Ensemble-Methoden
Im maschinellen Lernen haben Sie vielleicht bereits gelernt, wie man einen Entscheidungsbaum oder ein logistisches Regressionsmodell trainiert. Die Leistung eines einzelnen Modells (das wir als Basis-Lerner bezeichnen) kann manchmal an einen Engpass stoßen.
An diesem Punkt entsteht eine mächtige Idee:Ensemble-Methoden, die nicht darauf setzen, einen brandneuen, komplexeren Algorithmus zu entwickeln, sondern durch das geschickte Kombinieren mehrerer relativ einfacher, sogar mittelmäßiger Modelle ein leistungsfähigeres, stabileres und genaueres Supermodell aufbauen.
Einfach ausgedrückt ist die Kernphilosophie des Ensemble-Lernens:Drei Schuster mit vereintem Verstand können Zhuge Liang übertreffen.。
Ensemble-Methoden bündeln die kollektive Weisheit mehrerer Modelle, um Bias, Varianz oder zufällige Fehler auszugleichen, die ein einzelnes Modell aufweisen kann, und verbessern dadurch die Gesamtvorhersageleistung erheblich.
Dieser Artikel wird die Prinzipien, gängigen Techniken und Engineering-Praktiken von Ensemble-Methoden systematisch erklären.
Grundideen und Vorteile des Ensemble-Lernens
Bevor wir in spezifische Methoden eintauchen, müssen wir zunächst verstehen, warum Ensemble-Learning funktioniert und welche Vorteile es bringen kann.
Kernidee: Fehler reduzieren
Der Vorhersagefehler eines Modells kann üblicherweise in drei Teile zerlegt werden:Bias、Varianzundirreduzibler Fehler。
- Bias: Systematischer Fehler, der durch falsche Annahmen über die Natur des Problems verursacht wird. Hoher Bias bedeutet, dass das Modellein Underfitting aufweistund die grundlegenden Beziehungen in den Daten nicht erfassen kann.
- Varianz: Die Empfindlichkeit des Modells gegenüber kleinen Schwankungen in den Trainingsdaten. Hohe Varianz bedeutet, dass das Modellein Overfitting aufweistund dem Rauschen in den Trainingsdaten zu viel Aufmerksamkeit schenkt.
- Irreduzibler Fehler: Das inhärente zufällige Rauschen in den Daten, das durch kein Modell eliminiert werden kann.
Das Kernziel von Ensemble-Methoden ist es, mehrere Modelle zu kombinieren, umdie Varianz oder den Bias des Gesamtmodells zu reduzieren, wodurch robustere (stabilere) und genauere Vorhersagen erzielt werden.
Hauptvorteile
- Genauigkeit verbessern: Dies ist das direkteste Ziel; Ensemble-Modelle übertreffen den besten einzelnen Basis-Lerner in der überwiegenden Mehrheit der Szenarien.
- Stabilität und Robustheit erhöhen: Durch Mittelung oder Abstimmung sind Ensemble-Modelle weniger empfindlich gegenüber verrauschten Daten und Ausreißern, wodurch das Risiko von Overfitting verringert wird.
- Den Hypothesenraum erweitern: Mehrere Modelle zu kombinieren ist gleichbedeutend damit, einen breiteren Lösungsraum zu erkunden, wodurch es wahrscheinlicher wird, sich der optimalen Lösung des Problems anzunähern.
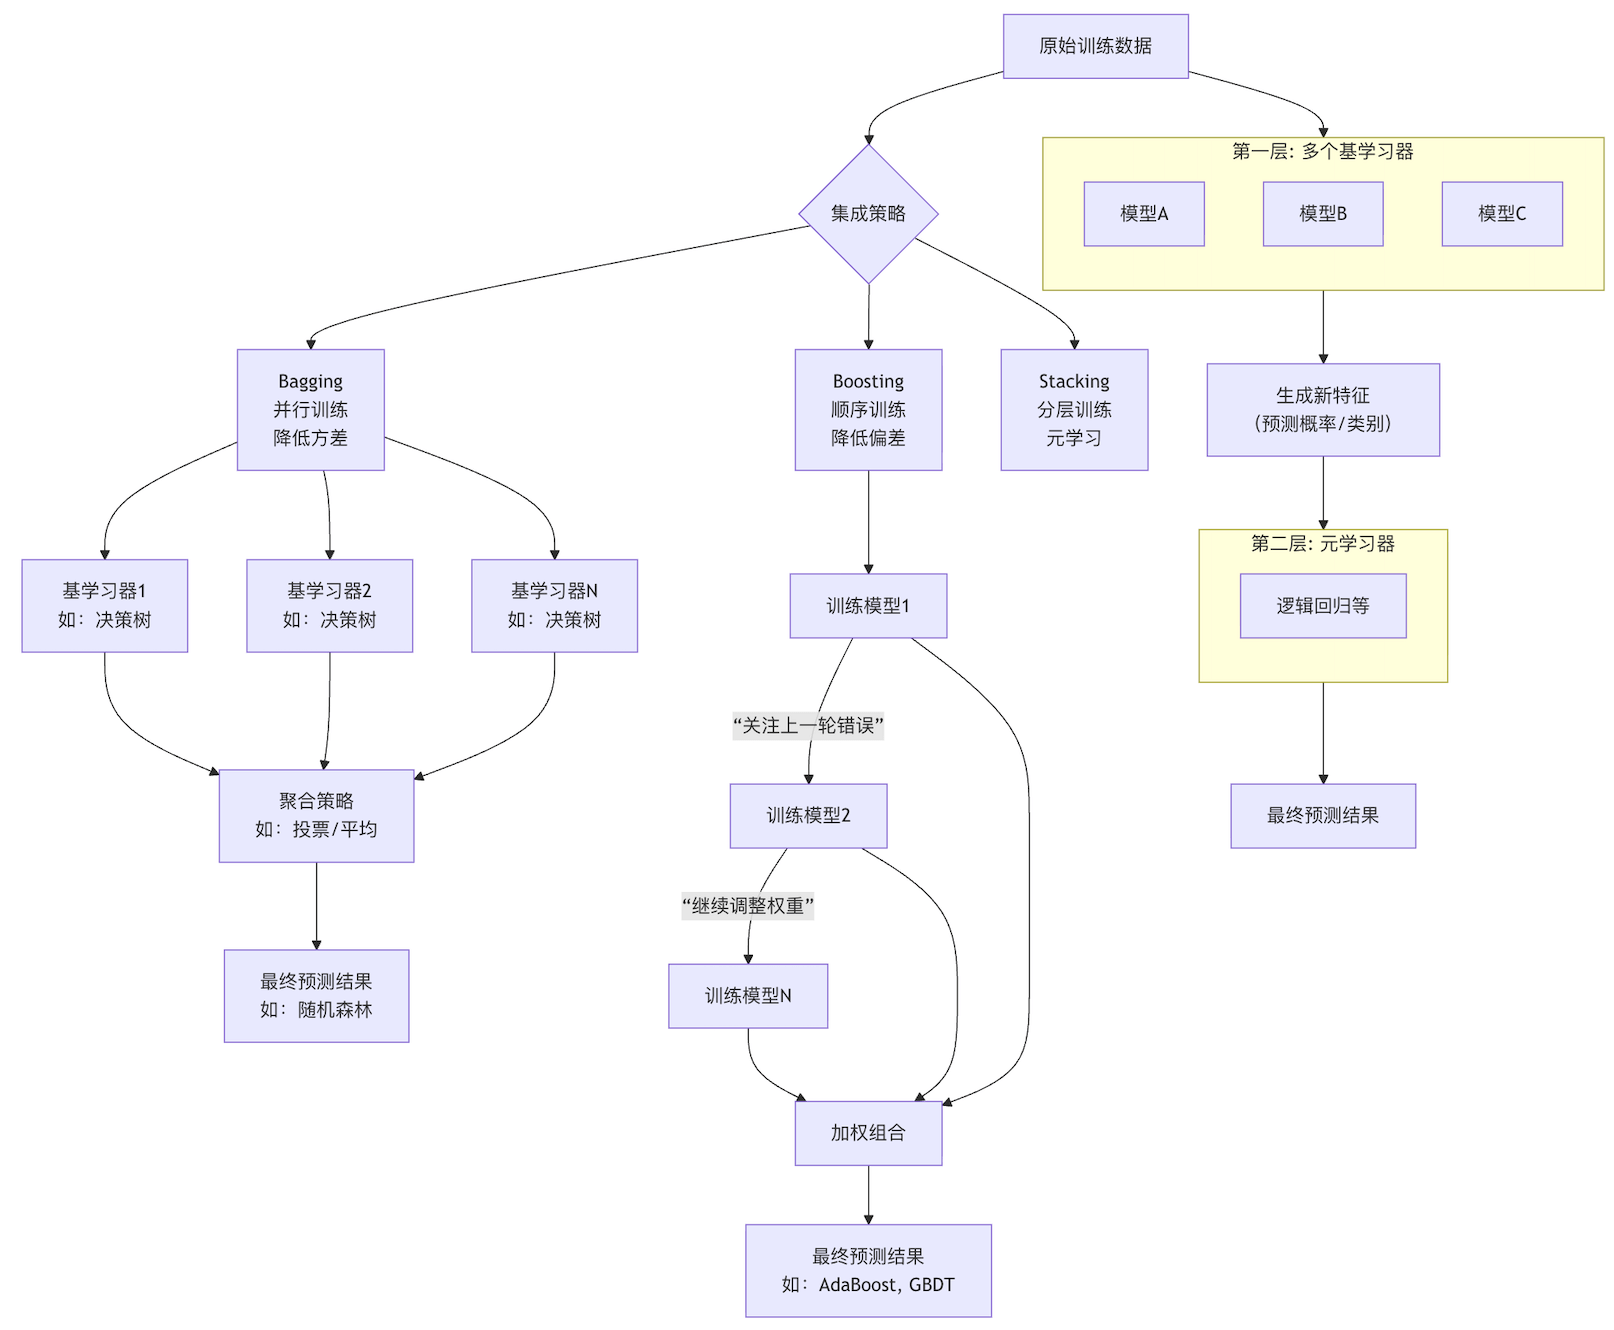
Um intuitiver zu verstehen, wie Ensemble-Methoden durch die Kombination mehrerer Modelle funktionieren, können wir uns das folgende Flussdiagramm ansehen:
Detaillierte Erklärung gängiger Ensemble-Methoden
Entsprechend der Erzeugungsmethode und Kombinationsstrategie der Basislerner werden Ensemble-Methoden hauptsächlich in drei Kategorien unterteilt:Bagging,、BoostingundStacking。
Bagging: Der Weg der Parallelität, Stabilität zuerst
BaggingDie Kernidee istBootstrap Aggregating。
- Bootstrap: Aus dem ursprünglichen Trainingssatz werden durchStichprobenziehung mit ZurücklegenZufallsstichproben erzeugt, um mehrere verschiedene Trainings-Teilmengen zu generieren. Die Größe jeder Teilmenge kann dieselbe wie die des ursprünglichen Satzes sein, aber aufgrund der Stichprobenziehung mit Zurücklegen werden einige Beispiele wiederholt gezogen, während andere überhaupt nicht gezogen werden.
- Paralleles Training: Es wird derselbe Lernalgorithmus verwendet (normalerweise ein Modell mit hoher Varianz und geringem Bias, etwa ein ungeprunter Entscheidungsbaum), um auf jeder Teilmenge unabhängig einen Basislerner zu trainieren.
- Aggregierung: Für Klassifikationsaufgaben wirdAbstimmung(Mehrheitsregel) verwendet, um die endgültige Klasse zu bestimmen; für Regressionsaufgaben wirdMittelwertbildungverwendet, um den endgültigen Wert zu berechnen.
Repräsentativer Algorithmus: Random ForestRandom Forest ist ein herausragender Vertreter der Bagging-Idee. Er geht auf Basis von Bagging noch einen Schritt weiter: Wenn jeder Entscheidungsbaum eine Knotenaufteilung durchführt, werden nicht nur zufällig Stichproben gezogen, sondern auchzufällig eine Teilmenge von Merkmalen auswählt, um die optimale Aufteilung durchzuführen. Diese "doppelte Zufälligkeit" verbessert die Diversität des Modells und seine Fähigkeit zur Vermeidung von Overfitting weiter.
Beispiel
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Daten laden
iris = load_iris()
X, y = iris.data, iris.target
# Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Random-Forest-Klassifikator erstellen
# n_estimators: Anzahl der Bäume im Wald, Anzahl der Basislerner
# max_depth: maximale Tiefe des Baums, steuert die Modellkomplexität
# random_state: Zufallsstartwert, gewährleistet reproduzierbare Ergebnisse
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Modell trainieren
rf_clf.fit(X_train, y_train)
# Vorhersagen und bewerten
y_pred = rf_clf.predict(X_test)
print(f"Genauigkeit des Random Forest: {accuracy_score(y_test, y_pred):.4f}")
# Tiefe eines einzelnen Baums anzeigen (Beispiel)
print(f"Tiefe des ersten Baums: {rf_clf.estimators_)
Boosting: Die Weisheit des sequenziellen Trainings, Fokus auf Fehlerkorrektur
BoostingEs verfolgt eine völlig andere Strategie.
- Sequenzielles Training: Die Basislerner werdensequenziell trainiert, statt parallel.
- Fokus auf Fehler: Jedes nachfolgende Modell schenkt den Stichproben mehr Aufmerksamkeit, die vorherige Modellefalsch vorhergesagt haben.Dies wird üblicherweise durch Anpassen der Gewichte der Trainingsstichproben erreicht (wobei falsch klassifizierten Stichproben höhere Gewichte zugewiesen werden).
- Gewichtete Kombination: Kombiniere alle Basis-Lerner mitgewichteter Summation, um das endgültige Modell zu erhalten; Basis-Lerner, die gute Leistungen erbringen, haben höhere Gewichte.
Der Kern von Boosting besteht darin, die Fehler der Vorgänger kontinuierlich zu korrigieren und eine Gruppe von "schwachen Lernern" (nur geringfügig besser als zufälliges Raten) zu einem leistungsstarken "starken Lerner" zu erheben.
Repräsentative Algorithmen: AdaBoost und Gradient Boosting Decision Tree
- AdaBoost: Einer der frühesten Boosting-Algorithmen. Er erhöht die Gewichte falsch klassifizierter Stichproben und zwingt nachfolgende Modelle, sich auf diese "schwierigen" Stichproben zu konzentrieren.
- Gradient Boosting Decision Tree (GBDT): Einer der beliebtesten und leistungsstärksten Boosting-Algorithmen. Er passt nicht mehr die Stichprobengewichte an, sondern behandelt den Trainingsprozess als einenGradientenabstieg-Optimierungsprozess. Das Ziel jedes neuen Baums ist es, dieResiduen(negativer Gradient) zwischen den Vorhersagen des aktuellen Modells und den wahren Labels.
Beispiel
from sklearn.ensemble import GradientBoostingClassifier
# Gradient-Boosting-Klassifikator erstellen
# n_estimators: Anzahl der Boosting-Stufen (Anzahl der Bäume)
# learning_rate: Lernrate, steuert den Beitrag jedes Baums zum Endergebnis (Schrumpfungskoeffizient)
# max_depth: maximale Tiefe jedes Regressionsbaums, normalerweise klein (3-5), was schwache Lernende repräsentiert
gb_clf = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, max_depth=3, random_state=42)
# Modell trainieren
gb_clf.fit(X_train, y_train)
# Vorhersagen und bewerten
y_pred_gb = gb_clf.predict(X_test)
print(f"Genauigkeit des Gradient Boosting Tree: {accuracy_score(y_test, y_pred_gb):.4f}")
# Feature-Wichtigkeit anzeigen (Ensemble-Methoden bieten dies normalerweise)
print("Feature-Wichtigkeit:", gb_clf.feature_importances_)
Ausgabe:
随机森林准确率: 1.0000
第一棵树的深度: 4
Stacking: Modell-Stacking, Meta-Learning-Strategie
StackingEs ist eine fortgeschrittenere Ensemble-Technik, die das Konzept eines "Meta-Lerners" einführt.
- Erste Schicht: Diverse Basis-Lernende. Verwenden SieverschiedeneLernalgorithmen (wie KNN, SVM, Entscheidungsbäume), um mehrere Modelle auf den Originaldaten zu trainieren.
- Neue Features generieren: Verwenden Sie diese Modelle der ersten Schicht, um die Trainingsdaten vorherzusagen (üblicherweise unter Verwendung von Kreuzvalidierung, um Datenleckage zu vermeiden), und verwenden Sie ihre Vorhersageergebnisse (Klassenbezeichnungen oder Wahrscheinlichkeiten) alsneue Features。
- Zweite Schicht: Trainieren Sie den Meta-Lerner. Mit diesen neuen Features als Eingabe und den ursprünglichen Labels als Ausgabe trainieren Sie ein finales Modell (wie logistische Regression oder lineare Regression). Dieser Meta-Lerner ist dafür verantwortlich zu lernen, wie die Ausgaben der Modelle der ersten Schicht am besten kombiniert werden.
Stacking hat großes Potenzial, ist aber rechenintensiv und erfordert ein sorgfältiges Design, um Überanpassung zu verhindern.
Methodenvergleich und Empfehlungen für die Ingenieurspraxis
Wie wählt man nach dem Verständnis der Prinzipien diese Methoden in realen Projekten aus und wendet sie an?
Vergleich der drei Methoden
| Merkmal | Bagging (z. B. Random Forest) | Boosting (z. B. GBDT, XGBoost) | Stacking |
|---|---|---|---|
| Kernziel | Varianzreduzieren, Überanpassung verhindern | Biasreduzieren, Vorhersagekraft verbessern | Kombinationsstrategie optimieren |
| Trainingsmethode | Paralleles, unabhängiges Training | Sequenziell, hängt von den Ergebnissen der vorherigen Runde ab | Geschichtet, zuerst Basislerner, dann Meta-Lerner |
| Stichprobengewichte | Gleich behandelt, Bootstrap-Sampling | Dynamisch angepasst, Fokus auf Fehler | Normalerweise gleich |
| Beziehung der Basislerner | Gegenseitig unabhängig, Diversität entsteht durch Datenperturbation | Gegenseitig abhängig, gemeinsam die Zielfunktion optimieren | Gegenseitig unabhängig, Diversität entsteht durch Algorithmusunterschiede |
| Vorteile | Stabil, robust gegen Overfitting, leicht zu parallelisieren | Die Vorhersagegenauigkeit ist normalerweise sehr hoch | Theoretisch lässt sich die beste Leistung erzielen |
| Nachteile | Begrenzte Bias-Reduktion, hoher Verbrauch an Rechenressourcen | Empfindlich gegenüber Rauschen, anfällig für Overfitting, komplexes Tuning | Extrem hohe Rechenkosten, komplexe Struktur, anfällig für Overfitting |
| Typische Anwendungen | Random Forest, Extra-Trees | AdaBoost, GBDT, XGBoost, LightGBM, CatBoost | Häufig in Machine-Learning-Wettbewerben |
Leitfaden für die Ingenieurspraxis
Bevorzugtes Baseline-Modell: Verwenden Sie nicht von Anfang an komplexe Ensemble-Methoden. Verwenden Sie zunächst ein einfaches Modell (wie logistische Regression, einen einzelnen Entscheidungsbaum), um eine Leistungs-Baseline festzulegen.
Je nach Problem auswählen:
- Wenn Ihr Basismodell (wie ein sehr tiefer Entscheidungsbaum)stark überangepasst ist (hohe Varianz), sollten Sie vorrangigBagging(Random Forest) ausprobieren.
- Wenn dein Basismodellunterfittet (hoher Bias), oder wenn du extrem hohe Vorhersagegenauigkeit anstrebst, versuche vorrangigBoosting(wie XGBoost, LightGBM).
- BeiMachine-Learning-Wettbewerbenoder Szenarien mit extremen Genauigkeitsanforderungen und ausreichenden Rechenressourcen kannst duStackingoderBlending in Betracht ziehen。
Verwende moderne optimierte Bibliotheken: Verwende in der Praxis direkt hoch optimierte Bibliotheken, die modernste Ensemble-Algorithmen implementieren:
- Scikit-learn: bietet
RandomForest,GradientBoostingund andere hervorragende Implementierungen, geeignet für Anfänger und schnelles Prototyping. - XGBoost: Schnell, hohe Genauigkeit, voll ausgestattet, ein häufiger Gewinner in Kaggle-Wettbewerben.
- LightGBM: Von Microsoft eingeführt, schnellere Trainingsgeschwindigkeit, geringerer Speicherverbrauch, besonders geeignet für große Datensätze.
- CatBoost: Von Yandex eingeführt, verarbeitet kategorische Merkmale gut und erzielt gute Ergebnisse mit Standardparametern.
Achte auf das Tuning: Ensemble-Modelle haben viele Hyperparameter. Wichtige Parameter, auf die du achten solltest, sind:
n_estimators: Anzahl der Basislerner (je mehr, desto besser, aber der Rechenaufwand steigt).learning_rate(Boosting): Lernrate, steuert den Beitrag jedes Schritts. Muss normalerweisen_estimatorsabgewogen werden (eine kleine Lernrate erfordert mehr Bäume).max_depth(Tree-Methode): Schlüssel zur Kontrolle von Modellkomplexität und Overfitting.- Verwenden SieKreuzvalidierungundGrid Search/Random Search, um Parameter systematisch abzustimmen.