Datenleck
In der Praxis des maschinellen Lernens begegnen wir oft einem verwirrenden Phänomen: Das Modell schneidet im Trainings- und Validierungssatz hervorragend ab, alle Metriken sind nahezu perfekt, doch sobald es in einer realen Produktionsumgebung eingesetzt wird, fällt seine Leistung steil ab und ist nahezu unbrauchbar. Hinter dieser enormen Kluft steht einer der häufigsten und gefährlichsten unsichtbaren KillerDatenleck。
Datenleck ist eine Hauptursache für das Scheitern von Machine-Learning-Projekten. Es untergräbt die Fairness der Modellbewertung und führt dazu, dass wir blind optimistische Fehlurteile über die Modellleistung treffen. Das Verständnis, die Identifizierung und die Vermeidung von Datenlecks ist eine zentrale Ingenieurfähigkeit, die jeder Machine-Learning-Ingenieur und Datenwissenschaftler beherrschen muss.
Dieser Artikel wird Sie anleiten, Datenlecks systematisch zu verstehen, ihre Mechanismen zu begreifen, Diagnosemethoden zu erlernen und eine Reihe wirksamer Präventionsstrategien zu beherrschen.
Was ist ein Datenleck?
Kerndefinition
Datenleck, bezieht sich darauf, dass während des Modelltrainingsprozesses⟦⟧unsachgemäß Informationen verwendet werden, die in realen Vorhersageszenarien nicht verfügbar sindimproperly using information that is unavailable in real prediction scenarios, wodurch das Modell "zukünftige Informationen" oder "globale Informationen" erhält, die es nicht kennen sollte, und dadurch während der Evaluierung eine übermäßig optimistische, aber tatsächlich ungültige Leistung erzeugt.
Einfach gesagt, ist es, als hätte das Modell heimlich die "Antworten" vor der "Prüfung" angeschaut. Dadurch kann es bei Probeklausuren (Validierungsset) gut abschneiden, aber in der echten Prüfung, in der es keine Antworten gibt (Produktionsumgebung), kläglich scheitern.
Eine anschauliche Metapher
Stellen Sie sich vor, Sie bringen einem Schüler bei, Bilder von Tieren zu erkennen.
- Der richtige Ansatz: Sie zeigen ihm einige Bilder von Katzen und Hunden (Trainingsset), sagen ihm, welche davon Katzen und welche Hunde sind. Dann nehmen Sie einige neue Bilder heraus, die er noch nie gesehen hat (Testset), und bitten ihn, sie zu identifizieren.
- Der Datenleck-Ansatz: Während Sie ihm Trainingsbilder zeigen, mischen Sie versehentlich einige Bilder aus dem Testset unter und sagen ihm die Antworten. Wenn der Schüler also wirklich "neuen" Bildern gegenübersteht, hat er diese tatsächlich schon vor langer Zeit gesehen und auswendig gelernt. Er scheint gut gelernt zu haben, aber in Wirklichkeit hat er nicht die allgemeine Fähigkeit gelernt, "Tiere anhand von Merkmalen zu identifizieren"; er hat nur die Antworten für bestimmte Bilder auswendig gelernt.
Häufige Arten und Szenarien von Datenlecks
Ein Datenleck ist nicht immer offensichtlich; es versteckt sich oft in den Details der Datenverarbeitungspipeline. Es kann hauptsächlich in die folgenden zwei Kategorien unterteilt werden:
1. Datenleck in Merkmalen
Dies ist der häufigste Typ, bei dem die für das Training verwendeten Merkmale direkte oder indirekte Informationen über die Zielvariable enthalten.
Szenario 1: Verwendung zukünftiger Informationen
Dies ist eine typische Falle bei der Zeitreihenvorhersage.
- Inkorrektes Beispiel: Den Preis einer Aktie für morgen vorherzusagen, aber den Stimmungsindex der Nachrichten von morgen oder das Handelsvolumen von morgen als Merkmale zu verwenden. Bei einer echten Vorhersage kann man diese Informationen über morgen unmöglich im Voraus kennen.
- Korrektes Vorgehen: Jedes Merkmal musseine historische Information sein, die zum Zeitpunkt der Vorhersage bekannt ist. Zum Beispiel können Sie nur historische Preise, Nachrichten usw. bis zum heutigen Börsenschluss verwenden, um morgen vorherzusagen.
Szenario 2: Schatten der Zielvariable
Merkmale weisen eine umgekehrte Kausalität oder eine hohe Korrelation mit der Zielvariable auf.
- Inkorrektes Beispiel: In einem medizinischen Diagnosemodell ein Merkmal "ob der Patient das Spezialmedikament A eingenommen hat" verwenden, um vorherzusagen, ob der Patient an Krankheit X leidet. In der Realität wird jedoch nur Patienten, bei denen Krankheit X diagnostiziert wurde, das Spezialmedikament A verschrieben. Dieses Merkmal verrät die Antwort beinahe direkt.
- Inkorrektes Beispiel: In einem Modell, das vorhersagt, ob ein Nutzer abwandern wird, wird die Anzahl der kürzlichen Kontakte des Kunden zum Support als Merkmal hinzugefügt. Wenn die Kontaktaufnahme mit dem Support eine Gegenmaßnahme vor der Nutzerabwanderung ist, dann enthält dieses Merkmal Informationen über eine unmittelbar bevorstehende Abwanderung.
Szenario 3: Unsachgemäße Datenvorverarbeitung
InVor dem Aufteilen des Trainings- und Testsatzeswurden globale Datenvorverarbeitungsoperationen durchgeführt.
- Inkorrekte Operation: Zuerst den gesamten Datensatz normalisieren (den globalen Mittelwert subtrahieren, durch die globale Standardabweichung dividieren) und ihn dann in Trainings- und Testsatz aufteilen.
- Das Problem: Die Daten des Testsatzes fließen in die Berechnung des globalen Mittelwerts und der globalen Standardabweichung ein, was bedeutet, dass Sie beim Training des Modells bereits die Verteilungsinformationen des Testsatzes "eingesehen" haben.
- Korrektes Vorgehen:Zuerst aufteilen, dann vorverarbeiten. Berechnen Sie die Normalisierungsparameter (Mittelwert, Standardabweichung) mit den Daten des Trainingssatzes und verwenden Sie diese Parameter dann, um den Trainings- und Testsatz zu transformieren.
Beispiel
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
# Fehler: Anpassung an die gesamten Daten vor dem Aufteilen
X_scaled = scaler.fit_transform(X_all)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all, test_size=0.2)
# ----------------------------------------------------------------------
# Korrekter Ansatz: Zuerst aufteilen, dann getrennt verarbeiten
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# 1. Zuerst die Daten aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 2. Den Preprocessor nur auf dem Trainingssatz anpassen
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train) # Mittelwert und Standardabweichung nur mit den Trainingsdaten berechnen
# 3. Die aus dem Trainingssatz gewonnenen Parameter verwenden, um den Testsatz zu transformieren
X_test_scaled = scaler.transform(X_test) # Hinweis: Hier ist es transform, nicht fit_transform!
2. Datenleck im Evaluierungsprozess
Diese Art von Datenleck tritt beim Entwurf des Modelltrainings- und Evaluierungsprozesses auf, wodurch das Modell während der Evaluierung indirekt mit Testdaten in Berührung kommt.
Szenario 1: Fehlerhafte Kreuzvalidierung
Verwendung einer standardmäßigen zufälligen K-fachen Kreuzvalidierung bei Zeitreihendaten.
Problem: Zufälliges Mischen der Daten kann dazu führen, dass „zukünftige Daten verwendet werden, um ein Modell zu trainieren, um die Vergangenheit vorherzusagen“, was das Prinzip der chronologischen Reihenfolge ernsthaft verletzt.
Korrektes Vorgehen: Verwenden SieZeitreihen-Kreuzvalidierung, um sicherzustellen, dass der Trainingssatz zeitlich immer vor dem Validierungssatz liegt.
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # ... 训练和评估
Szenario 2: Merkmalsauswahl oder Hyperparameter-Tuning basierend auf allen Daten
Dies ist eine äußerst häufige und versteckte Falle.
Falscher Ablauf:
- Verwenden Sie alle Daten, um eine Merkmalsauswahl durchzuführen und die beste Merkmals-Teilmenge auszuwählen.
- Verwenden Sie alle Daten, um eine Hyperparameter-Rastersuche durchzuführen und die optimalen Parameter zu finden.
- Wenden Sie die oben genannten „optimalen“ Merkmale und Parameter auf das Modell an und verwenden Sie dann erneut train_test_split, um die Leistung zu bewerten.
Das Problem: Der Prozess der Merkmalsauswahl und Optimierung hat bereits alle Daten gesehen (einschließlich des zukünftigen Testsatzes), und die ausgewählten „optimalen“ Merkmale und Parameter sind das Ergebnis einer Überanpassung an den gesamten Datensatz, was seine Generalisierungsfähigkeit auf neue Daten nicht widerspiegeln kann.
Korrektes Vorgehen: Integrieren Sie Schritte wie Merkmalsauswahl und Hyperparameter-Tuningals Teil des Modelltrainingsund kapseln Sie sie in die Kreuzvalidierungsschleife ein. Verwenden SiePipelineundGridSearchCVum diesen Prozess gut zu automatisieren.
Beispiel
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import SelectKBest
from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestClassifier
# Pipeline erstellen: zuerst Merkmalsauswahl, dann Modellierung
pipe = Pipeline([
('selector', SelectKBest()), # Merkmalsselektor
('classifier', RandomForestClassifier()) # Klassifikator
])
# Parameter-Grid definieren
param_grid = {
'selector__k': [5, 10, 20], # Einige Merkmale auswählen
'classifier__n_estimators': [50, 100]
}
# GridSearchCV für Tuning mit Kreuzvalidierung verwenden
# Der cv-Parameter stellt sicher, dass in jedem Fold der Kreuzvalidierung Merkmalsauswahl und Tuning nur auf dem Trainings-Fold durchgeführt werden
grid_search = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train) # Nur auf dem Trainingssatz durchgeführt!
print("Beste Parameter:", grid_search.best_params_)
print("Bester Kreuzvalidierungs-Score:", grid_search.best_score_)
# Zum Schluss auf dem unabhängigen Testsatz evaluieren
final_score = grid_search.score(X_test, y_test)
print("Score auf dem unabhängigen Testsatz:", final_score)
Wie diagnostiziert man Datenlecks?
- Warnung bei Leistungsunterschieden: Die Leistung des Modells auf dem Trainings-/Validierungssatz (z. B. Genauigkeit, AUC) ist weit höher als seine Leistung in realen Geschäftsszenarien oder auf einem streng isolierten Testsatz; dies ist das offensichtlichste Warnsignal.
- Analyse der Feature-Wichtigkeit: Untersuchen Sie die Features, die das Modell als am wichtigsten erachtet. Wenn Sie ein Feature mit ungewöhnlich hoher Wichtigkeit finden und es aus Sicht der Geschäftslogik nicht eine so starke Vorhersagekraft haben sollte (z. B. ein ID-Feld oder ein Feld, das Zielinformationen enthält), ist ein Datenleck sehr wahrscheinlich.
- Überprüfen Sie die Korrelation zwischen Features und dem Ziel: Berechnen Sie die Korrelation zwischen allen Features und der Zielvariable. Wenn ein Feature eine extrem hohe Korrelation mit dem Ziel im Trainingssatz aufweist, es aber aus Sicht der Geschäftslogik keinen Sinn ergibt, seien Sie äußerst wachsam.
- Führen Sie einen "Verfügbarkeitstest" durch: Simulieren Sie vor der Bereitstellung einen vollständig abgeschotteten Test: Trainieren Sie mit Daten aus einem historischen Zeitpunkt, prognostizieren Sie Daten für einen darauffolgenden Zeitraum und vergleichen Sie sie mit echten Ergebnissen. Dies ist die effektivste Methode, um Zeitreihen-Leckage zu erkennen.
- Code-Review und Prozess-Retrospektive: Überprüfen Sie sorgfältig den gesamten Codeablauf der Datenvorverarbeitung, des Feature-Engineerings, des Modelltrainings und der Evaluierung, um sicherzustellen, dass es keine Operation gibt, die zuerst kontaminiert, dann aufteilt.
Best Practices zur Vermeidung von Datenlecks
Wenn Sie die folgenden Prinzipien und Prozesse befolgen, können Sie Datenlecks weitestgehend vermeiden:
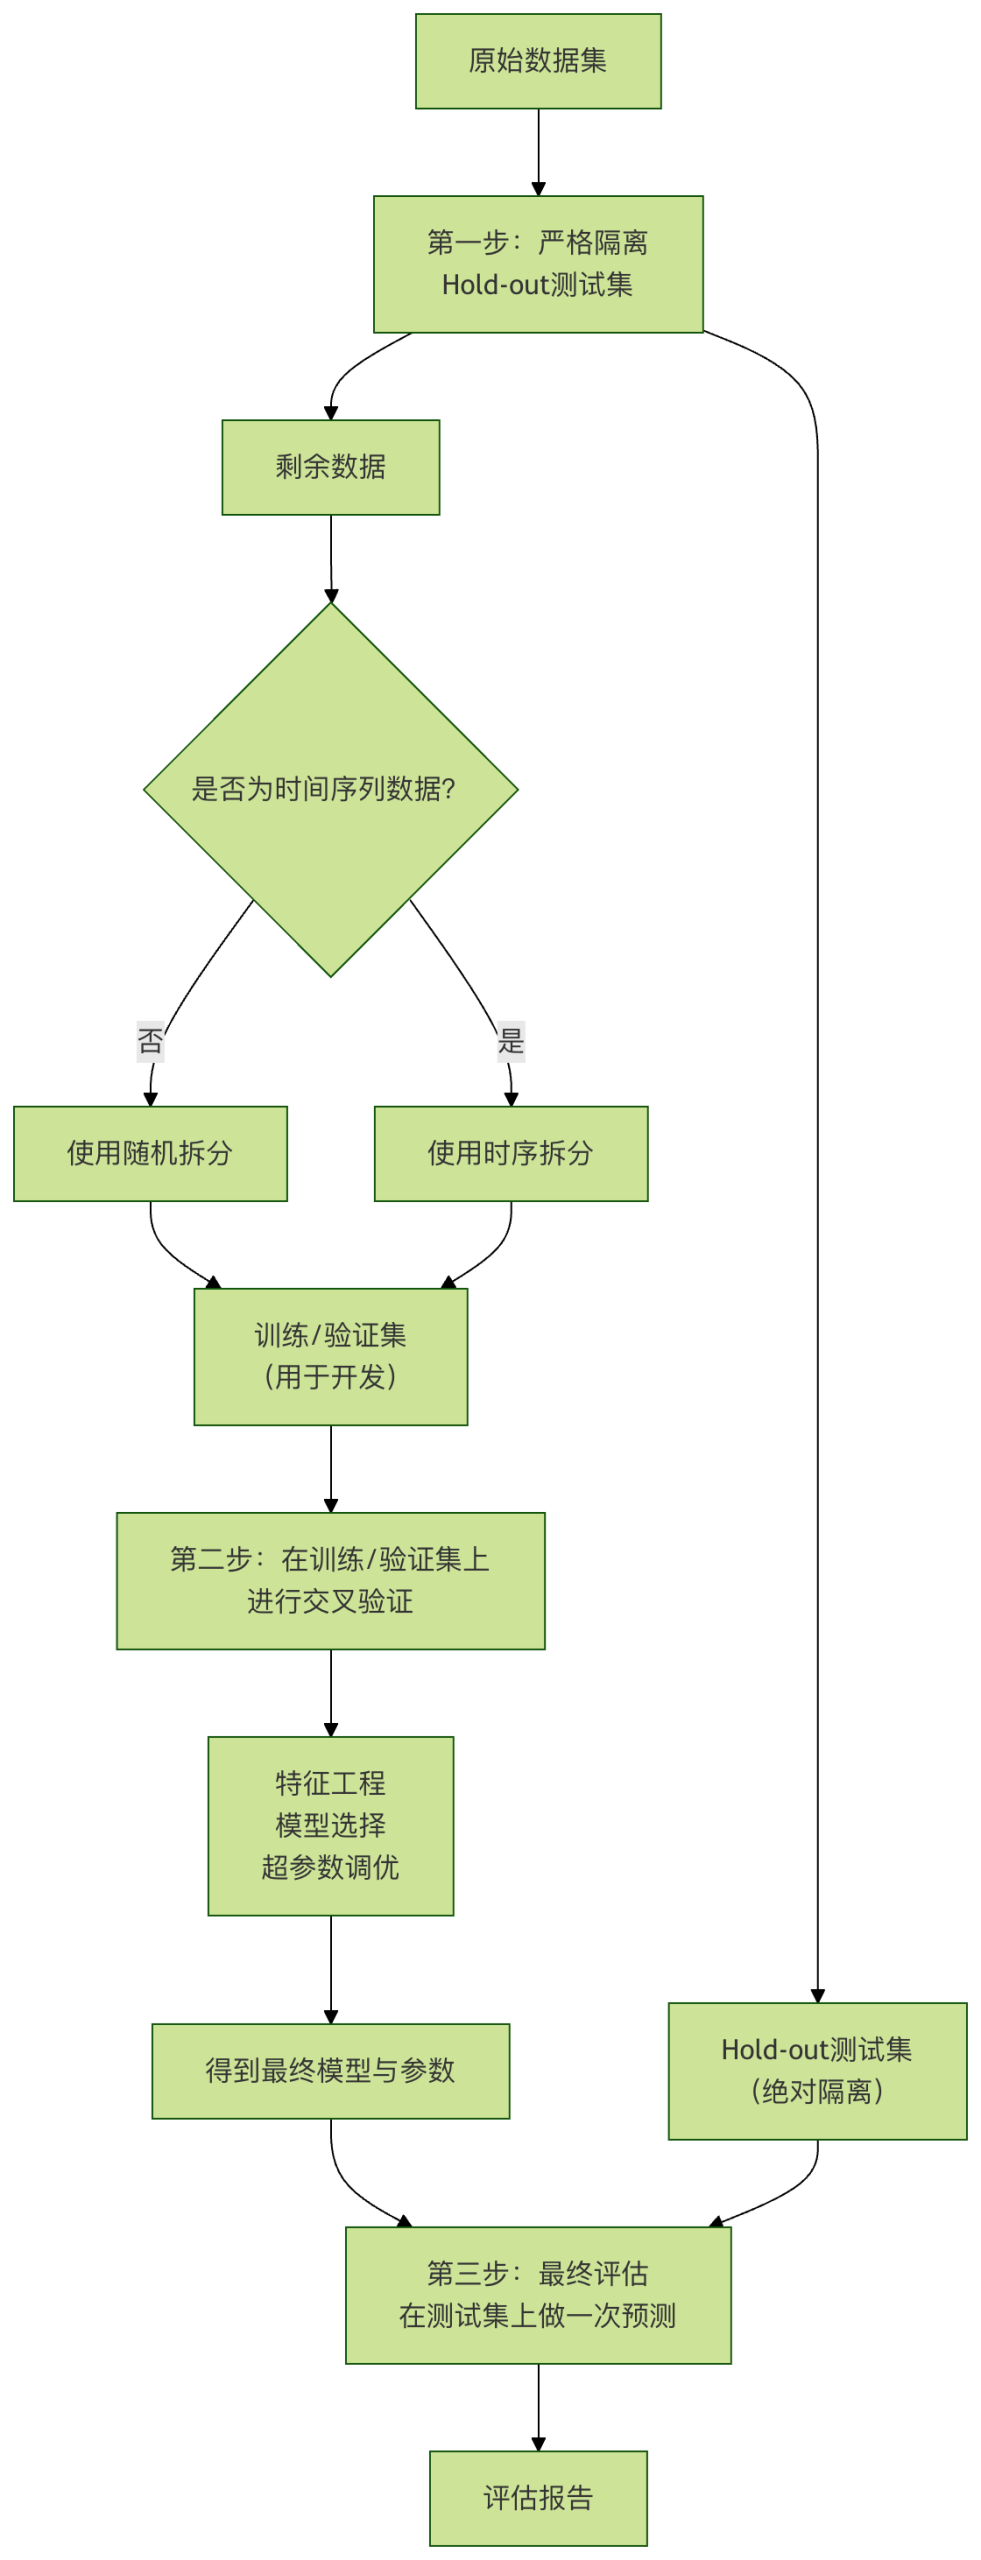
- Etablieren Sie eine strikte Denkweise der Datenisolierung: Legen Sie zu Beginn des Projekts sofort, zufällig (oder nach Zeit), einen Teil der Daten als dasfinale Testsetbeiseite und schließen Sie es weg; verwenden Sie es während des gesamten Modellentwicklungszyklus niemals. Es wird nur für den letzten Schritt der Modellbewertung verwendet.
- Befolgen Sie die eiserne Regel "zuerst aufteilen, dann verarbeiten": Jede Operation, die Parameter aus Daten lernt (Normalisierung, Auffüllen fehlender Werte, Kodierung usw.), darf nur auf dem Trainingsset ausgeführt werden; anschließend werden die gelernten Parameter auf die Validierungs- und Testsets angewendet.
- Pipeline verwenden: Scikit-learns
PipelineWerkzeuge können Vorverarbeitungsschritte und Modelltrainingsschritte zwangsweise bündeln und sicherstellen, dass Vorverarbeitungsschritte während der Kreuzvalidierung korrekt erneut ausgeführt werden. Sie sind eine mächtige Waffe gegen Vorverarbeitungslecks. - Bewahren Sie Ehrfurcht vor Zeitreihen: Wenn Sie Zeitdaten verarbeiten, nehmen Sie stets an, dass "die Zukunft nicht erkennbar ist". Verwenden Sie Zeitreihen-Kreuzvalidierung und stellen Sie sicher, dass alle Merkmale verzögerte Merkmale sind.
- Verstehen Sie die Geschäftslogik gründlich: Kommunizieren Sie mit Domänenexperten, um die wahre Bedeutung und den Entstehungszeitpunkt jedes Merkmals zu verstehen. Seien Sie wachsam bei Merkmalen, die eine umgekehrte kausale Beziehung zum Ergebnis haben oder nachträgliche Informationen enthalten.
- Behalten Sie eine skeptische Haltung bei: Wenn ein Modell unrealistisch gut abschneidet (z. B. 99.9% Genauigkeit), sollte Ihre erste Reaktion "Ist das ein Datenleck?" sein, anstatt Erfolg zu feiern.
Zusammenfassung
Datenleckage ist eine zentrale Herausforderung auf dem Weg zum Machine-Learning-Engineering. Sie ist nicht nur ein technischer Fehler, sondern eine Manifestation eines systemischen Denkfehlers. Um Datenleckage zu bekämpfen, müssen wir:
- Kognitiv: Bleiben Sie jederzeit wachsam und bedenken Sie, dass ihr Wesen die unsachgemäße Nutzung von Informationen ist.
- Im Prozess: Etablieren und befolgen Sie strenge Standards für Datenverarbeitung und Modellbewertung.
- Bei den Werkzeugen: Nutzen Sie
Pipeline, korrekte Kreuzvalidierungsmethoden und andere Werkzeuge, um eine Firewall aufzubauen.