Statistik-Grundlagen
Bevor wir verschiedene coole Algorithmen lernen, müssen wir zuerst eine entscheidende Grundlage legen –Statistik。
Wir können uns Statistik als dieSpracheundWerkzeugkistevorstellen; ohne sie sind Modelle des maschinellen Lernens wie Entdecker ohne Karte, die Daten nicht verstehen, keine Vorhersagen treffen und ihre eigene Leistung nicht bewerten können.
Dieser Artikel führt systematisch in die zentralen statistischen Konzepte ein, die für maschinelles Lernen unerlässlich sind, und verwendet eine einfache Sprache sowie anschauliche Beispiele, um Ihnen zu helfen, ein solides theoretisches Fundament aufzubauen.
Warum braucht maschinelles Lernen Statistik?
Hauptgrund: Maschinelles Lernen ist im Wesentlichendas Erlernen von Mustern aus Datenund die Nutzung dieses Musters fürVorhersageoderund Entscheidungsfindung.Und Statistik ist genau genommen die Wissenschaft davon, wie man Daten sammelt, analysiert, interpretiert und präsentiert.
- Datenverständnis: Die Statistik hilft uns, die grundlegenden Eigenschaften von Daten zu beschreiben (z. B. durchschnittliche Körpergröße, Einkommensverteilung). Dies ist der erste Schritt bei der Datenbereinigung und -exploration.
- Muster-Mining: Es bietet Methoden zum Ableiten allgemeiner Muster (Modelle) aus Daten und sagt uns, wie zuverlässig diese Muster sind.
- Vorhersage und Bewertung: Die statistische Theorie bildet die Grundlage dafür, wie wir Modelle zur Vorhersage nutzen und wie wir die Qualität eines Modells objektiv bewerten (rät es blind oder versteht es wirklich?).
- Unsicherheitsquantifizierung: Die reale Welt ist voller Rauschen; die Statistik ermöglicht es uns, die Unsicherheit in Vorhersagen zu quantifizieren (z. B. "Ich bin zu 95% sicher, dass es morgen regnet").
Einfach ausgedrückt,ist die Statistik der theoretische Eckpfeiler des maschinellen Lernens und verwandelt Intelligenz von Mystizismus in Wissenschaft.
Kernkonzept 1: Deskriptive Statistik
Deskriptive Statistik ist wie ein Schnappschuss und ein Gesundheitscheck-Bericht der Daten, wobei einige zentrale Kennzahlen verwendet werden, um das Gesamtbild eines Datensatzes zusammenzufassen. Dies ist der Ausgangspunkt jedes Datenanalyseprojekts.
1. Zentrale Tendenz: Wo sammeln sich die Daten?
Diese Kennzahlen sagen uns, wo das Zentrum oder der typische Wert der Daten liegt.
| Metrik | Erklärung (Metapher) | Berechnungsformel (kurz) | Eigenschaften und Verwendungen |
|---|---|---|---|
| Mittelwert | Das arithmetische Mittel aller Daten. Wie das "Durchschnittsgehalt." |
Sum / Number of data points |
Am häufigsten verwendet, aber sehr empfindlich gegenüber Extremwerten (z. B. Milliardären) und leicht nach oben "verzerrt". |
| Median | Nach dem Sortieren der Daten vom kleinsten zum größten Wert,der exakt mittlereWert. Wie das "Median-Gehalt." |
Nimm den Wert an der mittleren Position nach dem Sortieren. | Robust, unempfindlich gegenüber Extremwerten und spiegelt typische Situationen besser wider. |
| Mode | Der Wert, deram häufigstenin den Daten vorkommt. Wie die meistverkaufte Schuhgröße in einem Geschäft. |
Der Wert mit der höchsten Häufigkeit | Geeignet für kategoriale Daten oder zum Finden der häufigsten Kategorie. |
Beispiel: Die Monatsgehälter (in Tausend Yuan) von 5 Mitarbeitern einer Abteilung sind:[30, 35, 40, 45, 200](Der Chef ist unter ihnen.)
- Mittelwert = (30+35+40+45+200)/5 = 70. Dieser Wert ist wegen der 200 des Chefs künstlich hoch und kann das Einkommen der Mitarbeiter nicht repräsentieren.
- Median= die dritte Zahl nach dem Sortieren40. Dieser Wert repräsentiert besser das Einkommen eines "typischen" Mitarbeiters in der Abteilung.
- Modus= alle Werte kommen nur einmal vor, alsogibt es keinen Modus.。
2. Streuung: Wie weit sind die Daten gestreut?
Es reicht nicht, nur das Zentrum zu kennen; wir müssen auch wissen, ob die Daten eng um das Zentrum gruppiert oder weit verstreut sind. Die Streuung misst die Volatilität oder Vielfalt der Daten.
| Metrik | Erklärung (Metapher) | Berechnungsformel (kurz) | Eigenschaften und Verwendungen |
|---|---|---|---|
| Varianz | Der Abstand jedes Datenpunkts vom Mittelwert,quadriert,wird gemittelt. | Σ(每个值 - 均值)² / (n-1) |
Misst die Gesamtstreuung; die Einheit ist das Quadrat der ursprünglichen Einheit. |
| Standardabweichung | Die positive Quadratwurzel der Varianz.。 Wie die „durchschnittliche Schwankungsbreite“. |
√Variance |
Wird am häufigsten verwendet, hat dieselbe Einheit wie die Originaldaten und spiegelt intuitiv die Größe der Schwankung wider. Je größer der Wert, desto stärker sind die Daten gestreut. |
| Range | Die Differenz zwischen dem Maximal- und dem Minimalwert. „Gehaltsspanne.“ |
Maximum value - Minimum value |
Einfach zu berechnen, aber nur durch zwei Extremwerte bestimmt und leicht durch Ausreißer beeinflusst. |
Fortsetzung des obigen Beispiels: Berechnen Sie die Standardabweichung der Mitarbeitergehälter (wobei 40 als geschätzter Mittelwert sinnvoller ist).
- Berechnen Sie die Varianz:
[(30-40)² + (35-40)² + (40-40)² + (45-40)² + (200-40)²] / 4 ≈ 5875 - Standardabweichung =
√5875 ≈ 76.65. Diese enorme Standardabweichung (76.65) ist weit größer als der Mittelwert (40),was stark darauf hindeutet, dass ein extremer Ausreißer in den Daten vorliegt (die 200 des Chefs), was eine weitere Analyse erfordert.
3. Datenverteilung und Visualisierung
Numerische Kennzahlen sind abstrakt; Diagramme ermöglichen es uns, die Daten intuitiv zu „sehen“.
- Histogramm: Zeigt die Häufigkeitsverteilung der Daten in verschiedenen Intervallen (Bins). Es zeigt, ob die Daten unimodal oder multimodal sind und ob sie symmetrisch sind.
- Boxplot: Verwendet eine "Box" und "Whiskers", um die Daten darzustellen:Minimum, erstes Quartil (Q1), Median (Q2), drittes Quartil (Q3) und Maximum, und ist ein leistungsstarkes Werkzeug zum Identifizieren vonAusreißern.
Beispiel
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np
# Mitarbeitergehaltsdaten, die einen Ausreißer enthalten
salaries = np.array([30, 35, 40, 45, 200])
employee_names = ['Alice', 'Bob', 'Charlie', 'Diana', 'Boss']
plt.figure(figsize=(8, 5))
# Boxplot erstellen
sns.boxplot(y=salaries)
plt.title('Gehaltsverteilung der Abteilung (Boxplot)')
plt.ylabel('Gehalt (k)')
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Markiere den Punkt, der dem Ausreißer entspricht
for i, (name, salary) in enumerate(zip(employee_names, salaries)):
if salary > 45 + 1.5 * (45-35): # Einfache Regel zur Ausreißererkennung
plt.annotate(f'{name}: {salary}', xy=(0, salary), xytext=(0.2, salary),
arrowprops=dict(facecolor='red', shrink=0.05))
plt.show()
Code-Erklärung:
sns.boxplot()Zeichne ein Boxplot. Die Box reicht von Q1 bis Q3, und die mittlere Linie ist der Median.- Die „Whiskers“ eines Boxplots erstrecken sich typischerweise bis zum am weitesten entfernten Datenpunkt innerhalb des 1,5-Fachen des Interquartilsabstands (IQR = Q3 - Q1); Punkte darüber hinaus gelten alsAusreißerund werden separat mit Punkten markiert. In der Abbildung,
200Dieser Punkt wird eindeutig als Ausreißer identifiziert.
Kernkonzept 2: Wahrscheinlichkeit und Verteilungen
Wenn deskriptive Statistik bedeutet, auf die Vergangenheit zu blicken, dann geht es bei der Wahrscheinlichkeit darum, die Zukunft vorherzusagen. Sie quantifiziertdie Wahrscheinlichkeit, dass ein Ereignis eintritt.。
1. Grundlagen der Wahrscheinlichkeit
- Wahrscheinlichkeit P(A): Die Wahrscheinlichkeit, dass Ereignis A eintritt, reicht von 0 (unmöglich) bis 1 (sicher).
- Bedingte Wahrscheinlichkeit P(A|B): Unter der Bedingung, dass Ereignis Beingetreten ist, die Wahrscheinlichkeit, dass Ereignis A eintritt. Dies ist der Schlüssel zum Verständnis vieler Algorithmen des maschinellen Lernens (wie Naive Bayes).
- Formel:
P(A|B) = P(A 且 B) / P(B)
- Formel:
2. Wahrscheinlichkeitsverteilungen
Beschreibt die Wahrscheinlichkeitsregeln für eine Zufallsvariable, die verschiedene mögliche Werte annimmt. Die wichtigste im maschinellen Lernen ist:
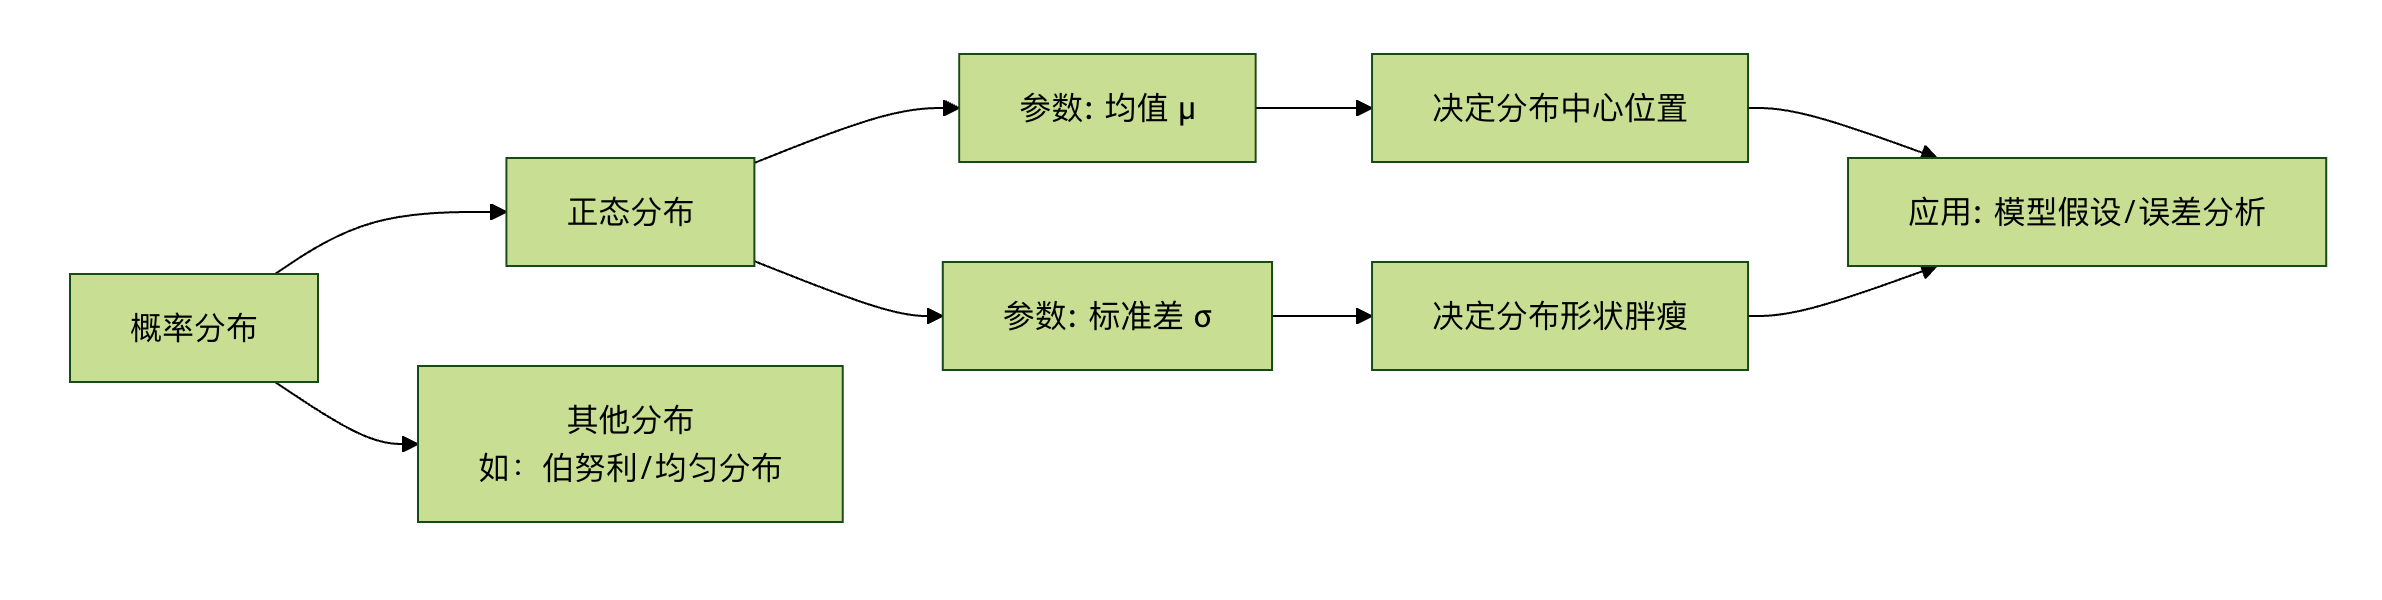
- Normalverteilung (Gauß-Verteilung):
- Form: Die berühmte "Glockenkurve", links und rechts symmetrisch.
- Parameter: Der **Mittelwert (μ)** bestimmt die Position des Zentrums, und die **Standardabweichung (σ)** bestimmt die "Dicke" (Streuung) der Kurve.
- Bedeutung: Viele Phänomene in der Natur und in den Sozialwissenschaften folgen annähernd einer Normalverteilung (z. B. Körpergröße, Messfehler). Der zentrale Grenzwertsatz besagt, dass die Summe vieler unabhängiger Zufallsvariablen gegen eine Normalverteilung strebt, was ihn zum Eckpfeiler der statistischen Inferenz macht.
- 68-95-99.7-Regel: Die Wahrscheinlichkeiten, dass Daten innerhalb von Mittelwert ±1σ, ±2σ und ±3σ liegen, betragen ungefähr 68%, 95% bzw. 99.7%.
Kernkonzept 3: Inferenzstatistik
Dies ist die "fortgeschrittene Version" der Statistik; das Ziel ist, ausStichprobendaten aufGrundgesamtheitseigenschaften zu schließen.
1. Zentraler Grenzwertsatz
Kernidee: Unabhängig davon, wie die Grundgesamtheit verteilt ist, wenn wir eine große Anzahl vonunabhängigenZufallsstichproben aus der Grundgesamtheit ziehen und denMittelwertjeder Stichprobe berechnen, strebt die Verteilung dieser Stichprobenmittelwerte gegen eineNormalverteilung.。
Bedeutung für das maschinelle Lernen: Dies ermöglicht es uns, die Eigenschaften der Normalverteilung zu nutzen, umHypothesentestsdurchzuführen undKonfidenzintervallefür Modellparameter (wie den Mittelwert) zu konstruieren, was eine theoretische Grundlage bietet. Selbst wenn wir die wahre Verteilung der Grundgesamtheit nicht kennen, können wir die Zuverlässigkeit von Schätzungen auf Basis von Stichproben analysieren.
2. Hypothesentest
Es wird verwendet, um zu bestimmen, ob eine Hypothese über die Grundgesamtheit (wie „das neue Medikament ist unwirksam“) durch die Stichprobendaten gestützt wird.
- Nullhypothese (H0): Üblicherweise bedeutet sie „kein Effekt“ oder „kein Unterschied“ (Standardposition).
- Alternativhypothese (H1): Die Hypothese, die wir bestätigen wollen (z. B. „das neue Medikament ist wirksam“).
- p-Wert: Die Wahrscheinlichkeit, die aktuellen Stichprobendaten (oder extremere Daten) zu beobachten, unter der Annahme, dass die Nullhypothese wahr ist.
- Wie man entscheidet: Wenn der p-Wert sehr klein ist (normalerweise < 0.05), bedeutet das, dass die aktuelle Situation unter H0 äußerst unwahrscheinlich ist, sodass wir ausreichend Evidenz haben, umH0 abzulehnenund H1 anzunehmen.
- Signifikanzniveau (α): Der Schwellenwert, der verwendet wird, um zu bestimmen, ob der p-Wert „klein genug“ ist; oft auf 0.05 festgelegt.
Anwendungen im maschinellen Lernen: Wird zur Merkmalsauswahl verwendet, um zu bestimmen, ob zwischen einem Merkmal und der Zielvariable eine statistisch signifikante Korrelation besteht und nicht nur ein zufälliger Zusammenhang.
3. Korrelation und Kausalität
Dies ist eines der am leichtesten zu verwechselnden und wichtigsten Konzepte in der Datenanalyse.
- Korrelation: Misst die Tendenz zweier Variablen, sichgemeinsam zu verändern. Sie wird oft durch den **Korrelationskoeffizienten (von -1 bis 1)** dargestellt.
- 1: Perfekte positive Korrelation (gemeinsam steigen und fallen).
- -1: Perfekte negative Korrelation (eine steigt, während die andere fällt).
- 0: Keine lineare Korrelation.
- Kausalität: Bezieht sich auf eine Variable (Ursache), derenÄnderung direkt zurÄnderung einer anderen Variable (Wirkung) führt.
Hauptunterschied:Korrelation ist nicht gleich Kausalität!
- Klassischer Trugschluss: Eisverkäufe und Ertrinkungsfälle sind im Sommer stark positiv korreliert. Aber das bedeutet nicht, dass das Essen von Eiscreme Ertrinken verursacht. Ihregemeinsame Ursache (Störvariable)Jaist das heiße Wetter.。
- Implikationen für maschinelles Lernen: Modelle des maschinellen Lernens (insbesondere prädiktive Modelle) sind hervorragend darin,Korrelationenzu entdecken, können aber von sich aus nichtKausalität. Starke von Modellen gefundene Korrelationen mit kausalen Beziehungen zu verwechseln, ist in der Praxis ein häufiger Fehler. Die Etablierung kausaler Modelle erfordert strengere experimentelle Designs (z. B. randomisierte kontrollierte Studien) oder spezielle Methoden der kausalen Inferenz.
Praktische Übung: Grundlegende statistische Analyse mit Python
Verwenden wir Python und den bekanntenpandas、seabornBibliothek zur Durchführung einfacher deskriptiver und explorativer statistischer Analyse eines realen Datensatzes.
Beispiel
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np
# 1. Datensatz laden (unter Verwendung des in seaborn integrierten 'tips'-Trinkgeld-Datensatzes)
df = sns.load_dataset('tips')
print("Erste 5 Zeilen des Datensatzes:")
print(df.head())
print(f"\n"Form des Datensatzes: {df.shape}") # Anzahl der Zeilen und Spalten anzeigen
print("\n"Grundlegende Informationen:")
print(df.info())
print("\n"Deskriptive Statistik:")
print(df.describe())
# 2. Numerische Variablen untersuchen: Gesamtrechnung (total_bill) und Trinkgeld (tip)
print(f"\n"Mittlere Gesamtrechnung: {df['total_bill'].mean():.2f}")
print(f"Median der Gesamtrechnung: {df['total_bill'].median():.2f}")
print(f"Standardabweichung der Gesamtrechnung: {df['total_bill'].std():.2f}")
print(f"Korrelationskoeffizient zwischen Trinkgeld und Gesamtrechnung: {df['tip'].corr(df['total_bill']):.3f}")
# 3. Visualisierung
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
# 3.1 Histogramm und Dichteschätzung der Gesamtrechnung
sns.histplot(df['total_bill'], kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Verteilung der Gesamtrechnung')
axes[0, 0].axvline(df['total_bill'].mean(), color='red', linestyle='--', label=f'Mittelwert: {df["total_bill"].mean():.1f}')
axes[0, 0].axvline(df['total_bill'].median(), color='green', linestyle='--', label=f'Median: {df["total_bill"].median():.1f}')
axes[0, 0].legend()
# 3.2 Streudiagramm von Trinkgeld vs. Gesamtrechnung (zur Untersuchung der Korrelation)
sns.scatterplot(data=df, x='total_bill', y='tip', hue='time', ax=axes[0, 1])
axes[0, 1].set_title('Trinkgeld vs. Gesamtrechnung (nach Mahlzeit eingefärbt)')
# 3.3 Boxplot von Trinkgeld gruppiert nach Geschlecht (zum Vergleich von Unterschieden zwischen Gruppen)
sns.boxplot(data=df, x='sex', y='tip', ax=axes[1, 0])
axes[1, 0].set_title('Trinkgeldbetrag nach Geschlecht')
# 3.4 Balkendiagramm der durchschnittlichen Rechnung nach Raucherstatus
bill_by_smoker = df.groupby('smoker')['total_bill'].mean().reset_index()
sns.barplot(data=bill_by_smoker, x='smoker', y='total_bill', ax=axes[1, 1])
axes[1, 1].set_title('Durchschnittliche Gesamtrechnung nach Raucherstatus')
for index, row in bill_by_smoker.iterrows():
axes[1, 1].text(index, row['total_bill']+0.5, f"{row['total_bill']:.1f}", ha='center')
plt.tight_layout()
plt.show()
Übungsaufgaben:
Führe den Code aus: Führe den obigen Code in deiner Python-Umgebung aus, beobachte die Ausgaben und Diagramme.
Interpretiere die Ergebnisse:
- Kannst du aus der Tabelle der deskriptiven Statistik die ungefähre Spannweite und den Median der Gesamtrechnung erkennen?
- Sind Trinkgeld und Gesamtrechnung positiv oder negativ korreliert? Kannst du das aus dem Streudiagramm erkennen?
- Lässt sich aus dem Boxplot ein signifikanter Unterschied zwischen dem Median des Trinkgelds erkennen, das von Männern und Frauen gegeben wird?
Formuliere eine Hypothese: Kannst du basierend auf dem Balkendiagramm der durchschnittlichen Rechnung nach Raucherstatus eine Nullhypothese für denHypothesentestvorschlagen? (Zum Beispiel: H0: Es gibt keinen Unterschied bei der durchschnittlichen Rechnung zwischen Rauchern und Nichtrauchern).
Weitere Erweiterungen