MLOps-Konzepte
Stellen Sie sich vor, Sie sind Datenwissenschaftler. Nach wochenlanger harter Arbeit haben Sie endlich ein Machine-Learning-Modell trainiert, das auf dem Testset hervorragend abschneidet. Aufgeregt übergeben Sie diesemodel.pklDatei an Ihren Softwareentwickler-Kollegen. Doch die Probleme folgen Schlag auf Schlag: Wie kann dieses Modell stabil auf Servern laufen, die Millionen von Anfragen pro Tag verarbeiten? Wie können Sie überwachen, ob seine Leistung bei echten Daten nachlässt? Wenn neue Daten eintreffen, wie trainieren Sie das Modell automatisch neu und aktualisieren es?
Dieses Szenario offenbart eine zentrale Herausforderung in Machine-Learning-Projekten:wie man experimentellen Modellcode in ein zuverlässiges Produktionssystem verwandelt, das kontinuierlich Mehrwert für das Unternehmen schafft.MLOps ist genau eine Reihe von Philosophien und Praktiken, die entstanden sind, um diese Lücke zu schließen.
Einfach gesagt, MLOps istMachine LearningundDevOps, eine Kombination. Es schöpft aus den Automatisierungs-, Kollaborations- und Monitoring-Ideen von DevOps in der Softwareentwicklung und wendet sie auf das Lebenszyklusmanagement von Machine-Learning-Systemen an, mit dem Ziel,eine effiziente Entwicklung, zuverlässige Bereitstellung und einen kontinuierlichen Betrieb von ML-Modellen zu erreichen.。
Was ist MLOps?
Kerndefinition
MLOps ist eine Reihe von Engineering-Praktiken, die verwendet werden, umzu standardisieren und zu automatisieren, und zwardie verschiedenen Schritte im Lebenszyklus von Machine-Learning-Systemen, einschließlich:
- Modellentwicklung und Experimentieren
- Kontinuierliches Modelltraining und -evaluierung
- Modellbereitstellung und Serving
- Überwachung, Wartung und Iteration in Produktionsumgebungen
Ihr ultimatives Ziel ist es,reproduzierbare, skalierbare, auditierbare und kollaborative Machine-Learning-Workflows aufzubauen,damit Modelle schnell und sicher vom Labor in die Produktion gelangen und kontinuierlich ihren Wert erhalten können.
Eine einfache Analogie: Vergleich mit DevOps
Zum besseren Verständnis können wir MLOps mit dem bekannteren DevOps vergleichen:
| Aspekt | DevOps (traditionelle Softwareentwicklung) | MLOps (Entwicklung von Machine-Learning-Systemen) |
|---|---|---|
| Kernliefergegenstand | Anwendung/Service | Machine-Learning-Modell + seine Laufzeitumgebung |
| Iterationsobjekt | Code | Code + Daten + Modell |
| Testfokus | Funktionale Tests, Integrationstests | Modellleistungstests, Datenvalidierung, Concept-Drift-Erkennung |
| Deployment-Einheit | Ausführbare Datei/Container-Image | Modelldatei + Inferenzcode + spezifische Abhängigkeitsumgebung |
| Monitoring-Metriken | CPU-/Speicherauslastung, Anfragelatenz, Fehlerrate | Qualität der Modellvorhersage (z. B. Genauigkeit), Verteilung der Eingabedaten, Geschäftsmetriken |
Dieser Vergleich zeigt die einzigartige Komplexität von MLOps: Es verwaltet nicht nur Code, sondern auchDatenundund ModelleDiese beiden sich dynamisch verändernden Elemente.
Warum MLOps?
Maschinelle Lernprojekte ohne MLOps fallen oft in die „Prototypen-Vorhölle“ — Modelle bleiben für immer in der Experimentierphase stecken und erzielen keine echte Wirkung. MLOps durchbricht diesen Stillstand, indem es die folgenden zentralen Probleme angeht:
1. Herausforderungen bei Zusammenarbeit und Reproduzierbarkeit
- Problem: Data Scientists experimentieren in Jupyter Notebooks mit unübersichtlichen Umgebungsabhängigkeiten, und Experimentierschritte lassen sich nicht reproduzieren.
- MLOps-Lösung: Verwenden Sie Versionskontrolle (z. B. Git) zur Verwaltung von Code, Datenversionen (z. B. DVC) und Modellversionen; nutzen Sie Containerisierung (z. B. Docker), um Umgebungen einzufrieren, sodass jedes Experiment präzise reproduziert werden kann.
2. Komplexität bei Deployment und Betrieb
- Problem: Das manuelle Deployment von Modellen ist mühsam und fehleranfällig; das Modell-Serving lässt sich nur schwer skalieren, und Monitoring fehlt.
- MLOps-Lösung: Automatisieren Sie CI/CD-Pipelines, um Modelle mit einem Klick als API-Dienste bereitzustellen; nutzen Sie cloud-native Technologien für elastische Skalierung; richten Sie umfassende Monitoring-Dashboards ein.
3. Verschlechterung der Modellleistung
- Problem: Die Datenverteilung in der Produktion ändert sich im Laufe der Zeit (Concept Drift), wodurch sich die Modellleistung unbemerkt verschlechtert, ohne dass es jemand bemerkt.
- MLOps-Lösung: Überwachen Sie kontinuierlich die Vorhersageleistung und die Verteilung der Eingabedaten, richten Sie automatisierte Warnmeldungen ein und lösen Sie Modell-Retraining-Workflows aus.
4. Governance- und Compliance-Anforderungen
- Problem: Es ist unmöglich, nachzuvollziehen, welche Modellversion und welche Daten eine bestimmte Vorhersage erzeugt haben, was es schwierig macht, Audit- und regulatorische Anforderungen zu erfüllen.
- MLOps-Lösung: End-to-End-Versionsverfolgung, Experimentprotokollierung und Rückverfolgbarkeit von Vorhersageergebnissen.
Kernkomponenten und Workflow von MLOps
Ein typisches MLOps-System enthält mehrere zusammenarbeitende Komponenten, und sein Workflow kann als Schleife visualisiert werden:
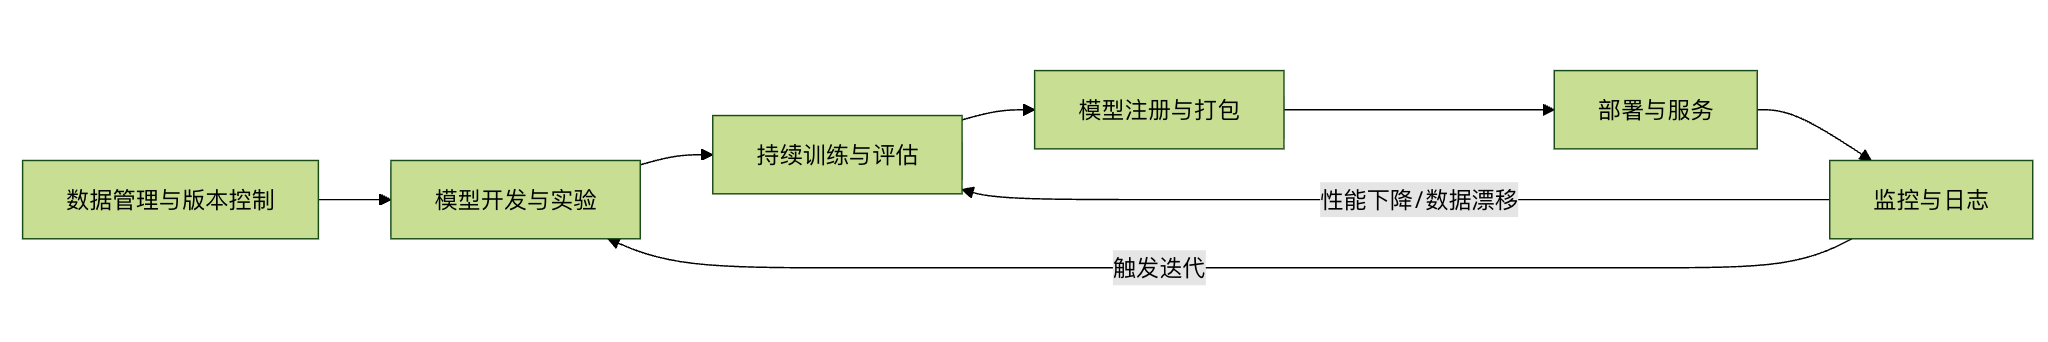
Zerlegen wir jeden Schlüsselschritt im folgenden Diagramm:
1. Datenmanagement und Versionskontrolle
Dies ist der Grundpfeiler von MLOps. Anders als bei Code sind Datendateien oft groß und ändern sich ständig.
- Praxis: Verwenden Sie Tools wieDVC (Data Version Control)oderLakeFS, um Daten- und Modelldateien genauso zu verwalten, wie Git Code verwaltet. Sie speichern Versionsmetadaten der Daten, während die eigentlichen Dateien in Cloud-Speicher abgelegt werden können.
- Beispiel: Jedes Experiment kann einem bestimmten Daten-Snapshot zugeordnet werden, was reproduzierbare Ergebnisse gewährleistet.
2. Modellentwicklung und Experimentieren
Dies ist das Hauptschlachtfeld für Datenwissenschaftler, aber es erfordert ingenieurmäßige Disziplin.
- Praxis: Refaktorisieren Sie experimentellen Code aus Notebooks in modulare Python-Skripte; verwenden SieMLflow TrackingoderWeights & Biases, um Hyperparameter, Metriken und Ausgabemodelle für jedes Experiment aufzuzeichnen, um einen einfachen Vergleich zu ermöglichen.
3. Kontinuierliches Training und Evaluierung
Wenn neue Daten eintreffen oder eine Leistungsverschlechterung erkannt wird, sollte das System in der Lage sein, das Modell automatisch oder halbautomatisch neu zu trainieren.
- Praxis: Erstellen Sie automatisierte Trainingspipelines (z. B. mitKubeflow PipelinesoderApache Airflow). Die Pipeline umfasst Datenvalidierung, Feature-Engineering, Modelltraining und Evaluierung (aufein Validierungssatz, der sich vom Trainingssatz unterscheidet) und weitere Schritte. Nur Modelle, die die Evaluierung bestehen, können zur nächsten Phase übergehen.
4. Modellregistrierung und Verpackung
Trainierte Modelle müssen ordnungsgemäß verwaltet und für die Bereitstellung vorbereitet werden.
- Vorgehen: Verwenden Sie eineModellregistrierung(z. B. MLflow Model Registry). Sie speichert, annotiert und verwaltet Modelle als versionierbare Assets. Modelle werden typischerweise zusammen mit Inferenzcode inDocker-Container-Images verpackt.um die Konsistenz mit der Produktionsumgebung sicherzustellen.
5. Bereitstellung und Serving
Stellen Sie das Modell Benutzern oder anderen Systemen zur Verfügung.
- Modi:
- Batch-Vorhersage: Führen Sie regelmäßig Vorhersagen für große Datenmengen durch und generieren Sie Berichte.
- Echtzeit-API-Serving: Das Modell fungiert als REST-API oder gRPC-Dienst und antwortet in Echtzeit auf Anfragen. Gängige Tools sindFastAPI, TensorFlow Serving, TorchServeoder verwaltete Dienste von Cloud-Anbietern.
- Strategien: Sie könnenBlue-Green-Deploymentoderoder Canary-Releaseseinsetzen, um den Datenverkehr schrittweise auf das neue Modell zu verlagern und das Risiko zu reduzieren.
6. Monitoring und Protokollierung
Dies sind die "Augen", die sicherstellen, dass das Produktionsmodell gesund läuft.
- Monitoring-Inhalte:
- Systemmetriken: API-Latenz, Durchsatz, Fehlerrate, Ressourcenauslastung.
- Modellmetriken: Verteilung der Vorhersageergebnisse, Änderungen wichtiger Merkmale (Erkennung von Data Drift).
- Geschäftsmetriken: Die letztendliche geschäftliche Auswirkung von Modellentscheidungen (z. B. Klickrate, Konversionsrate).
- Praxis: Integrieren Sie Monitoring-Tools (z. B.Prometheus, Grafana) und Logging-Systeme (z. B.ELK Stack), und richten Sie Alarmregeln für Schlüsselmetriken ein.
Ein vereinfachtes MLOps-Praxisbeispiel
Lassen Sie uns einen konzeptionellen Codeablauf durchgehen, um zu sehen, wie man Experiment-Tracking, Modellregistrierung und Paketierung mit MLflow, einem beliebten Tool, implementiert.
Beispiel
import mlflow
import mlflow.sklearn
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# 2. MLflow-Tracking-Server einrichten (angenommen, er läuft bereits lokal)
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mlflow.set_experiment("Iris_Classification")
# 3. Einen Experimentlauf starten
with mlflow.start_run():
# Daten laden und aufteilen
data = load_iris()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)
# Modell definieren und trainieren
n_estimators = 100
model = RandomForestClassifier(n_estimators=n_estimators, random_state=42)
model.fit(X_train, y_train)
# Vorhersagen und bewerten
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
# 4. Experimentinformationen auf dem MLflow Tracking Server protokollieren
mlflow.log_param("n_estimators", n_estimators) # Hyperparameter protokollieren
mlflow.log_metric("accuracy", acc) # Evaluierungsmetriken protokollieren
# 5. Das Modell selbst protokollieren (einschließlich seiner Abhängigkeitsumgebung)
# mlflow.sklearn.log_model protokolliert das Modell und erzeugt eine conda.yaml-Umgebungsdatei
mlflow.sklearn.log_model(model, "random_forest_model")
print(f"Modelltraining abgeschlossen, Genauigkeit: {acc:.4f}")
print(f"Experiment protokolliert. Sie können es in der MLflow-UI ansehen (http://127.0.0.1:5000).")
# 6. (Nächster Schritt) In der MLflow-UI können Sie dieses protokollierte Modell in der Model Registry "registrieren".
# 7. Dann können Sie das Modell aus der Registry abrufen und es mit dem Befehl `mlflow models build-docker` als Docker-Image paketieren.
# 8. Schließlich rollen Sie dieses Image auf Kubernetes oder einem Cloud-Server aus, um das Modell bereitzustellen.
Code-Erklärung:
- Dieses Beispiel demonstriert die Kernaspekte von MLOps:ExperimentverfolgungundModellprotokollierungDiese sind unerlässlich.
mlflow.log_paramundmlflow.log_metricEs gewährleistet die Rückverfolgbarkeit von Experimenten.mlflow.sklearn.log_modelEs speichert nicht nur die Modelldatei, sondern zeichnet auch automatisch die Python-Bibliotheksversionen (Umgebung) auf, die zur Erstellung des Modells verwendet wurden, was ein entscheidender Schritt zur Reproduzierbarkeit ist.- Die anschließenden Schritte Registrierung, Paketierung und Bereitstellung werden normalerweise in der UI oder über CI/CD-Pipelines durchgeführt.
MLOps-Reifegradstufen
Die Implementierung von MLOps ist kein einmaliger Aufwand; allgemein wird angenommen, dass es drei evolutionäre Stufen gibt:
- Basis-MLOps (manueller Prozess): Bereitstellungs- und Trainingsprozesse werden manuell ausgelöst, mit begrenztem Monitoring. Dies ist der Ausgangspunkt für viele Teams.
- Mittleres MLOps (automatisierte Pipelines): Implementiert kontinuierliche Integration (CI)Continuous Integration (CI)undContinuous Delivery (CD)für Modelltraining und Deployment, mit einem hohen Automatisierungsgrad.
- Fortgeschrittenes MLOps (Continuous Training, CT): Das System verfügt über vollständige automatisierte Monitoring- und Feedbackschleifen und kann Datenerfassung, Neutraining, Evaluierung und Deployment automatisch auslösen, wodurch echtesContinuous Training erreicht wird。
Zusammenfassung und Ausblick
MLOps ist kein bestimmtes Tool, sondern einumfassendes Framework, das Kultur, Prozesse und Technologie abdeckt. Es erfordert eine enge Zusammenarbeit zwischen Data Scientists, Machine-Learning-Ingenieuren und Operations-Ingenieuren.
Für Einsteiger ist das Verständnis der MLOps-Konzepte der erste Schritt zum Aufbau zuverlässiger Machine-Learning-Systeme. Sie können mit den folgenden Praktiken beginnen:
- Verwenden Sie Git für eine strikte Code-Versionskontrolle。
- Probieren Sie MLflow aus, um Ihre Experimente und Modelle zu verwalten。
- Stellen Sie Ihr Modell bereit, schreiben Sie zum Beispiel eine einfache Vorhersage-API mit FastAPI.
- Denken Sie darüber nach, wie Sie die Vorhersageergebnisse Ihres Modells überwachen können。
Da maschinelles Lernen in der Industrie zunehmend Anwendung findet, ist MLOps zu einer zentralen Engineering-Fähigkeit geworden, um den Erfolg, die Kontrollierbarkeit und die Skalierbarkeit von ML-Projekten sicherzustellen. Die Beherrschung der MLOps-Denkweise kann Ihnen helfen, die Modelle in Ihren Händen von glänzenden Kristallen im Labor in einen stabilen Motor zu verwandeln, der das Geschäftswachstum antreibt.
Weitere Erweiterungen