Tutorial für maschinelles Lernen
Maschinelles Lernen ist ein Teilgebiet der Künstlichen Intelligenz (KI), das Computersysteme in die Lage versetzt, mithilfe von Daten und Algorithmen automatisch zu lernen und ihre Leistung zu verbessern.
Maschinelles Lernen ermöglicht es Maschinen, durch Erfahrung (Daten) Entscheidungen zu treffen und Vorhersagen zu machen.
Maschinelles Lernen wird in vielen Bereichen umfassend eingesetzt, darunter Empfehlungssysteme, Bilderkennung, Spracherkennung, Finanzanalyse und mehr.
Beispielsweise können Autos durch maschinelles Lernen lernen, Verkehrsschilder, Fußgänger und Hindernisse zu erkennen, um autonomes Fahren zu ermöglichen.
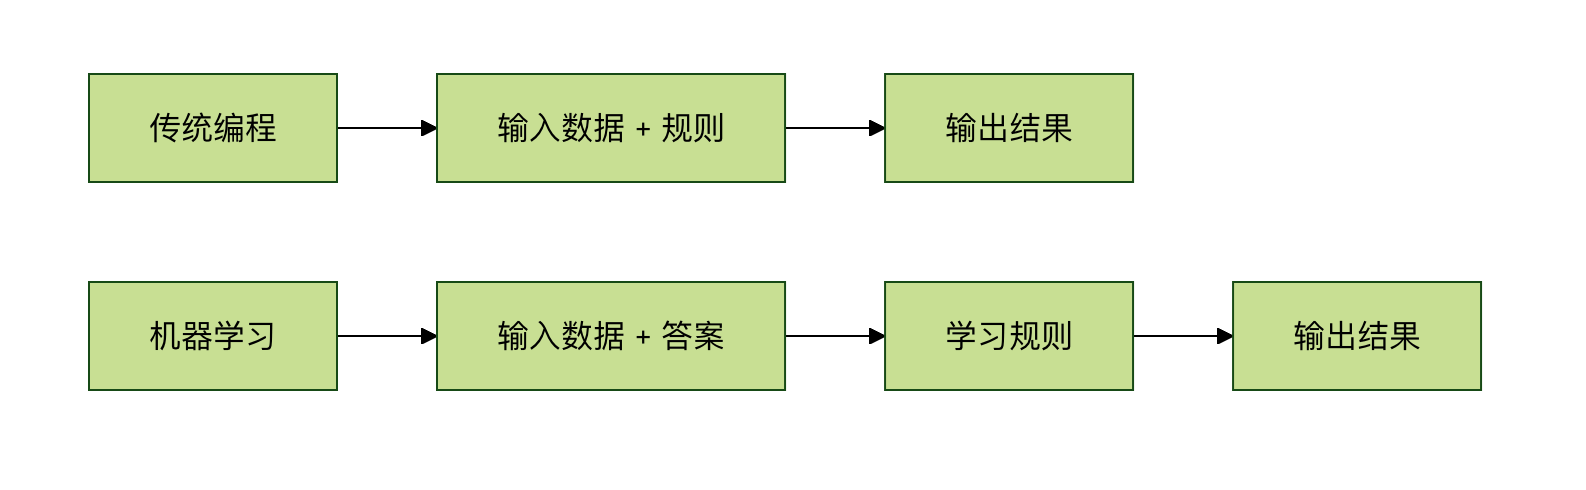
Unterschiede zwischen maschinellem Lernen und traditioneller Programmierung
| Traditionelle Programmierung | Maschinelles Lernen |
|---|---|
| Programmierer schreiben explizite Regeln | Computer lernen Regeln aus Daten |
| Geeignet für Situationen, in denen Probleme klar definiert und Regeln eindeutig sind | Geeignet für komplexe Situationen, in denen Regeln schwer zu definieren sind |
| Beispiel: Ein Taschenrechnerprogramm schreiben | Beispiel: Ein Programm zur Erkennung von Spam-E-Mails schreiben |
Drei wesentliche Elemente des maschinellen Lernens
Maschinelles Lernen besteht aus drei grundlegenden Elementen:
1. Daten
Daten sind der Treibstoff des maschinellen Lernens. Je höher die Qualität und je größer die Menge der Daten, desto besser kann das Modell in der Regel lernen.
- Trainingsdaten: Daten, die zum Trainieren des Modells verwendet werden
- Testdaten: Daten, die verwendet werden, um die Lerneffektivität des Modells zu bewerten
- Daten aus der realen Welt: Neue Daten, auf die das Modell in realen Anwendungen trifft
2. Algorithmus
Algorithmen sind die Lernmethoden des maschinellen Lernens; verschiedene Algorithmen eignen sich für verschiedene Problemtypen.
- Überwachtes Lernen: Lernen mit beschrifteten Antworten
- Unüberwachtes Lernen: Keine beschrifteten Antworten; Muster selbstständig finden
- Bestärkendes Lernen: Lernen durch Versuch und Irrtum und Belohnungen
3. Modell
Das Modell ist das Ergebnis des Lernens, so wie das Wissen, das ein Lernender erwirbt.
- Trainingsprozess: Der Algorithmus lernt Muster aus Daten
- Inferenzprozess: Verwendung der erlernten Muster, um Vorhersagen zu treffen
Beispiel
Als Nächstes verwenden wir ein einfaches Beispiel, um den grundlegenden Arbeitsablauf des maschinellen Lernens zu verstehen.
Wir werden Python verwenden, um ein einfaches lineares Regressionsmodell zu erstellen, das Hauspreise vorhersagt.
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
import seaborn as sns
# Diagrammstil festlegen, damit es besser aussieht
sns.set_style("whitegrid")
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Problem beheben, dass Minuszeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# 1. Daten vorbereiten
# Angenommen, wir haben Daten zur Wohnfläche und den entsprechenden Preisen
# Wohnfläche (Quadratmeter)
house_sizes = np.array([50, 60, 70, 80, 90, 100, 110, 120]).reshape(-1, 1)
# Hauspreis (zehntausend Yuan)
house_prices = np.array([150, 180, 210, 240, 270, 300, 330, 360])
# 2. Modell erstellen und trainieren
# Lineares Regressionsmodell erstellen
model = LinearRegression()
# Trainiere das Modell mit Daten (lerne die Beziehung zwischen Fläche und Preis)
model.fit(house_sizes, house_prices)
# 3. Verwende das Modell, um Vorhersagen zu treffen
# Sage den Preis eines 85 Quadratmeter großen Hauses voraus
predicted_price = model.predict([[85]])
print(f"Vorhergesagter Preis für ein 85 Quadratmeter großes Haus: {predicted_price)
# 4. Visualisiere die Ergebnisse
plt.scatter(house_sizes, house_prices, color='blue', label='Tatsächliche Daten')
plt.plot(house_sizes, model.predict(house_sizes), color='red', label='Vorhersagelinie')
plt.scatter([85], predicted_price, color='green', s=100, label='Vorhersagepunkt')
plt.xlabel('Hausfläche (Quadratmeter)')
plt.ylabel('Hauspreis (zehntausend Yuan)')
plt.title('BEISPIEL Maschinelles-Lernen-Test -- Beziehung zwischen Hausfläche und Preis')
plt.legend()
plt.grid(True)
plt.show()
Ausführungsergebnis:
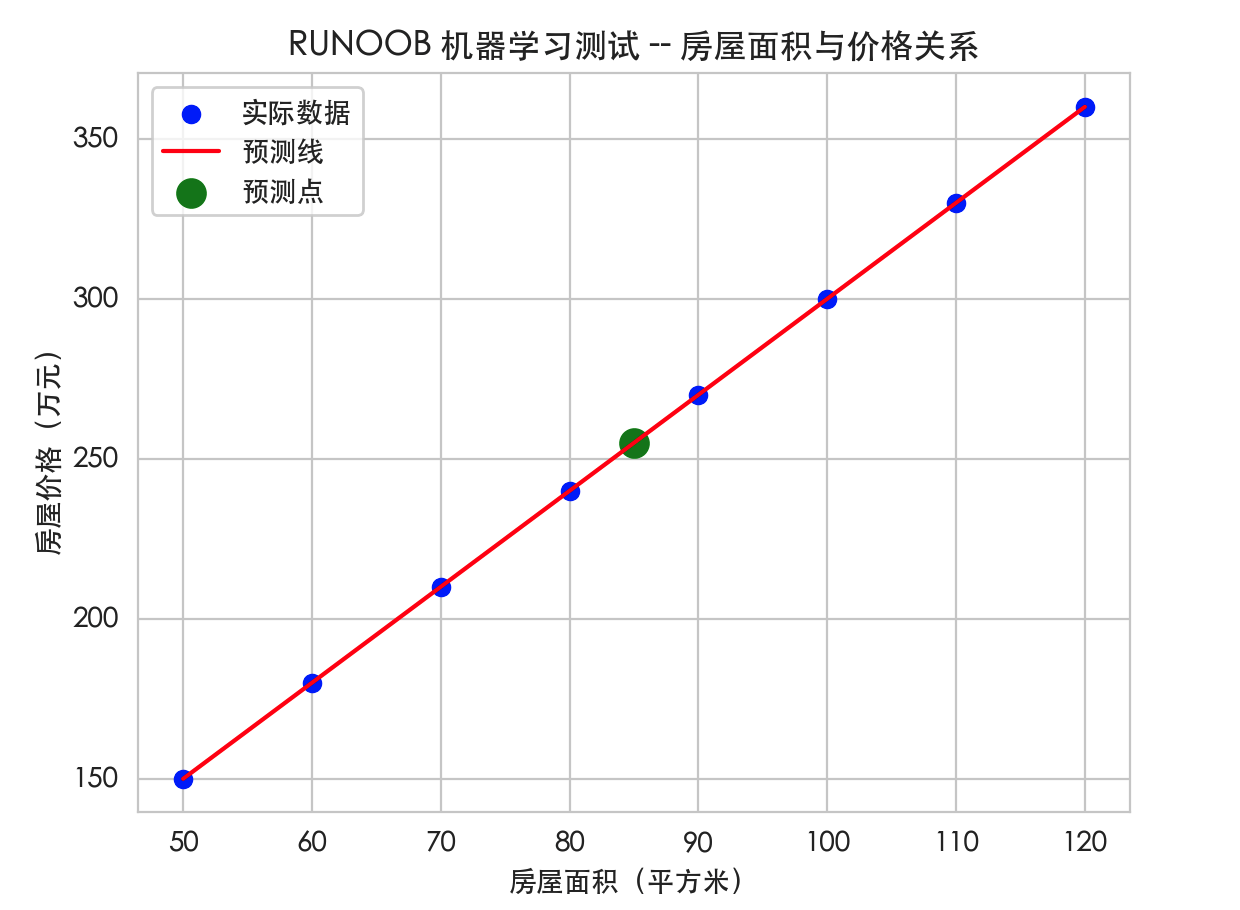
85 平方米的房屋预测价格:255.00 万元
Dieses Beispiel zeigt den grundlegenden Workflow des maschinellen Lernens:
- Die Daten vorbereiten (Wohnfläche und Preis)
- Algorithmus auswählen (lineare Regression)
- Modell trainieren (den Computer die Beziehung zwischen Fläche und Preis lernen lassen)
- Das Modell zur Vorhersage verwenden (den Preis einer neuen Fläche vorhersagen)
Das Ausgabediagramm sieht wie folgt aus: