Einschränkungen der Annahmen
Als zentrale Triebkraft der künstlichen Intelligenz hat maschinelles Lernen in Bereichen wie Bilderkennung, Verarbeitung natürlicher Sprache und Empfehlungssystemen bemerkenswerte Erfolge erzielt.
Allerdings ist maschinelles Lernen, wie jedes leistungsstarke Werkzeug, kein Allheilmittel. Seine Wirksamkeit hängt in hohem Maße von einer Reihe vongrundlegenden Annahmenab. Wenn reale Daten oder Problemszenarien diese Annahmen verletzen, wird die Leistung des Modells stark beeinträchtigt oder führt sogar zu völlig falschen Schlussfolgerungen.
Das Verständnis dieser Einschränkungen und Grenzen, insbesondere derAnnahmeeinschränkungendahinter, ist entscheidend für die korrekte und sichere Anwendung von maschinellem Lernen. Dies hilft uns nicht nur, Fallstricke zu vermeiden, sondern leitet uns auch bei der Auswahl geeigneterer Modelle oder der Verbesserung von Daten, wodurch robustere und vertrauenswürdigere intelligente Systeme entstehen.
Annahme unabhängig und identisch verteilter (IID) Daten
Dies ist eine der grundlegendsten Annahmen im überwachten Lernen.
Grundlegende Konzepte
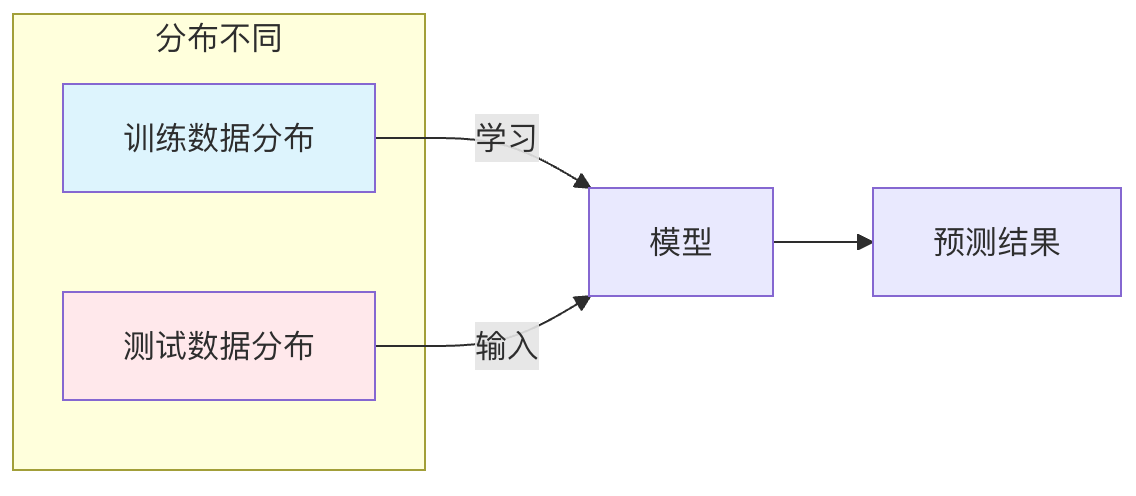
Die IID-Annahme besagt: Die Datenstichproben, die wir zum Trainieren des Modells verwenden, und die Datenstichproben, die das Modell in Zukunft vorhersagen wird, sindaus derselbenWahrscheinlichkeitsverteilungunabhängiggezogen.
- UnabhängigkeitDas Auftreten einer Datenstichprobe beeinflusst nicht die Wahrscheinlichkeit des Auftretens einer anderen Datenstichprobe.
- Identische VerteilungAlle Daten (Trainingssatz, Validierungssatz, Testsatz und zukünftige reale Daten) folgen derselben zugrunde liegenden Datengenerierungsregel.
Warum es wichtig ist
Das Wesen eines Machine-Learning-Modells besteht darin, durch Analyse von Trainingsdaten die zugrunde liegende Regel der Datenverteilung zu lernen. Wenn Trainingsdaten und Testdaten aus unterschiedlichen Verteilungen stammen, bedeutet das, dass die vom Modell gelernten Regeln nicht auf das Testszenario anwendbar sind und seine Vorhersageergebnisse unzuverlässig sein werden.
Konsequenzen und Beispiele von Verletzungen der Annahmen
Wenn diese Annahme verletzt wird, tritt einDistribution-Shift-Problem auf, hauptsächlich in den folgenden Typen:
Kovariaten-Shift
- Beschreibung: Die Eingabemerkmale
Xhaben sich in ihrer Verteilung geändert, aber die Beziehung zwischen der EingabeXund der AusgabeY(d. h. die bedingte VerteilungP(Y|X)) bleibt unverändert. - Beispiel: Ein Katzen- und Hunde-Klassifikator wurde auf einem Datensatz klarer Bilder trainiert, die tagsüber aufgenommen wurden, und dann verwendet, um unscharfe Bilder zu erkennen, die nachts aufgenommen wurden. Hier hat sich die Verteilung von Bildschärfe und Beleuchtung (Merkmale
X) hat sich dramatisch geändert, aber die visuellen Merkmale von "Katzen" und "Hunden" selbst (die BeziehungP(Y|X)) hat sich nicht geändert. Das Modell kann schlecht abschneiden, weil es mit unscharfen nächtlichen Merkmalen nicht vertraut ist.
Label-Verschiebung
- Beschreibung: Die Ausgabe-Labels
Yhaben sich in der Verteilung geändert, aber unter der Bedingung des Labels ist die Verteilung der EingabemerkmaleP(X|Y)bleibt unverändert. - Beispiel: Ein Krankheitsdiagnosemodell wurde auf einem Datensatz trainiert, in dem gesunde Menschen 99% und kranke Menschen 1% ausmachen. In einer anderen Region kann die Prävalenz der Krankheit auf 10% steigen. Obwohl bei wirklich kranken Menschen ihre Symptome (
P(X|Y=患病)) ähnlich sind, hat das Modell zuvor zu wenige "kranke" Stichproben gesehen und kann die Krankheitswahrscheinlichkeit in neuen Daten stark unterschätzen.
Konzeptverschiebung
- Beschreibung: Die Abbildungsbeziehung zwischen der Eingabe
Xund der AusgabeYselbst ändert sich im Laufe der Zeit oder mit der Umgebung. - Beispiel: Modell zur Vorhersage von Aktienkursen. Die Marktregeln, die die Aktienkurse beeinflussen (
P(Y|X)) sind dynamisch und ändern sich im Laufe der Zeit. Ein Modell, das mit Daten des letzten Jahrzehnts trainiert wurde, kann künftige Aktienkurstrends unter völlig neuen wirtschaftspolitischen Rahmenbedingungen möglicherweise nicht genau vorhersagen.
Annahme der Repräsentativität der Trainingsdaten
Diese Annahme erfordert, dassder Trainingsdatensatz den gesamten Datenraum, auf den das Modell treffen kann, vollständig repräsentieren muss.。
Grundlegende Konzepte
Ein Modell kann nur aus Daten lernen, die es "gesehen" hat. Wenn den Trainingsdaten bestimmte wichtige Szenarien, Kategorien oder Merkmalsbereiche fehlen, ist das Modell bei diesen "ungesehenen" Situationen ratlos.
Konsequenzen und Beispiele von Verletzungen der Annahmen
Dies führt direkt zuschlechter Generalisierungsfähigkeitundund Bias-Problemen.
Unvollständige Datenabdeckung
- Beispiel: Wenn in dem Datensatz, der zum Trainieren eines Wahrnehmungsmodells für autonomes Fahren verwendet wird, Bilder von extremem Wetter wie starkem Regen und starkem Schnee fehlen, dann wird die Fähigkeit des Modells, Fußgänger und Fahrzeuge zu erkennen, bei solchem Wetter deutlich nachlassen oder sogar versagen.
Stichprobenauswahlverzerrung
- Beschreibung: Die Datenerhebungsmethode schließt systematisch bestimmte Gruppen aus.
- Beispiel: Wenn die Trainingsdaten eines Gesichtserkennungssystems hauptsächlich von Erwachsenen mit bestimmten Hauttönen und Altersgruppen stammen, ist seine Genauigkeit bei der Erkennung von Kindern, älteren Menschen oder Personen mit anderen Hauttönen deutlich geringer. Das liegt nicht daran, dass das Modell "schlecht" ist, sondern daran, dass es nicht die Gelegenheit hatte, die Merkmale dieser Gruppen zu lernen.
Stationaritätsannahme
Diese Annahme betrifft hauptsächlich Zeitreihendaten und erfordert, dassdie grundlegenden statistischen Eigenschaften der Daten (wie Mittelwert und Varianz) sich im Laufe der Zeit nicht ändern.。
Grundlegende Konzepte
Viele klassische Zeitreihenmodelle (wie ARIMA) oder auf Sequenzdaten angewandte Modelle des maschinellen Lernens nehmen implizit an, dass der Datengenerierungsprozess stationär ist oder durch Methoden wie Differenzbildung stationär gemacht werden kann.
Warum es wichtig ist
Trends oder Saisonalität in nicht stationären Daten dominieren den Lernprozess des Modells, wodurch das Modell eher diese sich mit der Zeit ändernden Scheinmuster als wahre intrinsische Beziehungen erfasst und dadurch schlechte Vorhersagen für die Zukunft trifft.
Konsequenzen und Beispiele von Verletzungen der Annahmen
- Beispiel: Vorhersage des monatlichen Eiscreme-Absatzes. Die Daten zeigen einen klaren Aufwärtstrend (möglicherweise aufgrund des Unternehmenswachstums) und Sommerspitzen. Wenn nicht stationäre Daten direkt zur Modellierung verwendet werden, könnte das Modell einfach vorhersagen, dass der nächste Monat höher ausfällt als dieser Monat, und kann nicht genau zwischen langfristigen Trends, saisonalen Effekten und echten zufälligen Schwankungen unterscheiden. Sobald der Markt gesättigt ist (der Trend sich ändert), werden die Vorhersagen völlig falsch sein.
Annahme der Korrelation zwischen Merkmalen und Labels
Diese Annahme ist es, die maschinelles Lernen ermöglicht – diegrundlegende Voraussetzung:die Merkmale, die wir bereitstellenXmüssen eine gewisse Korrelation mit den Labels aufweisen, die wir vorhersagen wollenYdie vom Modell gelernt werden kann.
Grundlegende Konzepte
Die Aufgabe eines Machine-Learning-Modells ist es, zu entdeckenXundYdieses Assoziationsmuster zwischen ihnen. Wenn die beiden im Wesentlichen unzusammenhängend sind, kann kein Modell Vorhersagen treffen, die besser als zufälliges Raten sind.
Konsequenzen und Beispiele von Verletzungen der Annahmen
- Beispiel: Der Versuch, die Farbe einer Kaffeetasse zu verwenden, um vorherzusagen, ob der Aktienmarkt morgen steigen oder fallen wird. Es gibt nahezu keine bedeutsame kausale Beziehung oder stabile statistische Assoziation zwischen diesen beiden Variablen, daher sind die Ergebnisse ungültig, egal welches fortgeschrittene Modell verwendet wird.
Praktische Übung: Diagnostizieren Sie Ihr Problem
Bevor Sie ein Machine-Learning-Projekt starten, ziehen Sie bitte zunächst die folgende Checkliste mit Fragen in Betracht, um potenzielle Risiken durch Annahmeeinschränkungen einzuschätzen:
- Datenquellenkonsistenz: Wurden meine Trainingsdaten (historische Daten) und die Daten des zukünftigen Anwendungsszenarios unter denselben Bedingungen erzeugt? Gibt es nicht berücksichtigte umweltbedingte, zeitliche oder gruppenbezogene Unterschiede?
- Prüfung der Datenvollständigkeit: Enthält mein Trainingsset alle möglichen wichtigen Kategorien und Randfälle? Gibt es systematische Auslassungen im Datenerhebungsprozess?
- Plausibilität der Beziehung: Sind die von mir ausgewählten Merkmale aus Sicht der Geschäftslogik oder des gesunden Menschenverstands wirklich mit dem Vorhersageziel verbunden?
- Stabilitätsbewertung: Wenn meine Daten eine Zeitreihe sind, schwanken ihre statistischen Eigenschaften (wie der Mittelwert) im Laufe der Zeit drastisch?
Zusammenfassung
Die Einschränkungen der Annahmen des maschinellen Lernens anzuerkennen bedeutet nicht, seinen Wert zu leugnen, sondern eswissenschaftlicherundverantwortungsvollerzu nutzen. In praktischen Anwendungen gibt es fast nie absolut perfekte Annahmen. Unser Ziel ist es, durchDatenvorverarbeitung(wie Datenaugmentierung, Resampling),Algorithmusauswahl(wie Algorithmen, die robust gegenüber Verteilungsverschiebungen sind), undkontinuierliche Modellüberwachung und -bewertung,die Auswirkungen dieser Annahmeverletzungen so weit wie möglich abzumildern.
Ein exzellenter Praktiker des maschinellen Lernens ist nicht nur ein Meister des Parameter-Tunings, sondern auch ein Daten-Detektiv, der die Grenzen von Daten, Problemen und Modellen tiefgehend versteht. Diese Einschränkungen zu verstehen, ist der notwendige Weg vom Anfänger zur Meisterschaft.
Andere Erweiterungen