Gängige Datentypen
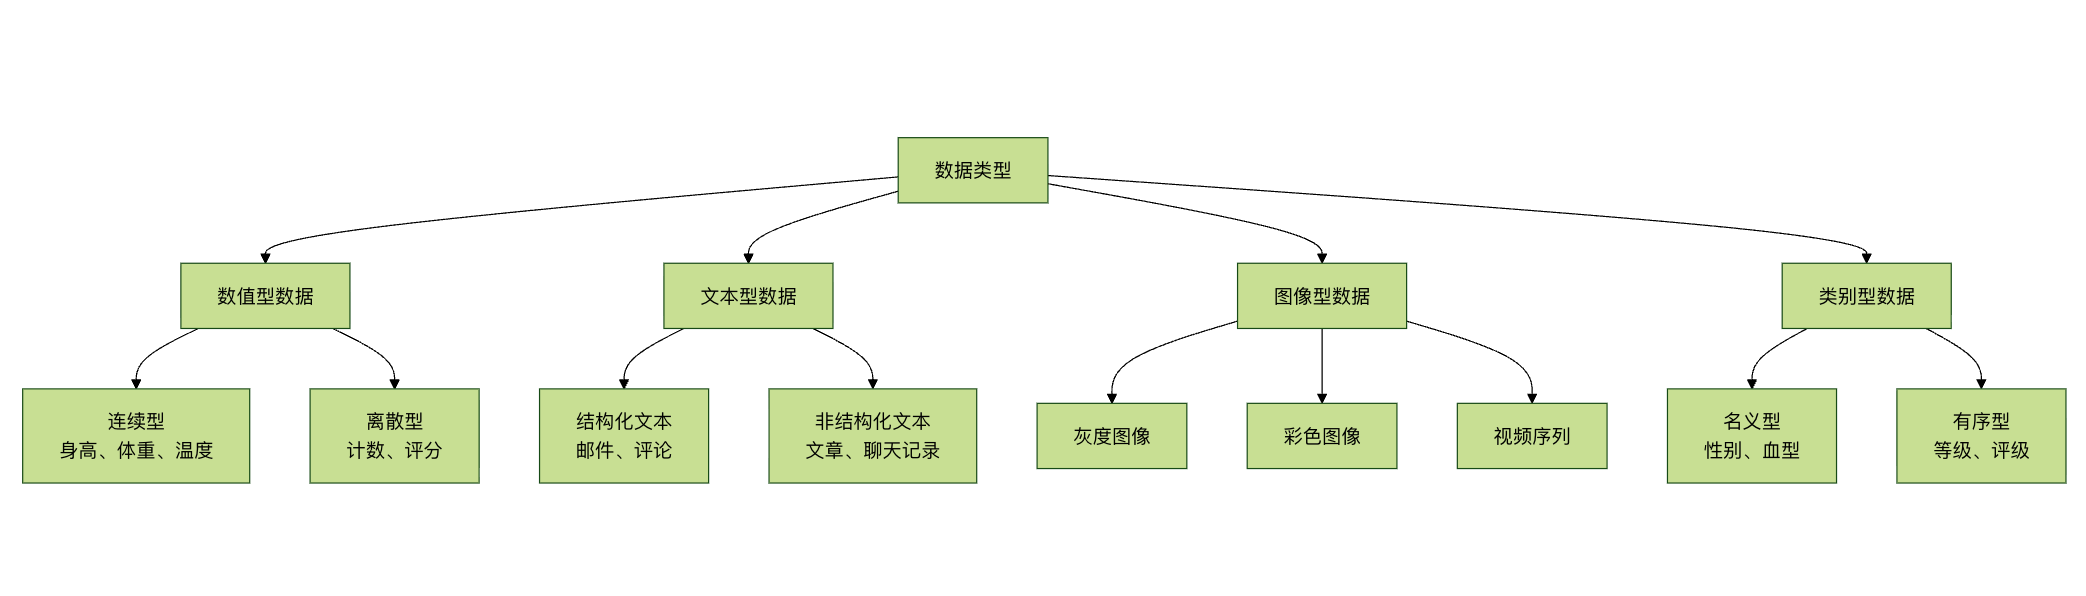
Dieses Kapitel stellt Ihnen die vier häufigsten Datentypen im maschinellen Lernen vor: numerische, textuelle, Bild- und kategorische Daten.
Datentypen sind wie die Arten von Zutaten, verschiedene Zutaten erfordern unterschiedliche Verarbeitungsmethoden. Ebenso erfordern unterschiedliche Datentypen auch unterschiedliche Verarbeitungstechniken und Algorithmen.
Vier Hauptkategorien von Datentypen
Numerische Daten
Was sind numerische Daten?
Numerische Daten sind wie das Ergebnis einer Linealmessung, lassen sich mathematisch verarbeiten und sind der häufigste Datentyp im maschinellen Lernen.
Klassifizierung numerischer Daten
1. Kontinuierliche numerische Daten
Beispiel
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
def continuous_data_example():
"""Beispiel für kontinuierliche numerische Daten"""
print("=== Beispiel für kontinuierliche numerische Daten ===")
# Kontinuierliche Daten generieren
np.random.seed(42)
n_samples = 1000
# Körpergrößendaten (kontinuierlich)
heights = np.random.normal(170, 10, n_samples) # Mittelwert 170, Standardabweichung 10
weights = heights * 0.7 + np.random.normal(0, 5, n_samples) # Gewicht korreliert mit der Körpergröße
temperatures = np.random.normal(36.5, 0.5, n_samples) # Körpertemperatur
# DataFrame erstellen
continuous_data = pd.DataFrame({
'Körpergröße (cm)': heights,
'Gewicht (kg)': weights,
'Körpertemperatur (°C)': temperatures,
'Alter': np.random.randint(18, 65, n_samples)
})
print("Beispiel für kontinuierliche Daten:")
print(continuous_data.head())
print(f"\nInformationen zur Datenstatistik:")
print(continuous_data.describe())
# Kontinuierliche Datenverteilung visualisieren
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(continuous_data['Körpergröße (cm)'], bins=30, alpha=0.7, color='skyblue')
plt.title('Verteilung der Körpergröße')
plt.xlabel('Größe (cm)')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 2)
plt.hist(continuous_data['Gewicht (kg)'], bins=30, alpha=0.7, color='lightgreen')
plt.title('Gewichtsverteilung')
plt.xlabel('Gewicht (kg)')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 3)
plt.hist(continuous_data['Körpertemperatur (°C)'], bins=30, alpha=0.7, color='salmon')
plt.title('Körpertemperaturverteilung')
plt.xlabel('Körpertemperatur (°C)')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 4)
plt.scatter(continuous_data['Größe (cm)'], continuous_data['Gewicht (kg)'], alpha=0.6)
plt.title('Größe vs. Gewicht')
plt.xlabel('Größe (cm)')
plt.ylabel('Gewicht (kg)')
plt.tight_layout()
plt.show()
return continuous_data
# Beispiel ausführen
continuous_df = continuous_data_example()
. Diskrete numerische Daten
Beispiel
def discrete_data_example():
"""Beispiel für diskrete numerische Daten"""
print("\n=== Beispiel für diskrete numerische Daten ===)
# Diskrete Daten generieren
np.random.seed(42)
n_samples = 500
# Diskrete Daten
customer_count = np.random.poisson(10, n_samples) # Poisson-Verteilung: Anzahl der Kunden
product_rating = np.random.randint(1, 6, n_samples) # 1-5-Sternebewertung
defect_count = np.random.binomial(20, 0.1, n_samples) # Binomialverteilung: Anzahl der Defekte
call_duration = np.random.exponential(5, n_samples) * 60 # Exponentialverteilung: Anrufdauer (Sekunden)
# DataFrame erstellen
discrete_data = pd.DataFrame({
'Anzahl der Kunden': customer_count,
'Produktbewertung': product_rating,
'Anzahl der Defekte': defect_count,
'Anrufdauer (Sekunden)': call_duration.astype(int)
})
print("Beispiel für diskrete Daten:")
print(discrete_data.head())
print(f"\nInformationen zur Datenstatistik:")
print(discrete_data.describe())
# Diskrete Daten visualisieren
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(discrete_data['Anzahl der Kunden'], bins=range(0, max(discrete_data['Anzahl der Kunden'])+2),
alpha=0.7, color='orange')
plt.title('Verteilung der Anzahl der Kunden')
plt.xlabel('Anzahl der Kunden')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 2)
value_counts = discrete_data['Produktbewertung'].value_counts().sort_index()
plt.bar(value_counts.index, value_counts.values, color='purple', alpha=0.7)
plt.title('Verteilung der Produktbewertung')
plt.xlabel('Bewertung')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 3)
plt.hist(discrete_data['Anzahl der Defekte'], bins=range(0, max(discrete_data['Anzahl der Defekte'])+2),
alpha=0.7, color='red')
plt.title('Verteilung der Anzahl der Defekte')
plt.xlabel('Anzahl der Defekte')
plt.ylabel('Häufigkeit')
plt.subplot(2, 2, 4)
plt.hist(discrete_data['Anrufdauer (Sekunden)'], bins=30, alpha=0.7, color='brown')
plt.title('Verteilung der Anrufdauer')
plt.xlabel('Anrufdauer (Sekunden)')
plt.ylabel('Häufigkeit')
plt.tight_layout()
plt.show()
return discrete_data
# Beispiel ausführen
discrete_df = discrete_data_example()
Methoden zur Verarbeitung numerischer Daten
Beispiel
class NumericDataProcessor:
def __init__(self):
self.scalers = {}
self.transformers = {}
def detect_outliers(self, data, method='iqr'):
"""Ausreißer erkennen"""
outliers_info = {}
for column in data.select_dtypes(include=[np.number]).columns:
if method == 'iqr':
Q1 = data[column].quantile(0.25)
Q3 = data[column].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = data[(data[column] < lower_bound) |
(data[column] > upper_bound)]
elif method == 'zscore':
z_scores = np.abs((data[column] - data[column].mean()) / data[column].std())
outliers = data[z_scores > 3]
outliers_info[column] = {
'count': len(outliers),
'indices': outliers.index.tolist(),
'percentage': (len(outliers) / len(data)) * 100
}
return outliers_info
def handle_missing_values(self, data, strategy='mean'):
"""Fehlende Werte behandeln"""
processed_data = data.copy()
for column in processed_data.select_dtypes(include=[np.number]).columns:
if processed_data[column].isnull().sum() > 0:
if strategy == 'mean':
processed_data[column].fillna(processed_data[column].mean(), inplace=True)
elif strategy == 'median':
processed_data[column].fillna(processed_data[column].median(), inplace=True)
elif strategy == 'mode':
processed_data[column].fillna(processed_data[column].mode()[0], inplace=True)
elif strategy == 'forward':
processed_data[column].fillna(method='ffill', inplace=True)
elif strategy == 'backward':
processed_data[column].fillna(method='bfill', inplace=True)
return processed_data
def normalize_data(self, data, method='minmax'):
"""Datenstandardisierung"""
from sklearn.preprocessing import MinMaxScaler, StandardScaler, RobustScaler
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
if method == 'minmax':
scaler = MinMaxScaler()
elif method == 'standard':
scaler = StandardScaler()
elif method == 'robust':
scaler = RobustScaler()
else:
raise ValueError("Methode muss 'minmax', 'standard' oder 'robust' sein")
processed_data[numeric_columns] = scaler.fit_transform(processed_data[numeric_columns])
self.scalers[method] = scaler
return processed_data
def create_features(self, data):
"""Feature-Engineering"""
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
# Polynomielle Features erstellen
if len(numeric_columns) >= 2:
col1, col2 = numeric_columns[0], numeric_columns[1]
processed_data[f'{col1}_x_{col2}'] = data[col1] * data[col2]
processed_data[f'{col1}_div_{col2}'] = data[col1] / (data[col2] + 1e-8)
# Statistische Merkmale erstellen
for column in numeric_columns:
processed_data[f'{column}_log'] = np.log1p(data[column])
processed_data[f'{column}_sqrt'] = np.sqrt(np.abs(data[column]))
processed_data[f'{column}_square'] = data[column] ** 2
return processed_data
# Verwendungsbeispiel
processor = NumericDataProcessor()
# Ausreißer erkennen
outliers = processor.detect_outliers(continuous_df)
print("\nErgebnisse der Ausreißererkennung:")
for column, info in outliers.items():
if info['count'] > 0:
print(f"{column}: {info['count']} Ausreißer ({info['percentage']:.2f}%)")
# Datenstandardisierung
normalized_data = processor.normalize_data(continuous_df, method='standard')
print("\nBeispiel für standardisierte Daten:")
print(normalized_data.head())
Textdaten
Was sind Textdaten?
Textdaten sind wie der Ausdruck menschlicher Sprache, enthalten reichhaltige semantische Informationen, erfordern jedoch eine spezielle Verarbeitung, bevor sie von Machine-Learning-Modellen verwendet werden können.
Klassifikation von Textdaten
1. Strukturierte Textdaten
Beispiel
import pandas as pd
import re
from collections import Counter
def structured_text_example():
"""Beispiel für strukturierte Textdaten"""
print("\n=== Beispiel für strukturierte Textdaten ===)
# Strukturierte Textdaten erstellen
structured_data = pd.DataFrame({
'Email ID': range(1, 11),
'Sender': [
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]'
],
'Betreff': [
'Besprechungsmitteilung: Besprechung morgen um 3 pm',
'Produktangebot: neueste Preisliste',
'Kundenfeedback: Umfrage zur Servicezufriedenheit',
'Projektfortschritt: erste Phase abgeschlossen',
'Feiertagsregelung: Mitteilung zum Nationalfeiertag',
'Technisches Update: Ankündigung zum System-Upgrade',
'Wissenschaftliche Konferenz: Hinweis zum Call for Papers',
'Schulungshinweis: Schulung für neue Mitarbeiter',
'Richtliniendokument: neueste Vorschriften',
'Gesundheitserinnerung: Hinweis zur ärztlichen Untersuchung'
],
'Inhaltslänge': [156, 234, 189, 145, 98, 267, 198, 134, 312, 87]
})
print("Beispiel für strukturierte Textdaten:")
print(structured_data)
# Textmerkmalsextraktion
print("\n=== Textmerkmalsanalyse ===)
# E-Mail-Domain-Analyse
domains = [email.split('@')[1] for email in structured_data['Sender']]
domain_counts = Counter(domains)
print(f"Verteilung der E-Mail-Domains: {dict(domain_counts)}")
# Analyse der Betreff-Schlüsselwörter
all_words = []
for subject in structured_data['Subject']:
words = re.findall(r'[\u4e00-\u9fff]+', subject) # Chinesisches Vokabular extrahieren
all_words.extend(words)
word_counts = Counter(all_words)
print(f"Worthäufigkeit im Subjekt: {dict(word_counts)}")
# Statistiken zur Inhaltslänge
print(f"Statistiken zur Inhaltslänge:")
print(structured_data['Content length'].describe())
return structured_data
# Beispiel ausführen
structured_text_df = structured_text_example()
2. Unstrukturierte Textdaten
Beispiel
def unstructured_text_example():
"""Beispiel für unstrukturierte Textdaten"""
print("\n=== Beispiel für unstrukturierte Textdaten ===)
# Unstrukturierte Textdaten erstellen
unstructured_texts = [
"""
Die Technologie der künstlichen Intelligenz entwickelt sich rasant, und in Bereichen wie Deep Learning, maschinellem Lernen und natürlicher Sprachverarbeitung wurden große Durchbrüche erzielt.
Diese Technologien werden in zahlreichen Branchen wie Gesundheitswesen, Finanzen, Bildung und Verkehrswesen weit verbreitet eingesetzt und bringen neue Chancen für die gesellschaftliche Entwicklung.
In Zukunft wird künstliche Intelligenz mit verbesserter Rechenleistung und besseren Algorithmen in mehr Bereichen eine wichtige Rolle spielen.
""",
"""
Das Wetter ist heute wirklich schön, sonnig und windig. Ich habe beschlossen, einen Spaziergang im Park zu machen und diese wundervolle Zeit zu genießen.
Im Park gibt es viele Blumen, rote, gelbe, violette, bunte und sehr schöne. Kleine Vögel singen in den Bäumen,
Schmetterlinge tanzen zwischen den Blumen, und alles scheint so harmonisch und natürlich.
""",
"""
Der Aktienmarkt zeigte sich heute stark, der Shanghai Composite Index stieg um 2.3% und der Shenzhen Component Index um 1.8%.
Tech-Aktien führten die Gewinne an, wobei viele Aktien das Tageslimit erreichten. Analysten sind der Meinung, dass dies hauptsächlich auf die kürzlich eingeführten förderlichen politischen Maßnahmen zurückzuführen ist.
Das Vertrauen der Anleger wurde gestärkt, der Markthandel ist rege und das Handelsvolumen hat deutlich zugenommen.
""",
"""
Ein gesunder Lebensstil umfasst eine ausgewogene Ernährung, mäßige Bewegung, ausreichend Schlaf und eine positive Einstellung.
Es wird empfohlen, täglich Gemüse und Obst zu essen und fettige Speisen zu reduzieren; mindestens 3-mal pro Woche Sport zu treiben, jede Einheit über 30 Minuten;
Achten Sie auf 7-8 Stunden Schlaf; lernen Sie, Gefühle zu regulieren, und bewahren Sie eine positive und optimistische Einstellung.
"""
]
text_categories = ['Technologie', 'Leben', 'Finanzen', 'Gesundheit']
# DataFrame erstellen
unstructured_df = pd.DataFrame({
'Text': unstructured_texts,
'Category': text_categories
})
print("Beispiel für unstrukturierte Textdaten:")
for i, row in unstructured_df.iterrows():
print(f"\nKategorie: {row['类别']}")
print(f"Text: {row['文本'][:100]}...")
return unstructured_df
# Beispiel ausführen
unstructured_text_df = unstructured_text_example()
Methoden zur Verarbeitung von Textdaten
Beispiel
# Methoden zur Verarbeitung von Textdaten
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer
from sklearn.preprocessing import LabelEncoder
class TextDataProcessor:
def __init__(self):
self.vectorizers = {}
self.label_encoders = {}
def clean_text(self, text):
"""Textbereinigung"""
# Sonderzeichen und Zahlen entfernen
text = re.sub(r'[^\u4e00-\u9fff\s]', '', text)
# Überflüssige Leerzeichen entfernen
text = re.sub(r'\s+', ' ', text).strip()
return text
def tokenize_chinese(self, text):
"""Chinesische Wortsegmentierung"""
words = jieba.lcut(text)
# Stoppwörter entfernen (vereinfachte Version)
stop_words = {'of', 'already', 'at', 'is', 'I', 'have', 'and', 'then', 'not', 'person', 'all', 'one', 'one', 'on', 'also', 'very', 'to', 'say', 'want', 'go', 'you', 'will', '-ing', 'none', 'see', 'good', 'self', '这'}
words = [word for word in words if word not in stop_words and len(word) > 1]
return words
def extract_features(self, texts, method='tfidf'):
"""Merkmalsextraktion"""
# Textvorverarbeitung
cleaned_texts = [self.clean_text(text) for text in texts]
if method == 'tfidf':
vectorizer = TfidfVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
elif method == 'count':
vectorizer = CountVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
else:
raise ValueError("Methode muss 'tfidf' oder 'count' sein")
features = vectorizer.fit_transform(cleaned_texts)
self.vectorizers[method] = vectorizer
return features.toarray(), vectorizer.get_feature_names_out()
def analyze_text_statistics(self, texts):
"""Statistische Textanalyse"""
stats = []
for text in texts:
cleaned_text = self.clean_text(text)
words = self.tokenize_chinese(cleaned_text)
stats.append({
'Zeichenanzahl': len(text),
'Zeichenanzahl nach Bereinigung': len(cleaned_text),
'Wortanzahl': len(words),
'Durchschnittliche Wortlänge': np.mean([len(word) for word in words]) if words else 0,
'Anzahl eindeutiger Wörter': len(set(words))
})
return pd.DataFrame(stats)
def encode_labels(self, labels):
"""Label-Kodierung"""
encoder = LabelEncoder()
encoded_labels = encoder.fit_transform(labels)
self.label_encoders['default'] = encoder
return encoded_labels, encoder.classes_
# Verwendungsbeispiel
text_processor = TextDataProcessor()
# Statistische Textanalyse
text_stats = text_processor.analyze_text_statistics(unstructured_text_df['Text'])
print("\nStatistische Textanalyse: ")
print(text_stats)
# Merkmalsextraktion
features, feature_names = text_processor.extract_features(
unstructured_text_df['Text'], method='tfidf'
)
print(f"\nForm der Feature-Matrix: {features.shape}")
print(f"Erste 10 Features: {feature_names[:10]}")
# Label-Kodierung
encoded_labels, label_classes = text_processor.encode_labels(
unstructured_text_df['Category']
)
print(f"\nKodierte Labels: {encoded_labels}")
print(f"Label-Klassen: {label_classes}")
Bilddaten
Was sind Bilddaten?
Bilddaten sind wie eine digitale Darstellung der visuellen Welt, aus Pixeln zusammengesetzt und enthalten reichhaltige räumliche und Farbinformationen.
Klassifikation von Bilddaten
1. Graustufenbild
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from PIL import Image
def grayscale_image_example():
"""Graustufenbild-Beispiel"""
print("\n=== Graustufenbild-Beispiel ===")
# Ein einfaches Graustufenbild erstellen
# Ein 100x100-Graustufenbild erstellen
height, width = 100, 100
# Gradientenbild erstellen
gradient = np.zeros((height, width))
for i in range(height):
gradient[i, :] = i # Vertikaler Gradient
# Schachbrettmuster erstellen
checkerboard = np.zeros((height, width))
for i in range(0, height, 10):
for j in range(0, width, 10):
if (i // 10 + j // 10) % 2 == 0:
checkerboard[i:i+10, j:j+10] = 255
# Kreismuster erstellen
circle = np.zeros((height, width))
center_x, center_y = width // 2, height // 2
radius = 30
for i in range(height):
for j in range(width):
if (i - center_y) ** 2 + (j - center_x) ** 2 <= radius ** 2:
circle[i, j] = 255
# Bild anzeigen
plt.figure(figsize=(12, 4))
plt.subplot(1, 3, 1)
plt.imshow(gradient, cmap='gray')
plt.title('Gradientenbild')
plt.axis('off')
plt.subplot(1, 3, 2)
plt.imshow(checkerboard, cmap='gray')
plt.title('Schachbrettmuster')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.imshow(circle, cmap='gray')
plt.title('Kreismuster')
plt.axis('off')
plt.tight_layout()
plt.show()
# Bilddateninformationen
print(f"Form des Gradientenbildes: {gradient.shape}")
print(f"Datentyp: {gradient.dtype}")
print(f"Pixelwertbereich: {gradient.min()} - {gradient.max()}")
return gradient, checkerboard, circle
# Beispiel ausführen
gradient_img, checkerboard_img, circle_img = grayscale_image_example()
2. Farbbild
Beispiel
def color_image_example():
"""Farbbild-Beispiel"""
print("\n=== Farbbild-Beispiel ===")
height, width = 100, 100
# RGB-Farbbild erstellen
# Roter Farbverlauf
red_gradient = np.zeros((height, width, 3), dtype=np.uint8)
red_gradient[:, :, 0] = np.linspace(0, 255, width) # Rotkanal-Farbverlauf
# Grüner Farbverlauf
green_gradient = np.zeros((height, width, 3), dtype=np.uint8)
green_gradient[:, :, 1] = np.linspace(0, 255, width) # Grünkanal-Farbverlauf
# Blauer Farbverlauf
blue_gradient = np.zeros((height, width, 3), dtype=np.uint8)
blue_gradient[:, :, 2] = np.linspace(0, 255, width) # Blaukanal-Farbverlauf
# Regenbogenmuster
rainbow = np.zeros((height, width, 3), dtype=np.uint8)
for i in range(width):
hue = i / width
# Vereinfachte HSV-zu-RGB-Konvertierung
if hue < 1/3:
rainbow[:, i] = [255 * (1 - 3*hue), 255 * 3*hue, 0]
elif hue < 2/3:
rainbow[:, i] = [0, 255 * (2 - 3*hue), 255 * (3*hue - 1)]
else:
rainbow[:, i] = [255 * (3*hue - 2), 0, 255 * (3 - 3*hue)]
# Bild anzeigen
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.imshow(red_gradient)
plt.title('Roter Farbverlauf')
plt.axis('off')
plt.subplot(2, 2, 2)
plt.imshow(green_gradient)
plt.title('Grüner Farbverlauf')
plt.axis('off')
plt.subplot(2, 2, 3)
plt.imshow(blue_gradient)
plt.title('Blauer Farbverlauf')
plt.axis('off')
plt.subplot(2, 2, 4)
plt.imshow(rainbow)
plt.title('Regenbogenmuster')
plt.axis('off')
plt.tight_layout()
plt.show()
# Informationen zu den Bildkanälen
print(f"Form des Farbbilds: {rainbow.shape}")
print(f"Datentyp: {rainbow.dtype}")
print(f"Pixelwertbereich: {rainbow.min()} - {rainbow.max()}")
return red_gradient, green_gradient, blue_gradient, rainbow
# Beispiel ausführen
red_img, green_img, blue_img, rainbow_img = color_image_example()
Methoden zur Bilddatenverarbeitung
Beispiel
# Methoden zur Bilddatenverarbeitung
from skimage import filters, feature, measure, transform
from skimage.color import rgb2gray, rgb2hsv
class ImageDataProcessor:
def __init__(self):
pass
def resize_image(self, image, target_size):
"""Bild skalieren"""
from skimage.transform import resize
return resize(image, target_size, anti_aliasing=True)
def normalize_image(self, image):
"""Bildnormalisierung"""
return (image - image.min()) / (image.max() - image.min())
def extract_color_features(self, image):
"""Farbeigenschaften extrahieren"""
if len(image.shape) == 3: # Farbbild
# Statistische Merkmale für jeden Kanal berechnen
features = {}
for i, channel in enumerate(['R', 'G', 'B']):
channel_data = image[:, :, i]
features[f'{channel}_mean'] = np.mean(channel_data)
features[f'{channel}_std'] = np.std(channel_data)
features[f'{channel}_min'] = np.min(channel_data)
features[f'{channel}_max'] = np.max(channel_data)
# Farbhistogramm-Merkmale berechnen
hist_r, _ = np.histogram(image[:, :, 0], bins=256, range=(0, 256))
hist_g, _ = np.histogram(image[:, :, 1], bins=256, range=(0, 256))
hist_b, _ = np.histogram(image[:, :, 2], bins=256, range=(0, 256))
features.update({
'hist_r_peak': np.argmax(hist_r),
'hist_g_peak': np.argmax(hist_g),
'hist_b_peak': np.argmax(hist_b)
})
return features
else: # Graustufenbild
return {
'mean': np.mean(image),
'std': np.std(image),
'min': np.min(image),
'max': np.max(image)
}
def extract_texture_features(self, image):
"""Texturmerkmale extrahieren"""
if len(image.shape) == 3:
image = rgb2gray(image)
# Kantenmerkmale berechnen
edges = filters.sobel(image)
edge_density = np.sum(edges > 0) / edges.size
# Lokales binäres Muster berechnen (vereinfachte Version)
lbp = feature.local_binary_pattern(image, P=8, R=1, method='uniform')
lbp_hist, _ = np.histogram(lbp.ravel(), bins=10)
return {
'edge_density': edge_density,
'lbp_hist': lbp_hist.tolist()
}
def augment_image(self, image):
"""Bild-Augmentierung"""
augmented = []
# Originalbild
augmented.append(image)
# Horizontale Spiegelung
augmented.append(np.fliplr(image))
# Vertikale Spiegelung
augmented.append(np.flipud(image))
# Um 90 Grad drehen
augmented.append(np.rot90(image))
# Helligkeitsanpassung
if len(image.shape) == 3:
brightened = np.clip(image * 1.2, 0, 255).astype(np.uint8)
else:
brightened = np.clip(image * 1.2, 0, 1)
augmented.append(brightened)
return augmented
def visualize_image_channels(self, image):
"""Bildkanäle visualisieren"""
if len(image.shape) == 3:
plt.figure(figsize=(12, 3))
plt.subplot(1, 4, 1)
plt.imshow(image)
plt.title('Originalbild')
plt.axis('off')
plt.subplot(1, 4, 2)
plt.imshow(image[:, :, 0], cmap='Reds')
plt.title('Roter Kanal')
plt.axis('off')
plt.subplot(1, 4, 3)
plt.imshow(image[:, :, 1], cmap='Greens')
plt.title('Grüner Kanal')
plt.axis('off')
plt.subplot(1, 4, 4)
plt.imshow(image[:, :, 2], cmap='Blues')
plt.title('Blauer Kanal')
plt.axis('off')
plt.tight_layout()
plt.show()
# Verwendungsbeispiel
image_processor = ImageDataProcessor()
# Farbmerkmale extrahieren
color_features = image_processor.extract_color_features(rainbow_img)
print("\nFarbmerkmale: ")
for key, value in color_features.items():
if not key.startswith('hist'):
print(f"{key}: {value:.2f}")
# Texturmerkmale extrahieren
texture_features = image_processor.extract_texture_features(checkerboard_img)
print("\nTexturmerkmale: ")
for key, value in texture_features.items():
if key != 'lbp_hist':
print(f"{key}: {value:.4f}")
# Bild-Augmentierung
augmented_images = image_processor.augment_image(circle_img)
print(f"\nBild-Augmentierung: {len(augmented_images)} Varianten generiert")
# Bildkanäle visualisieren
image_processor.visualize_image_channels(rainbow_img)
Kategorische Daten
Was sind kategoriale Daten?
Kategoriale Daten sind wie Klassifikationslabels, die verschiedene Kategorien oder Gruppen darstellen und nicht mathematisch verarbeitet werden können.
Klassifikation kategorialer Daten
1. Nominale Daten
Beispiel
def nominal_data_example():
"""Beispiel für nominale Daten"""
print("\n=== Beispiel für nominale Daten ===")
# Nominale Daten erstellen
nominal_data = pd.DataFrame({
'Student ID': range(1, 11),
'Name': ['Zhang San', 'Li Si', 'Wang Wu', 'Zhao Liu', 'Qian Qi', 'Sun Ba', 'Zhou Jiu', 'Wu Shi', 'Zheng Shiyi', 'Chen Shier'],
'Geschlecht': ['Männlich', 'Weiblich', 'Männlich', 'Männlich', 'Weiblich', 'Weiblich', 'Männlich', 'Weiblich', 'Männlich', 'Weiblich'],
'Blutgruppe': ['A', 'B', 'O', 'AB', 'A', 'B', 'O', 'AB', 'A', 'O'],
'Stadt': ['Peking', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Peking', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Peking', 'Shanghai'],
'Studienfach': ['Informatik', 'Mathematik', 'Physik', 'Chemie', 'Informatik', 'Mathematik', 'Physik', 'Chemie', 'Informatik', 'Mathematik']
})
print("Beispiel für Nominaldaten:")
print(nominal_data)
# Kategoriale statistische Analyse
print("\n=== Kategoriale statistische Analyse ===)
for column in nominal_data.select_dtypes(include=['object']).columns:
if column != 'Name': # Namensspalte überspringen
value_counts = nominal_data[column].value_counts()
print(f"\n{column} Verteilung:")
print(value_counts)
print(f"Anzahl eindeutiger Werte: {len(value_counts)}")
return nominal_data
# Beispiel ausführen
nominal_df = nominal_data_example()
2. Ordinale Daten
Beispiel
def data_example():
"""Beispiel für ordinale Daten"""
print("\n=== Beispiel für ordinale Daten ===)
# Ordinale Daten erstellen
ordinal_data = pd.DataFrame({
'Produkt-ID': range(1, 11),
'Produktname': [f'Produkt {i}' for i in range(1, 11)],
'Qualitätsbewertung': ['Ausgezeichnet', 'Gut', 'Durchschnittlich', 'Qualitätsbewertung', 'Gut', 'Durchschnittlich', 'Schlecht', 'Ausgezeichnet', 'Gut', 'Durchschnittlich'],
'Kundenzufriedenheit': ['Sehr zufrieden', 'Zufrieden', 'Neutral', 'Sehr zufrieden', 'Zufrieden', 'Neutral', 'Unzufrieden', 'Sehr zufrieden', 'Zufrieden', 'Neutral'],
'Preisspanne': ['Hoch', 'Mittel', 'Niedrig', 'Hoch', 'Mittel', 'Niedrig', 'Niedrig', 'Hoch', 'Mittel', 'Mittel'],
'Verkaufsrangliste': [1, 3, 5, 2, 4, 7, 9, 6, 8, 10]
})
print("Beispiel für ordinale Daten:")
print(ordinal_data)
# Statistische Analyse ordinaler Daten
print("\n=== Statistische Analyse ordinaler Daten ===)
# Reihenfolge definieren
quality_order = ['Schlecht', 'Durchschnittlich', 'Gut', 'Ausgezeichnet']
satisfaction_order = ['Unzufrieden', 'Neutral', 'Zufrieden', 'Sehr zufrieden']
price_order = ['Niedrig', 'Mittel', 'Hoch']
# In ordinale Kategorien umwandeln
ordinal_data['quality_rating_ordered'] = pd.Categorical(
ordinal_data['quality_rating'], categories=quality_order, ordered=True
)
ordinal_data['customer_satisfaction_ordered'] = pd.Categorical(
ordinal_data['customer_satisfaction'], categories=satisfaction_order, ordered=True
)
ordinal_data['price_range_ordered'] = pd.Categorical(
ordinal_data['price_range'], categories=price_order, ordered=True
)
# Statistische Analyse
for column in ['quality_rating_ordered', 'customer_satisfaction_ordered', 'price_range_ordered']:
print(f"\n{column} Verteilung:")
value_counts = ordinal_data[column].value_counts().sort_index()
print(value_counts)
# Median berechnen
median_value = ordinal_data[column].median()
print(f"Median: {median_value}")
return ordinal_data
# Beispiel ausführen
ordinal_df = ordinal_data_example()
Methoden zur Verarbeitung kategorischer Daten
Beispiel
# Methoden zur Verarbeitung kategorischer Daten
from sklearn.preprocessing import LabelEncoder, OneHotEncoder, OrdinalEncoder
class CategoricalDataProcessor:
def __init__(self):
self.encoders = {}
self.feature_names = {}
def label_encoding(self, data, columns):
"""Label-Kodierung"""
encoded_data = data.copy()
for column in columns:
encoder = LabelEncoder()
encoded_data[f'{column}_encoded'] = encoder.fit_transform(data[column])
self.encoders[f'{column}_label'] = encoder
print(f"{column} Label-Kodierung:")
for i, category in enumerate(encoder.classes_):
print(f" {category} - {i}")
return encoded_data
def one_hot_encoding(self, data, columns):
"""One-Hot-Kodierung"""
encoded_data = data.copy()
for column in columns:
encoder = OneHotEncoder(sparse=False, drop='first') # Vermeide Mehrklassen
encoded_features = encoder.fit_transform(data[[column]])
# Neue Spaltennamen erstellen
feature_names = [f{category}' for category in encoder.categories_[0][1:]]
# Zum DataFrame hinzufügen
for i, feature_name in enumerate(feature_names):
encoded_data[feature_name] = encoded_features[:, i]
self.encoders[f'{column}_onehot'] = encoder
self.feature_names[f'{column}_onehot'] = feature_names
print(f"{column} One-Hot-Encoding: {len(feature_names)} Merkmale erstellt")
return encoded_data
def ordinal_encoding(self, data, columns, categories_list):
"""Ordinale Kodierung"""
encoded_data = data.copy()
for column, categories in zip(columns, categories_list):
encoder = OrdinalEncoder(categories=[categories])
encoded_data[f'{column}_ordinal'] = encoder.fit_transform(data[[column]])
self.encoders[f'{column}_ordinal'] = encoder
print(f"{column} Ordinalkodierung:")
for i, category in enumerate(categories):
print(f" {category} - {i}")
return encoded_data
def target_encoding(self, data, categorical_column, target_column):
"""Zielkodierung"""
encoded_data = data.copy()
# Berechne den Zielmittelwert für jede Kategorie
target_means = data.groupby(categorical_column)[target_column].mean()
# Kodierung anwenden
encoded_data[f'{categorical_column}_target'] = data[categorical_column].map(target_means)
print(f"{categorical_column} Zielkodierung:")
for category, mean_value in target_means.items():
print(f" {category} -> {mean_value:.4f}")
return encoded_data
def frequency_encoding(self, data, columns):
"""Häufigkeitskodierung"""
encoded_data = data.copy()
for column in columns:
# Häufigkeit für jede Kategorie berechnen
frequency = data[column].value_counts(normalize=True)
# Kodierung anwenden
encoded_data[f'{column}_frequency'] = data[column].map(Frequenz)
print(f"{column} Häufigkeitskodierung:")
for category, freq in frequency.head().items():
print(f" {category} -> {freq:.4f}")
return encoded_data
def analyze_categorical_importance(self, data, categorical_columns, target_column):
"""Bedeutung kategorischer Merkmale analysieren"""
importance_scores = {}
for column in categorical_columns:
# Berechne die mittlere Zielwertdifferenz für jede Kategorie
category_means = data.groupby(column)[target_column].mean()
mean_difference = category_means.max() - category_means.min()
# Berechne die Anzahl der Kategorien
unique_count = data[column].nunique()
# Einfacher Wichtigkeitswert
importance = mean_difference * np.log(unique_count + 1)
importance_scores[column] = importance
# Sortieren
sorted_importance = sorted(importance_scores.items(), key=lambda x: x[1], reverse=True)
print("\nWichtigkeit kategorischer Merkmale:")
for column, importance in sorted_importance:
print(f"{column}: {importance:.4f}")
return importance_scores
# Verwendungsbeispiel
cat_processor = CategoricalDataProcessor()
# Numerisches Ziel für nominale Daten hinzufügen
nominal_df_with_target = nominal_df.copy()
nominal_df_with_target['Score'] = np.random.randint(60, 100, len(nominal_df))
# Label-Kodierung
label_encoded = cat_processor.label_encoding(
nominal_df_with_target, ['Gender', 'Blood Type', 'City']
)
# One-Hot-Encoding
onehot_encoded = cat_processor.one_hot_encoding(
nominal_df_with_target, ['Major']
)
# Target-Encoding
target_encoded = cat_processor.target_encoding(
nominal_df_with_target, 'City', 'Score'
)
# Häufigkeitskodierung
frequency_encoded = cat_processor.frequency_encoding(
nominal_df_with_target, ['Gender', 'Blood Type']
)
# Merkmalswichtigkeit analysieren
importance_scores = cat_processor.analyze_categorical_importance(
nominal_df_with_target, ['Gender', 'Blood Type', 'City', 'Major'], 'Score'
)
Multimodale Datenfusion
Beispiel für Datentypfusion
Beispiel
class MultiModalDataProcessor:
def __init__(self):
self.numeric_processor = NumericDataProcessor()
self.text_processor = TextDataProcessor()
self.image_processor = ImageDataProcessor()
self.categorical_processor = CategoricalDataProcessor()
def create_multimodal_dataset(self):
"""Multimodalen Datensatz erstellen"""
print("\n=== Beispiel für multimodalen Datensatz ===)
n_samples = 100
# Numerische Merkmale
numeric_features = {
'Alter': np.random.randint(18, 65, n_samples),
'Einkommen': np.random.normal(50000, 15000, n_samples),
'Berufserfahrung': np.random.randint(0, 20, n_samples)
}
# Kategorische Merkmale
categorical_features = {
'Geschlecht': np.random.choice(['Männlich', 'Weiblich'], n_samples),
'Bildungsniveau': np.random.choice(['High School', "Bachelor", "Master", 'PhD'], n_samples),
'Stadt': np.random.choice(['Peking', 'Shanghai', 'Guangzhou', 'Shenzhen'], n_samples)
}
# Textmerkmale
text_features = [
f"Dies ist die Textbeschreibung von Beispiel {i}, die einige grundlegende Informationen und Merkmale enthält."
for i in range(n_samples)
]
# Bildmerkmale (simuliert)
image_features = np.random.rand(n_samples, 64, 64, 3) # Simuliere 64x64-Farbbilder
# Zielvariable
target = np.random.choice([0, 1], n_samples)
# Datensatz erstellen
dataset = {
'numeric': pd.DataFrame(numeric_features),
'categorical': pd.DataFrame(categorical_features),
'text': text_features,
'image': image_features,
'target': target
}
print(f"Datensatzgröße: {n_samples}")
print(f"Numerische Merkmale: {list(numeric_features.keys())}")
print(f"Kategorische Merkmale: {list(categorical_features.keys())}")
print(f"Textmerkmale: {len(text_features)} Einträge")
print(f"Bildmerkmale: {image_features.shape}")
print(f"Zielvariable: {np.bincount(target)}")
return dataset
def process_multimodal_data(self, dataset):
"""Multimodale Daten verarbeiten"""
print("\n=== Multimodale Datenverarbeitung ===)
processed_features = {}
# Numerische Merkmale verarbeiten
numeric_data = dataset['numeric']
numeric_processed = self.numeric_processor.normalize_data(numeric_data, method='standard')
processed_features['numeric'] = numeric_processed
# Kategorische Merkmale verarbeiten
categorical_data = dataset['categorical']
categorical_processed = self.categorical_processor.one_hot_encoding(
categorical_data, list(categorical_data.columns)
)
# Nur kodierte Spalten behalten
categorical_encoded = categorical_processed.select_dtypes(include=[np.number])
processed_features['categorical'] = categorical_encoded
# Textmerkmale verarbeiten
text_data = dataset['text']
text_features, _ = self.text_processor.extract_features(text_data, method='tfidf')
processed_features['text'] = text_features
# Bildmerkmale verarbeiten
image_data = dataset['image']
# Einfache Bildmerkmale extrahieren (Mittelwert, Standardabweichung usw.)
image_features = []
for img in image_data:
features = self.image_processor.extract_color_features(img)
feature_vector = list(features.values())[:10] # Die ersten 10 Merkmale nehmen
image_features.append(feature_vector)
processed_features['image'] = np.array(image_features)
# Verarbeitungsergebnisse ausgeben
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
print(f"{modality} Merkmale: {features.shape}")
else:
print(f"{modality} Merkmale: {features.shape}")
return processed_features
def fuse_features(self, processed_features):
"""Merkmalsfusion"""
print("\n=== Merkmalsfusion ===)
# Alle Merkmale zusammenführen
feature_arrays = []
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
feature_arrays.append(features.values)
else:
feature_arrays.append(features)
# Horizontale Verkettung
fused_features = np.hstack(feature_arrays)
print(f"Form der fusionierten Merkmale: {fused_features.shape}")
return fused_features
# Verwendungsbeispiel
multimodal_processor = MultiModalDataProcessor()
# Multimodalen Datensatz erstellen
multimodal_dataset = multimodal_processor.create_multimodal_dataset()
# Multimodale Daten verarbeiten
processed_multimodal = multimodal_processor.process_multimodal_data(multimodal_dataset)
# Merkmalsfusion
fused_features = multimodal_processor.fuse_features(processed_multimodal)