K-Nächste-Nachbarn-Algorithmus
K-Nearest Neighbors (KNN) ist ein einfacher und häufig verwendeter Klassifikations- und Regressionsalgorithmus.
K-Nearest Neighbors ist eine Art des überwachten Lernens. Seine Kernidee besteht darin, den Abstand zwischen der zu klassifizierenden Probe und jeder Probe im Trainingsdatensatz zu berechnen, die K Proben mit dem kleinsten Abstand zu finden und dann die Klasse oder den Wert der Zielprobe basierend auf den Klassen oder Werten dieser K Proben vorherzusagen.
Grundprinzipien von KNN
Die Grundprinzipien des KNN-Algorithmus lassen sich in den folgenden Schritten zusammenfassen:
- Distanz berechnen: Berechnen Sie den Abstand zwischen der zu klassifizierenden Probe und jeder Probe im Trainingsdatensatz. Gängige Abstandsmetriken sind euklidischer Abstand, Manhattan-Abstand usw.
- K nächste Nachbarn auswählen: Basierend auf den berechneten Distanzen werden die K Stichproben mit der kleinsten Distanz ausgewählt.
- Abstimmung oder Mittelwertbildung: Bei Klassifikationsproblemen ist die Klasse, die unter den K nächsten Nachbarn am häufigsten vorkommt, die Klasse der Zielstichprobe; bei Regressionsproblemen ist der Durchschnittswert der K nächsten Nachbarn der Wert der Zielstichprobe.
Eigenschaften von KNN
- Einfach und leicht zu verstehen: Das Prinzip des KNN-Algorithmus ist sehr einfach, leicht zu verstehen und zu implementieren.
- Kein Training erforderlich: KNN ist ein "Lazy-Learning"-Algorithmus, der keinen expliziten Trainingsprozess erfordert; alle Berechnungen werden zum Vorhersagezeitpunkt durchgeführt.
- Keine Annahmen über die Datenverteilung: KNN trifft keine Annahmen über die Datenverteilung, was es für verschiedene Datentypen geeignet macht.
- Hohe Rechenkomplexität: Da KNN zum Vorhersagezeitpunkt Distanzen zu allen Stichproben berechnen muss, wird die Rechenkomplexität bei großen Datensätzen hoch.
Vor- und Nachteile des KNN-Algorithmus
Vorteile
- Einfach und leicht anzuwenden: Der KNN-Algorithmus ist im Prinzip einfach und leicht zu verstehen und zu implementieren.
- Kein Training erforderlich: KNN erfordert keinen expliziten Trainingsprozess; alle Berechnungen werden zum Vorhersagezeitpunkt durchgeführt.
- Geeignet für Multiklassenklassifikation: KNN kann Multiklassenklassifikationsprobleme problemlos bewältigen.
Nachteile
- Hohe Rechenkomplexität: KNN muss zum Vorhersagezeitpunkt Distanzen zu allen Stichproben berechnen, und die Rechenkomplexität ist bei großen Datensätzen hoch.
- Empfindlich gegenüber Rauschen: KNN ist relativ empfindlich gegenüber verrauschten Daten, was die Vorhersageergebnisse beeinträchtigen kann.
- Notwendigkeit, einen geeigneten K-Wert zu wählen: Die Wahl des K-Werts beeinflusst die Modellleistung stark, und die Auswahl eines geeigneten K-Werts ist eine Herausforderung.
Implementierungsschritte des KNN-Algorithmus
1. Notwendige Bibliotheken importieren
Zuerst müssen wir einige gängige Python-Bibliotheken importieren, wie z. B.numpyfür numerische Berechnungen,matplotlibzum Plotten,sklearnzum Laden von Datensätzen und zur Bewertung von Modellen.
Beispiel
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2. Datensatz laden
Wir verwendensklearnfromload_irisFunktion zum Laden des klassischen Iris-Datensatzes. Dieser Datensatz enthält 150 Stichproben, jede mit 4 Merkmalen, und das Ziel ist, die Stichproben in 3 Klassen zu klassifizieren.
Beispiel
iris = datasets.load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale zur Visualisierung verwenden
y = iris.target
3. Datenvorverarbeitung
Bevor der KNN-Algorithmus angewendet wird, ist es normalerweise notwendig, die Daten zu standardisieren, um sicherzustellen, dass jedes Merkmal gleichermaßen zur Distanzberechnung beiträgt.
Beispiel
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. KNN-Modell trainieren
Als Nächstes verwenden wirsklearnfromKNeighborsClassifierum das KNN-Modell zu trainieren. Hier wählen wir K=3, d. h., wir wählen die 3 nächsten Nachbarn aus.
Beispiel
knn = KNeighborsClassifier(n_neighbors=3)
# Modell trainieren
knn.fit(X_train, y_train)
5. Vorhersage und Evaluierung
Verwenden Sie das trainierte Modell, um auf dem Testsatz Vorhersagen zu treffen und die Genauigkeit des Modells zu berechnen.
Beispiel
y_pred = knn.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Genauigkeit des KNN-Modells: {accuracy:.4f}")
Die Ausgabe sieht wie folgt aus:
KNN模型的准确率: 0.7556
6. KNN-Klassifikationsergebnisse visualisieren
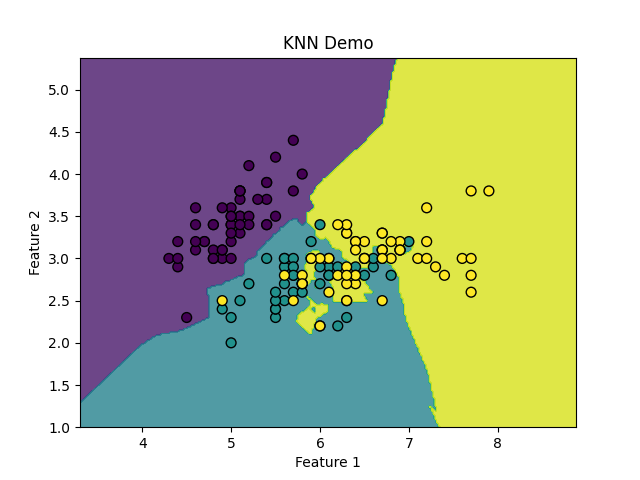
Um den Klassifikationseffekt von KNN intuitiver zu verstehen, können wir Datenpunkte und Entscheidungsgrenzen darstellen.
Hier verwenden wir die ersten beiden Merkmale des Datensatzes als Eingabemerkmale.
Beispiel
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
# Iris-Datensatz laden
iris = datasets.load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale zur Visualisierung verwenden
y = iris.target
# Teile den Datensatz in Trainings- und Testsets auf
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# KNN-Modell erstellen, K-Wert auf 3 setzen
knn = KNeighborsClassifier(n_neighbors=3)
# Modell trainieren
knn.fit(X_train, y_train)
# Vorhersage auf dem Testset
y_pred = knn.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Genauigkeit des KNN-Modells: {accuracy:.4f}")
# Entscheidungsgrenze und Datenpunkte plotten
h = .02 # Schrittweite des Gitters
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
# Ein 2D-Gitternetz erstellen, das verschiedene Stichprobenräume darstellt
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
# Das KNN-Modell verwenden, um die Klasse jedes Punkts auf dem Gitter vorherzusagen
Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Entscheidungsgrenze plotten
plt.contourf(xx, yy, Z, alpha=0.8)
# Trainingsdatenpunkte plotten
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o', s=50)
plt.title("KNN Demo")
plt.xlabel("Merkmal 1")
plt.ylabel("Merkmal 2")
plt.show()
Die Anzeige ist wie folgt:
7. K-Wert anpassen
Die Wahl des K-Werts hat einen wichtigen Einfluss auf die Modellleistung.
Normalerweise wählen wir den besten K-Wert durch Kreuzvalidierung oder Visualisierungsmethoden.
Beispiel
k_range = range(1, 21)
accuracies = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
accuracies.append(accuracy)
# Beziehung zwischen K-Wert und Genauigkeit darstellen
plt.plot(k_range, accuracies, marker='o')
plt.title("Beziehung zwischen K-Wert und Genauigkeit")
plt.xlabel("K-Wert")
plt.ylabel("Genauigkeit")
plt.show()
8. Verwendung von KNN für Regressionsaufgaben
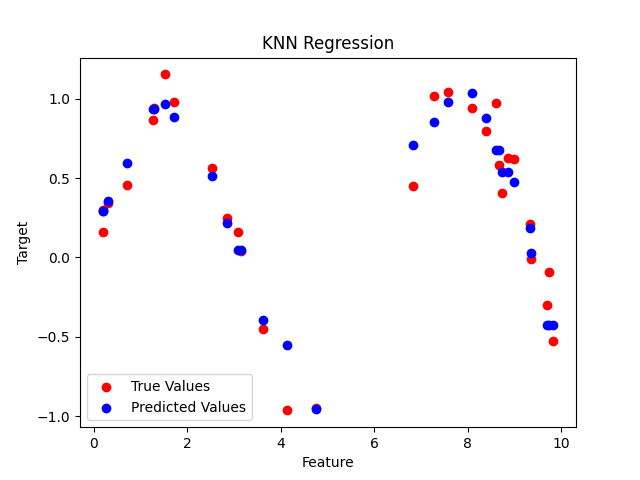
KNN kann auch für Regressionsaufgaben verwendet werden (KNN-Regression).
Bei Regressionsaufgaben prognostiziert KNN die Ausgabe durch Mittelung der Zielwerte der K nächsten Nachbarn.
Beispiel
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
# Beispieldaten generieren
X = np.random.rand(100, 1) * 10
y = np.sin(X).ravel() + 0.1 * np.random.randn(100)
# In Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# KNN-Regressionsmodell erstellen
knn_reg = KNeighborsRegressor(n_neighbors=5)
# Modell trainieren
knn_reg.fit(X_train, y_train)
# Vorhersage auf dem Testset
y_pred = knn_reg.predict(X_test)
# Regressionsergebnisse visualisieren
plt.scatter(X_test, y_test, color='red', label='Wahre Werte')
plt.scatter(X_test, y_pred, color='blue', label='Vorhergesagte Werte')
plt.title("KNN-Regression")
plt.xlabel("Merkmal")
plt.ylabel("Zielwert")
plt.legend()
plt.show()
Rot zeigt wahre Werte an, Blau zeigt vorhergesagte Werte an: