Regularisierung
Stellen Sie sich vor, wir lernen Fahrradfahren. Am Anfang sind wir vielleicht sehr nervös, halten den Lenker fest umklammert, der Körper ist steif, und wir versuchen, uns jedes Detail der Bewegung zu merken. Dieser Zustand, bei dem wir uns übermäßig auf Details konzentrieren und versuchen, jede kleinste Bewegung perfekt zu kontrollieren, nennt man im maschinellen LernenÜberanpassung。
Unser Modell (wie Sie als Anfänger) ist zu komplex, es merkt sich jede einzelne Stichprobe in den Trainingsdaten perfekt, einschließlich Rauschen und zufälliger Schwankungen, was dazu führt, dass es bei neuen, ungesehenen Daten (z. B. beim tatsächlichen Fahren auf der Straße) schlecht abschneidet und keine Generalisierungsfähigkeit besitzt.
Regularisierungist die Kerntechnologie, die entwickelt wurde, um dieses Problem zu lösen. Ihre Kernidee ist:Die Lernbegeisterung des Modells abzukühlen, zu verhindern, dass es sich an Details aufhängt, und dadurch seine Anpassungsfähigkeit an neue Umgebungen zu verbessern.Einfach ausgedrückt fügt die Regularisierung der Zielfunktion (Verlustfunktion) während des Modelltrainings einen zusätzlichen Strafterm hinzu, wodurch die Komplexität des Modells begrenzt und verhindert wird, dass es sich zu stark auf spezifische Muster in den Trainingsdaten verlässt.
Dieser Artikel vermittelt Ihnen ein tiefgehendes Verständnis der Prinzipien der Regularisierung, gängiger Methoden und ihrer Anwendungen in der Ingenieurpraxis.
Grundlegende Konzepte: Der Bias-Varianz-Tradeoff
Bevor wir in die Regularisierung eintauchen, müssen wir die beiden Kernfehlerquellen in Modellen des maschinellen Lernens verstehen:BiasundVarianz. Das hilft uns zu verstehen, was die Regularisierung tatsächlich anpasst.
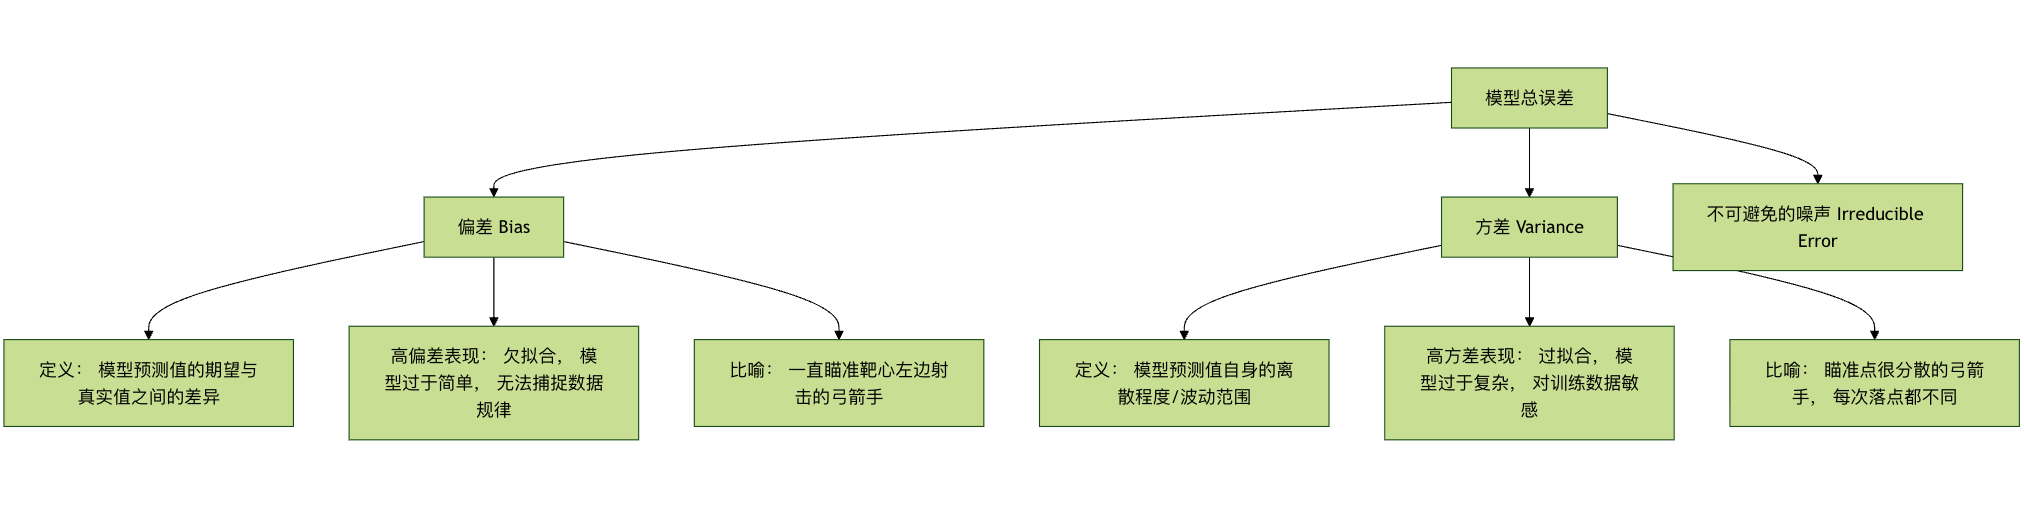
- Biasmisst den eigenensystematischen Fehler des Modells.Ein hoher Bias bedeutet, dass das Modell zu einfach ist und nicht einmal die grundlegenden Muster in den Trainingsdaten lernt (Unteranpassung).
- Varianzmisst die Empfindlichkeit des Modells gegenüberzufälligen Schwankungen in den Trainingsdaten.Eine hohe Varianz bedeutet, dass das Modell zu komplex ist und Rauschen in den Trainingsdaten als zu lernende Muster behandelt (Überanpassung).
Unser Ziel ist es, denBias-Varianz-Tradeoffoptimalen Punkt zu finden, um den Gesamtfehler zu minimieren. Regularisierung ist eine Methode, die durchdas Hinzufügen eines kleinen Bias (das Modell etwas einfacher macht) die Varianzdeutlich reduziert und dadurch die allgemeine Generalisierungsleistung des Modells effektiv verbessert.
L1- und L2-Regularisierung
Die klassischste Regularisierungsmethode besteht darin, der Verlustfunktion direkt einen Strafterm basierend auf den Gewichtsparametern des Modells hinzuzufügen. Je nach Berechnungsmethode des Strafterms wird sie hauptsächlich in L1- und L2-Regularisierung unterteilt.
Änderungen der Verlustfunktion
Nicht regularisierte Verlustfunktion (unter Verwendung des mittleren quadratischen Fehlers, MSE, als Beispiel):Loss = (1/n) * Σ(真实值 - 预测值)²
Verlustfunktion nach dem Hinzufügen des Regularisierungsterms:Loss_正则化 = Loss + λ * Penalty(权重)
wobei:
λ(lambda) ist derRegularisierungsstärke-Koeffizient,ein Hyperparameter größer als 0. Er steuert die Stärke der Bestrafung.λJe größer λ ist, desto stärker wird die Modellkomplexität bestraft, und desto einfacher wird das Modell.Penalty(权重)ist der Strafterm. L1 und L2 haben unterschiedliche Definitionen.
L1-Regularisierung (Lasso-Regression)
- Strafterm: Die Summe der Absolutwerte aller Gewichtsparameter im Modell.
- Formel:
Penalty = Σ|w_i|, wobeiw_iist das i-te Gewicht. - Verlustfunktion:
Loss_L1 = Loss + λ * Σ|w_i|
Zentrale Eigenschaften und Auswirkungen:
- Merkmalsauswahl: L1-Regularisierung neigt dazu, einedünnbesetzte Gewichtsmatrix zu erzeugen,d. h., sie komprimiert die Gewichte vieler unwichtiger Merkmale direkt auf00. Das entspricht einer automatischen Merkmalsauswahl, bei der das Modell nur die wichtigsten Merkmale beibehält.
- Geometrische Interpretation: Geometrisch ist ihr Restriktionsbereich ein 'Diamant' (eine Raute in zwei Dimensionen). Der optimale Lösungspunkt trifft mit größerer Wahrscheinlichkeit eine 'Ecke' dieses Diamanten, und Punkte an der Ecke bedeuten, dass einige Koordinaten 0 sind.
Codebeispiel:
Beispiel
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
# Simulierte Daten generieren
X, y = make_regression(n_samples=100, n_features=10, noise=0.1, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# L1-Regularisierungsmodell (Lasso) erstellen, Regularisierungsstärke alpha festlegen (d. h. λ)
lasso_model = Lasso(alpha=0.1) # Je größer alpha, desto stärker die Bestrafung, und desto mehr Gewichte werden 0
lasso_model.fit(X_train, y_train)
# Modellkoeffizienten (Gewichte) anzeigen, um Sparsität zu beobachten
print("Lasso-Modellkoeffizienten:")
for i, coef in enumerate(lasso_model.coef_):
print(f" Feature {i}: {coef:.4f}")
# Zähle die Anzahl der Nicht-Null-Gewichte
non_zero_count = sum(lasso_model.coef_ != 0)
print(f"\nAnzahl der Merkmale mit Nicht-Null-Gewichten: {non_zero_count} / {X.shape)
Ausgabe:
Lasso 模型系数:
  特征 0: 16.6855
  特征 1: 54.0447
  特征 2: 5.0302
  特征 3: 63.5492
  特征 4: 93.4587
  特征 5: 70.5421
  特征 6: 86.9569
  特征 7: 10.2711
  特征 8: 3.0697
  特征 9: 70.7835

非零权重的特征数量: 10 / 10
L2-Regularisierung (Ridge-Regression)
- Strafterm: Die Summe der Quadrate aller Gewichtsparameter im Modell.
- Formel:
Penalty = Σ(w_i)² - Verlustfunktion:
Loss_L2 = Loss + λ * Σ(w_i)²
Zentrale Eigenschaften und Auswirkungen:
- Gewichtsabnahme: L2-Regularisierung neigt dazu, alle Gewichtsparametergegen 0 gehen zu lassen, aber normalerweise sind sie nicht gleich 0.Sie verkleinert alle Gewichte gleichmäßig und verhindert, dass ein einzelnes Gewicht zu groß wird.
- Verbesserung schlecht konditionierter Probleme: Bei Daten mit Multikollinearität (hoher Korrelation) zwischen Merkmalen kann die gewöhnliche lineare Regression instabil sein. L2-Regularisierung kann dieses Problem wirksam verbessern und die Lösung stabiler machen.
- Geometrische Interpretation: Geometrisch ist ihr Restriktionsbereich ein 'Kreis' (ein Kreis in zwei Dimensionen). Der optimale Lösungspunkt berührt eher den 'Rand' dieses Kreises als eine scharfe Ecke.
Codebeispiel:
Beispiel
# L2-Regularisierungsmodell (Ridge) erstellen
ridge_model = Ridge(alpha=1.0) # alpha ist λ
ridge_model.fit(X_train, y_train)
# Modellkoeffizienten anzeigen, um Weight Decay zu beobachten
print("Koeffizienten des Ridge-Modells:")
for i, coef in enumerate(ridge_model.coef_):
print(f" Feature {i}: {coef:.4f}")
# Koeffizientenunterschiede zwischen Lasso und Ridge vergleichen
print("\nKoeffizientenvergleich (Lasso vs Ridge):")
print("Merkmal | Lasso-Koeffizient | Ridge-Koeffizient")
print("-" * 35)
for i in range(len(lasso_model.coef_)):
print(f"{i:4d} | {lasso_model.coef_[i]:11.4f} | {ridge_model.coef_[i]:11.4f}")
L1-vs-L2-Vergleichszusammenfassung
| Eigenschaft | L1-Regularisierung (Lasso) | L2-Regularisierung (Ridge) |
|---|---|---|
| Strafterm | `Σ | w_i |
| Lösungseigenschaften | Dünn besetzte Lösung, viele Gewichte sind 0 | Dichte Lösung, Gewichte sind nahe bei 0, aber nicht null |
| Kernfunktion | Merkmalsauswahl | Weight Decay, Stabile Lösung |
| Geometrische Form | Raute / Polyeder | Kreis / Kugel |
| Berechnung | Komplexere Optimierung (nicht überall differenzierbar) | Einfache Optimierung (überall differenzierbar) |
| Anwendbare Szenarien | Viele Merkmale, und nur wenige gelten als relevant | Alle Merkmale können beitragen, oder es liegt Multikollinearität vor |
Elastic Net
Elastic Net ist ein Kompromiss zwischen L1- und L2-Regularisierung und enthält Strafterme von beiden.Loss_ElasticNet = Loss + λ1 * Σ|w_i| + λ2 * Σ(w_i)²
Es kombiniert die Merkmalsauswahlfähigkeit von L1 mit der Stabilität von L2 und eignet sich daher für Fälle mit sehr hohen Merkmalsdimensionen und Korrelationen zwischen Merkmalen.
Beispiel
elastic_model = ElasticNet(alpha=0.1, l1_ratio=0.5) # l1_ratio steuert das Mischungsverhältnis von L1 und L2
elastic_model.fit(X_train, y_train)
Weitere Regularisierungstechniken
Neben der direkten Änderung der Verlustfunktion gibt es auch Methoden, die Regularisierung durch Änderung des Trainingsprozesses oder der Modellstruktur erreichen.
Dropout (für neuronale Netze)
Dropout ist eine äußerst effektive Regularisierungstechnik in neuronalen Netzen. Während desTrainingsprozesses,veranlasst es zufällig einen Teil der Neuronen im Netzwerk, vorübergehend 'zu deaktivieren' (ihre Ausgabe auf 0 zu setzen).
Funktionsweise:
- In jedem Trainingsbatch, mit Wahrscheinlichkeit
p(z. B. 0.5), zufällig einen Teil der Neuronen deaktivieren. - Vorwärtspropagation und Backpropagation werden nur in den verbleibenden Neuronen durchgeführt.
- Während des Testens oder der Vorhersage werden alle Neuronen verwendet, aber die Ausgabe eines Neurons wird multipliziert mit
(1-p)um den Erwartungswert konsistent zu halten.
Kernidee: Um komplexe Ko-Adaptation zwischen Neuronen zu verhindern und das Netzwerk dazu zu zwingen, mehrrobusteunddisperseMerkmalsrepräsentationen zu erlernen. Das ist wie ein Team: Es kann sich nicht immer auf einige wenige Kernmitglieder verlassen; jeder muss in der Lage sein, unabhängig zu arbeiten, sodass das Team auch dann noch normal funktionieren kann, wenn jemand fehlt.
Codebeispiel (mit TensorFlow/Keras):
Beispiel
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout
model = Sequential([
Dense(128, activation='relu', input_shape=(input_dim,)),
Dropout(0.5), # Füge eine Dropout-Schicht nach der vorherigen Schicht hinzu, Dropout-Rate 50%
Dense(64, activation='relu'),
Dropout(0.3), # Dropout-Rate 30%
Dense(1, activation='sigmoid') # Ausgabeschicht
])
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
Frühzeitiges Stoppen
Early Stopping ist eine einfache und effiziente Regularisierungsstrategie. Es verändert nicht die Verlustfunktion, sondernüberwacht die Leistung des Modells auf dem Validierungsset.。
Schritte:
- Teilen Sie die Daten in Trainings- und Validierungssets auf.
- Trainieren Sie das Modell auf dem Trainingsset und bewerten Sie regelmäßig die Leistung auf dem Validierungsset (z. B. nach jeder Trainings-Epoche).
- Sobald festgestellt wird, dass sich die Leistung (z. B. der Verlust) auf dem Validierungsset über mehrere aufeinanderfolgende Epochen nicht verbessert hatoder sogar begonnen hat zu sinken,brechen Sie das Training sofort ab.
Kernidee:Beenden Sie das Training genau in dem Moment, kurz bevor das Modell beginnt, die Trainingsdaten zu überfitten (d. h., wenn der Validierungsfehler beginnt zu steigen), und erhalten Sie dadurch die Modellgewichte mit der besten Generalisierungsfähigkeit.
Beispiel
# Definieren Sie die Early-Stopping-Callback-Funktion
# monitor: die zu überwachende Metrik, z. B. 'val_loss'
# patience: Anzahl der zu tolerierenden Epochen; stoppen, wenn sich die Validierungsleistung innerhalb dieser Anzahl von Epochen nicht verbessert
# restore_best_weights: ob die Gewichte aus der Epoche mit der besten überwachten Metrik wiederhergestellt werden sollen
early_stopping = EarlyStopping(
monitor='val_loss',
patience=10,
restore_best_weights=True
)
# Verwendung in model.fit
history = model.fit(
X_train, y_train,
validation_data=(X_val, y_val),
epochs=100,
callbacks=[early_stopping] # Übergib die Callback-Liste
)
Übungsaufgabe: Umfassender Vergleich der Regularisierungseffekte
Verwenden wir ein vollständiges Beispiel, um die Auswirkungen verschiedener Regularisierungsmethoden auf eine Regressionsaufgabe zu vergleichen.
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Lasso, Ridge, ElasticNet
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline
from sklearn.metrics import mean_squared_error
# 1. Nichtlineare Daten mit Rauschen generieren
np.random.seed(42)
X = np.linspace(-3, 3, 100).reshape(-1, 1)
y_true = 0.5 * X.ravel()**2 + X.ravel() # Wahre quadratische Beziehung
y = y_true + np.random.randn(100) * 0.8 # Rauschen hinzufügen
# 2. Modelle unterschiedlicher Komplexität erstellen (mit Polynommerkmalen)
degree = 10 # Ein Polynom 10. Grades verwenden, das anfällig für Überanpassung ist
models = {
'Keine Regularisierung': make_pipeline(PolynomialFeatures(degree), LinearRegression()),
'L1 (Lasso)': make_pipeline(PolynomialFeatures(degree), Lasso(alpha=0.01, max_iter=10000)),
'L2 (Ridge)': make_pipeline(PolynomialFeatures(degree), Ridge(alpha=0.1)),
'ElasticNet': make_pipeline(PolynomialFeatures(degree), ElasticNet(alpha=0.01, l1_ratio=0.5))
}
# 3. Trainieren und vorhersagen
X_plot = np.linspace(-3.5, 3.5, 200).reshape(-1, 1)
plt.figure(figsize=(12, 8))
plt.scatter(X, y, s=20, alpha=0.6, label='Trainingsdaten (mit Rauschen)')
plt.plot(X, y_true, 'k-', linewidth=3, label='Wahre Funktion')
for name, model in models.items():
model.fit(X, y)
y_plot = model.predict(X_plot)
mse = mean_squared_error(y, model.predict(X))
plt.plot(X_plot, y_plot, '--', linewidth=2, label=f'{name} (MSE: {mse:.3f})')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Vergleich verschiedener Regularisierungsmethoden zur Unterdrückung von Overfitting (Polynom 10. Grades)')
plt.legend(loc='best')
plt.grid(True, alpha=0.3)
plt.show()
Übungsaufgaben:
- Führen Sie den obigen Code aus und beobachten Sie, wie das unregularisierte Modell stark schwankt, um Rauschen anzupassen (Overfitting), während die Kurven der regularisierten Modelle glatter und näher an der wahren Funktion sind.
- Versuchen Sie,
degree(den Polynomgrad) und diealpha(Regularisierungsstärke)-Parameter jedes Modells anzupassen und ihre Auswirkungen auf die Ergebnisse der Modellanpassung zu beobachten. - (Fortgeschritten) Teilen Sie die Daten in Trainings- und Testsets auf, berechnen Sie die MSE jedes Modells auf dem Testset und überprüfen Sie die Verbesserung der Generalisierung durch Regularisierung.
Zusammenfassung und technische Empfehlungen
Regularisierung ist ein unverzichtbares Werkzeug im Werkzeugkasten eines Machine-Learning-Ingenieurs. Um sie effektiv anzuwenden, beachten Sie die folgenden Punkte:
- Verstehen Sie die Natur des Problems:Verwenden Sie zunächst Lernkurven, die Leistung auf dem Validierungsset usw., um festzustellen, ob das Modell ein Overfitting-Problem (hohe Varianz) aufweist.
- Einfach anfangen:Normalerweise können Sie zuerstL2-Regularisierung ausprobieren,weil sie stabil und einfach abzustimmen ist. Wenn die Merkmalsdimensionalität extrem hoch ist und Merkmalsauswahl erforderlich ist, dann ziehen SieL1oderelastic net in Betracht.。
- Tuning ist entscheidend:Die Regularisierungsstärke
λ(oderalpha) ist ein entscheidender Hyperparameter. Er muss durchCross-Validationsorgfältig ausgewählt werden. - In Kombination verwenden:In der Praxis werden Regularisierungstechniken oft in Kombination eingesetzt. Wenn man beispielsweise tiefe neuronale Netze trainiert,Dropout + L2 Weight Decay + Early Stoppingist eine äußerst übliche Kombination.
- Domänenanpassung:Für Computer-Vision-Aufgaben sind Dropout und Batch Normalization (die auch einen gewissen Regularisierungseffekt haben) sehr effektiv. Für Sequenzmodelle (wie RNN, Transformer) werden Dropout und Weight Decay häufig verwendet.
Das ultimative Ziel der Regularisierung ist es, das Modell vom "Auswendiglernen" der Trainingsdaten hin zu einem "tiefen Verständnis" der universellen Muster hinter den Daten zu führen, um in der realen Welt zuverlässigere Vorhersagen zu treffen. Beherrschen Sie es, und Sie halten den Schlüssel zur Verbesserung der Modellgeneralisierung in der Hand.
Weitere Erweiterungen