Ensemble-Lernen
Im Bereich des maschinellen Lernens ist Ensemble Learning eine Technik, die die Gesamtleistung verbessert, indem sie die Vorhersageergebnisse mehrerer Modelle kombiniert.
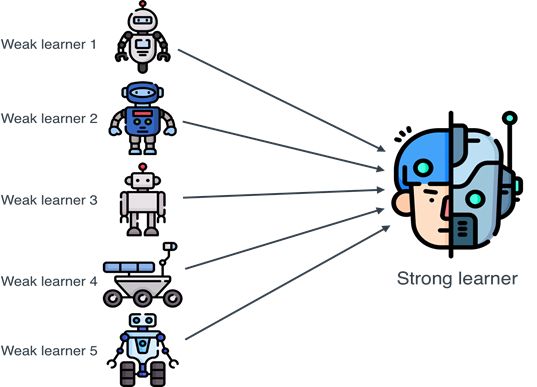
Die Kernidee des Ensemble Learnings ist "drei Schuster mit vereinten Kräften sind so gut wie Zhuge Liang," das heißt, die Kombination mehrerer schwacher Lerner kann einen starken Lerner aufbauen.
Das Hauptziel des Ensemble Learnings ist es, die Vorhersagegenauigkeit und Robustheit durch die Kombination mehrerer Modelle zu verbessern.
Gängige Ensemble-Learning-Methoden sind:
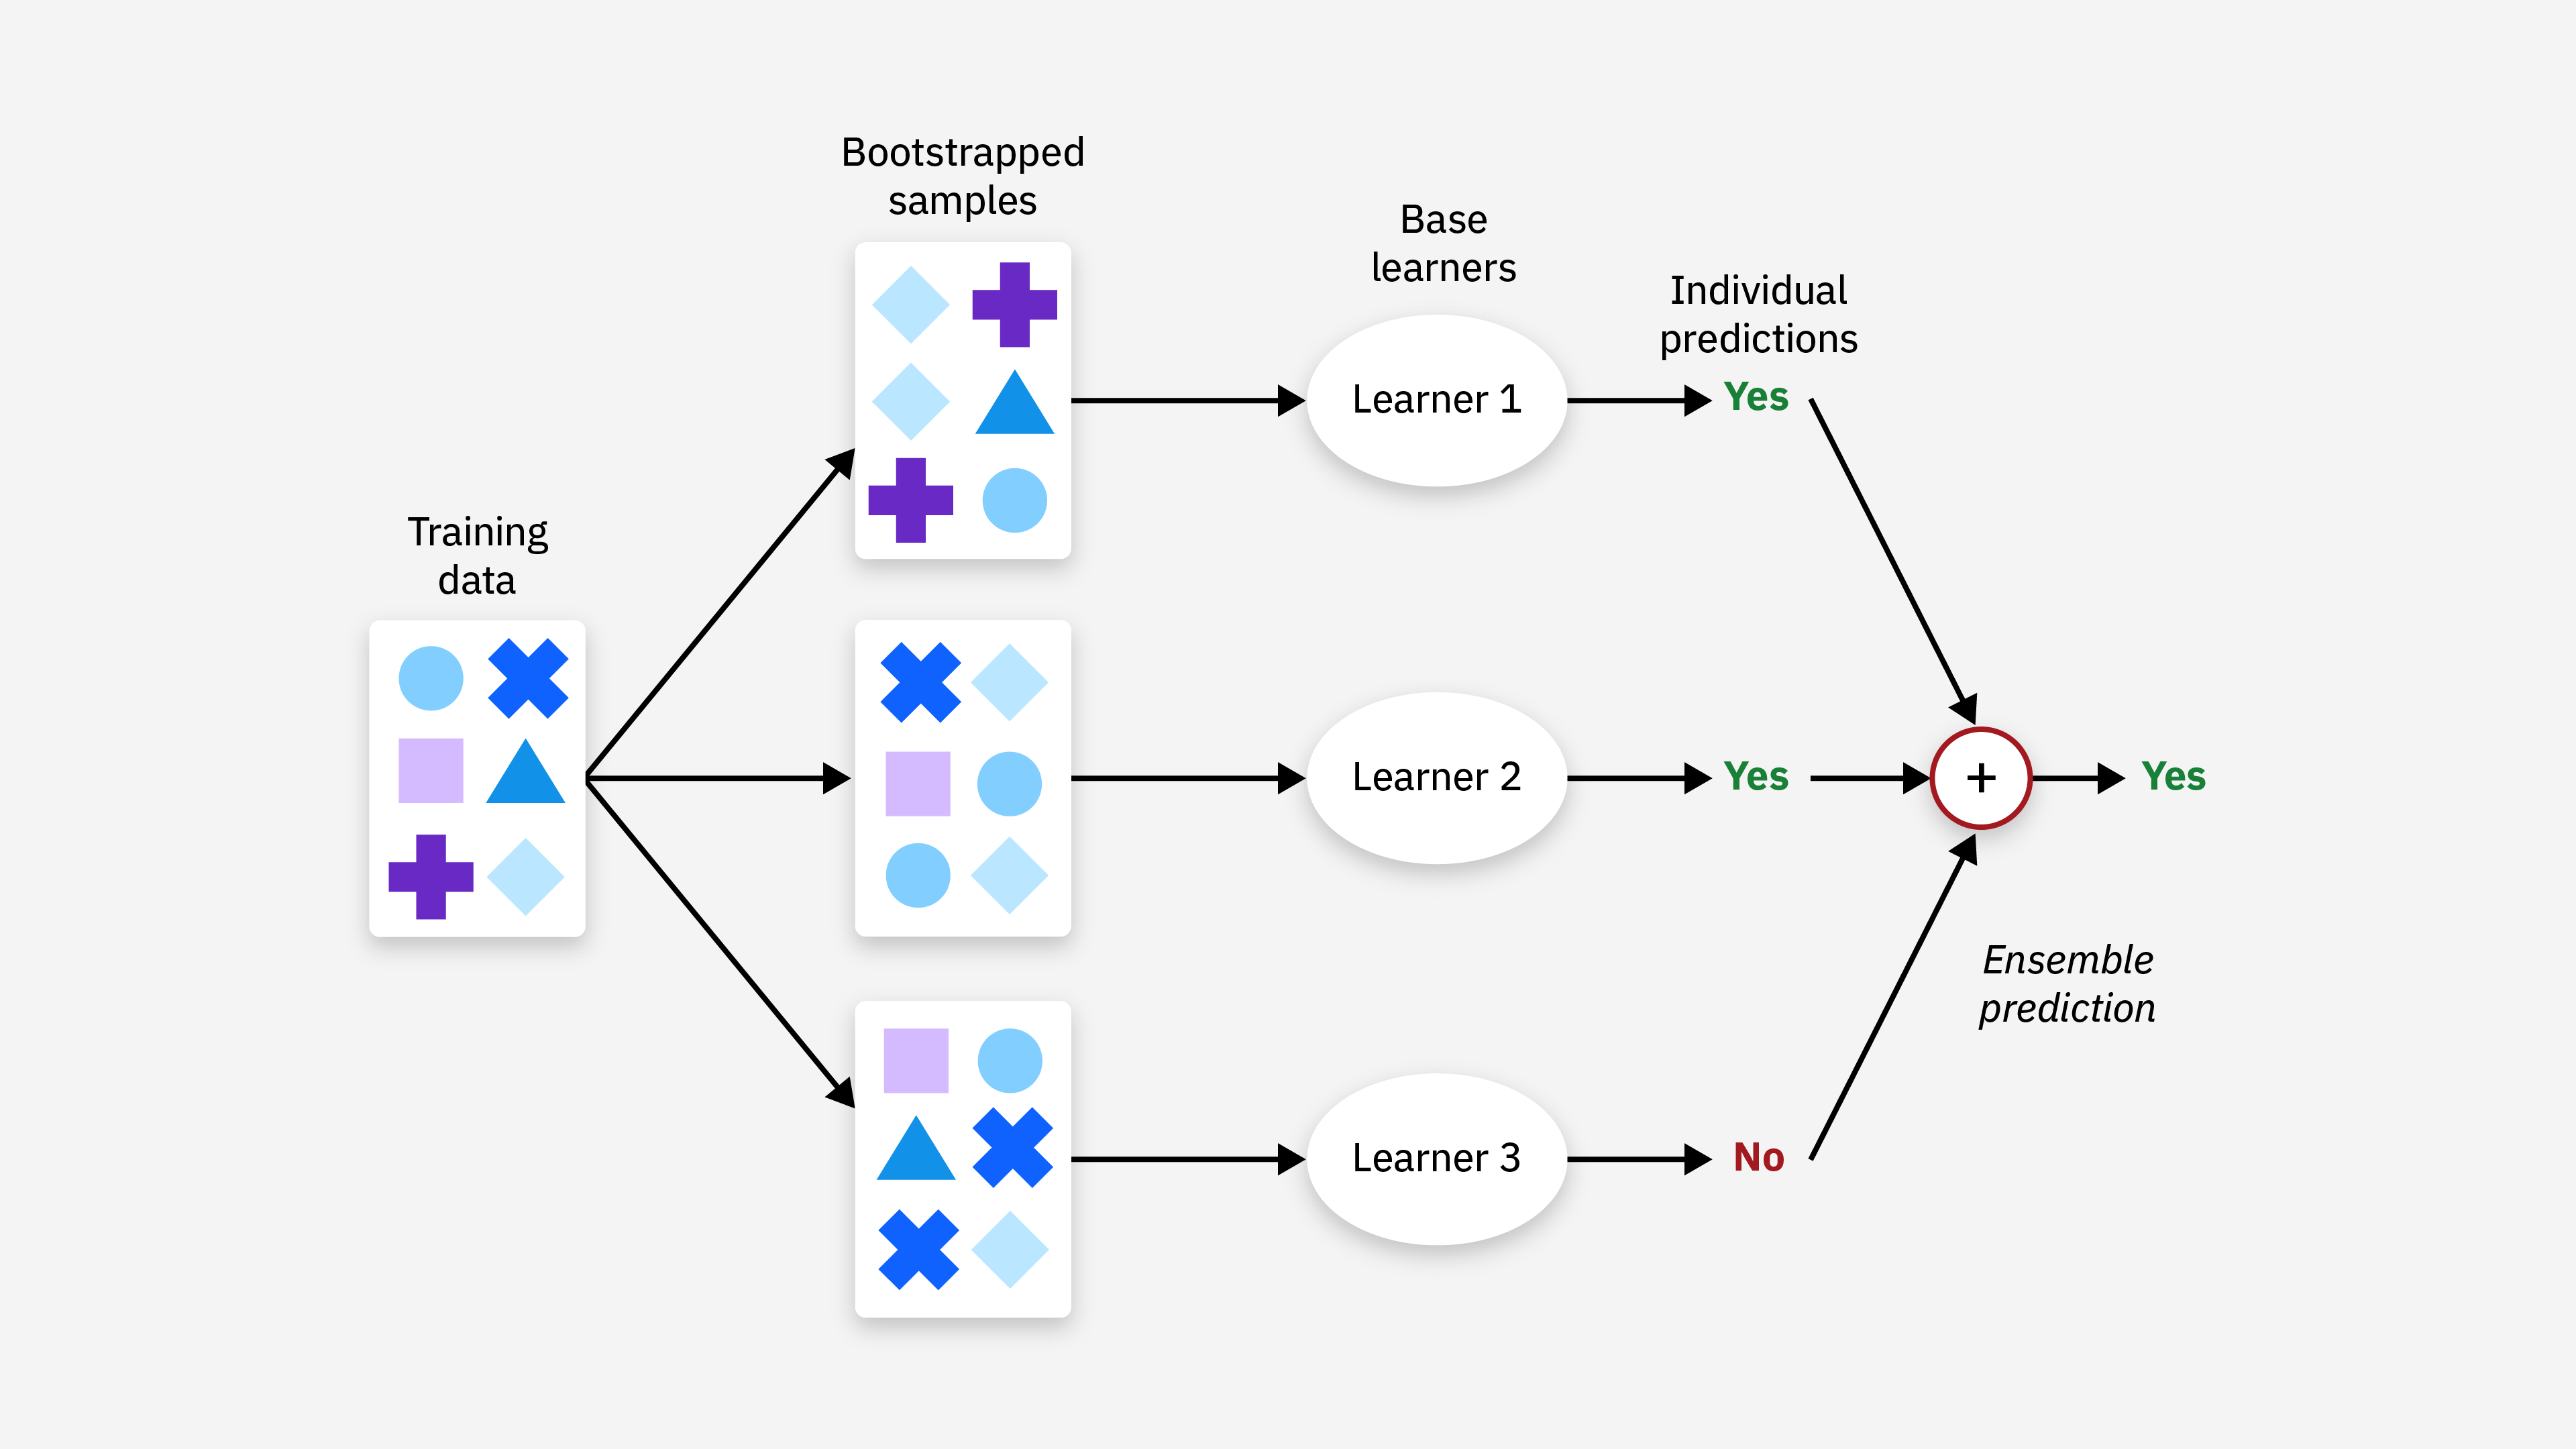
- Bagging: Erzeuge mehrere Trainingsdatensätze durch Bootstrap-Stichproben, trainiere dann mehrere Modelle separat und erhalte schließlich das Endergebnis durch Abstimmung oder Mittelwertbildung.
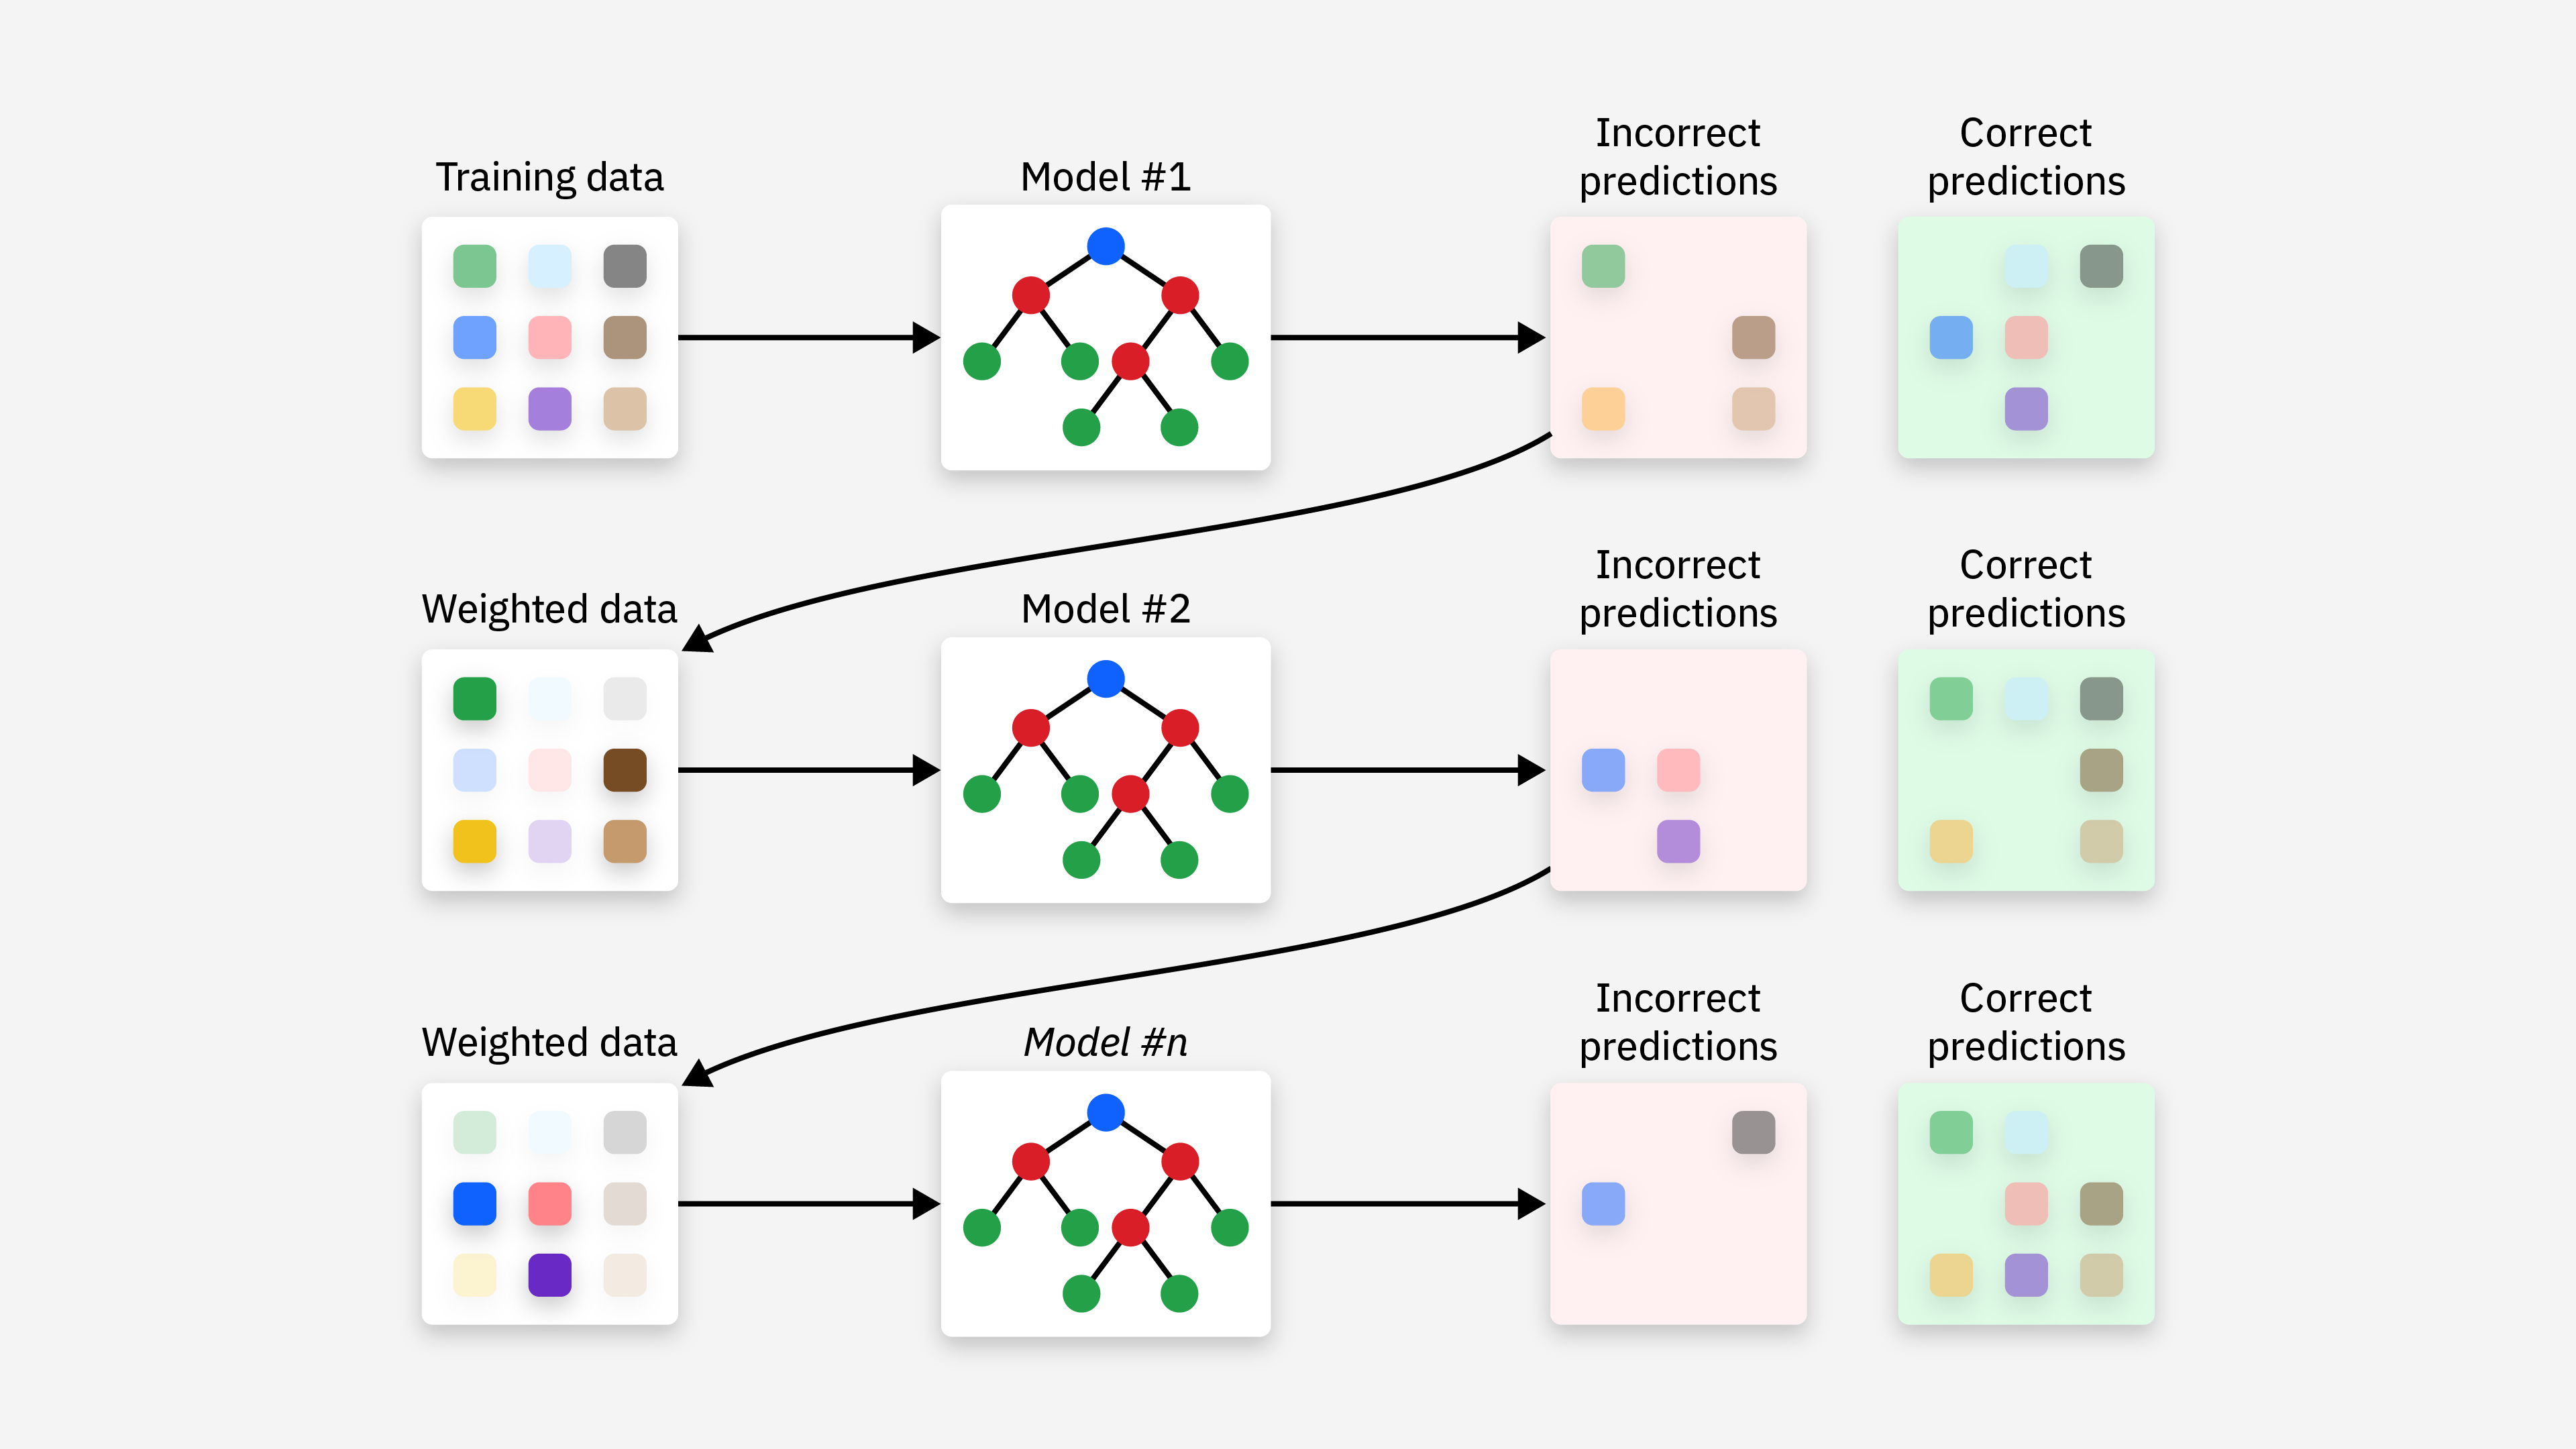
- Boosting: Trainiere mehrere Modelle iterativ, wobei jedes Modell versucht, die Fehler des vorherigen Modells zu korrigieren, und das Ergebnis schließlich durch gewichtete Abstimmung erhalten wird.
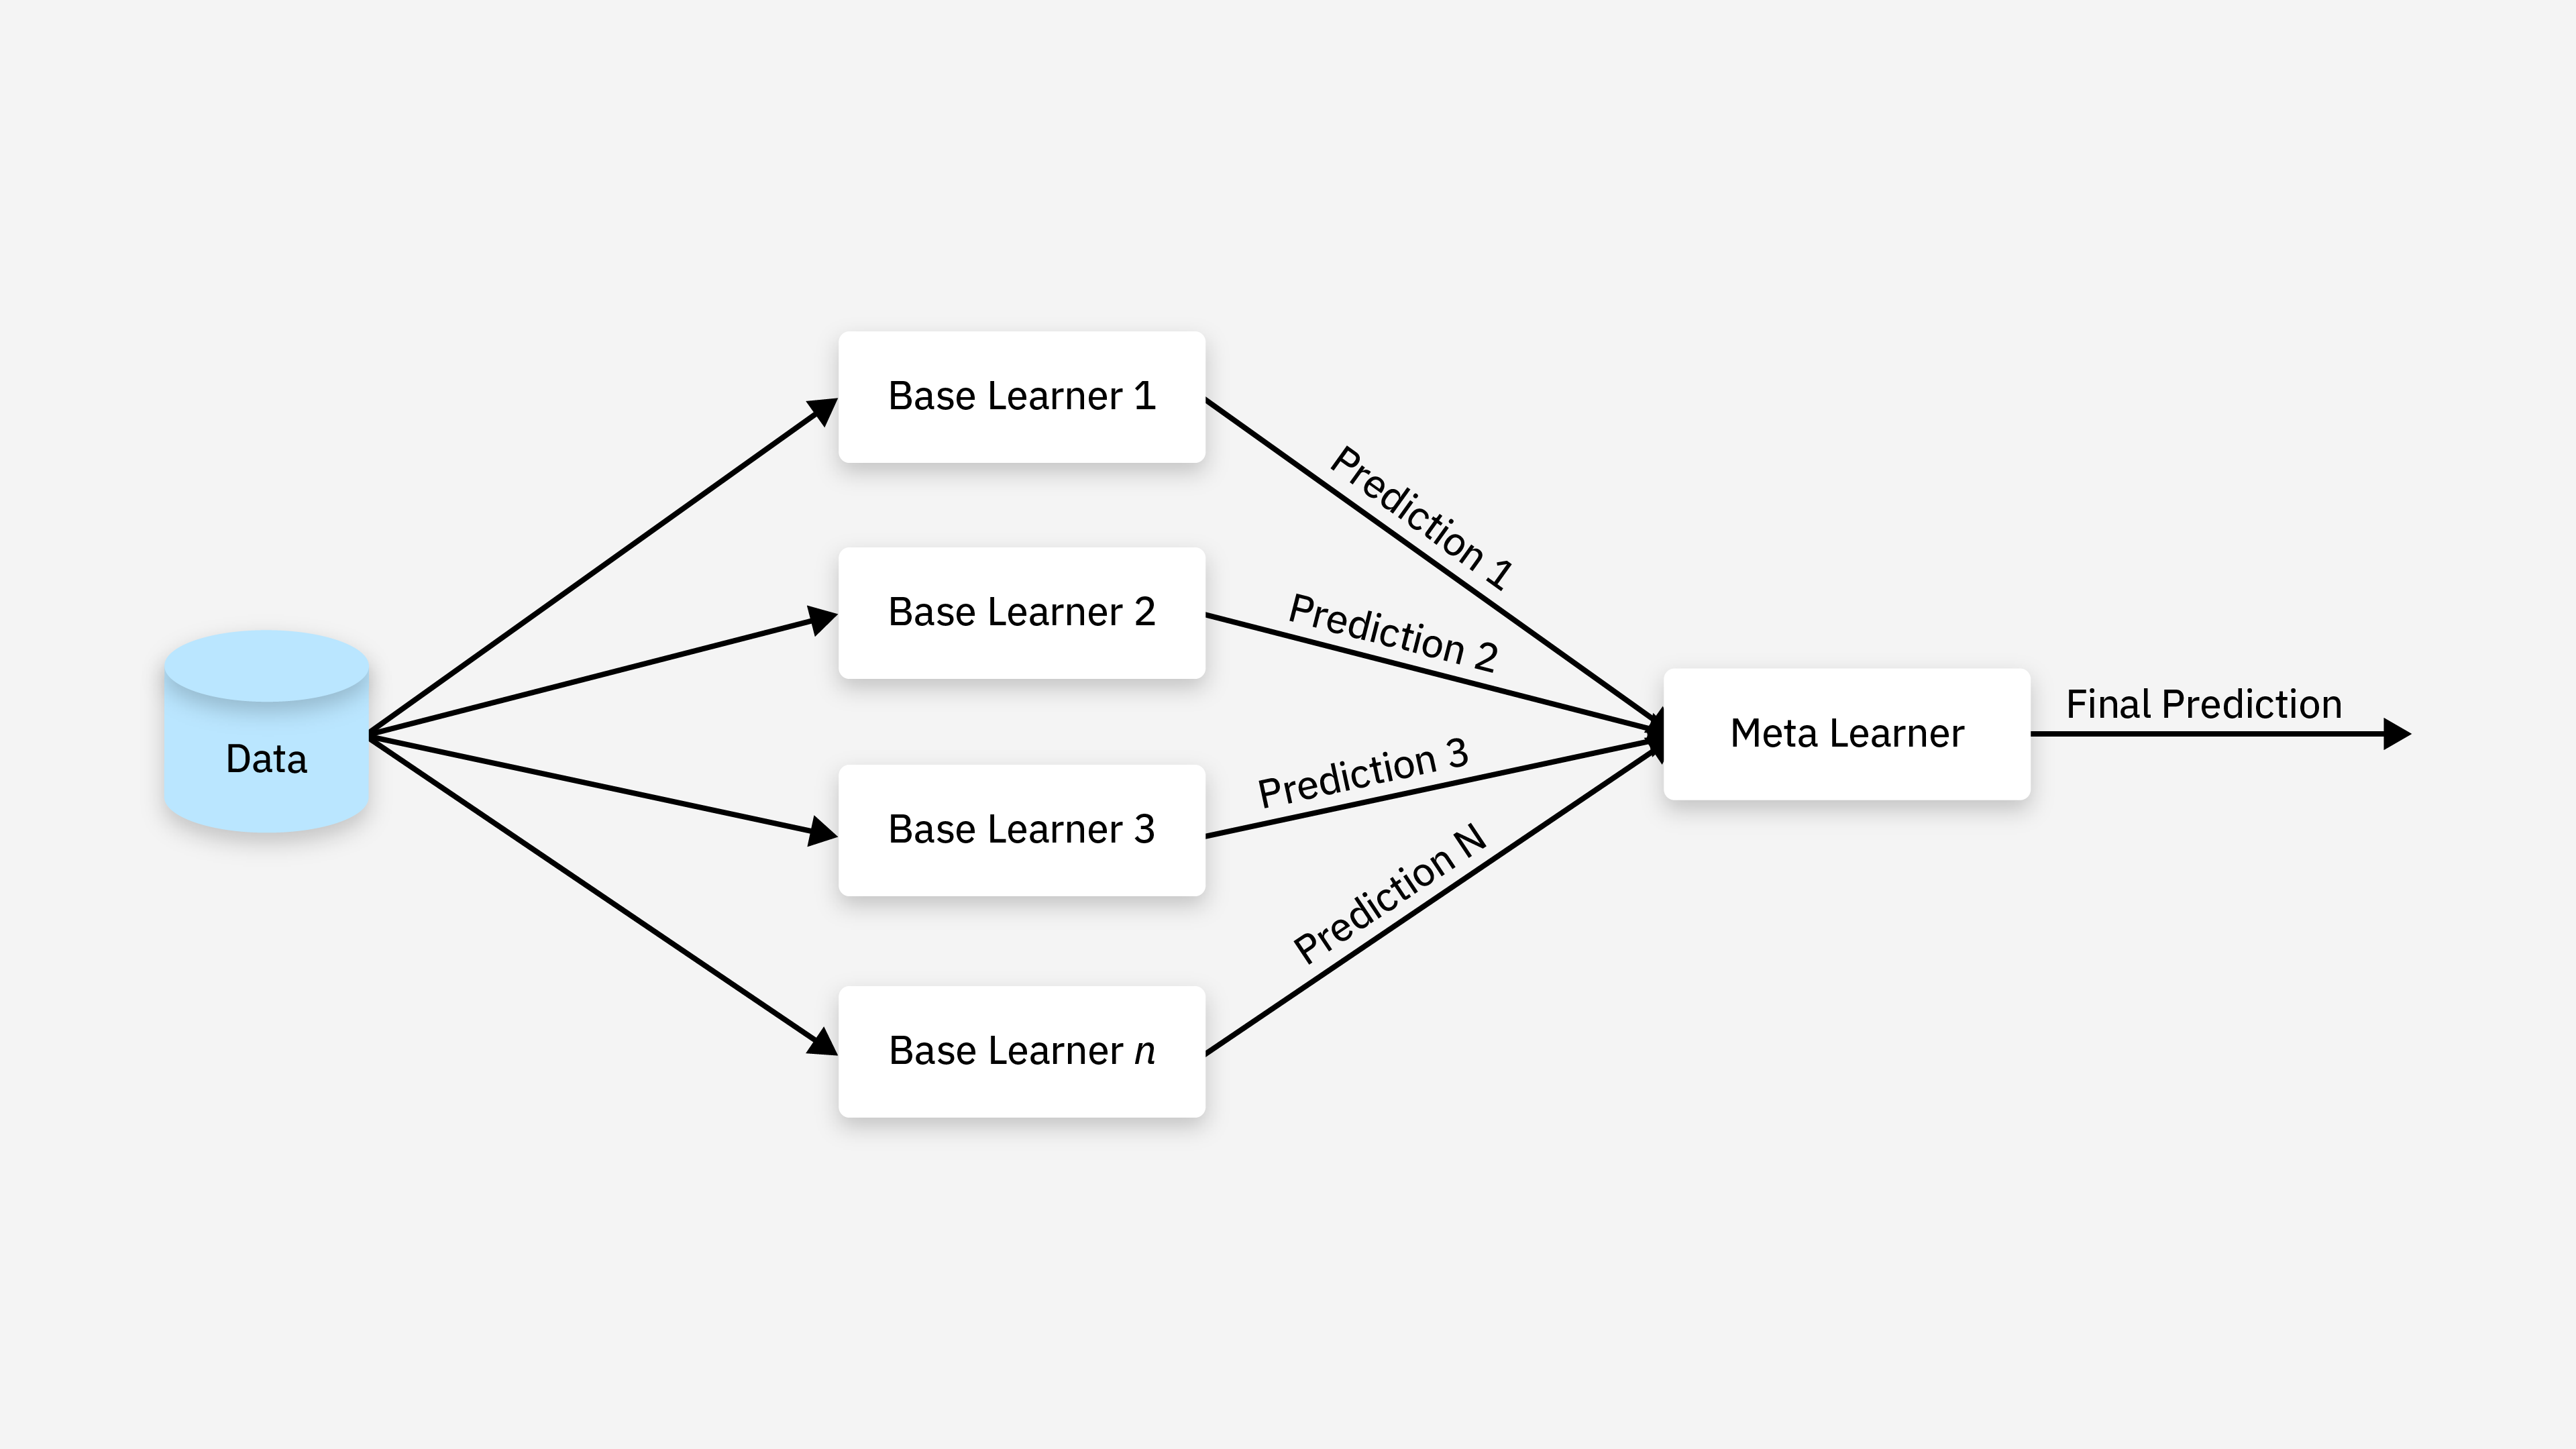
- Stacking: Trainiere mehrere verschiedene Modelle, verwende dann die Ausgaben dieser Modelle als neue Merkmale und trainiere ein Meta-Modell für die endgültige Vorhersage.
1. Bagging(Bootstrap Aggregating)
Das Ziel von Bagging ist es, die Leistung durch Reduzierung der Varianz des Modells zu verbessern, und es eignet sich für Modelle mit hoher Varianz und einer Neigung zu Overfitting. Es wird durch die folgenden Schritte umgesetzt:
- Resampling des Datensatzes: Führe mehrere zufällige Stichproben mit Zurücklegen (Bootstrap) auf dem Trainingsdatensatz durch, wobei jede Stichprobe eine Teilmenge ergibt.
- Mehrere Modelle trainieren: Trainiere einen Basislerner (normalerweise denselben Modelltyp) auf jeder Teilmenge.
- Ergebnisse zusammenführen: Kombiniere die Ergebnisse mehrerer Basislerner, normalerweise durch Abstimmung (für Klassifikationsprobleme) oder Mittelwertbildung (für Regressionsprobleme).
Typische Algorithmen:
- Random Forest: Random Forest ist eine klassische Implementierung von Bagging. Es reduziert das Risiko von Overfitting, indem mehrere Entscheidungsbäume erstellt werden, wobei jeder Baum während des Trainings zufällig Merkmale auswählt.
Vorteile:
- Es kann die Varianz effektiv reduzieren und die Modellstabilität verbessern.
- Geeignet für Modelle mit hoher Varianz, wie Entscheidungsbäume.
Nachteile:
- Der Trainingsprozess dauert lange, da mehrere Modelle trainiert werden müssen.
- Die Ergebnisse sind schwierig zu interpretieren, weil es kein einzelnes Modell gibt.
2. Boosting
Das Ziel von Boosting ist es, die Leistung durch Reduzierung des Bias des Modells zu verbessern, und es eignet sich für schwache Lerner. Die Kernidee von Boosting besteht darin, die Gewichtung jedes Modells schrittweise anzupassen und dabei diejenigen Stichproben hervorzuheben, die vom Modell der vorherigen Runde falsch klassifiziert wurden. Boosting wird durch die folgenden Schritte implementiert:
- Serielles Training: Modelle werden nacheinander trainiert, und jede Trainingsrunde wird entsprechend den Fehlern der vorherigen Runde angepasst.
- Gewichtete Abstimmung: Die endgültige Vorhersage ist die gewichtete Summe aller Vorhersagen der schwachen Lerner, wobei falsch klassifizierten Stichproben höhere Gewichte zugewiesen werden.
- Modelle kombinieren: Das Gewicht jedes Modells wird durch seine Leistung während des Trainingsprozesses bestimmt.
Typische Algorithmen:
- AdaBoost(Adaptive Boosting): AdaBoost verändert die Gewichte der Stichproben, wodurch jeder nachfolgende Klassifikator den in der vorherigen Runde falsch klassifizierten Stichproben mehr Aufmerksamkeit schenkt.
- Gradient Boosting Trees (GBT): GBT optimiert die Zielfunktion iterativ, um den Bias schrittweise zu reduzieren.
- XGBoost(Extreme Gradient Boosting): XGBoost ist ein effizienter Gradient-Boosting-Algorithmus, der in Data-Science-Wettbewerben weit verbreitet ist und eine starke Leistung sowie Optimierung bietet.
- LightGBM(Light Gradient Boosting Machine): LightGBM ist ein Framework, das auf Gradient Boosting Trees basiert. Im Vergleich zu XGBoost bietet es eine schnellere Trainingsgeschwindigkeit und einen geringeren Speicherverbrauch.
Vorteile:
- Geeignet für Modelle mit großem Bias und kann die Vorhersagegenauigkeit effektiv verbessern.
- Starke Leistung, und es schneidet in vielen realen Anwendungen hervorragend ab.
Nachteile:
- Es ist empfindlich gegenüber verrauschten Daten und kann leicht zu Überanpassung führen.
- Der Trainingsprozess ist bei großen Datensätzen langsam.
3. Stacking (Stacked Generalization)
Stacking ist eine Methode, die die Gesamtvorhersagegenauigkeit verbessert, indem verschiedene Arten von Modellen trainiert und ihre Vorhersagen kombiniert werden. Die Kernidee ist:
- Erste Schicht (Basislerner): Trainiere mehrere Basislerner unterschiedlicher Typen (z. B. Entscheidungsbäume, SVM, K usw.), um die Daten vorherzusagen.
- Zweite Schicht (Meta-Lerner): Verwende die Vorhersageergebnisse der Lerner der ersten Schicht als Eingabe und trainiere einen Meta-Lerner (normalerweise logistische Regression, lineare Regression usw.), um die endgültige Vorhersage zu treffen.
Vorteile:
- Verschiedene Arten von Basislernern können verwendet werden, um unterschiedliche Muster in den Daten zu erfassen.
- Theoretisch kann es die Vorteile von Modellen kombinieren, um eine stärkere Vorhersagefähigkeit zu erreichen.
Nachteile:
- Der Trainingsprozess ist komplex und erfordert das Training mehrerer Modelle; auch die Art der Kombination der Modelle muss sorgfältig entworfen werden.
- Es ist komplexer als andere Ensemble-Methoden wie Bagging und Boosting und neigt zu Überanpassung.
Beispieldemonstration
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Lade den Datensatz
iris = load_iris()
X, y = iris.data, iris.target
# Datensatz in Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Random-Forest-Klassifikator erstellen
rf = RandomForestClassifier(n_estimators=100, random_state=42)
# Modell trainieren
rf.fit(X_train, y_train)
# Vorhersagen
y_pred = rf.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Genauigkeit des Random Forest: {accuracy:.2f}")
Das Ausgabeergebnis ist wie folgt:
随机森林的准确率: 1.00
Code-Erklärung:
- Datensatz laden: Wir verwenden die
load_iris()Funktion, um den klassischen Iris-Datensatz zu laden. - Datensatz in Trainings- und Testsets aufteilen: Verwenden Sie die
train_test_split()Funktion, um den Datensatz in Trainings- und Testsets aufzuteilen. - Random-Forest-Klassifikator erstellen: Verwenden Sie die
RandomForestClassifierKlasse, um einen Random-Forest-Klassifikator zu erstellen,n_estimators=100bedeutet, dass 100 Entscheidungsbäume verwendet werden. - Modell trainieren: Verwenden Sie die
fit()Methode, um das Modell zu trainieren. - Vorhersagen: Verwenden Sie die
predict()Methode, um Vorhersagen auf dem Testset zu treffen. - Genauigkeit berechnen: Verwenden Sie die
accuracy_score()Funktion, um die Genauigkeit des Modells zu berechnen.
Boosting:AdaBoost
Algorithmusprinzip:Die Kernidee von Boosting besteht darin, mehrere Modelle iterativ zu trainieren, wobei jedes Modell versucht, die Fehler des vorherigen Modells zu korrigieren. AdaBoost (Adaptive Boosting) ist einer der klassischsten Boosting-Algorithmen.
Beispiel
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
# Lade den Datensatz
iris = load_iris()
X, y = iris.data, iris.target
# Datensatz in Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Standardmäßigen schwachen Lerner (Entscheidungsbaum) verwenden und den SAMME-Algorithmus angeben
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
n_estimators=50,
random_state=42,
algorithm='SAMME')
# Modell trainieren
ada.fit(X_train, y_train)
# Vorhersagen
y_pred = ada.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"AdaBoost-Genauigkeit: {accuracy:.2f}")
Das Ausgabeergebnis ist wie folgt:
AdaBoost的准确率: 1.00
Code-Erklärung:
- Laden Sie den Datensatz: Verwenden Sie die
load_iris()Funktion zum Laden des Iris-Datensatzes, der Merkmalsdaten enthältXund Labeldaten.y。 - Datensatz in Trainings- und Testsets aufteilen: Verwenden Sie die
train_test_split()Funktion zum Aufteilen des Datensatzes in Trainings- und Testsets, wobei der Testsatz 30% und der Trainingssatz 70% ausmachen. - Erstellen Sie einen Entscheidungsbaum-Klassifikator: Verwenden Sie
DecisionTreeClassifier(max_depth=1)um einen Entscheidungsbaum-Klassifikator mit Tiefe 1 als Basislerner von AdaBoost zu erstellen. - Erstellen Sie einen AdaBoost-Klassifikator: Verwenden Sie die
AdaBoostClassifier()Klasse, um einen AdaBoost-Klassifikator zu erstellen,n_estimators=50bedeutet, dass 50 schwache Lernende verwendet werden,algorithm='SAMME'und der SAMME-Algorithmus angegeben wird. - Modell trainieren: Verwenden Sie die
fit()Methode, um das AdaBoost-Modell mit den Trainingsdaten zu trainieren. - Vorhersagen: Verwenden Sie die
predict()Methode, um Vorhersagen auf dem Testsatz zu treffen und vorhergesagte Labels zu generieren.y_pred。 - Genauigkeit berechnen: Verwenden Sie die
accuracy_score()Funktion zur Berechnung und Ausgabe der Vorhersagegenauigkeit des Modells.
Stacking: Modell-Stacking
Algorithmusprinzip:Die Kernidee von Stacking ist, mehrere unterschiedliche Modelle zu trainieren, dann die Ausgaben dieser Modelle als neue Merkmale zu verwenden und ein Meta-Modell zu trainieren, das die endgültige Vorhersage trifft.
Beispiel
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Lade den Datensatz
iris = load_iris()
X, y = iris.data, iris.target
# Datensatz in Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Basislerner definieren
estimators = [
('dt', DecisionTreeClassifier(max_depth=1)),
('svc', SVC(kernel='linear', probability=True))
]
# Einen Stacking-Klassifikator erstellen
stacking = StackingClassifier(estimators=estimators, final_estimator=LogisticRegression())
# Modell trainieren
stacking.fit(X_train, y_train)
# Vorhersagen
y_pred = stacking.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Stacking-Genauigkeit: {accuracy:.2f}")
Das Ausgabeergebnis ist wie folgt:
tacking的准确率: 1.00
Code-Erklärung:
- Datensatz laden: Verwenden Sie ebenfalls die
load_iris()Die Funktion lädt den Iris-Datensatz. - Trainings- und Testsatz aufteilen: Verwenden Sie
train_test_split()Die Funktion teilt den Datensatz in Trainings- und Testsätze auf. - Basislerner definieren: Verwenden Sie
DecisionTreeClassifierundSVCals Basislerner. - Einen Stacking-Klassifikator erstellen: Verwenden Sie
StackingClassifierKlasse zum Erstellen eines Stacking-Klassifikators,final_estimator=LogisticRegression()was darauf hinweist, dass logistische Regression als Meta-Modell verwendet wird. - Trainieren Sie das Modell: Verwenden Sie
fit()Methode, um das Modell zu trainieren. - Vorhersagen: Verwenden Sie
predict()Methode, um Vorhersagen auf dem Testset zu treffen. - Genauigkeit berechnen: Verwenden Sie
accuracy_score()Funktion zur Berechnung der Genauigkeit des Modells.