Vorwärtspropagation und Backpropagation
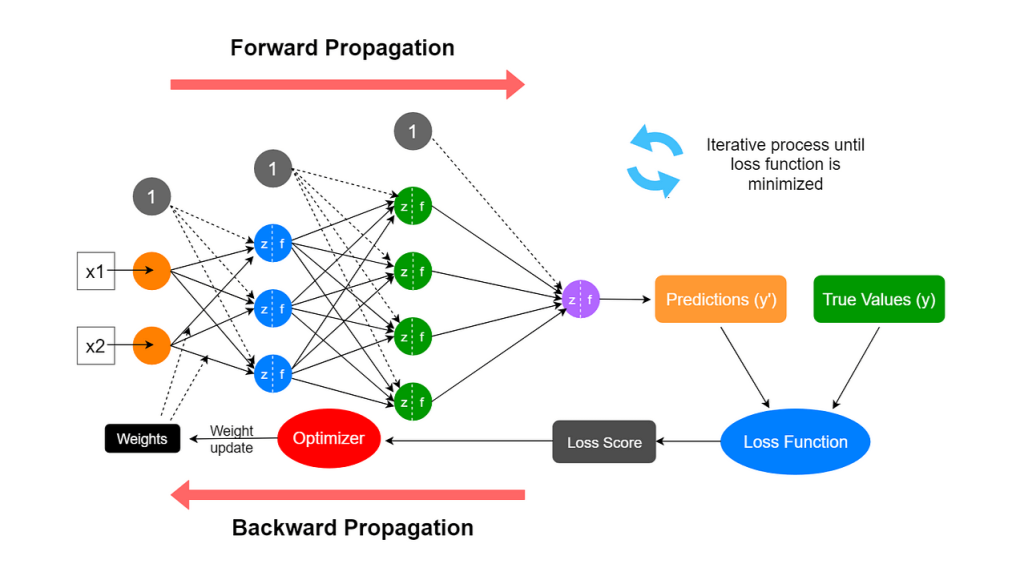
Im Deep Learning sind Forward Propagation und Backpropagation die beiden Kernpfeiler, die seine Funktionsweise tragen. Sie sind wie zwei Seiten derselben Medaille und bilden gemeinsam einen vollständigen geschlossenen Kreislauf vom Lernen bis zur Anwendung in neuronalen Netzen. Ein gründliches Verständnis dieser beiden Prozesse ist der erste Schlüssel, um die Tür zum Deep Learning zu öffnen.
Dieser Artikel führt Sie Schritt für Schritt durch diese scheinbar komplexen Konzepte, mit klarer Logik und lebendigen Analogien, sodass Sie nicht nur wissen, was sie sind, sondern auch verstehen, warum sie funktionieren.
Was sind Forward Propagation und Backpropagation?
Bevor wir ins Detail gehen, wollen wir zunächst ein Verständnis auf Makroebene schaffen.
Stellen Sie sich vor, Sie bringen einem Kind bei, Katzen und Hunde zu erkennen. Sie zeigen ihm ein Bild (Eingabe), und basierend auf dem Wissen, das bereits in seinem Gehirn vorhanden ist (Netzwerkparameter, d. h. Gewichte und Bias), trifft es eine Einschätzung und sagt Ihnen dann, dass dies eine Katze ist (Ausgabe). Dieser Prozess – das Bild ansehen -> Gehirnverarbeitung -> eine Antwort geben – istForward Propagation。
Doch die Einschätzung des Kindes kann falsch sein. Du sagst ihm: Nein, das ist ein Hund. Der Unterschied zwischen der richtigen Antwort und der Antwort des Kindes ist einFehler. Das Kind muss aufgrund dieses Fehlers reflektieren: Welches Wissen (welche Parameter) in meinem Gehirn hat zu dieser Fehleinschätzung geführt? Wie sollte ich sie anpassen, damit ich beim nächsten Mal richtig erkenne? Dieser Prozess der Anpassung des Wissens von hinten nach vorn ausgehend vom Fehler istBackpropagation。
In neuronalen Netzen:
- Vorwärtspropagation: Der Prozess, in dem Daten von der Eingabeschicht durch verborgene Schichten gehen und schließlich die Ausgabeschicht erreichen, wodurch ein Vorhersageergebnis entsteht. Dies ist einInferenzprozess.
- Backpropagation: Basierend auf dem Fehler zwischen dem durch Vorwärtspropagation erzeugten Vorhersageergebnis und dem wahren Wert beginnt sie bei der Ausgabeschicht und berechnet rückwärts, Schicht für Schicht, den „Beitrag“ jedes Parameters (Gewicht und Bias) zum Gesamtfehler (d. h. den Gradienten) und aktualisiert die Parameter entsprechend. Dies ist einLernprozess.
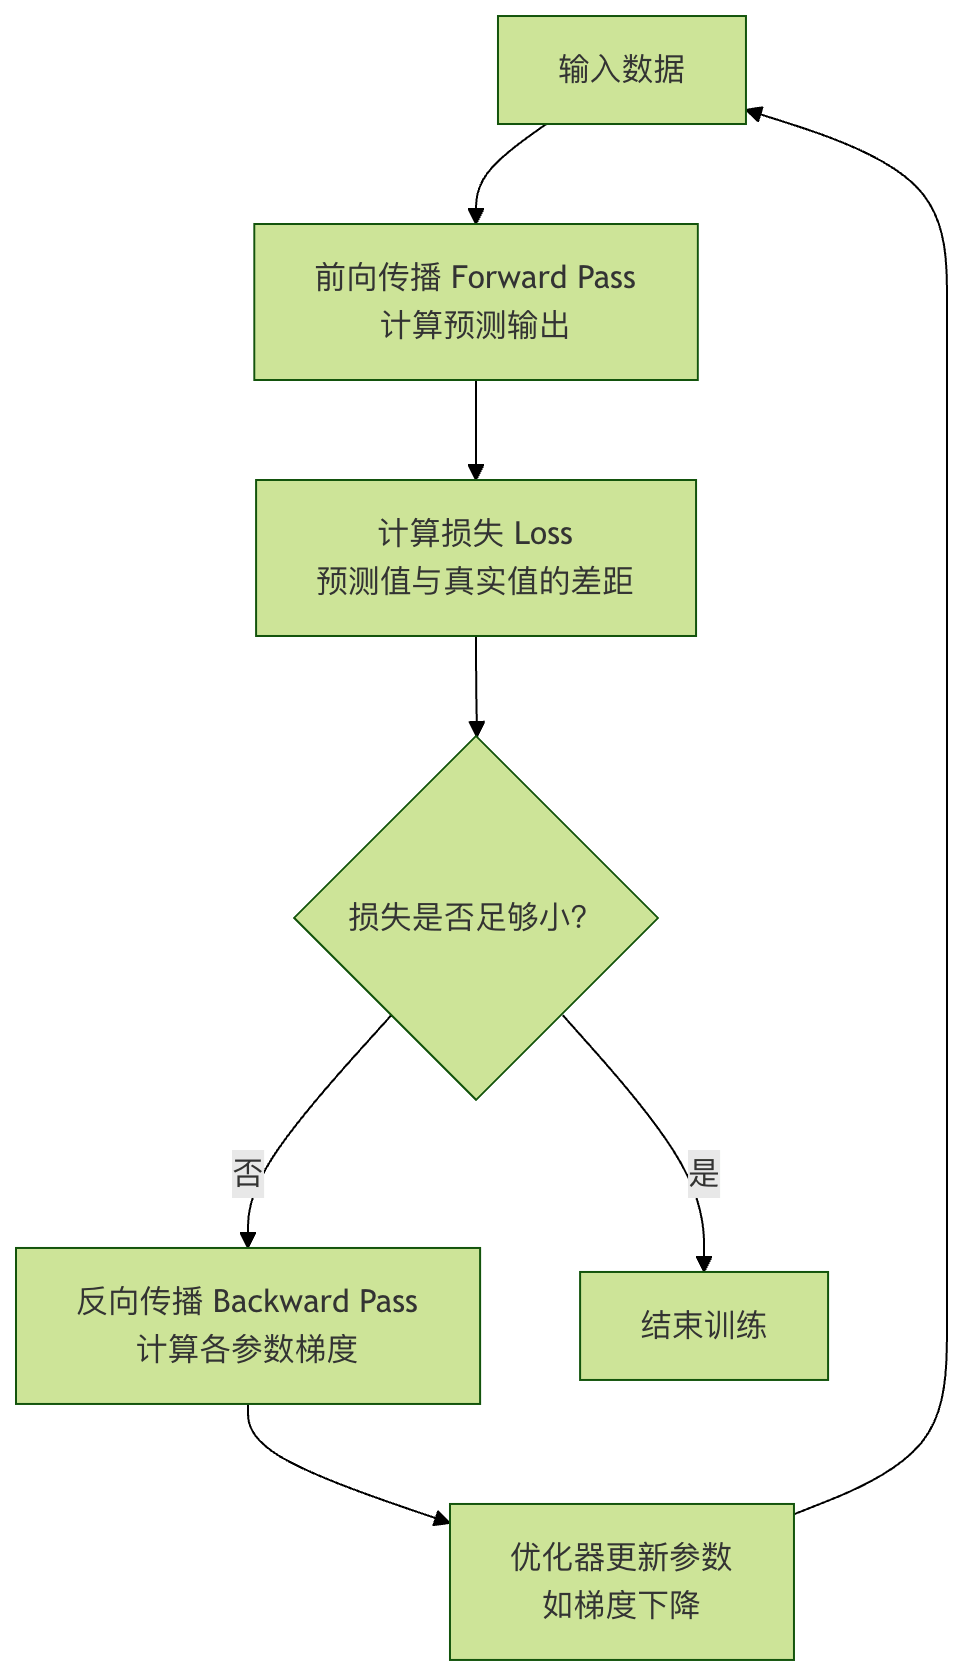
Ihre Beziehung kann durch ein einfaches Lernschleifen-Diagramm dargestellt werden:
Vorwärtspropagation: Der Inferenzpfad neuronaler Netze
Vorwärtspropagation ist der Vorwärtskanal, durch den neuronale Netze Vorhersagen treffen. Verstehen wir sie anhand eines einfachen dreischichtigen neuronalen Netzes (Eingabeschicht, eine verborgene Schicht, Ausgabeschicht).
Kernkonzepte und Berechnung
Angenommen, wir möchten Hauspreise vorhersagen, und die Eingabe ist die Wohnflächex. Unsere Miniatur-Netzwerkstruktur sieht wie folgt aus:
- Eingabeschicht: ein Neuron, das empfängt
x。 - Verdeckte Schicht: ein Neuron, mit Gewicht
w1und Biasb1。 - Ausgabeschicht: ein Neuron, mit Gewicht
w2und Biasb2, das den vorhergesagten Immobilienpreis ausgibty_pred。
Die Berechnung der Vorwärtspropagation ist in zwei Schritte unterteilt:
1. Berechnung der verdeckten Schicht: Eingabexund Gewichtw1, Biasb1werden kombiniert und dann durch eine Aktivierungsfunktion geleitet (z. B. Sigmoid, bezeichnet alsσ), wodurch die Ausgabe der verdeckten Schicht erzeugt wirda1。
z1 = w1 * x + b1
a1 = σ(z1) = 1 / (1 + exp(-z1))
z1ist das Ergebnis der linearen Transformation.a1ist die Ausgabe nach der nichtlinearen Aktivierung, wodurch das Netzwerk die Fähigkeit erhält, komplexe Muster zu erlernen.
2. Berechnung der Ausgabeschicht: Ausgabe der verborgenen Schichta1als Eingabe, mit dem Gewicht der Ausgabeschichtw2, Biasb2werden kombiniert, um die endgültige Vorhersage zu erzeugeny_pred. Der Einfachheit halber wird hier angenommen, dass die Ausgabeschicht keine Aktivierungsfunktion verwendet (d. h. lineare Ausgabe).
y_pred = w2 * a1 + b2
Codebeispiel: manuelle Implementierung der Vorwärtspropagation
Beispiel
def sigmoid(x):
"""Sigmoid-Aktivierungsfunktion"""
return 1 / (1 + np.exp(-x))
# Netzwerkparameter initialisieren (normalerweise zufällige Initialisierung, hier zur Demonstration angegebene Werte)
w1, b1 = 2.0, -1.0 # Parameter der verborgenen Schicht
w2, b2 = 1.5, 0.5 # Parameter der Ausgabeschicht
def forward_pass(x):
"""Führe eine Vorwärtspropagation durch"""
# Berechnung der verborgenen Schicht
z1 = w1 * x + b1
a1 = sigmoid(z1) # Aktivierungsfunktion anwenden
# Berechnung der Ausgabeschicht
y_pred = w2 * a1 + b2 # Lineare Ausgabe
# Zwischenergebnisse und endgültige Vorhersage zum späteren Verständnis zurückgeben
return {'z1': z1, 'a1': a1, 'y_pred': y_pred}
# Angenommen, die Hausfläche ist 3 (Einheit: 100 Quadratmeter)
x_input = 3.0
result = forward_pass(x_input)
print(f"Eingabe x = {x_input}")
print(f"Lineare Ausgabe der verborgenen Schicht z1 = w1*x + b1 = {result['z1']:.4f}")
print(f"Aktivierungsausgabe der verborgenen Schicht a1 = sigmoid(z1) = {result['a1']:.4f}")
print(f"Final predicted housing price y_pred = w2*a1 + b2 = {result['y_pred']:.4f}")
Beispielausgabe:
输入 x = 3.0
隐藏层线性输出 z1 = w1*x + b1 = 5.0000
隐藏层激活输出 a1 = sigmoid(z1) = 0.9933
最终预测房价 y_pred = w2*a1 + b2 = 1.9899
Diesy_predist der vom Netzwerk vorhergesagte Preis für ein Haus mit Fläche 3. Aber offensichtlich ist dieser vorhergesagte Wert (basierend auf Parametern, die wir beiläufig festgelegt haben) wahrscheinlich weit vom tatsächlichen Hauspreis entfernt. Wie messen wir diese Lücke und verbessern sie? Dafür benötigt manVerlustfunktionund die bevorstehendeBackpropagation。
Verlustfunktion: Ein Maßstab zur Bewertung von Gut oder Schlecht
Bevor die Backpropagation beginnt, müssen wir zunächst den vorhergesagten Wert quantifiziereny_predund den wahren Werty_truedie Lücke zwischen ihnen. Das ist die Rolle der Verlustfunktion.
Gängige Verlustfunktionen:
- Mittlerer quadratischer Fehler: Geeignet für Regressionsprobleme (z. B. Vorhersage von Hauspreisen, Temperatur).
Loss = (1/N) * Σ (y_true - y_pred)^2 - Kreuzentropie-Verlust: Geeignet für Klassifikationsprobleme (z. B. Bildklassifikation, Spam-Erkennung).
Nehmen wir den mittleren quadratischen Fehler als Beispiel, für eine einzelne Stichprobe:
Loss = (y_true - y_pred)^2
Unser Ziel ist es, anzupassenw1, b1, w2, b2, um diesenLossWert so klein wie möglich zu machen.
Backpropagation: Die Lern-Engine neuronaler Netze
Backpropagation ist der zentrale Lernalgorithmus des Deep Learnings. Ihr Wesen istdie Kettenregel, effizient in neuronalen Netzen angewendet. Das Ziel ist es, die Verlustfunktion zu berechnenLin Bezug auf jeden Parameter (w1, b1, w2, b2)partielle Ableitungen (Gradienten), i.e.,∂L/∂w1, ∂L/∂b1usw. Diese Gradienten geben an, in welche Richtung und mit welcher Größe jeder Parameter angepasst werden sollte, um den Verlust zu verringern.
Gradienten verstehen: Richtung und Schrittweite beim Bergabgehen
Stellen Sie sich vor, Sie sind mit verbundenen Augen auf einem Berg (Verlustfläche) und das Ziel ist, den tiefsten Punkt des Tals zu finden (minimaler Verlust). Vor jedem Schritt müssen Sie mit Ihren Füßen die steilste Bergabrichtung um sich herum erfühlen. Diese steilste Bergabrichtung istder Gradient. Backpropagation ist genau das, was Ihnen hilft, den Gradienten an jedem Punkt unter Ihren Füßen zu berechnen (entsprechend jedem Parametersatz).
Berechnungsschritte der Backpropagation (Kettenregel)
Wir verwenden weiterhin das vorherige Miniatur-Netzwerk und nehmen an, dass der wahre Immobilienpreisy_true = 2.5, und die Verlustfunktion ist der mittlere quadratische FehlerL = (y_true - y_pred)^2。
Backpropagation beginnt bei der Ausgabeschicht,in umgekehrter Reihenfolgeund berechnet die Gradienten Schicht für Schicht:
Berechne die Gradienten der Parameter der Ausgabeschicht
- Verlust
Lin Bezug auf den vorhergesagten Werty_predGradient:∂L/∂y_pred = -2 * (y_true - y_pred) - Weil
y_pred = w2 * a1 + b2, daher:∂L/∂w2 = (∂L/∂y_pred) * (∂y_pred/∂w2) = (∂L/∂y_pred) * a1∂L/∂b2 = (∂L/∂y_pred) * (∂y_pred/∂b2) = (∂L/∂y_pred) * 1
Berechne die Gradienten der Parameter der verborgenen Schicht
- Zuerst benötigen wir den Verlust
Lin Bezug auf die Ausgabe der verborgenen Schichta1Gradient.a1Durchy_predbeeinflusstL:∂L/∂a1 = (∂L/∂y_pred) * (∂y_pred/∂a1) = (∂L/∂y_pred) * w2 - Dann,
a1 = σ(z1), die Ableitung der Sigmoid-Funktionσ'(z) = σ(z)*(1-σ(z))。 - Schließlich berechnen wir
Lin Bezug auf die Parameter der verborgenen Schichtw1,b1Gradienten:∂L/∂w1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂w1) = (∂L/∂a1) * σ'(z1) * x∂L/∂b1 = (∂L/∂a1) * (∂a1/∂z1) * (∂z1/∂b1) = (∂L/∂a1) * σ'(z1) * 1
Codebeispiel: Backpropagation manuell implementieren
Beispiel
y_true = 2.5
y_pred = result['y_pred']
a1 = result['a1']
z1 = result['z1']
x = x_input
print(f"Wahrer Wert y_true = {y_true}")
print(f"Vorhergesagter Wert y_pred = {y_pred:.4f}")
print(f"Anfänglicher Verlust Loss = {(y_true - y_pred)**2:.4f}")
print("\n--- Backpropagation starten, um Gradienten zu berechnen ---")
# 1. Berechne den Gradienten des Verlusts bezüglich y_pred
dL_dy_pred = -2 * (y_true - y_pred)
print(f"Gradient ∂L/∂y_pred = -2*(y_true - y_pred) = {dL_dy_pred:.4f}")
# 2. Berechne die Gradienten der Parameter der Ausgabeschicht w2, b2
dL_dw2 = dL_dy_pred * a1
dL_db2 = dL_dy_pred * 1
print(f"Gradient ∂L/∂w2 = (∂L/∂y_pred) * a1 = {dL_dw2:.4f}")
print(f"Gradient ∂L/∂b2 = (∂L/∂y_pred) * 1 = {dL_db2:.4f}")
# 3. Berechne den Gradienten des Verlusts bezüglich der Ausgabe der verborgenen Schicht a1
dL_da1 = dL_dy_pred * w2
print(f"Gradient ∂L/∂a1 = (∂L/∂y_pred) * w2 = {dL_da1:.4f}")
# 4. Berechne den Wert der Ableitung der Sigmoid-Funktion an der Stelle z1
def sigmoid_derivative(x):
"""Ableitung der Sigmoid-Funktion"""
s = sigmoid(x)
return s * (1 - s)
sigma_prime_z1 = sigmoid_derivative(z1)
print(f"Sigmoid-Ableitung σ'(z1) = σ(z1)*(1-σ(z1)) = {sigma_prime_z1:.4f}")
# 5. Berechne die Gradienten der Parameter der verborgenen Schicht w1, b1
dL_dw1 = dL_da1 * sigma_prime_z1 * x
dL_db1 = dL_da1 * sigma_prime_z1 * 1
print(f"Gradient ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = {dL_dw1:.4f}")
print(f"Gradient ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = {dL_db1:.4f}")
Beispielausgabe:
真实值 y_true = 2.5
预测值 y_pred = 1.9899
初始损失 Loss = 0.2602

--- 开始反向传播计算梯度 ---
梯度 ∂L/∂y_pred = -2*(y_true - y_pred) = -1.0202
梯度 ∂L/∂w2 = (∂L/∂y_pred) * a1 = -1.0134
梯度 ∂L/∂b2 = (∂L/∂y_pred) * 1 = -1.0202
梯度 ∂L/∂a1 = (∂L/∂y_pred) * w2 = -1.5303
Sigmoid导数 σ'(z1) = σ(z1)*(1-σ(z1)) = 0.0066
梯度 ∂L/∂w1 = (∂L/∂a1) * σ'(z1) * x = -0.0304
梯度 ∂L/∂b1 = (∂L/∂a1) * σ'(z1) * 1 = -0.0101
Nun haben wir die Gradienten aller Parameter erhalten. Diese negativen Werte bedeuten, dass, wenn wir die Werte dieser Parametererhöhen, der Verlustzunehmenwird (weil die Gradientenrichtung die Richtung des Anstiegs ist). Um den Verlust zu verringern, sollten wiruns in die entgegengesetzte Richtung des Gradienten bewegen, um die Parameter anzupassen.
Parameteraktualisierung: Gradientenabstieg
Nachdem wir die Gradienten erhalten haben, verwenden wir denGradientenabstiegsalgorithmus, um die Parameter zu aktualisieren:
parameter = parameter - learning rate * the gradient of that parameter
wobei,Lernrateein sehr wichtiger Hyperparameter ist, der die Schrittweite jeder Parameteraktualisierung steuert. Ist die Schrittweite zu klein, ist das Lernen langsam; ist sie zu groß, kann die Konvergenz fehlschlagen oder sogar divergieren.
Codebeispiel: Anwenden des Gradientenabstiegs zur Aktualisierung von Parametern
Beispiel
# Parameter aktualisieren
w1_new = w1 - learning_rate * dL_dw1
b1_new = b1 - learning_rate * dL_db1
w2_new = w2 - learning_rate * dL_dw2
b2_new = b2 - learning_rate * dL_db2
print("--- Aktualisierte Parameter ---")
print(f"w1: {w1:.4f} -> {w1_new:.4f}")
print(f"b1: {b1:.4f} -> {b1_new:.4f}")
print(f"w2: {w2:.4f} -> {w2_new:.4f}")
print(f"b2: {b2:.4f} -> {b2_new:.4f}")
# Führe einen Vorwärtsdurchlauf mit den neuen Parametern durch, um zu überprüfen, ob der Verlust gesunken ist
def forward_pass_with_params(x, w1, b1, w2, b2):
z1 = w1 * x + b1
a1 = sigmoid(z1)
y_pred = w2 * a1 + b2
return y_pred
y_pred_new = forward_pass_with_params(x_input, w1_new, b1_new, w2_new, b2_new)
loss_new = (y_true - y_pred_new)**2
print(f"\n"Vorhersage mit neuen Parametern: y_pred_new = {y_pred_new:.4f}")
print(f"Aktualisierter Verlust Neuer Verlust = {loss_new:.4f}")
print(f"Verluständerung: {loss_new - (y_true-y_pred)**2:.4f} (ein negativer Wert bedeutet, dass der Verlust gesunken ist)")
Beispielausgabe:
--- 更新后的参数 ---
w1: 2.0000 -> 2.0030
b1: -1.0000 -> -0.9990
w2: 1.5000 -> 1.6013
b2: 0.5000 -> 0.6020

用新参数预测: y_pred_new = 2.1933
更新后的损失 New Loss = 0.0940
损失变化: -0.1662 (负值表示损失减小)
Großartig! Nach einemVorwärtspropagation -> Verlustberechnung -> Backpropagation -> Gradientenabstiegsupdatevollständigen Zyklus ist unser vorhergesagter Werty_predfrom1.99ist näher am wahren Wert2.5, und der Verlust ging ebenfalls von0.260auf0.094. Wenn man diesen Zyklus Tausende oder Millionen Mal wiederholt (mit großen Datenmengen), kann das neuronale Netz effektive Parameter lernen und genaue Vorhersagen treffen.
Praktische Übung: Festigen Sie Ihr Verständnis
Jetzt ist es an der Zeit, praktisch zu werden und das Gelernte zu festigen.
Übung 1: Das Netzwerk erweiternÄndern Sie den obigen Code, um die Neuronen der verborgenen Schicht auf 2 zu erhöhen. Sie müssen initialisierenw1als Array der Form(2,)Array (zwei Gewichte),b1ist(2,)array.
Übung 2: Die Aktivierungsfunktion ändernErsetzen Sie die Sigmoid-Aktivierungsfunktion durch die ReLU-Funktion (f(x) = max(0, x)). Sie müssen die Ableitung von ReLU neu herleiten und implementieren (f'(x) = 1 if x>0 else 0). Vergleichen Sie, wie sich der Trainingsprozess unterscheidet, wenn verschiedene Aktivierungsfunktionen verwendet werden.
Übung 3: Eine Trainingsschleife implementierenSchreiben Sie eine vollständige Trainingsschleife, um einen einfachen Datensatz anzupassen (z. B. erstellen Sie Ihre eigeneny = 2x + 1 + 噪声Daten), indem Sie ein winziges Netzwerk trainieren, um es anzupassen. Legen Sie die Anzahl der Epochen fest, geben Sie den Verlust nach jeder Iteration aus und beobachten Sie, ob der Verlust mit fortschreitendem Training weiter abnimmt.
Übung 4: Die Auswirkungen der Lernrate verstehenVersuchen Sie basierend auf Übung 3 verschiedenelearning_rate(z. B. 0.01, 0.1, 0.5, 1.0). Beobachten Sie, wie sich die Verlustkurve ändert, wenn die Lernrate zu groß oder zu klein ist (ob sie oszilliert, divergiert oder langsam konvergiert), und verstehen Sie die Bedeutung der Lernrate als Schrittweite eingehend.
Zusammenfassung
Vorwärtspropagation und Backpropagation sind die Kerndynamik des Lernens neuronaler Netze:
- Vorwärtspropagation,ja,ist der Inferenzpfad, der aktuelle Parameter verwendet, um Eingaben auf Ausgaben abzubilden, und eine Bewertung (Verlust) der aktuellen Leistung berechnet.
- Backpropagation,ja,ist der Lernalgorithmus, der die Kettenregel verwendet, um den Gradienten der Verlustfunktion in Bezug auf jeden Parameter im Netzwerk effizient zu berechnen und die Richtung für die Parameteroptimierung anzugeben.
- Gradientenabstieg,ja,ist die Optimierungsstrategie, die tatsächlich Parameter mithilfe der von der Backpropagation bereitgestellten Gradienten mit der Lernrate als Schrittweite aktualisiert und so die Leistung des Netzwerks schrittweise verbessert.