Probleme der Erklärbarkeit
Stellen Sie sich vor, Sie gehen zu einem Arzt, und der Arzt sagt Ihnen: Laut meinem fortschrittlichen Diagnosesystem benötigen Sie diese Operation, aber ich kann nicht erklären, warum. Würden Sie zustimmen? Die meisten Menschen würden zögern, weil wir die Gründe hinter Entscheidungen verstehen wollen.
Im Bereich des maschinellen Lernens stehen wir vor einem ähnlichen Dilemma. Viele fortgeschrittene Modelle des maschinellen Lernens, insbesondere Deep-Learning-Modelle, sind wie Blackboxes – wir können die Eingaben und Ausgaben sehen, aber es ist schwierig zu verstehen, wie intern Entscheidungen getroffen werden. Das istdas Problem der Interpretierbarkeit des maschinellen Lernens, das zu einem der Haupthindernisse geworden ist, die die breite Anwendung von KI-Technologie in praktischen Schlüsselbereichen (wie Gesundheitswesen, Finanzen und Justiz) einschränken.
Dieser Artikel hilft Ihnen zu verstehen, was Interpretierbarkeit ist, warum sie so wichtig ist und welche aktuellen Herausforderungen und Lösungen es gibt.
Was ist die Interpretierbarkeit des maschinellen Lernens?
Grundlegende Konzepte
Die Interpretierbarkeit des maschinellen Lernensbezieht sich auf unsere Fähigkeit, den Entscheidungsprozess künstlicher Intelligenz zu verstehen, ihm zu vertrauen und ihn effektiv zu steuern.
Einfach gesagt ist es die Fähigkeit zu beantworten, warum das Modell eine solche Vorhersage getroffen hat.
Zwei Ebenen der Interpretierbarkeit
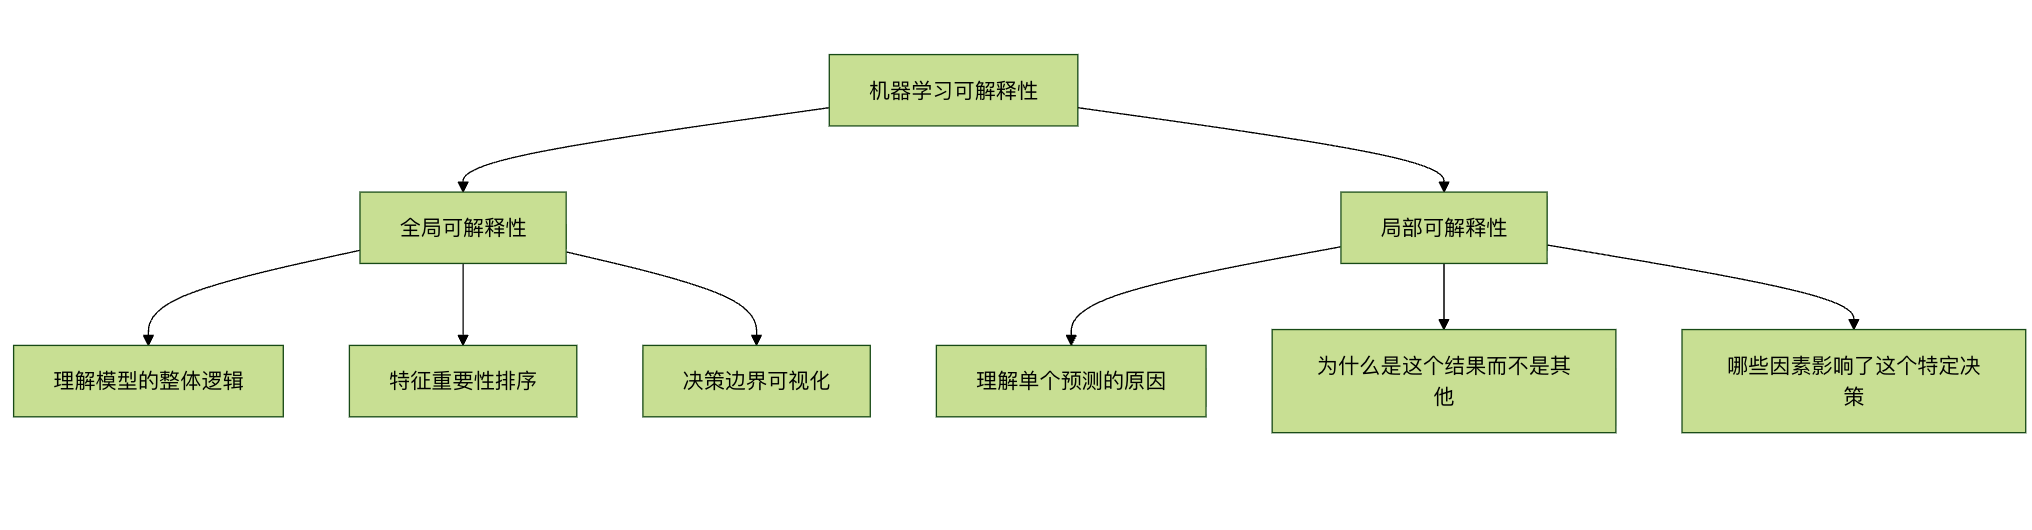
Globale InterpretierbarkeitFokussiert auf das Gesamtverhalten des Modells:
- Welche Muster hat das Modell gelernt?
- Welche Merkmale sind für Vorhersagen am wichtigsten?
- Welche Form hat die Entscheidungsgrenze des Modells?
Lokale InterpretierbarkeitFokussiert auf einzelne Vorhersagen:
- Warum wurde diese Stichprobe als Klasse A statt als Klasse B vorhergesagt?
- Wenn sich ein Merkmalswert leicht ändert, wie ändert sich dann die Vorhersage?
- Welche Merkmale haben am meisten zu dieser spezifischen Vorhersage beigetragen?
Warum ist Interpretierbarkeit so wichtig?
1. Aufbau von Vertrauen und Transparenz
In Hochrisikobereichen wie dem Gesundheitswesen, dem autonomen Fahren und der finanziellen Risikokontrolle müssen Menschen die Grundlage von KI-Entscheidungen kennen. Wenn ein Modell einen Kreditantrag ablehnt oder eine Krankheit diagnostiziert, müssen wir die Gründe erklären können.
2. Erfüllung regulatorischer Anforderungen
Die EU-DSGVO (Datenschutz-Grundverordnung) schreibt ausdrücklich vor, dass Nutzer das Recht haben, "aussagekräftige Informationen über die involvierte Logik" zu erhalten. Viele Branchenvorschriften verlangen Transparenz im Entscheidungsprozess.
3. Debugging und Verbesserung von Modellen
Indem wir verstehen, wie das Modell funktioniert, können wir:
- Bias im Modell entdecken und korrigieren
- Vom Modell erlernte Scheinkorrelationen identifizieren
- Modellarchitektur und Feature-Engineering verbessern
4. Wissensentdeckung und wissenschaftliche Einsicht
Manchmal können Modelle Muster entdecken, die menschlichen Experten nicht aufgefallen sind, und diese Erkenntnisse können wissenschaftlichen Fortschritt vorantreiben.
5. Sicherheit und adversariale Angriffe
Das Verständnis der Schwächen eines Modells hilft, sich gegen adversariale Angriffe zu verteidigen (sorgfältig gestaltete Eingaben, die dazu führen, dass das Modell falsch klassifiziert).
Verschiedene Modelltypen und Interpretierbarkeit
Spektrum der Modelltransparenz
| Modelltyp | Interpretierbarkeit | Typische Vertreter | Geeignete Szenarien |
|---|---|---|---|
| Hoch interpretierbare Modelle | Hoch | Lineare Regression, Entscheidungsbäume, Logistische Regression | Bereiche, die eine hohe Erklärbarkeit erfordern, wie z. B. Finanzkredite |
| Modelle mit mittlerer Interpretierbarkeit | Mittel | Random Forests, Gradient-Boosting-Bäume | Szenarien, die Leistung und Interpretierbarkeit ausbalancieren |
| Modelle mit geringer Interpretierbarkeit | Niedrig | Deep Learning, komplexe Ensemble-Modelle | Leistung an erster Stelle, wie z. B. Bilderkennung, Verarbeitung natürlicher Sprache |
Beispielvergleich: Entscheidungsbaum vs. neuronales Netz
Beispiel für Entscheidungsbaum (hohe Interpretierbarkeit):
Beispiel
from sklearn.tree import DecisionTreeClassifier, plot_tree
import matplotlib.pyplot as plt
# Modell erstellen und trainieren
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)
# Entscheidungsbaum visualisieren
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=feature_names,
class_names=['Nicht genehmigt', 'Genehmigt'],
filled=True, rounded=True)
plt.title(Entscheidungsbaum zur Kreditgenehmigung - Vollständig interpretierbar)
plt.show()
Der Vorteil von Entscheidungsbäumen besteht darin, dass wir den Pfad vom Wurzelknoten zu den Blattknoten direkt nachverfolgen und vollständig verstehen können, wie jede Entscheidung getroffen wird.
Beispiel für neuronales Netz (geringe Interpretierbarkeit):
Beispiel
import tensorflow as tf
from tensorflow import keras
# Ein einfaches neuronales Netzwerk erstellen
model = keras.Sequential([
keras.layers.Dense(128, activation='relu', input_shape=(10,)),
keras.layers.Dense(64, activation='relu'),
keras.layers.Dense(32, activation='relu'),
keras.layers.Dense(1, activation='sigmoid') # Ausgabe der binären Klassifikation
])
model.compile(optimizer='adam',
loss='binary_crossentropy',
metrics=['accuracy'])
# Modell trainieren
history = model.fit(X_train, y_train,
epochs=50,
validation_split=0.2,
verbose=0)
Ein neuronales Netzwerk besteht aus Hunderten oder sogar Millionen miteinander verbundener Neuronen, wobei jede Verbindung ein Gewicht besitzt, das durch das Training automatisch angepasst wird. Obwohl wir alle Gewichtswerte einsehen können, ist es nahezu unmöglich zu verstehen, wie diese Zahlen gemeinsam eine bestimmte Vorhersage erzeugen.
Herausforderungen für die Interpretierbarkeit
1. Der Trade-off zwischen Genauigkeit und Interpretierbarkeit
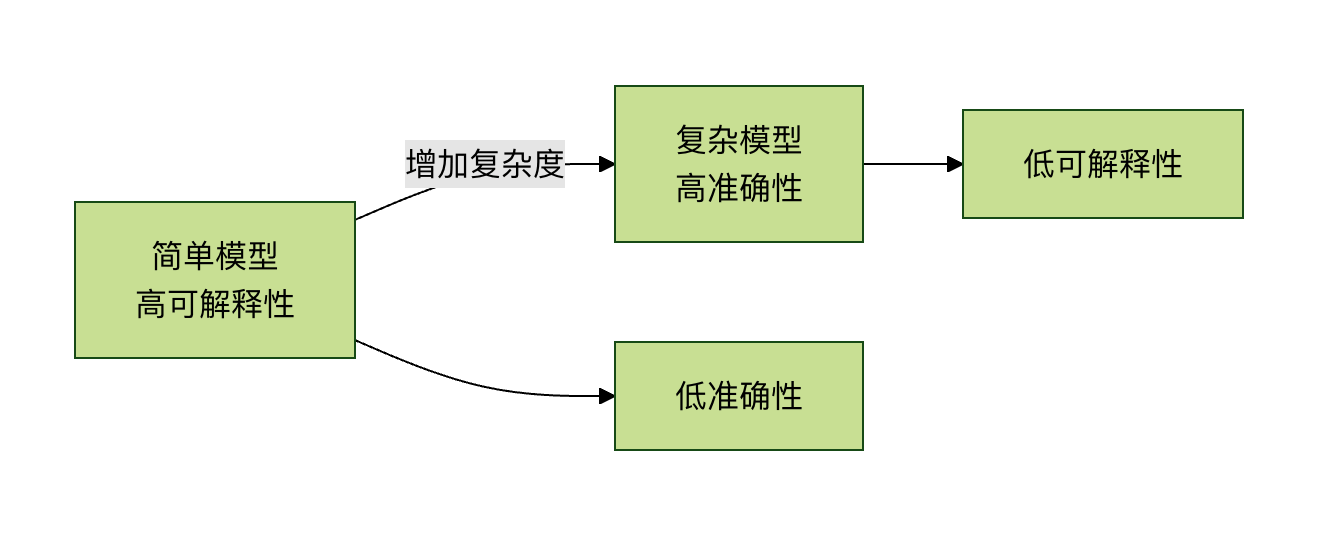
Im Allgemeinen gilt: Je komplexer das Modell und je besser seine Leistung, desto schlechter ist seine Interpretierbarkeit. Dies nennt manden Genauigkeits-Interpretierbarkeits-Trade-off.。
2. Technische Komplexität
Deep-Learning-Modelle können Folgendes aufweisen:
- Millionen von Parametern
- Komplexe nichtlineare Transformationen
- Mehrschichtige abstrakte Repräsentationen
3. Menschliche kognitive Einschränkungen
Selbst wenn wir technische Erklärungen erhalten, können sie das menschliche Auffassungsvermögen übersteigen. Beispielsweise ist eine Erklärung komplexer Interaktionen mit 1000 Merkmalen für das menschliche Gehirn schwer zu verarbeiten.
4. Mangel an Bewertungsstandards
Wie messen wir die "Qualität" einer Erklärung? Derzeit fehlen einheitliche und objektive Bewertungsstandards.
Aktuelle Techniken zur Interpretierbarkeit
1. Analyse der Merkmalswichtigkeit
Beispiel
import shap
import xgboost as xgb
import matplotlib.pyplot as plt
# Trainiere ein XGBoost-Modell
model = xgb.XGBClassifier()
model.fit(X_train, y_train)
# SHAP-Explainer erstellen
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X_test)
# Feature-Wichtigkeit visualisieren
shap.summary_plot(shap_values, X_test, plot_type="bar")
plt.title(Ranking der Feature-Wichtigkeit)
plt.show()
# Erklärung einer einzelnen Vorhersage
shap.force_plot(explainer.expected_value, shap_values[0,:], X_test.iloc[0,:])
SHAP (SHapley Additive exPlanations) basiert auf der Spieltheorie und weist jedem Merkmal einen Wichtigkeitswert zu, der den Beitrag des Merkmals zur Vorhersage zeigt.
2. LIME (Local Interpretable Model-agnostic Explanations)
Beispiel
import lime
from lime import lime_image
from skimage.segmentation import mark_boundaries
# LIME-Explainer erstellen
explainer = lime_image.LimeImageExplainer()
# Eine einzelne Bildvorhersage erklären
explanation = explainer.explain_instance(
image_array,
model.predict,
top_labels=3,
hide_color=0,
num_samples=1000
)
# Zeigt an, welche Regionen die Vorhersage unterstützen
temp, mask = explanation.get_image_and_mask(
explanation.top_labels[0],
positive_only=True,
num_features=5,
hide_rest=False
)
plt.imshow(mark_boundaries(temp, mask))
plt.title(Regionen im Bild, die die Vorhersage unterstützen)
plt.axis('off')
plt.show()
Die Kernidee von LIME besteht darin, ein einfaches, interpretierbares Modell (wie ein lineares Modell) in der Nähe eines einzelnen Vorhersagepunkts zu erstellen, um das Verhalten des komplexen Modells zu approximieren.
3. Aufmerksamkeitsmechanismus
In der natürlichen Sprachverarbeitung kann der Aufmerksamkeitsmechanismus zeigen, auf welche Teile des Eingabetexts das Modell bei Vorhersagen "achtet":
Beispiel
import numpy as np
import matplotlib.pyplot as plt
def visualize_attention(text, attention_weights):
"""
Aufmerksamkeitsgewichte visualisieren
Parameter:
text: tokenisierte Textliste
attention_weights: Aufmerksamkeitsgewicht für jedes Wort
"""
fig, ax = plt.subplots(figsize=(10, 2))
# Heatmap erstellen
im = ax.imshow([attention_weights], cmap='YlOrRd', aspect='auto')
# Koordinatenachsen festlegen
ax.set_xticks(range(len(text)))
ax.set_xticklabels(text, rotation=45, ha='right')
# Farbleiste hinzufügen
plt.colorbar(im)
plt.title("Visualisierung der Attention-Gewichte")
plt.tight_layout()
plt.show()
# Beispielverwendung
sample_text = ["I", "like", "machine learning", "'s", "interpretability", "research"]
sample_attention = [0.1, 0.15, 0.4, 0.05, 0.25, 0.05]
visualize_attention(sample_text, sample_attention)
4. Visualisierung der Entscheidungsgrenze
Bei niedrigdimensionalen Daten können wir die Entscheidungsgrenze des Modells direkt visualisieren:
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
def plot_decision_boundary(model, X, y):
"""
Zeichne die Entscheidungsgrenze zweidimensionaler Daten
Parameter:
model: trainierter Klassifikator
X: Merkmalsdaten (2D)
y: Labels
"""
# Mesh-Gitter erstellen
x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.02),
np.arange(y_min, y_max, 0.02))
# Auf dem gesamten Gitterraster vorhersagen
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Entscheidungsgrenze und Streudiagramm plotten
plt.figure(figsize=(10, 8))
plt.contourf(xx, yy, Z, alpha=0.4, cmap=plt.cm.RdYlBu)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50,
edgecolor='k', cmap=plt.cm.RdYlBu)
plt.xlabel('Merkmal 1')
plt.ylabel('Merkmal 2')
plt.title('Visualisierung der Entscheidungsgrenze')
plt.show()
# Beispieldaten generieren und Modell trainieren
np.random.seed(42)
X = np.random.randn(200, 2)
y = (X[:, 0] + X[:, 1] > 0).astype(int) # Einfache lineare Entscheidungsgrenze
model = LogisticRegression()
model.fit(X, y)
plot_decision_boundary(model, X, y)
Praktische Ratschläge: Umgang mit Interpretierbarkeitsproblemen in Projekten
1. Strategien basierend auf dem Anwendungsszenario wählen
| Anwendungsszenario | Anforderung an die Interpretierbarkeit | Empfohlene Methode |
|---|---|---|
| Medizinische Diagnose | Sehr hoch | Hoch interpretierbare Modelle verwenden oder Post-hoc-Erklärungen für komplexe Modelle hinzufügen |
| Finanzrisikokontrolle | Hoch | Analyse der Feature-Wichtigkeit, Extraktion von Entscheidungsregeln |
| Empfehlungssysteme | Mittel | Attention-Mechanismen, Generierung von Empfehlungsgründen |
| Bilderkennung | Relativ niedrig | Salienzkarten, Aktivierungsvisualisierung |
| Forschungsexploration | Variable | Wähle basierend auf der spezifischen Forschungsfrage |
2. Schritte zur Implementierung der Interpretierbarkeit
Beispiel
class ExplainableMLPipeline:
def __init__(self, model, feature_names):
self.model = model
self.feature_names = feature_names
self.explanations = {}
def add_global_explanation(self, method='shap'):
"""Globale Erklärung hinzufügen"""
if method == 'shap':
explainer = shap.TreeExplainer(self.model)
shap_values = explainer.shap_values(self.X)
self.explanations['global_shap'] = shap_values
# Diagramm zur Merkmalswichtigkeit erstellen
shap.summary_plot(shap_values, self.X,
feature_names=self.feature_names)
def add_local_explanation(self, instance_index, method='lime'):
"""Lokale Erklärung hinzufügen"""
if method == 'lime':
# Hier vereinfacht; in der Praxis wird der Explainer je nach Modelltyp ausgewählt
print(f"Vorhersageerklärung für Instanz {instance_index}:")
print(f"Vorhergesagter Wert: {self.model.predict([self.X[instance_index]]))
print("Wichtigste Einflussfaktoren:")
# Zeige die wichtigsten Merkmale und ihre Beiträge
def generate_report(self):
"""Interpretierbarkeitsbericht erstellen"""
report = {
'model_type': type(self.model).__name__,
'global_importance': self.get_feature_importance(),
'sample_explanations': self.get_sample_explanations(3),
'fairness_metrics': self.check_fairness()
}
return report
def get_feature_importance(self):
"""Merkmalswichtigkeit abrufen"""
# Berechnung der Merkmalswichtigkeit implementieren
pass
def check_fairness(self):
"""Modellfairness prüfen"""
# Fairness-Prüfung implementieren
pass
3. Praktische Checkliste
Bevor Sie ein Machine-Learning-Modell einsetzen, stellen Sie diese Fragen:
Technische Überlegungen
- Können wir die Gesamtlogik des Modells erklären?
- Können wir einzelne Vorhersagen erklären?
- Welche Merkmale haben den größten Einfluss auf die Vorhersagen?
- Beruht das Modell auf Scheinkorrelationen?
Überlegungen zu Ethik und Compliance
- Weist das Modell eine Verzerrung auf? Gegenüber welchen Gruppen?
- Entspricht es den relevanten regulatorischen Anforderungen?
- Können Nutzer aussagekräftige Erklärungen erhalten?
- Gibt es einen Mechanismus, um fehlerhafte Vorhersagen zu korrigieren?
Praktische Überlegungen
- Können die Erklärungen von Domänenexperten verstanden werden?
- Helfen die Erklärungen, das Modell zu verbessern?
- Unterstützen die Erklärungen die Entscheidungsfindung?
- Sind Erklärungen für Schlüsselentscheidungen dokumentiert?
Zukünftige Perspektiven und Forschungsrichtungen
1. Entwicklung intrinsisch interpretierbarer Modelle
Forschende entwickeln neue Modellarchitekturen, die sowohl leistungsstark als auch interpretierbar sind, wie zum Beispiel:
- Neuro-symbolische Systeme: Kombination neuronaler Netze mit Lernregeln
- Interpretierbare neuronale Netze: Entwurf von Netzwerken mit transparenten Strukturen
- Capsule-Netzwerke: Bereitstellung besserer hierarchischer Repräsentationen
2. Standardisierung und Evaluierungsframeworks
Die Industrie benötigt:
- Standardisierte Metriken zur Evaluierung der Interpretierbarkeit
- Objektive Methoden zur Messung der Erklärungsqualität
- Konsistenzvalidierung verschiedener Erklärungsmethoden
3. Kollaborative Mensch-KI-Erklärungssysteme
Zukünftige Systeme könnten:
- Erklärungen auf verschiedenen Ebenen je nach Nutzerhintergrund bereitstellen
- Interaktive Exploration und Rückfragen unterstützen
- Domänenwissen kombinieren, um aussagekräftigere Erklärungen zu generieren
4. Automatisierung der Interpretierbarkeit
Entwicklungsrichtungen für Werkzeuge:
- Automatische Auswahl der am besten geeigneten Erklärungsmethode
- Erklärungen in Echtzeit generieren, ohne die Leistung übermäßig zu beeinträchtigen
- Personalisierte Anpassung von Erklärungen
Zusammenfassung und Kernpunkte
Interpretierbarkeit ist nicht optional: In Hochrisikobereichen ist Interpretierbarkeit eine notwendige Bedingung für den Einsatz von KI-Systemen.
Trade-offs sind real: Ein kluger Kompromiss zwischen Genauigkeit und Interpretierbarkeit muss je nach Anwendungsszenario gefunden werden.
Der Werkzeugkasten ist reichhaltig: Von SHAP und LIME bis hin zu Attention-Mechanismen gibt es mehrere Techniken, um die Interpretierbarkeit von Modellen zu verbessern.
Der Prozess ist systematisch: Interpretierbarkeit sollte den gesamten Lebenszyklus des maschinellen Lernens umfassen, von der Datenerfassung bis zur Modellbereitstellung.
Die Zukunft ist vielversprechend: Mit fortschreitender Forschung entwickeln wir neue Methoden, die sowohl leistungsstark als auch interpretierbar sind.
Tipps für Anfänger
Wenn Sie ein Anfänger im maschinellen Lernen sind:
- Beginnen Sie mit interpretierbaren Modellen: Beherrschen Sie zuerst interpretierbare Modelle wie lineare Regression, logistische Regression und Entscheidungsbäume
- Verstehe die Grundlagen, bevor du weitergehst: Nachdem du verstanden hast, wie einfache Modelle funktionieren, lerne dann komplexe Modelle
- Übe Erklärungstechniken: Verwende Tools wie SHAP und LIME, um deine Modelle zu erklären
- Kultiviere kritisches Denken: Frage immer: "Warum hat das Modell diese Vorhersage getroffen?"
Die Interpretierbarkeit des maschinellen Lernens ist nicht nur ein technisches Problem, sondern auch eine Brücke, die künstliche Intelligenz mit menschlichem Vertrauen verbindet. Mit fortschreitender Technologie bewegen wir uns auf transparentere und vertrauenswürdigere KI-Systeme zu, die es dem maschinellen Lernen ermöglichen werden, in immer kritischeren Bereichen eine wichtige Rolle zu spielen.
Praktische Übungen
Übung 1: Vergleich der Interpretierbarkeit verschiedener Modelle
Verwende den Iris-Datensatz, um die Interpretierbarkeit verschiedener Modelle zu vergleichen:
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
import shap
# Daten laden
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
iris.data, iris.target, test_size=0.2, random_state=42
)
# Verschiedene Modelle trainieren
models = {
'Logistische Regression': LogisticRegression(max_iter=1000),
'Decision Tree': DecisionTreeClassifier(max_depth=3),
'Random Forest': RandomForestClassifier(n_estimators=100)
}
# Erklärungen für jedes Modell generieren und vergleichen
for name, model in models.items():
model.fit(X_train, y_train)
accuracy = model.score(X_test, y_test)
print(f"{name} - Genauigkeit: {accuracy:.3f}")
# Versuche es zu erklären (hier am Beispiel der Feature-Wichtigkeit)
if hasattr(model, 'feature_importances_'):
print(f" Feature-Wichtigkeit: {model.feature_importances_}")
elif hasattr(model, 'coef_'):
print(f" Koeffizienten: {model.coef_}")
Übung 2: Mit SHAP ein Hauspreisvorhersagemodell erklären
Beispiel
from sklearn.datasets import fetch_california_housing
from sklearn.ensemble import RandomForestRegressor
import shap
import matplotlib.pyplot as plt
# Lade den California-Housing-Datensatz
housing = fetch_california_housing()
X = pd.DataFrame(housing.data, columns=housing.feature_names)
y = housing.target
# Modell trainieren
model = RandomForestRegressor(n_estimators=100, random_state=42)
model.fit(X, y)
# SHAP zur Erklärung verwenden
explainer = shap.TreeExplainer(model)
shap_values = explainer.shap_values(X)
# 1. Zusammenfassung der Feature-Wichtigkeit
plt.figure(figsize=(10, 6))
shap.summary_plot(shap_values, X, plot_type="bar")
plt.title("Feature-Wichtigkeit für die Vorhersage von Hauspreisen in Kalifornien")
plt.tight_layout()
plt.show()
# 2. Erklärung individueller Vorhersagen
sample_idx = 10 # Ein Beispiel auswählen
print(f"Tatsächlicher Hauspreis für das Beispiel {sample_idx}: ${y[sample_idx]:.2f}k")
print(f"Vorhergesagter Hauspreis für das Beispiel {sample_idx}: ${model.predict([X.iloc[sample_idx]]))
shap.force_plot(explainer.expected_value,
shap_values[sample_idx,:],
X.iloc[sample_idx,:],
matplotlib=True)