Maschinelles Lernen - Beispiel für bestärkendes Lernen
Stellen Sie sich vor, Sie bringen einem Welpen das Kommando "Sitz" bei. Sie sagen ihm nicht direkt, was das Wort "Sitz" bedeutet, sondern leiten es durch Belohnungen und Bestrafungen.
- Wenn der Welpe zufällig die Sitzaktion ausführt, geben Sie ihm sofort ein Leckerli (Belohnung)。
- Wenn es etwas falsch macht, geben Sie ihm kein Leckerli (Bestrafung)。
Nach vielen Versuchen versteht der Welpe schließlich den Zusammenhang zwischen dem Befehl "Sitz" und dem Erhalten eines Leckerlis und erlernt so diese Fähigkeit.
Bestärkendes LernenEs ist eine Methode des maschinellen Lernens, die es einem Computer (oder Agenten) ermöglicht, durch Interaktionen mit der Umgebung nach dem Prinzip von Versuch und Irrtum zu lernen, optimale Entscheidungen zu treffen, um eine maximale kumulative Belohnung zu erzielen.
Bestärkendes LernenEs gibt einen wesentlichen Unterschied zum überwachten Lernen (mit Standardantworten) und unüberwachten Lernen (Finden inhärenter Strukturen in Daten), die wir zuvor kennengelernt haben. Der Kern des bestärkenden Lernens ist derAgentundUmgebungkontinuierliche Interaktion zwischen [dem Agenten und der Umgebung].
Analyse der Kernkonzepte
Bevor wir in den Code eintauchen, sollten wir ein paar Schlüsselkonzepte verstehen. Sie sind wie die Regeln eines Spiels und definieren, wie die Welt des bestärkenden Lernens funktioniert.
-
Agent:Der Agent ist unser Lernender oder Entscheidungsträger. In der obigen Analogie ist er der Welpe. In einem Programm ist er ein Algorithmus, der dafür verantwortlich ist, die Umgebung zu beobachten, Aktionen auszuführen und aus den Ergebnissen zu lernen.
-
Umgebung:Die Umgebung ist die äußere Welt, in der der Agent existiert. Sie empfängt die Aktionen des Agenten und gibt zwei Rückmeldesignale: den neuen Zustand der Umgebung und die unmittelbare Belohnung, die durch die Aktion hervorgebracht wird.
-
Zustand:Ein Zustand ist eine Beschreibung der konkreten Situation der Umgebung zu einem bestimmten Zeitpunkt. In einem Labyrinthspiel ist der Zustand beispielsweise die Koordinaten der aktuellen Position des Agenten.
-
Aktion:Eine Aktion ist eine Wahl, die der Agent in einem bestimmten Zustand treffen kann. In einem Labyrinth können Aktionen beispielsweise nach oben, unten, links oder rechts sein.
-
Belohnung:Eine Belohnung ist ein direktes Bewertungssignal der Umgebung für die Aktion des Agenten, normalerweise ein numerischer Wert.Positive Belohnungbedeutet Ermutigung,Negative Belohnungbedeutet Bestrafung. Das ultimative Ziel des Agenten ist es, dieGesamtbelohnung (kumulative Belohnung)。
-
Policy:Eine Policy ist der Verhaltenskodex des Agenten. Sie definiert, welche Aktion in jedem möglichen Zustand gewählt werden sollte. Der Lernprozess ist im Wesentlichen der Prozess der Optimierung dieser Policy.
Um intuitiver zu verstehen, wie diese Konzepte zusammenwirken, schauen wir uns den grundlegenden Interaktionsablauf des Reinforcement Learning an:
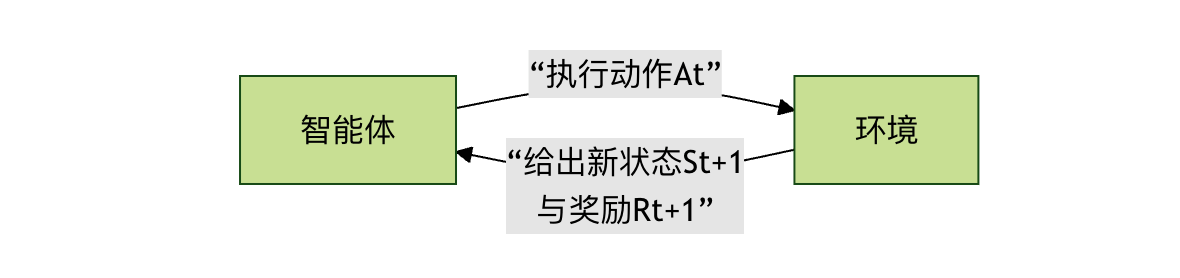
Diese Schleife wird fortgesetzt, bis ein Endzustand erreicht ist (z. B. das Spiel zu bestehen oder zu verlieren).
Klassisches Problem: Cliff Walking
Um die Theorie in die Praxis umzusetzen, verwenden wir eine klassische Beispielumgebung für Reinforcement Learning:CliffWalking-v0(Cliff Walking). Sie stammt ausgymnasiumBibliothek (ein gepflegter Zweig des ursprünglichen OpenAI Gym).
Beschreibung der Umgebung
- Szenario: eine 4x12-Rasterwelt.
- Startpunkt: untere linke Ecke (Koordinaten [3, 0]).
- Endpunkt: untere rechte Ecke (Koordinaten [3, 11]).
- Klippe: alle Positionen in der unteren Reihe außer den Start- und Endpunkten ([3, 1] bis [3, 10]). Ein Sturz von der Klippe führt zu einer enormen Strafe und zur Rückkehr zum Startpunkt.
- Ziel: Der Agent muss sicher vom Startpunkt zum Endpunkt gehen, ohne von der Klippe zu fallen.
- Aktionen: oben (0), rechts (1), unten (2), links (3).
- Belohnungen:
- Jeder Schritt auf einem normalen Gitter: -1 (ermutigt dazu, das Ziel mit weniger Schritten zu erreichen)
- Von der Klippe fallen: -100, und wird zurück zum Startpunkt geschickt
- Erreichen des Ziels: 0, und beendet diese Episode
Einführung in den Algorithmus: Q-Learning
Wir werden denQ-LearningAlgorithmus verwenden, um dieses Problem zu lösen. Er ist einmodellfreierReinforcement-Learning-Algorithmus, was bedeutet, dass der Agent die zugrunde liegenden Regeln der Umgebung nicht im Voraus kennen muss (wie Zustandsübergangswahrscheinlichkeiten). Er lernt durch kontinuierliches Ausprobieren.
Sein Kern ist eine Tabelle namensQ-Tabelle.
- ZeileZeilen repräsentieren alle möglichen Zustände.
- SpalteSpalten repräsentieren alle möglichen Aktionen.
- Der Wert einer Zelle (Q-Wert)repräsentiert den langfristig erwarteten Ertrag für die Ausführung einer bestimmten Aktion in einem bestimmten Zustand.
Der Lernprozess des Q-Learning kann in den folgenden Schritten zusammengefasst werden. Er zeigt, wie der Agent sein Wissen (Q-Tabelle) durch eine einzelne Erfahrung aktualisiert:
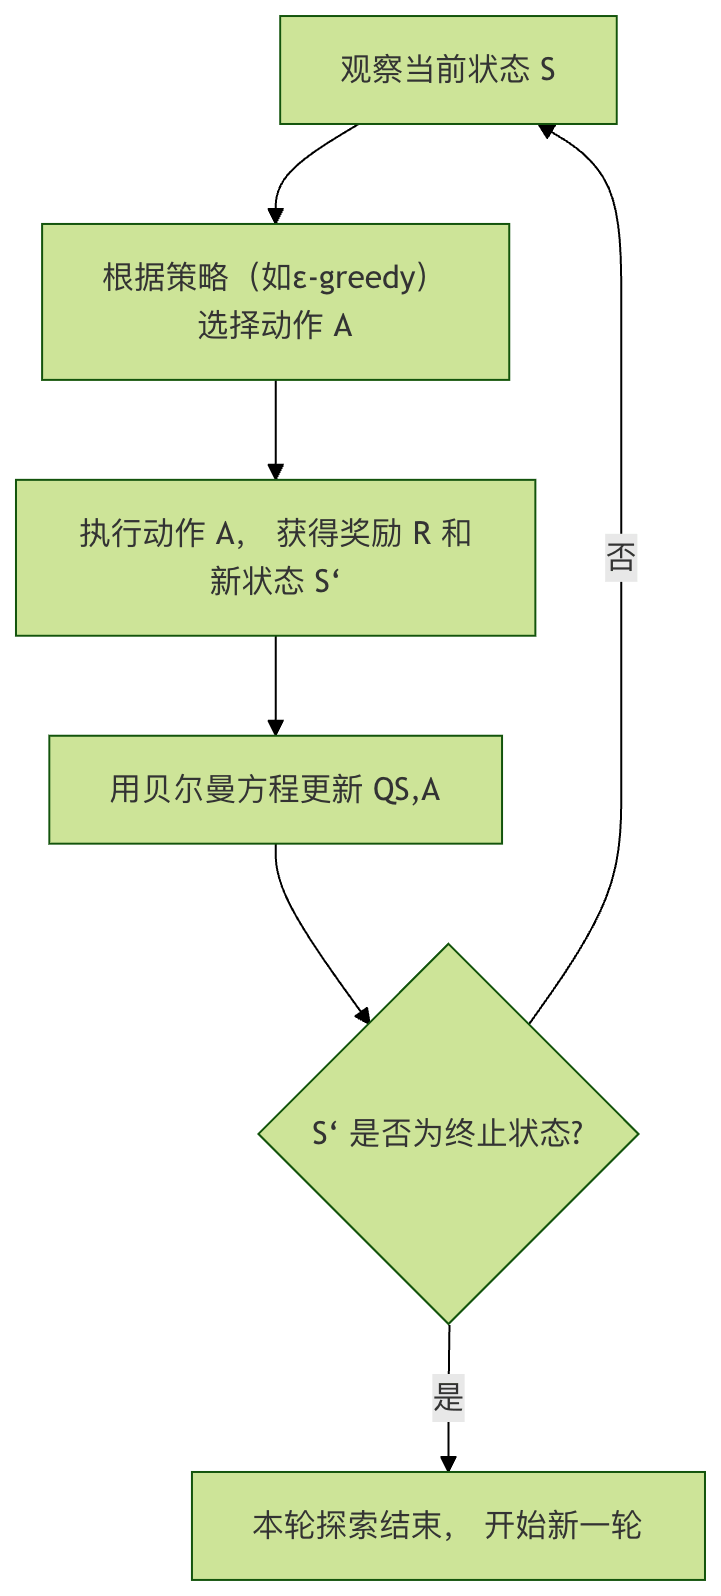
Kernformel: Bellman-Gleichung
Die mathematische Grundlage für Aktualisierungen der Q-Tabelle ist die Bellman-Gleichung, und ihre Aktualisierungsformel lautet wie folgt:
\[ Q(S, A) \leftarrow Q(S, A) + \alpha [R + \gamma \max_{a} Q(S', a) - Q(S, A)] \]
Zerlegen wir jeden Teil dieser Formel:
| Symbol | Bedeutung | Analogie-Erklärung |
|---|---|---|
| \( Q(S, A) \) | Ursprünglicher Q-Wert der Aktion A im Zustand S | Deine bisherige alte Bewertung der Entscheidung, an einer Kreuzung geradeaus zu fahren |
| \(\alpha \) | Lernrate (0 < α ≤ 1) | Wie sehr du dieser neuen Erfahrung vertraust. α=1 bedeutet, altes Wissen vollständig durch neue Erfahrung zu ersetzen; α=0.1 bedeutet, dass die neue Erfahrung altes Wissen nur leicht korrigiert |
| \(R \) | Dieunmittelbare Belohnung | Nachdem du geradeaus gefahren bist, stellst du fest, dass die Straße frei ist, und bekommst ein kleines positives Feedback (+1) |
| \(\gamma \) | Diskontfaktor (0 ≤ γ < 1) | Wie sehr du zukünftige Belohnungen schätzt. γ=0 bedeutet, dass du dich nur um unmittelbare Belohnungen kümmerst; γ=0.9 bedeutet, dass du langfristigen Erträgen große Bedeutung beimisst |
| \(\max_{a} Q(S', a) \) | Der maximale Q-Wert unter allen möglichen Aktionen im neuen Zustand S' | Nachdem du an der neuen Kreuzung angekommen bist, bewertest du, welche der Möglichkeiten – links abbiegen, rechts abbiegen oder geradeaus fahren – den höchsten zukünftigen Ertrag bringt |
| \(R + \gamma \max_{a} Q(S', a)\) | Ziel-Q-Wert, der eine neue und bessere Schätzung der aktuellen Entscheidung darstellt | Durch die Kombination der unmittelbaren Belohnung und des besten zukünftigen Ertrags erhält man eine neue Bewertung für die Entscheidung, an der alten Kreuzung geradeaus zu fahren |
| \(R + \gamma \max_{a} Q(S', a) - Q(S, A)\) | Temporal-Differenz-Fehler, die Lücke zwischen neuem und altem Wissen | Die Differenz zwischen der neuen Bewertung und der alten Bewertung. Diese Differenz treibt das Lernen voran. |
Einfach ausgedrückt, ermöglicht diese Formel dem Agenten,unmittelbare Belohnung + diskontierte beste Schätzung der Zukunftzu nutzen, um sein Urteil über den Wert der aktuellen Entscheidung kontinuierlich zu überarbeiten.
Praxis: Schreiben eines Q-Learning-Agenten
Nun wollen wir mit Code einen Q-Learning-Agenten implementieren, der das Cliff-Walking-Problem löst.
Schritt 1: Bibliotheken installieren und importieren
Stelle zunächst sicher, dass du die notwendigen Bibliotheken installiert hast. Führe Folgendes im Terminal oder in der Kommandozeile aus:
Beispiel
Importiere sie dann in einer Python-Datei:
Beispiel
import numpy as np
import random
Schritt 2: Umgebung und Q-Tabelle initialisieren
Beispiel
env = gym.make("CliffWalking-v0", render_mode="human") # render_mode="human" wird für die Visualisierung verwendet
# 2. Umgebungsinformationen abrufen
n_states = env.observation_space.n # Gesamtzahl der Zustände (4*12=48)
n_actions = env.action_space.n # Gesamtzahl der Aktionen (4 Richtungen)
# 3. Q-Tabelle mit Form [Anzahl der Zustände, Anzahl der Aktionen] initialisieren, alle Anfangswerte 0
Q_table = np.zeros((n_states, n_actions))
print(f"Anzahl der Umgebungszustände: {n_states}, Anzahl der Aktionen: {n_actions}")
print(f"Form der Q-Tabelle: {Q_table.shape}")
Schritt 3: Hyperparameter festlegen
Hyperparameter sind die Stellschrauben, die das Verhalten des Algorithmus steuern und je nach Problem angepasst werden müssen.
Beispiel
alpha = 0.1 # Lernrate: der Grad des Einflusses neuer Informationen
gamma = 0.99 # Diskontfaktor: Bedeutung zukünftiger Belohnungen
epsilon = 0.1 # Explorationsrate: Wahrscheinlichkeit, eine zufällige Exploration durchzuführen (anstatt die bekannte beste Aktion zu wählen)
num_episodes = 500 # Anzahl der Trainings-Episoden (wie oft der Agent das Spiel spielt)
Schritt 4: ε-greedy-Strategie implementieren
Dies ist die Kernstrategie für die Entscheidungsfindung des Agenten; sie balanciertExplorationundExploitation。
- Exploration: zufällige Auswahl von Aktionen, um potenziell bessere Strategien zu entdecken.
- Exploitation: Auswahl der Aktion, die die aktuelle Q-Tabelle als optimal betrachtet, um den maximalen Nutzen zu erzielen.
Beispiel
"""
Wähle eine Aktion gemäß der ε-greedy-Richtlinie.
Parameter:
state: aktueller Zustand
Q_table: Q-Wert-Tabelle
epsilon: Explorationswahrscheinlichkeit
Rückgabe:
action: die ausgewählte Aktion (0, 1, 2, 3)
"""
# Generiere eine Zufallszahl zwischen 0 und 1
if random.uniform(0, 1) < epsilon:
# Exploration: Wähle zufällig eine Aktion
action = env.action_space.sample()
else:
# Ausnutzung: Wähle die Aktion mit dem höchsten Q-Wert im aktuellen Zustand
# np.argmax gibt den Index des Maximalwerts zurück, d. h. die optimale Aktion
action = np.argmax(Q_table[state])
return action
Schritt 5: Kern-Trainingsschleife
Dies ist der Hauptprozess, durch den der Algorithmus lernt.
Beispiel
reward_history = []
for episode in range(num_episodes):
# Umgebung zurücksetzen und den Anfangszustand abrufen
state, _ = env.reset()
total_reward = 0 # Kumulierte Belohnung für diese Episode
terminated = False # Ob der Endzustand erreicht wurde (Ziel/Klippe)
truncated = False # Ob aufgrund Überschreitung des Schrittlimits abgebrochen wurde (tritt in dieser Umgebung im Allgemeinen nicht auf)
# Interaktionsschleife für diese Episode, bis das Spiel endet
while not (terminated or truncated):
# 1. Eine Aktion auswählen
action = choose_action(state, Q_table, epsilon)
# 2. Die Aktion ausführen und Feedback von der Umgebung erhalten
next_state, reward, terminated, truncated, _ = env.step(action)
# 3. Die Q-Tabelle aktualisieren (Kern-Updateformel des Q-Learnings)
# Den aktuellen Q-Wert abrufen
current_q = Q_table[state, action]
# Ziel-Q-Wert berechnen: unmittelbare Belohnung + diskontierter zukünftiger maximaler Q-Wert
# Hinweis: Wenn der nächste Zustand ein Endzustand ist, gibt es keinen zukünftigen Q-Wert
if terminated:
target_q = reward
else:
target_q = reward + gamma * np.max(Q_table[next_state])
# Wende die Bellman-Gleichung an, um den Q-Wert zu aktualisieren
Q_table[state, action] = current_q + alpha * (target_q - current_q)
# 4. Zum nächsten Zustand übergehen und die Belohnung ansammeln
state = next_state
total_reward += reward
# Die Gesamtbelohnung für diese Episode aufzeichnen
reward_history.append(total_reward)
# Fortschritt alle 100 Episoden ausgeben
if (episode + 1) % 100 == 0:
avg_reward = np.mean(reward_history[-100:]) # Durchschnittliche Belohnung über die letzten 100 Episoden
print(f"Episode {episode + 1}, durchschnittliche Belohnung über die letzten 100 Episoden: {avg_reward:.2f}")
# Training beendet, die Umgebung schließen
env.close()
Schritt 6: Den trainierten Agenten testen
Nach Abschluss des Trainings schalten wir die Exploration aus und lassen den Agenten das gelernte Wissen (Q-Tabelle) rein ausnutzen, um die Umgebung zu durchlaufen und zu sehen, wie er abschneidet.
Beispiel
# Erstelle eine neue Testumgebung (du kannst render_mode weglassen oder ihn zur Anzeige in "human" ändern)
test_env = gym.make("CliffWalking-v0", render_mode="human")
state, _ = test_env.reset()
test_terminated = False
test_truncated = False
step_count = 0
while not (test_terminated or test_truncated):
# Beim Testen setzen wir epsilon=0, d. h. reine Ausnutzung, keine Exploration
action = choose_action(state, Q_table, epsilon=0)
state, reward, test_terminated, test_truncated, _ = test_env.step(action)
step_count += 1
print(f"Schritt {step_count}: Zustand {state}, Aktion {action}, Belohnung {reward}")
print(f"Test abgeschlossen! Gesamtschritte: {step_count}, Gesamtbelohnung: {reward} (Belohnung für das Erreichen des Ziels ist 0)")
test_env.close()
Laufergebnisse und Analyse
Vollständiger Code:
Beispiel
import numpy as np
import random
# =========================
# 1. Umgebung erstellen
# =========================
env = gym.make("CliffWalking-v0", render_mode="human")
# =========================
# 2. Umgebungsinformationen abrufen
# =========================
n_states = env.observation_space.n
n_actions = env.action_space.n
# =========================
# 3. Initialisiere die Q-Tabelle
# =========================
Q_table = np.zeros((n_states, n_actions))
print(f"Anzahl der Umgebungszustände: {n_states}")
print(f"Anzahl der Aktionen: {n_actions}")
print(f"Form der Q-Tabelle: {Q_table.shape}")
# =========================
# 4. Hyperparameter festlegen
# =========================
Alpha = 0.1
Gamma = 0.99
Epsilon = 0.1
num_episodes = 500
# =========================
# 5. ε-greedy-Strategie
# =========================
def choose_action(state, Q_table, epsilon):
if random.uniform(0, 1) < epsilon:
return env.action_space.sample()
return np.argmax(Q_table[state])
# =========================
# 6. Trainingsschleife
# =========================
reward_history = []
for episode in range(num_episodes):
state, _ = env.reset()
total_reward = 0
terminated = False
truncated = False
while not (terminated or truncated):
action = choose_action(state, Q_table, epsilon)
next_state, reward, terminated, truncated, _ = env.step(action)
current_q = Q_table[state, action]
if terminated:
target_q = reward
else:
target_q = reward + gamma * np.max(Q_table[next_state])
Q_table[state, action] = current_q + alpha * (target_q - current_q)
state = next_state
total_reward += reward
reward_history.append(total_reward)
if (episode + 1) % 100 == 0:
avg_reward = np.mean(reward_history[-100:])
print(f"Episode {episode + 1}, durchschnittliche Belohnung über die letzten 100 Episoden: {avg_reward:.2f}")
env.close()
# =========================
# 7. Trainingsergebnisse testen
# =========================
print("\n"=== Test wird gestartet ===")
test_env = gym.make("CliffWalking-v0", render_mode="human")
state, _ = test_env.reset()
terminated = False
truncated = False
step_count = 0
total_reward = 0
while not (terminated or truncated):
action = choose_action(state, Q_table, epsilon=0)
state, reward, terminated, truncated, _ = test_env.step(action)
step_count += 1
total_reward += reward
print(f"Schritt {step_count}: Zustand {state}, Aktion {action}, Belohnung {reward}")
print(f"Test abgeschlossen, Gesamtschritte: {step_count}, Gesamtbelohnung: {total_reward}")
test_env.close()
Nach dem Ausführen des vollständigen obigen Codes werden Sie zwei sehr intuitive Phänomene sehen: die Veränderung der Belohnungen während der Trainingsphase und den tatsächlichen Aktionspfad des Agenten während der Testphase.
1. Trainingsphase: Belohnungen steigen allmählich an
Während des Trainings gibt die Konsole alle 100 Episoden die durchschnittliche Belohnung der letzten 100 Episoden aus. Zum Beispiel:
轮次 100, 最近100轮平均奖励: -120.45
轮次 200, 最近100轮平均奖励: -65.32
轮次 300, 最近100轮平均奖励: -32.18
轮次 400, 最近100轮平均奖励: -18.06
轮次 500, 最近100轮平均奖励: -13.94
Sie werden einen offensichtlichen Trend bemerken:Die durchschnittliche Belohnung steigt weiter an (der Absolutwert negativer Werte wird kleiner)。
Was zeigt das?
- In der frühen Trainingsphase fällt der Agent häufig in die Klippe und erhält eine große Anzahl von
-100Strafen. - Mit fortschreitendem Training lernt die Q-Tabelle allmählich, "welche Pfade gefährlich und welche sicher sind."
- Der Agent beginnt, die Klippe proaktiv zu vermeiden und eine sichere Route zu wählen, die länger ist, aber geringere Strafen mit sich bringt.
Die Verbesserung der Belohnungen spiegelt im Wesentlichen die Verbesserung der Policy-Qualität wider.
2. Testphase: Verhaltensleistung des Agenten
In der Testphase setzen wirepsilonε auf 0, was bedeutet:
- Keine zufällige Erkundung mehr durchführen
- Agiere vollständig gemäß der in der Q-Tabelle gelernten optimalen Politik
Wenn du es aktiviert hastrender_mode="human", wirst du ein sehr typisches Verhalten sehen:
- Der Agent startet vom Startpunkt
- Bewegt sich horizontal an einer Position eine Zelle über der Klippe
- Bewegt sich dann nach unten, wenn er sich dem Ziel nähert, und erreicht es sicher
Genau das wird in der CliffWalking-Umgebung als dieoptimale Politik angesehen:
- nicht der kürzeste Weg (dicht an der Klippe entlang)
- sondern vielmehr der Pfad mitder minimalen erwarteten Strafepath
Dies spiegelt ein Kernmerkmal des bestärkenden Lernens wider:Es strebt langfristige kumulative Erträge an, nicht kurzfristige Optimalität。
3. Warum hat er gelernt, einen Umweg zu nehmen, anstatt den riskanten direkten Weg zu nehmen?
Dies ist eine sehr wichtige und zugleich sehr klassische Frage.
Aus menschlicher Intuition ist das Gehen entlang der Klippe der kürzeste Weg, aber für den Agenten:
- Mit einem falschen Schritt erhält er sofort
-100eine enorme Strafe. - Im Vergleich dazu führt das Gehen ein paar zusätzlicher Schritte nur zu ein paar weiteren Strafen.
-1
Unter der kumulativen Wirkung der Bellman-Gleichung:
Stetige kleine Verluste < gelegentliche große Katastrophen
Daher wird Q-Learning natürlich zu einer konservativeren Strategie mit einer höheren erwarteten Gesamtrendite konvergieren.
Häufige Probleme und Parametereffekte
1. Was passiert, wenn die Lernrate α zu groß oder zu klein ist?
- α zu groß: Der Lernprozess oszilliert, die Strategie ist instabil, und sie macht bestehende Erfahrungen leicht wiederholt zunichte
- α zu klein: Das Lernen ist sehr langsam und erfordert viele Episoden, um zu konvergieren
In diesem Beispiel,0.1ist eine relativ sichere Wahl.
2. Intuitive Bedeutung des Diskontfaktors γ
γ → 0: Der Agent kümmert sich nur um unmittelbare Belohnungen und wird leicht kurzsichtigγ → 1: Der Agent legt großen Wert auf langfristige Konsequenzen und ist eher wie ein weitsichtiger Planer
Beim Cliff-Walking-Problem hilft ein größeres γ dem Agenten zu erkennen, dass ein zusätzlicher Schritt jetzt dazu dient, größere Verluste in der Zukunft zu vermeiden.
3. Die wesentliche Rolle von ε
εEs bestimmt die Persönlichkeit des Agenten:
- ε groß → geht gern Risiken ein, erkundet mehr
- ε klein → konservativ, nutzt vorhandene Erfahrung stärker aus
In realen Projekten verwenden wir normalerweiseeine ε-Abklingstrategie::
- in der frühen Phase mehr erkunden
- und in der späteren Phase allmählich zu einer stabilen Policy konvergieren
Einschränkungen dieses Beispiels und Richtungen für Erweiterungen
Obwohl Q-Learning ein Klassiker ist, hat es auch offensichtliche Einschränkungen:
- Die Größe der Q-Tabelle wächst linear mit dem Zustandsraum
- Kontinuierliche Zustände (wie die reale physische Welt) können nicht direkt verarbeitet werden
- Konvergiert in komplexen Umgebungen langsam
Deshalb führen wir bei komplexeren Problemen Folgendes ein:
- Deep Q-Network(DQN)
- Policy Gradient
- Actor-Critic
Sie verwenden neuronale Netze, um die Q-Tabelle zu ersetzen, wodurch Reinforcement Learning auf reale Szenarien wie Spiele, Robotersteuerung und autonomes Fahren angewendet werden kann.
Zusammenfassung
Durch dieses vollständige Beispiel für Reinforcement Learning haben Sie:
- den grundlegenden Unterschied zwischen Reinforcement Learning und überwachtem / unüberwachtem Lernen verstanden
- Den vollständigen geschlossenen Kreislauf aus Agent, Umgebung, Zustand, Aktion, Belohnung und Policy gemeistert
- Einen lauffähigen, beobachtbaren und konvergenten Q-Learning-Agenten von Hand implementiert
- Die Kernidee des Reinforcement Learning verstanden: Maximierung langfristiger Erträge