Méthodes d'ensemble
En apprentissage automatique, vous avez peut-être déjà appris à entraîner un arbre de décision ou un modèle de régression logistique. La performance d'un modèle unique (que nous appelons un apprenant de base) peut parfois plafonner.
À ce stade, une idée puissante émerge :les méthodes d'ensemble, qui ne reposent pas sur la création d'un algorithme entièrement nouveau et plus complexe, mais sur la construction d'un super-modèle plus puissant, plus stable et plus précis en combinant astucieusement plusieurs modèles relativement simples, voire médiocres.
En termes simples, la philosophie centrale de l'apprentissage ensembliste estTrois cordonniers mettant leurs esprits en commun peuvent surpasser Zhuge Liang.。
Les méthodes d'ensemble agrègent la sagesse collective de plusieurs modèles pour compenser le biais, la variance ou les erreurs aléatoires qu'un modèle unique peut présenter, améliorant ainsi considérablement la performance globale de prédiction.
Cet article expliquera systématiquement les principes, les techniques courantes et les pratiques d'ingénierie des méthodes d'ensemble.
Idées de base et avantages de l'apprentissage ensembliste
Avant de nous plonger dans des méthodes spécifiques, nous devons d'abord comprendre pourquoi l'apprentissage d'ensemble fonctionne et quels bénéfices il peut apporter.
Idée centrale : réduire l'erreur
L'erreur de prédiction d'un modèle peut généralement être décomposée en trois parties :Biais、Varianceeterreur irréductible。
- Biais: Erreur systématique causée par des hypothèses incorrectes sur la nature du problème. Un biais élevé signifie que le modèlesous-apprendet ne peut pas capturer les relations de base dans les données.
- Variance: La sensibilité du modèle aux petites fluctuations des données d'entraînement. Une variance élevée signifie que le modèlesur-apprendet accorde trop d'attention au bruit dans les données d'entraînement.
- Erreur irréductible: Le bruit aléatoire inhérent aux données, qui ne peut être éliminé par aucun modèle.
L'objectif principal des méthodes d'ensemble est de combiner plusieurs modèles pourréduire la variance ou le biais du modèle global, afin d'obtenir des prédictions plus robustes (stables) et plus précises.
Principaux avantages
- Améliorer la précision: C'est l'objectif le plus direct ; les modèles d'ensemble surpassent le meilleur apprenant de base unique dans la grande majorité des scénarios.
- Renforcer la stabilité et la robustesse: Grâce à la moyenne ou au vote, les modèles d'ensemble sont moins sensibles aux données bruitées et aux valeurs aberrantes, ce qui réduit le risque de surapprentissage.
- Élargir l'espace d'hypothèses: Combiner plusieurs modèles équivaut à explorer un espace de solutions plus large, ce qui rend plus probable de s'approcher de la solution optimale du problème.
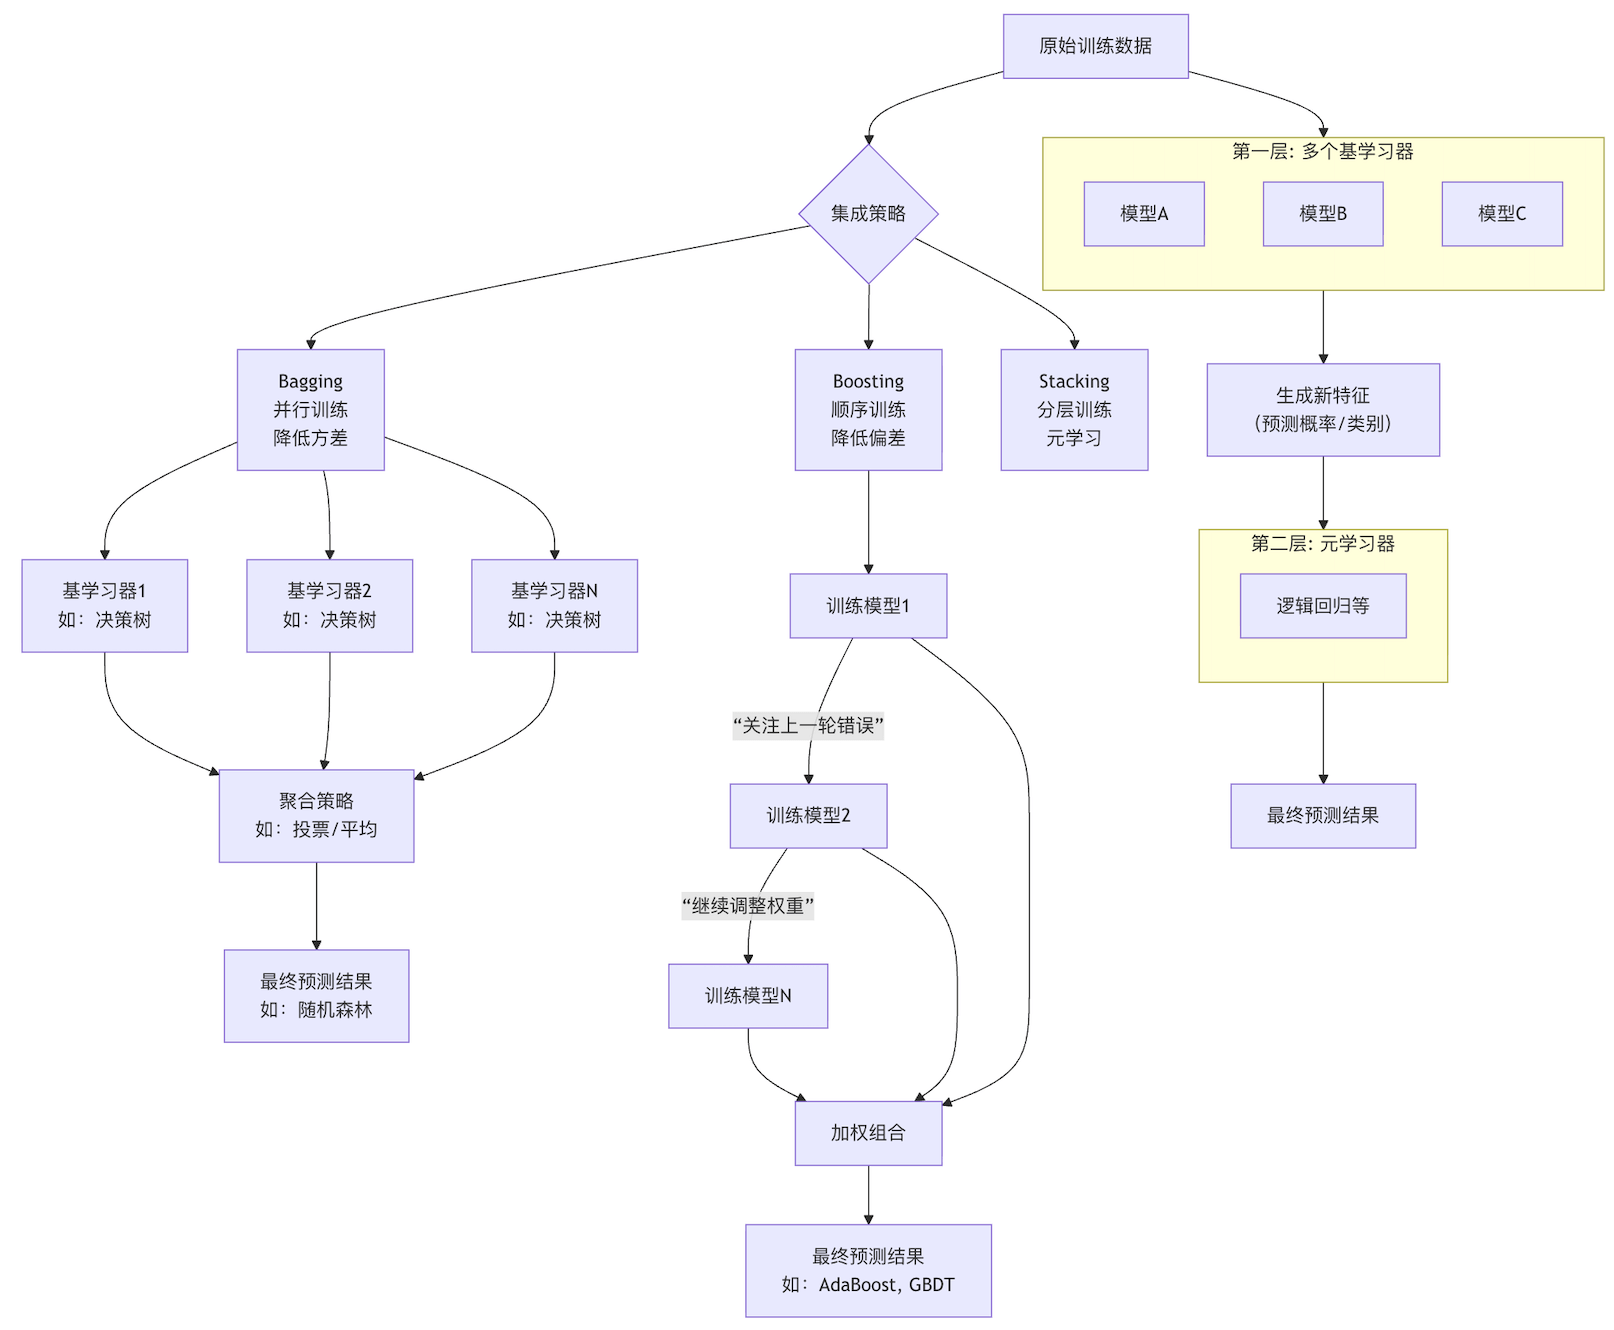
Pour comprendre plus intuitivement comment les méthodes d'ensemble fonctionnent en combinant plusieurs modèles, nous pouvons regarder le diagramme de flux suivant :
Explication détaillée des méthodes d'ensemble courantes
Selon la méthode de génération et la stratégie de combinaison des apprenants de base, les méthodes d'ensemble se divisent principalement en trois catégories :Bagging、BoostingetStacking。
Bagging : la voie du parallélisme, la stabilité avant tout
BaggingL'idée centrale estBootstrap Aggregating。
- Bootstrap: À partir de l'ensemble d'entraînement original, effectuer unéchantillonnage avec remiseéchantillonnage aléatoire pour générer plusieurs sous-ensembles d'entraînement différents. La taille de chaque sous-ensemble peut être identique à celle de l'ensemble original, mais en raison de l'échantillonnage avec remise, certains échantillons seront tirés plusieurs fois tandis que d'autres ne seront pas tirés du tout.
- Entraînement parallèle: Utiliser le même algorithme d'apprentissage (généralement un modèle à forte variance et faible biais, comme un arbre de décision non élagué) pour entraîner indépendamment un apprenant de base sur chaque sous-ensemble.
- Agrégation: Pour les tâches de classification, utiliser levote(règle de la majorité) pour déterminer la classe finale ; pour les tâches de régression, utiliser lamoyennepour calculer la valeur finale.
Algorithme représentatif : Forêt aléatoireLa forêt aléatoire est un représentant remarquable de l'idée de Bagging. Elle va un pas plus loin sur la base du Bagging : lorsque chaque arbre de décision effectue une division de nœud, il échantillonne non seulement aléatoirement des échantillons, mais aussisélectionne aléatoirement un sous-ensemble de caractéristiquespour effectuer la division optimale. Cette « double randomisation » renforce encore la diversité du modèle et sa capacité à éviter le surapprentissage.
Exemple
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger les données
iris = load_iris()
X, y = iris.data, iris.target
# Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer un classifieur de forêt aléatoire
# n_estimators : nombre d'arbres dans la forêt, nombre d'apprenants de base
# max_depth : profondeur maximale de l'arbre, contrôle la complexité du modèle
# random_state : graine aléatoire, garantit des résultats reproductibles
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Entraîner le modèle
rf_clf.fit(X_train, y_train)
# Prédire et évaluer
y_pred = rf_clf.predict(X_test)
print(f"Précision de la forêt aléatoire : {accuracy_score(y_test, y_pred):.4f}")
# Afficher la profondeur d'un seul arbre (exemple)
print(f"Profondeur du premier arbre : {rf_clf.estimators_)
Boosting : La sagesse de l'entraînement séquentiel, axé sur la correction des erreurs
BoostingIl adopte une stratégie complètement différente.
- Entraînement séquentiel: Les apprenants de base sontentraînés séquentiellement, plutôt qu'en parallèle.
- Se concentrer sur les erreurs: Chaque modèle suivant accorde plus d'attention aux échantillons que les modèles précédentsont mal prédits.Cela est généralement réalisé en ajustant les poids des échantillons d'entraînement (en donnant des poids plus élevés aux échantillons mal classés).
- Combinaison pondérée: Combiner tous les apprenants de base avecune somme pondéréepour obtenir le modèle final ; les apprenants de base qui fonctionnent bien ont des poids plus élevés.
Le cœur du Boosting est de corriger continuellement les erreurs de ses prédécesseurs, en élevant un groupe de « apprenants faibles » (à peine meilleurs que la devinette aléatoire) au rang de puissant « apprenant fort ».
Algorithmes représentatifs : AdaBoost et Gradient Boosting Decision Tree
- AdaBoost: L’un des premiers algorithmes de Boosting. Il augmente les poids des échantillons mal classés, forçant les modèles suivants à se concentrer sur ces échantillons « difficiles ».
- Gradient Boosting Decision Tree (GBDT): L’un des algorithmes de Boosting les plus populaires et les plus puissants. Il n’ajuste plus les poids des échantillons, mais considère plutôt le processus d’entraînement comme un processus d’optimisation pardescente de gradient. L’objectif de chaque nouvel arbre est d’ajuster lesrésidus(gradient négatif) entre les prédictions du modèle actuel et les vraies étiquettes.
Exemple
from sklearn.ensemble import GradientBoostingClassifier
# Créer un classifieur de gradient boosting
# n_estimators : nombre d’étapes de boosting (nombre d’arbres)
# learning_rate : taux d’apprentissage, contrôle la contribution de chaque arbre au résultat final (coefficient de rétrécissement)
# max_depth : profondeur maximale de chaque arbre de régression, généralement petite (3-5), représentant des apprenants faibles
gb_clf = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, max_depth=3, random_state=42)
# Entraîner le modèle
gb_clf.fit(X_train, y_train)
# Prédire et évaluer
y_pred_gb = gb_clf.predict(X_test)
print(f"Précision de l'arbre de Gradient Boosting : {accuracy_score(y_test, y_pred_gb):.4f}")
# Afficher l'importance des caractéristiques (les méthodes d'ensemble fournissent généralement cette information)
print("Importance des caractéristiques :", gb_clf.feature_importances_)
Sortie :
随机森林准确率: 1.0000
第一棵树的深度: 4
Stacking : empilement de modèles, stratégie de méta-apprentissage
StackingC'est une technique d'ensemble plus avancée qui introduit le concept de "méta-apprenant".
- Première couche : divers apprenants de base. Utilisezdifférentsalgorithmes d'apprentissage (tels que KNN, SVM, arbres de décision) pour entraîner plusieurs modèles sur les données d'origine.
- Générer de nouvelles caractéristiques: Utilisez ces modèles de première couche pour prédire les données d'entraînement (généralement en utilisant la validation croisée pour éviter la fuite de données), et utilisez leurs résultats de prédiction (étiquettes de classe ou probabilités) commenouvelles caractéristiques。
- Deuxième couche : entraîner le méta-apprenant. Avec ces nouvelles caractéristiques comme entrée et les étiquettes d'origine comme sortie, entraînez un modèle final (tel que la régression logistique ou la régression linéaire). Ce méta-apprenant est responsable d'apprendre comment combiner au mieux les sorties des modèles de première couche.
Le stacking a un grand potentiel, mais il est coûteux en calcul et nécessite une conception soignée pour éviter le surapprentissage.
Comparaison des méthodes et recommandations pour la pratique d'ingénierie
Après avoir compris les principes, comment choisir et appliquer ces méthodes dans des projets réels ?
Comparaison des trois méthodes
| Fonctionnalité | Bagging (par ex., Random Forest) | Boosting (par ex., GBDT, XGBoost) | Stacking |
|---|---|---|---|
| Objectif principal | Réduire la variance, éviter le surapprentissage | Réduire le biais, améliorer le pouvoir prédictif | Optimiser la stratégie de combinaison |
| Méthode d'entraînement | Entraînement parallèle et indépendant | Séquentiel, dépend des résultats du tour précédent | En couches, d'abord les apprenants de base puis le méta-apprenant |
| Poids des échantillons | Traités de manière égale, échantillonnage bootstrap | Ajustés dynamiquement, se concentrent sur les erreurs | Généralement égaux |
| Relation entre les apprenants de base | Mutuellement indépendants, la diversité provient de la perturbation des données | Mutuellement dépendants, optimisent conjointement l'objectif | Mutuellement indépendants, la diversité provient des différences d'algorithmes |
| Avantages | Stable, résistant au surapprentissage, facile à paralléliser | La précision de prédiction est généralement très élevée | Peut théoriquement atteindre les meilleures performances |
| Inconvénients | Réduction limitée du biais, consommation élevée de ressources de calcul | Sensible au bruit, enclin au surapprentissage, réglage complexe | Coût de calcul extrêmement élevé, structure complexe, enclin au surapprentissage |
| Applications typiques | Random Forest, Extra-Trees | AdaBoost, GBDT, XGBoost, LightGBM, CatBoost | Courant dans les compétitions de machine learning |
Guide de pratique d'ingénierie
Modèle de référence privilégié: N'utilisez pas de méthodes d'ensemble complexes dès le départ. Utilisez d'abord un modèle simple (comme la régression logistique, un seul arbre de décision) pour établir une référence de performance.
Choisir selon le problème:
- Si votre modèle de base (comme un arbre de décision très profond)surapprend fortement (variance élevée), essayez en prioritéBagging(Random Forest).
- Si votre modèle de basesous-ajuste (biais élevé), ou si vous recherchez une précision de prédiction extrêmement élevée, privilégiez l'essai deBoosting(comme XGBoost, LightGBM).
- Dansles compétitions d'apprentissage automatiqueou des scénarios avec des exigences de précision extrêmes, et des ressources de calcul suffisantes, vous pouvez envisagerStackingouBlending。
Utilisez des bibliothèques modernes optimisées: En pratique, utilisez directement des bibliothèques hautement optimisées qui implémentent des algorithmes d'ensemble de pointe :
- Scikit-learn: fournit
RandomForest,GradientBoostinget d'autres excellentes implémentations, adaptées aux débutants et au prototypage rapide. - XGBoost: Rapide, haute précision, complet, souvent gagnant dans les compétitions Kaggle.
- LightGBM: Lancé par Microsoft, vitesse d'entraînement plus rapide, consommation de mémoire moindre, particulièrement adapté aux grands jeux de données.
- CatBoost: Lancé par Yandex, gère bien les caractéristiques catégorielles et performe bien avec les paramètres par défaut.
Faites attention au réglage des hyperparamètres: Les modèles d'ensemble ont de nombreux hyperparamètres. Les principaux paramètres à surveiller incluent :
n_estimators: Nombre d'apprenants de base (plus il y en a, mieux c'est, mais le coût de calcul augmente).learning_rate(Boosting) : Taux d'apprentissage, contrôle la contribution de chaque étape. Doit généralement êtren_estimatorscompensé (un faible taux d'apprentissage nécessite plus d'arbres).max_depth(Méthode d'arbre) : clé pour contrôler la complexité du modèle et le surapprentissage.- Utilisezla validation croiséeetla recherche par grille/recherche aléatoirepour ajuster systématiquement les paramètres.