Python-Bibliotheken für maschinelles Lernen
Dieses Kapitel führt Sie in die vier zentralen Python-Bibliotheken im maschinellen Lernen ein: NumPy, Pandas, Matplotlib und Scikit-learn.
Bibliotheken für maschinelles Lernen sind wie ein professioneller Werkzeugkasten, und jede Bibliothek hat einen bestimmten Zweck; zusammen verwendet können sie komplexe Aufgaben des maschinellen Lernens bewältigen.
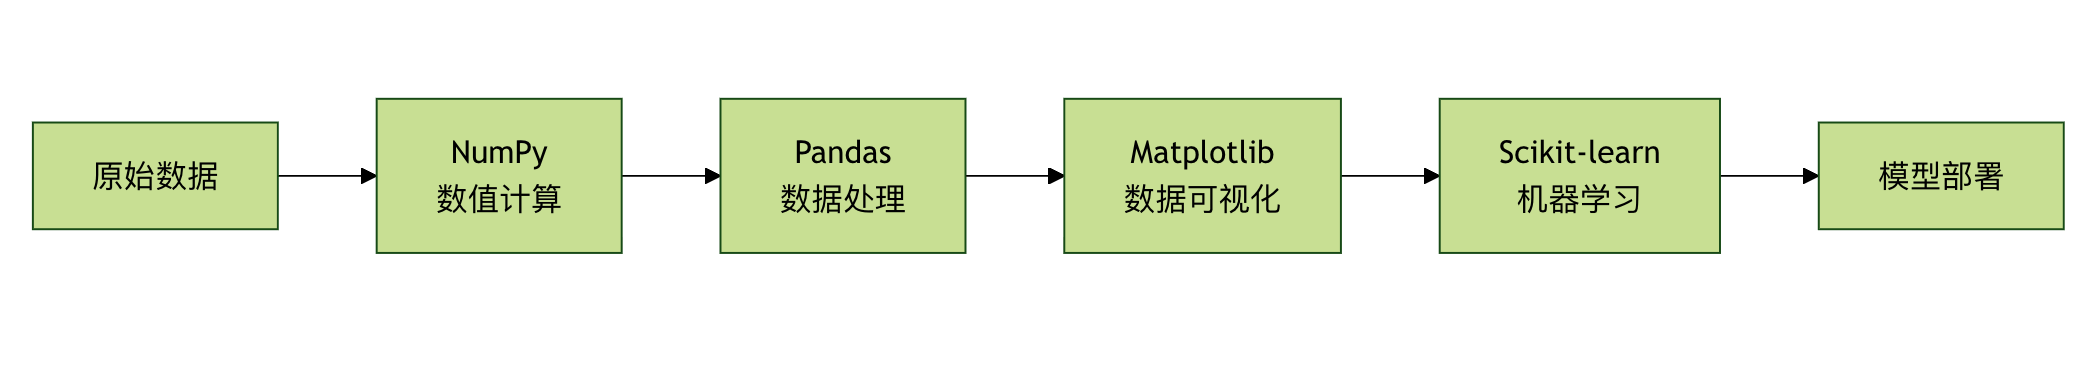
Rollen der vier Kernbibliotheken
- Numpy: die Grundlage der numerischen Berechnung, die effiziente Array-Operationen bietet
- Pandas: das scharfe Werkzeug für die Datenverarbeitung, das Datenstrukturen und Analysewerkzeuge bereitstellt
- Matplotlib: der Pinsel für die Datenvisualisierung, mit dem verschiedene Diagramme erstellt werden
- scikit-learn: das Schweizer Taschenmesser des maschinellen Lernens, das eine komplette ML-Toolchain bietet
NumPy: Die Grundlage der numerischen Berechnung
Was ist NumPy?
NumPy ist wie ein Taschenrechner für mathematische Berechnungen, aber es ist unzählige Male leistungsfähiger. Es ist die grundlegende Bibliothek für wissenschaftliches Rechnen in Python und bietet effiziente mehrdimensionale Array-Objekte.
Kernkonzepte von NumPy
1. Array
Beispiel
import numpy as np
# Verschiedene Möglichkeiten, Arrays zu erstellen
print("=== NumPy-Array-Erstellung ===")
# Aus einer Liste erstellen
arr1 = np.array([1, 2, 3, 4, 5])
print(f"Aus Liste erstellt: {arr1}")
# Ein Array mit arithmetischer Folge erstellen
arr2 = np.arange(0, 10, 2) # 0 bis 10, Schrittweite 2
print(f"Array mit arithmetischer Folge: {arr2}")
# Ein gleichmäßig verteiltes Array erstellen
arr3 = np.linspace(0, 1, 5) # 0 bis 1, 5 Punkte
print(f"Gleichmäßig verteiltes Array: {arr3}")
# Spezielle Arrays erstellen
zeros_arr = np.zeros((2, 3)) # 2x3-Array aus Nullen
ones_arr = np.ones((2, 3)) # 2x3-Array aus Einsen
identity_arr = np.eye(3) # 3x3-Einheitsmatrix
print(f"Nullen-Array:\n{zeros_arr}")
print(f"Einsen-Array:\n{ones_arr}")
print(f"Einheitsmatrix:\n{identity_arr}")
2. Array-Operationen
Beispiel
print("\n=== Grundlegende Array-Operationen ===)
# Array-Attribute
arr = np.array([[1, 2, 3], [4, 5, 6]])
print(f"Array:"\n{arr}")
print(f"Form: {arr.shape}")
print(f"Dimension: {arr.ndim}")
print(f"Anzahl der Elemente: {arr.size}")
print(f"Datentyp: {arr.dtype}")
# Array-Indizierung und Slicing
print(f"Erste Zeile: {arr)
print(f"Erste Spalte: {arr[:, 0]}")
print(f"Element [1,2]: {arr[1, 2]}")
# Array-Operationen
arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])
print(f"Addition: {arr1 + arr2}")
print(f"Multiplikation: {arr1 * arr2}")
print(f"Skalarprodukt: {np.dot(arr1, arr2)}")
# Statistische Funktionen
data = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 10])
print(f"Mittelwert: {np.mean(data)}")
print(f"Standardabweichung: {np.std(data)}")
print(f"Maximum: {np.max(data)}")
print(f"Minimum: {np.min(data)}")
print(f"Median: {np.median(data)}")
NumPy praktisches Anwendungsbeispiel
Beispiel
def numpy_linear_regression():
"""Implementiere eine einfache lineare Regression mit NumPy"""
# Beispieldaten generieren
np.random.seed(42)
X = 2 * np.random.rand(100, 1) # Merkmale
y = 4 + 3 * X + np.random.randn(100, 1) # Labels + Rauschen
# x0 = 1 zu X hinzufügen
X_b = np.c_[np.ones((100, 1)), X] # Bias-Term hinzufügen
# Löse mit der Normalengleichung: θ = (X^T * X)^(-1) * X^T * y
theta_best = np.linalg.inv(X_b.T.dot(X_b)).dot(X_b.T).dot(y)
print("=== NumPy Beispiel für lineare Regression ===")
print(f"Gelernte Parameter: Achsenabschnitt={theta_best)
# Vorhersage
X_new = np.array([[0], [2]])
X_new_b = np.c_[np.ones((2, 1)), X_new]
y_predict = X_new_b.dot(theta_best)
print(f"Vorhersageergebnisse: y={y_predict)
return theta_best, X, y
# Beispiel ausführen
theta, X, y = numpy_linear_regression()
Pandas: Das scharfe Werkzeug für die Datenverarbeitung
Was ist Pandas?
Pandas ist wie das Schweizer Taschenmesser der Datenverarbeitungund bietet leistungsstarke Datenstrukturen und Datenanalysewerkzeuge, besonders geeignet für die Verarbeitung tabellarischer Daten.
Zentrale Datenstrukturen von Pandas
1. Series (Eindimensionale Daten)
Beispiel
import pandas as pd
print("=== Pandas Series ===")
# Series aus einer Liste erstellen
s1 = pd.Series([1, 2, 3, 4, 5])
print(f"Aus Liste erstellt:\n{s1}")
# Series mit Index
s2 = pd.Series([10, 20, 30], index=['a', 'b', 'c'])
print(f"\nSeries mit Index:\n{s2}")
# Series aus einem Dictionary erstellen
s3 = pd.Series({'Mathe': 90, 'Englisch': 85, 'Physik': 88})
print(f"\nAus Dictionary erstellt:\n{s3}")
# Series-Operationen
print(f"\nZugriff auf Element: s2['b'] = {s2['b']}")
print(f"Slicing: s2[0:2] =\n{s2[0:2]}")
print(f"Statistische Informationen:\n{s2.describe()}")
2. DataFrame (zweidimensionale Daten)
Beispiel
print("\n=== Pandas DataFrame ===")
# DataFrame erstellen
data = {
'Name': ['Zhang San', 'Li Si', 'Wang Wu', 'Zhao Liu'],
'Age': [25, 30, 35, 28],
'Stadt': ['Peking', 'Shanghai', 'Guangzhou', 'Shenzhen'],
'Salary': [15000, 20000, 18000, 22000]
}
df = pd.DataFrame(data)
print("Ursprüngliches DataFrame:")
print(df)
# Grundlegende DataFrame-Operationen
print(f"\nDataFrame-Form: {df.shape}")
print(f"\nSpaltennamen: {list(df.columns)}")
print(f"\nDatentypen:\n{df.dtypes}")
# Daten auswählen
print(f"\nWählen Sie die Spalte 'Name' aus:\n{df['Name']}")
print(f"\nWählen Sie die ersten beiden Zeilen aus:\n{df.head(2)}")
print(f"\nWählen Sie Zeilen aus, in denen das Alter größer als 28 ist:\n{df[df['Age'] > 28]}")
# Statistische Informationen
print(f"\nStatistische Informationen für numerische Spalten:\n{df.describe()}")
# Eine neue Spalte hinzufügen
df['Annual Salary'] = df['Salary'] * 12
print(f"\nNach dem Hinzufügen der Spalte für das Jahresgehalt:\n{df}")
Pandas-Beispiel zur Datenverarbeitung
Beispiel
def pandas_data_processing():
"""Veranschaulicht den vollständigen Arbeitsablauf der Datenverarbeitung mit Pandas"""
print("=== Pandas-Datenverarbeitungsbeispiel ===")
# 1. Beispieldaten erstellen
np.random.seed(42)
n_samples = 1000
data = {
'Student ID': range(1, n_samples + 1),
'Name': [f'Student {i}' for i in range(1, n_samples + 1)],
'Alter': np.random.randint(18, 25, n_samples),
'Geschlecht': np.random.choice(['Männlich', 'Weiblich'], n_samples),
'Math Score': np.random.normal(75, 15, n_samples),
'English Score': np.random.normal(80, 12, n_samples),
'Physics Score': np.random.normal(72, 18, n_samples),
'Class': np.random.choice(['Class 1', 'Class 2', 'Class 3'], n_samples)
}
df = pd.DataFrame(data)
# 2. Datenbereinigung
print("Ursprüngliche Datenform:", df.shape)
# Ausreißer behandeln (Punkte sollten zwischen 0-100 liegen)
score_columns = ['Math Score', 'English Score', 'Physics Score']
for col in score_columns:
df[col] = df[col].clip(0, 100)
# 3. Feature-Engineering
# Gesamtpunktzahl und Durchschnittspunktzahl berechnen
df['Total Score'] = df[score_columns].sum(axis=1)
df['Average Score'] = df[score_columns].mean(axis=1)
# Note hinzufügen
def get_grade(score):
if score >= 90:
return 'A'
elif score >= 80:
return 'B'
elif score >= 70:
return 'C'
elif score >= 60:
return 'D'
else:
return 'F'
df['Grade'] = df['Average Score'].apply(get_grade)
# 4. Datenanalyse
print("\n=== Ergebnisse der Datenanalyse ===)
# Grundlegende Statistik
print("Durchschnittliche Punktzahlen nach Fach:")
print(df[score_columns].mean())
# Nach Klasse analysieren
print("\nDurchschnittliche Punktzahl nach Klasse:")
class_avg = df.groupby('Class')['Average Score'].mean()
print(class_avg)
# Nach Geschlecht analysieren
print("\nGeschlechterverteilung:")
gender_count = df['Gender'].value_counts()
print(gender_count)
# Notenverteilung
print("\nNotenverteilung:")
grade_dist = df['Grade'].value_counts().sort_index()
print(grade_dist)
# 5. Datenfilterung
print("\n=== Spezifische Datenfilterung ===)
# Ausgezeichnete Studierende (Durchschnittspunktzahl > 85)
excellent_students = df[df['Average Score'] > 85].head(5)
print("Ausgezeichnete Studierende (Top 5):")
print(excellent_students[['Name', 'Average Score', 'Name']])
# Schüler mit der höchsten Punktzahl in jeder Klasse
print("\nSchüler mit der höchsten Punktzahl in jeder Klasse:")
top_students = df.idxmax[df.groupby('Class')['Average Score'].idxmax()]
print(top_students[['Name', 'Name', Average Score']])
return df
# Beispiel ausführen
student_df = pandas_data_processing()
Matplotlib: Der Pinsel für die Datenvisualisierung
Was ist Matplotlib?
Matplotlib ist wie der Pinsel eines Datenkünstlers, der langweilige Daten in intuitive Diagramme verwandeln kann und uns hilft, Muster und Beziehungen in den Daten zu verstehen.
Grundlegende Diagramme in Matplotlib
Beispiel
import matplotlib.pyplot as plt
import numpy as np
# Chinesische Schriftart festlegen (verhindern, dass chinesische Zeichen als Kästchen angezeigt werden)
plt.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False
def matplotlib_basic_charts():
"""Demonstriert grundlegende Matplotlib-Diagramme"""
print("=== Matplotlib Beispiel für Basisdiagramme ===")
# 1. Liniendiagramm
plt.figure(figsize=(12, 8))
plt.subplot(2, 3, 1)
x = np.linspace(0, 10, 100)
y1 = np.sin(x)
y2 = np.cos(x)
plt.plot(x, y1, label='sin(x)')
plt.plot(x, y2, label='cos(x)')
plt.title('Trigonometrische Funktionen')
plt.xlabel('x')
plt.ylabel('y')
plt.legend()
plt.grid(True)
# 2. Streudiagramm
plt.subplot(2, 3, 2)
np.random.seed(42)
x = np.random.randn(100)
y = 2 * x + np.random.randn(100) * 0.5
plt.scatter(x, y, alpha=0.6, c='blue')
plt.title('Streudiagramm')
plt.xlabel('X')
plt.ylabel('Y')
# 3. Balkendiagramm
plt.subplot(2, 3, 3)
categories = ['A', 'B', 'C', 'D', 'E']
values = [23, 45, 56, 78, 32]
plt.bar(categories, values, color=['red', 'green', 'blue', 'orange', 'purple'])
plt.title('Balkendiagramm')
plt.xlabel('Kategorie')
plt.ylabel('Wert')
# 4. Histogramm
plt.subplot(2, 3, 4)
data = np.random.normal(100, 15, 1000)
plt.hist(data, bins=30, alpha=0.7, color='skyblue', edgecolor='black')
plt.title('Histogramm')
plt.xlabel('Wert')
plt.ylabel('Häufigkeit')
# 5. Kreisdiagramm
plt.subplot(2, 3, 5)
sizes = [30, 25, 20, 15, 10]
labels = ['A', 'B', 'C', 'D', 'E']
colors = ['gold', 'lightcoral', 'lightskyblue', 'lightgreen', 'plum']
plt.pie(sizes, labels=labels, colors=colors, autopct='%1.1f%%', startangle=90)
plt.title('Kreisdiagramm')
# 6. Boxplot
plt.subplot(2, 3, 6)
data1 = np.random.normal(0, 1, 100)
data2 = np.random.normal(2, 1, 100)
data3 = np.random.normal(-2, 1, 100)
plt.boxplot([data1, data2, data3], labels=['Gruppe 1', 'Gruppe 2', 'Gruppe 3'])
plt.title('Boxplot')
plt.ylabel('Wert')
plt.tight_layout()
plt.show()
print("Diagramm angezeigt!")
# Beispiel ausführen
matplotlib_basic_charts()
Fortgeschrittenes Visualisierungsbeispiel
Beispiel
def advanced_visualization():
"""Fortgeschrittene Visualisierungstechniken demonstrieren"""
print("=== Fortgeschrittenes Visualisierungsbeispiel ===")
# Komplexere Daten erstellen
np.random.seed(42)
n_points = 200
# Korrelierte Daten generieren
x = np.random.randn(n_points)
y = 2 * x + np.random.randn(n_points) * 0.5
colors = np.random.rand(n_points)
sizes = 1000 * np.random.rand(n_points)
# 1. Blasendiagramm
plt.figure(figsize=(15, 5))
plt.subplot(1, 3, 1)
scatter = plt.scatter(x, y, c=colors, s=sizes, alpha=0.6, cmap='viridis')
plt.colorbar(scatter, label='Farbwert')
plt.title('Blasendiagramm')
plt.xlabel('X')
plt.ylabel('Y')
# 2. Heatmap
plt.subplot(1, 3, 2)
data = np.random.randn(10, 10)
im = plt.imshow(data, cmap='coolwarm', aspect='auto')
plt.colorbar(im, label='Wert')
plt.title('Heatmap')
# 3. Subplot-Kombination
plt.subplot(1, 3, 3)
# Subplots erstellen
gs = plt.GridSpec(2, 2, subplot_kw={'projection': 'polar'})
ax1 = plt.subplot(gs[0, 0])
theta = np.linspace(0, 2*np.pi, 100)
r = np.sin(3*theta)
ax1.plot(theta, r)
ax1.set_title('Polardiagramm')
ax2 = plt.subplot(gs[0, 1])
categories = ['A', 'B', 'C', 'D']
values = [15, 30, 45, 10]
ax2.bar(categories, values)
ax2.set_title('Balkendiagramm')
ax3 = plt.subplot(gs[1, :])
x_line = np.linspace(0, 10, 100)
y_line1 = np.sin(x_line)
y_line2 = np.cos(x_line)
ax3.plot(x_line, y_line1, label='sin')
ax3.plot(x_line, y_line2, label='cos')
ax3.set_title('Kombiniertes Diagramm')
ax3.legend()
plt.tight_layout()
plt.show()
print("Erweitertes Diagramm angezeigt!")
# Beispiel ausführen
advanced_visualization()
Scikit-learn: Das Schweizer Taschenmesser des maschinellen Lernens
Was ist Scikit-learn?
Scikit-learn ist wie ein Werkzeugkasten für maschinelles Lernen, der eine vollständige Toolchain von der Datenvorverarbeitung über das Modelltraining bis zur Modellbewertung bereitstellt und der De-facto-Standard für maschinelles Lernen mit Python ist.
Kernfunktionen von Scikit-learn
Beispiel
from sklearn.datasets import make_classification, load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
def scikit_learn_basics():
"""Demonstriere die Kernfunktionalität von Scikit-learn"""
print("=== Scikit-learn Kernfunktionalitätsbeispiel ===")
# 1. Datengenerierung
X, y = make_classification(
n_samples=1000,
n_features=20,
n_classes=3,
n_informative=15,
random_state=42
)
print(f"Datenform: X={X.shape}, y={y.shape}")
print(f"Klassenverteilung: {np.bincount(y)}")
# 2. Datenaufteilung
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Größe des Trainingssets: {X_train.shape)
print(f"Größe des Testsets: {X_test.shape)
# 3. Datenvorverarbeitung
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
print("Datenstandardisierung abgeschlossen")
# 4. Modelltraining und Vergleich
models = {
'Logistische Regression': LogisticRegression(random_state=42),
'Random Forest': RandomForestClassifier(n_estimators=100, random_state=42),
'Support-Vektor-Maschine': SVC(random_state=42)
}
results = {}
for name, model in models.items():
print(f"\nTrainiere {name}...")
# Modell trainieren
model.fit(X_train_scaled, y_train)
# Vorhersagen
y_pred = model.predict(X_test_scaled)
# Auswerten
accuracy = accuracy_score(y_test, y_pred)
results[name] = accuracy
print(f"{name} Genauigkeit: {accuracy:.4f}")
print(f"Klassifikationsbericht:\n{classification_report(y_test, y_pred)}")
# 5. Ergebnisvergleich
print("\n=== Modellvergleich === ")
for name, accuracy in results.items():
print(f"{name}: {accuracy:.4f}")
best_model = max(results, key=results.get)
print(f"\nBestes Modell: {best_model}")
return models[best_model]
# Beispiel ausführen
best_model = scikit_learn_basics()
Vollständiger Machine-Learning-Workflow
Beispiel
def complete_ml_pipeline():
"""Demonstriert den vollständigen Machine-Learning-Workflow"""
print("=== Vollständiger Machine-Learning-Workflow ===")
# 1. Daten laden
iris = load_iris()
X = iris.data
y = iris.target
feature_names = iris.feature_names
target_names = iris.target_names
print(f"Datensatz: {iris.DESCR.split('\n')[0]}")
print(f"Anzahl der Merkmale: {len(feature_names)}")
print(f"Anzahl der Klassen: {len(target_names)}")
# 2. Datenexploration
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("\nDatenvorschau:")
print(df.head())
print("\nDatenstatistik:")
print(df.describe())
# 3. Datenvisualisierung
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['sepal length (cm)'],
df[df['target'] == i]['sepal width (cm)'],
label=target_name
)
plt.xlabel('Kelchblattlänge')
plt.ylabel('Kelchblattbreite')
plt.title('Verteilung der Kelchblattgröße')
plt.legend()
plt.subplot(1, 2, 2)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['petal length (cm)'],
df[df['target'] == i]['petal width (cm)'],
label=target_name
)
plt.xlabel('Blütenblattlänge')
plt.ylabel('Blütenblattbreite')
plt.title('Verteilung der Blütenblattgröße')
plt.legend()
plt.tight_layout()
plt.show()
# 4. Datenvorbereitung
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42, stratify=y
)
# 5. Modelltraining
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
# 6. Modellbewertung
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"\nModellgenauigkeit: {accuracy:.4f}")
print("\nKonfusionsmatrix:")
print(confusion_matrix(y_test, y_pred))
print("\nKlassifikationsbericht:")
print(classification_report(y_test, y_pred, target_names=target_names))
# 7. Feature-Wichtigkeit
feature_importance = model.feature_importances_
feature_df = pd.DataFrame({
'Feature': feature_names,
'Importance': feature_importance
}).sort_values('Importance', ascending=False)
print("\nFeature-Wichtigkeit:")
print(feature_df)
# 8. Visualisierung der Merkmalswichtigkeit
plt.figure(figsize=(8, 4))
plt.bar(feature_df['Feature'], feature_df['Importance'])
plt.title('Merkmalswichtigkeit')
plt.xlabel('Merkmal')
plt.ylabel('Wichtigkeit')
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
return model, feature_df
# Beispiel ausführen
trained_model, feature_importance = complete_ml_pipeline()
Beispiel für das Zusammenwirken der vier Bibliotheken
Beispiel
def four_libraries_integration():
"""Demonstriert das Zusammenspiel von NumPy, Pandas, Matplotlib und Scikit-learn"""
print("=== Beispiel für die Zusammenarbeit von vier Bibliotheken ===")
# 1. NumPy: Simulierte Daten generieren
np.random.seed(42)
n_samples = 500
# Merkmale generieren
study_hours = np.random.uniform(1, 10, n_samples) # Lernzeit
sleep_hours = np.random.uniform(5, 9, n_samples) # Schlafzeit
practice_tests = np.random.randint(0, 20, n_samples) # Anzahl der Übungsfragen
# Labels (Prüfungsergebnisse) generieren, basierend auf einer linearen Kombination von Merkmalen plus Rauschen
exam_scores = (
5 * study_hours +
3 * sleep_hours +
2 * practice_tests +
np.random.normal(0, 10, n_samples)
)
# Sicherstellen, dass die Ergebnisse im Bereich 0-100 liegen
exam_scores = np.clip(exam_scores, 0, 100)
# 2. Pandas: Ein DataFrame erstellen und Datenverarbeitung durchführen
df = pd.DataFrame({
'Lernzeit': study_hours,
'Schlafzeit': sleep_hours,
'Anzahl der Übungsfragen': practice_tests,
'Prüfungsergebnis': exam_scores
})
# Notenspalte hinzufügen
df['Note'] = pd.cut(df['Prüfungsergebnis'],
bins=[0, 60, 70, 80, 90, 100],
labels=['F', 'D', 'C', 'B', 'A'])
print("Datenvorschau:")
print(df.head())
print(f"\nDatenform: {df.shape}")
print(f"\nNotenverteilung:")
print(df['Grade'].value_counts().sort_index())
# 3. Matplotlib: Datenvisualisierung
plt.figure(figsize=(15, 10))
# Subplot 1: Merkmalsverteilung
plt.subplot(2, 3, 1)
df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']].hist(bins=20, ax=plt.gca())
plt.title('Merkmalsverteilung')
# Subplot 2: Punkteverteilung
plt.subplot(2, 3, 2)
plt.hist(df['Exam Score'], bins=20, alpha=0.7, color='skyblue')
plt.title('Prüfungsergebnisverteilung')
plt.xlabel('Punktzahl')
plt.ylabel('Häufigkeit')
# Subplot 3: Lernzeit vs. Punktzahl
plt.subplot(2, 3, 3)
plt.scatter(df['Study Time'], df['Exam Score'], Alpha=0.6)
plt.xlabel('Lernzeit')
plt.ylabel('Prüfungsergebnis')
plt.title('Zusammenhang zwischen Lernzeit und Punktzahl')
# Subplot 4: Schlafdauer vs. Punktzahl
plt.subplot(2, 3, 4)
plt.scatter(df['Sleep Duration'], df['Exam Score'], alpha=0.6, color='orange')
plt.xlabel('Schlafdauer')
plt.ylabel('Prüfungsergebnis')
plt.title('Zusammenhang zwischen Schlafdauer und Punktzahl')
# Subplot 5: Anzahl der Übungsaufgaben vs. Punktzahl
plt.subplot(2, 3, 5)
plt.scatter(df['Number of Practice Problems'], df['Exam Score'], alpha=0.6, color='green')
plt.xlabel('Anzahl der Übungsaufgaben')
plt.ylabel('Prüfungsergebnis')
plt.title('Zusammenhang zwischen Übungsaufgaben und Punktzahl')
# Unterdiagramm 6: Notenverteilung als Kreisdiagramm
plt.subplot(2, 3, 6)
grade_counts = df['Grade'].value_counts()
plt.pie(grade_counts.values, labels=grade_counts.index, autopct='%1.1f%%')
plt.title('Notenverteilung')
plt.tight_layout()
plt.show()
# 4. Scikit-learn: Modellierung mit maschinellem Lernen
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, r2_score
# Daten vorbereiten
X = df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']]
y = df['Exam Score']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
# Lineares Regressionsmodell trainieren
lr_model = LinearRegression()
lr_model.fit(X_train, y_train)
lr_pred = lr_model.predict(X_test)
lr_mse = mean_squared_error(y_test, lr_pred)
lr_r2 = r2_score(y_test, lr_pred)
# Random-Forest-Modell trainieren
rf_model = RandomForestRegressor(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)
rf_pred = rf_model.predict(X_test)
rf_mse = mean_squared_error(y_test, rf_pred)
rf_r2 = r2_score(y_test, rf_pred)
# Modellvergleich
print("\n=== Modellvergleich ===")
print(f"Lineare Regression: MSE={lr_mse:.2f}, R²={lr_r2:.4f}")
print(f"Random Forest: MSE={rf_mse:.2f}, R²={rf_r2:.4f}")
# Koeffizienten der linearen Regression
print(f"\nKoeffizienten der linearen Regression:")
for feature, coef in zip(X.columns, lr_model.coef_):
print(f"{feature}: {coef:.2f}")
# Random Forest Merkmalswichtigkeit
print(f"\nRandom Forest Merkmalswichtigkeit:")
for feature, importance in zip(X.columns, rf_model.feature_importances_):
print(f"{feature}: {importance:.4f}")
# Visualisierung der Vorhersageergebnisse
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.scatter(y_test, lr_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Tatsächlicher Wert')
plt.ylabel('Vorhergesagter Wert')
plt.title('Vorhersageergebnisse der linearen Regression')
plt.subplot(1, 2, 2)
plt.scatter(y_test, rf_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Tatsächlicher Wert')
plt.ylabel('Vorhergesagter Wert')
plt.title('Vorhersageergebnisse des Random Forest')
plt.tight_layout()
plt.show()
return {
'data': df,
'linear_model': lr_model,
'rf_model': rf_model,
'linear_metrics': {'mse': lr_mse, 'r2': lr_r2},
'rf_metrics': {'mse': rf_mse, 'r2': rf_r2}
}
# Vollständiges Beispiel ausführen
results = four_libraries_integration()