Ансамблевые методы
В машинном обучении вы, возможно, уже научились обучать решающее дерево или модель логистической регрессии. Производительность отдельной модели (которую мы называем базовым учеником) иногда может упираться в потолок.
В этот момент возникает мощная идея:ансамблевые методы, которые не полагаются на создание совершенно нового, более сложного алгоритма, а вместо этого строят более мощную, более стабильную и более точную супермодель путём умелого объединения нескольких относительно простых, даже посредственных моделей.
Проще говоря, основная философия ансамблевого обучения — это«Три сапожника, объединив умы, могут превзойти Чжугэ Ляна».。
Ансамблевые методы объединяют коллективный разум нескольких моделей, чтобы компенсировать смещение, дисперсию или случайные ошибки, которые может иметь отдельная модель, тем самым значительно улучшая общую производительность прогнозирования.
В этой статье систематически объясняются принципы, основные методы и инженерные практики ансамблевых методов.
Основные идеи и преимущества ансамблевого обучения
Прежде чем перейти к конкретным методам, сначала нужно понять, почему ансамблевое обучение работает и какие преимущества оно может принести.
Ключевая идея: снижение ошибки
Ошибку предсказания модели обычно можно разложить на три части:Смещение、ДисперсияиНеустранимая ошибка。
- Смещение: Систематическая ошибка, вызванная неверными предположениями о природе задачи. Высокое смещение означает, что модельнедообучаетсяи не может уловить базовые зависимости в данных.
- Дисперсия: Чувствительность модели к небольшим колебаниям в обучающих данных. Высокая дисперсия означает, что модельпереобучаетсяи уделяет слишком много внимания шуму в обучающих данных.
- Неустранимая ошибка: Внутренний случайный шум в данных, который не может быть устранён никакой моделью.
Основная цель ансамблевых методов — объединить несколько моделей, чтобыуменьшить дисперсию или смещение общей модели, тем самым получая более устойчивые (стабильные) и более точные предсказания.
Основные преимущества
- Повышение точности: Это самая прямая цель; ансамблевые модели превосходят лучшего одиночного базового алгоритма в подавляющем большинстве сценариев.
- Повышение стабильности и устойчивости: Благодаря усреднению или голосованию ансамблевые модели менее чувствительны к зашумлённым данным и выбросам, что снижает риск переобучения.
- Расширение пространства гипотез: Объединение нескольких моделей эквивалентно исследованию более широкого пространства решений, что повышает вероятность приблизиться к оптимальному решению задачи.
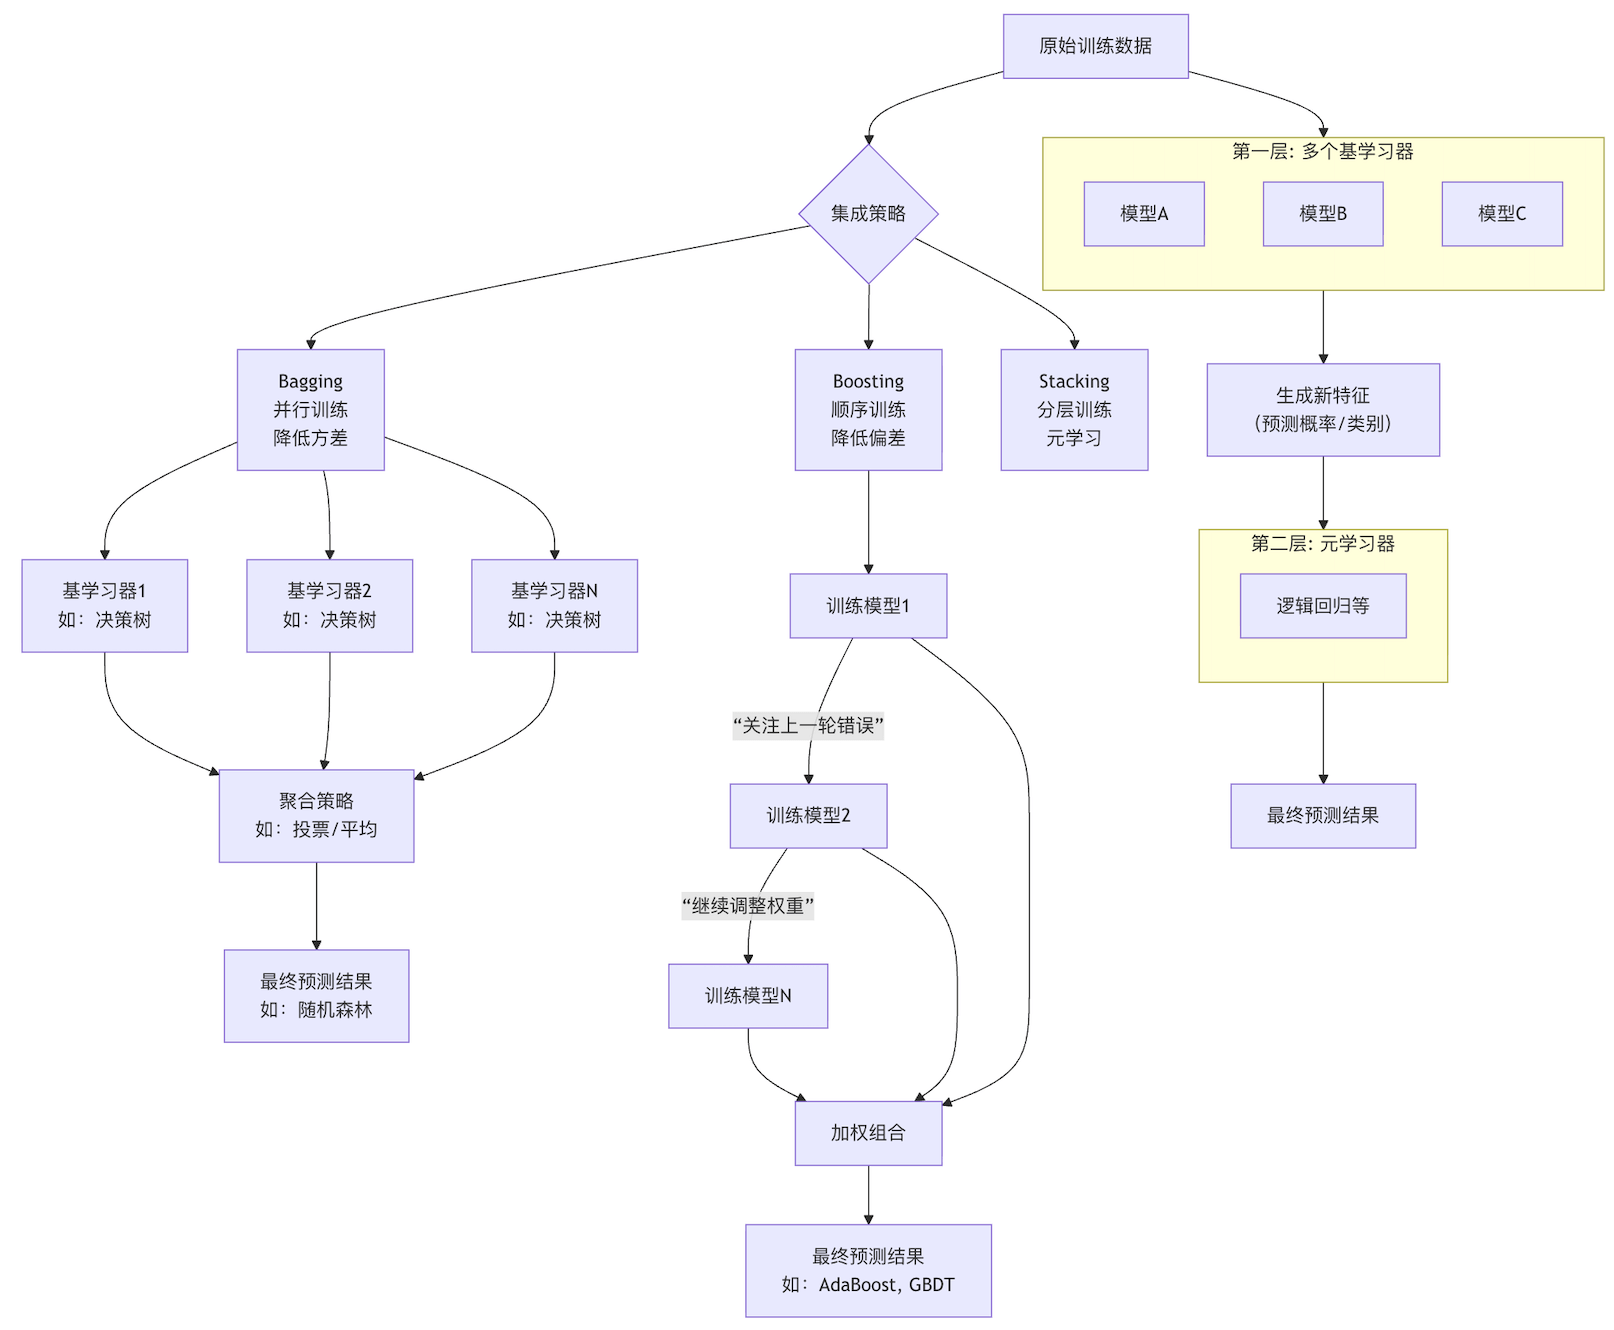
Чтобы более наглядно понять, как ансамблевые методы работают, объединяя несколько моделей, можно взглянуть на следующую блок-схему:
Подробное объяснение основных ансамблевых методов
По способу генерации и стратегии объединения базовых алгоритмов ансамблевые методы в основном делятся на три категории:Бэггинг,、БустингиСтекинг。
Бэггинг: путь параллелизма, стабильность прежде всего
БэггингОсновная идея —бутстрэп-агрегирование。
- Бутстрэп: Из исходной обучающей выборки выполнитьвыборку с возвращением(случайную выборку), чтобы сгенерировать несколько различных обучающих подмножеств. Размер каждого подмножества может совпадать с исходным множеством, но из-за выборки с возвращением некоторые примеры будут выбраны повторно, а другие не будут выбраны вовсе.
- Параллельное обучение: Используйте один и тот же алгоритм обучения (обычно модель с высокой дисперсией и низким смещением, например необрезанное решающее дерево), чтобы независимо обучить базовый алгоритм на каждом подмножестве.
- Агрегация: Для задач классификации используйтеголосование(правило большинства) для определения итогового класса; для задач регрессии используйтеусреднениедля вычисления итогового значения.
Репрезентативный алгоритм: случайный лесСлучайный лес — выдающийся представитель идеи бэггинга. Он идёт на шаг дальше на основе бэггинга: когда каждое решающее дерево выполняет разбиение узла, оно не только случайно выбирает примеры, но такжеслучайно выбирает подмножество признаковдля выполнения оптимального разбиения. Эта «двойная случайность» ещё больше повышает разнообразие модели и её устойчивость к переобучению.
Пример
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Загрузить данные
iris = load_iris()
X, y = iris.data, iris.target
# Разделить обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создание классификатора случайного леса
# n_estimators: количество деревьев в лесу, количество базовых алгоритмов
# max_depth: максимальная глубина дерева, управляет сложностью модели
# random_state: случайное начальное значение, обеспечивает воспроизводимые результаты
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Обучаем модель
rf_clf.fit(X_train, y_train)
# Прогнозирование и оценка
y_pred = rf_clf.predict(X_test)
print(f"Точность случайного леса: {accuracy_score(y_test, y_pred):.4f}")
# Просмотр глубины одного дерева (пример)
print(f"Глубина первого дерева: {rf_clf.estimators_)
Бустинг: мудрость последовательного обучения, акцент на исправлении ошибок
БустингОн использует совершенно другую стратегию.
- Последовательное обучение: базовые моделиобучаются последовательно, а не параллельно.
- Сосредоточение на ошибках: Каждая последующая модель уделяет больше внимания примерам, которые предыдущие моделипредсказали неверно.Обычно это достигается путём настройки весов обучающих примеров (присвоения более высоких весов неверно классифицированным примерам).
- Взвешенная комбинация: Объедините все базовые модели с помощьювзвешенного суммирования, чтобы получить итоговую модель; базовые модели, показывающие хорошие результаты, имеют более высокие веса.
Суть бустинга — непрерывно исправлять ошибки предшественников, превращая группу «слабых моделей» (лишь немного лучше случайного угадывания) в мощную «сильную модель».
Типичные алгоритмы: AdaBoost и Gradient Boosting Decision Tree
- AdaBoost: Один из самых ранних алгоритмов бустинга. Он увеличивает веса неверно классифицированных примеров, заставляя последующие модели сосредоточиться на этих «сложных» примерах.
- Gradient Boosting Decision Tree (GBDT): Один из самых популярных и мощных алгоритмов бустинга. Он больше не настраивает веса примеров, а вместо этого рассматривает процесс обучения как процесс оптимизации, а именноградиентный спуск. Цель каждого нового дерева — подогнатьостатки(отрицательный градиент) между предсказаниями текущей модели и истинными метками.
Пример
from sklearn.ensemble import GradientBoostingClassifier
# Создание классификатора градиентного бустинга
# n_estimators: количество этапов бустинга (количество деревьев)
# learning_rate: скорость обучения; управляет вкладом каждого дерева в итоговый результат (коэффициент сжатия)
# max_depth: максимальная глубина каждого регрессионного дерева, обычно небольшая (3-5), представляющая слабые модели
gb_clf = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, max_depth=3, random_state=42)
# Обучаем модель
gb_clf.fit(X_train, y_train)
# Прогнозирование и оценка
y_pred_gb = gb_clf.predict(X_test)
print(f"Точность градиентного бустинга: {accuracy_score(y_test, y_pred_gb):.4f}")
# Просмотр важности признаков (ансамблевые методы обычно предоставляют это)
print("Важность признаков:", gb_clf.feature_importances_)
Вывод:
随机森林准确率: 1.0000
第一棵树的深度: 4
Стекинг: стекинг моделей, стратегия метаобучения
СтекингЭто более продвинутая ансамблевая техника, которая вводит понятие "мета-учащегося".
- Первый слой: разнообразные базовые модели. Используйтеразличныеалгоритмы обучения (такие как KNN, SVM, деревья решений) для обучения нескольких моделей на исходных данных.
- Создание новых признаков: Используйте эти модели первого слоя, чтобы предсказать обучающие данные (обычно с использованием кросс-валидации, чтобы избежать утечки данных), и используйте их результаты предсказаний (метки классов или вероятности) какновые признаки。
- Второй слой: Обучение мета-учащегося. Используя эти новые признаки в качестве входных данных, а исходные метки — в качестве выходных, обучите итоговую модель (например, логистическую регрессию или линейную регрессию). Этот мета-учащийся отвечает за изучение того, как наилучшим образом объединить выходы моделей первого слоя.
У стекинга большой потенциал, но он вычислительно затратен и требует тщательного проектирования, чтобы предотвратить переобучение.
Сравнение методов и рекомендации по инженерной практике
После понимания принципов, как выбирать и применять эти методы в реальных проектах?
Сравнение трех методов
| Характеристика | Бэггинг (например, случайный лес) | Бустинг (например, GBDT, XGBoost) | Стекинг |
|---|---|---|---|
| Основная цель | Снизить дисперсию, предотвратить переобучение | Снизить смещение, повысить предсказательную способность | Оптимизировать стратегию комбинирования |
| Метод обучения | Параллельное, независимое обучение | Последовательное, зависит от результатов предыдущего раунда | Многоуровневое, сначала базовые модели, затем мета-модель |
| Веса примеров | Обрабатываются одинаково, бутстрап-выборка | Динамически корректируются, фокус на ошибках | Обычно равны |
| Взаимосвязь базовых моделей | Взаимно независимы, разнообразие обеспечивается возмущением данных | Взаимно зависимы, совместно оптимизируют целевую функцию | Взаимно независимы, разнообразие возникает из различий алгоритмов |
| Преимущества | Стабильный, устойчивый к переобучению, легко распараллеливается | Точность предсказания обычно очень высока | Теоретически может достичь наилучшей производительности |
| Недостатки | Ограниченное снижение смещения, высокое потребление вычислительных ресурсов | Чувствительность к шуму, склонность к переобучению, сложная настройка | Чрезвычайно высокая вычислительная стоимость, сложная структура, склонность к переобучению |
| Типичные области применения | Random Forest, Extra-Trees | AdaBoost, GBDT, XGBoost, LightGBM, CatBoost | Часто используется в соревнованиях по машинному обучению |
Руководство по инженерной практике
Предпочтительная базовая модель: Не используйте сложные ансамблевые методы с самого начала. Сначала используйте простую модель (например, логистическую регрессию, одно решающее дерево), чтобы установить базовый уровень производительности.
Выбирайте в зависимости от задачи:
- Если ваша базовая модель (например, очень глубокое решающее дерево)сильно переобучается (высокая дисперсия), в первую очередь попробуйтеBagging(Random Forest).
- Если ваша базовая модельнедообучается (высокое смещение), или вы стремитесь к чрезвычайно высокой точности прогнозирования, в первую очередь попробуйтебустинг(например, XGBoost, LightGBM).
- Всоревнованиях по машинному обучениюили сценариях с экстремальными требованиями к точности и достаточными вычислительными ресурсами можно рассмотретьстекингилиблендинг。
Используйте современные оптимизированные библиотеки: На практике напрямую используйте высокооптимизированные библиотеки, реализующие передовые алгоритмы ансамблирования:
- Scikit-learn: предоставляет
RandomForest,GradientBoostingи другие превосходные реализации, подходящие для начинающих и быстрого прототипирования. - XGBoost: Быстрый, высокая точность, полнофункциональный, частый победитель в соревнованиях Kaggle.
- LightGBM: Выпущен Microsoft, более высокая скорость обучения, меньшее потребление памяти, особенно подходит для больших наборов данных.
- CatBoost: Выпущен Yandex, хорошо обрабатывает категориальные признаки и хорошо работает с параметрами по умолчанию.
Обратите внимание на настройку: У ансамблевых моделей много гиперпараметров. К ключевым параметрам, на которые стоит обратить внимание, относятся:
n_estimators: Количество базовых обучающих алгоритмов (чем больше, тем лучше, но вычислительные затраты растут).learning_rate(бустинг): Скорость обучения контролирует вклад каждого шага. Обычно её нужноn_estimatorsсбалансировать (малая скорость обучения требует больше деревьев).max_depth(Метод дерева): ключ к управлению сложностью модели и переобучением.- Используйтекросс-валидациюипоиск по сетке/случайный поискдля систематической настройки параметров.