Overfitting, Underfitting, Bias und Varianz
In der Welt des maschinellen Lernens ist das Erstellen eines Modells wie das Trainieren eines Schülers. Unser Ziel ist, dass dieserSchülernicht nur die Beispielaufgaben im Lehrbuch (Trainingsdaten) auswendig lernen, sondern auch die zugrunde liegenden Prinzipien tiefgehend verstehen kann, um bei völlig unbekannten Prüfungsfragen (Testdaten) gute Ergebnisse zu erzielen. Doch dieserSchülerkann im Lernprozess auf zwei typische Probleme stoßen:
- Das eine ist zu starres Lernen, bei dem die Beispiele nur mechanisch angewendet werden (Underfitting);
- Das andere ist zu kluges Lernen, bei dem sogar die Satzzeichen und Handschriftmerkmale der Beispiele auswendig gelernt werden, sodass sie bei neuen Fragen ratlos sind (Overfitting)。
Das Verständnis vonOverfittingundUnderfittingsowie der tieferen theoretischen Konzepte dahinter—BiasundVarianz, ist ein entscheidender Schritt für jeden Praktiker des maschinellen Lernens vom Anfänger bis zur Meisterschaft. Sie erklären, warum Modelle Fehler machen, und zeigen uns die Richtung für die Modellverbesserung.
I. Kernkonzepte: Modellleistung und der "Fitting"-Zustand
Verwenden wir zunächst ein intuitives Beispiel, um zu verstehen, wasFittingist. Angenommen, wir möchten ein mathematisches Modell verwenden, um eine Menge verstreuter Datenpunkte anzupassen.
Beispiel
import matplotlib.pyplot as plt
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Behebe das Problem, dass negative Vorzeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# Simulierte Daten generieren: etwas zufälliges Rauschen basierend auf einer Sinuskurve hinzufügen
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Das tatsächliche zugrunde liegende Muster (das wir nicht kennen)
y_noise = np.random.randn(20) * 0.3 # Zufälliges Rauschen
y = y_true + y_noise # Die Daten, die wir tatsächlich beobachten
plt.scatter(X, y, label='Beobachtete Daten (mit Rauschen)', color='blue', alpha=0.6)
plt.plot(X, y_true, label='Wahres Muster (y=sin(x))', color='green', linewidth=2)
plt.xlabel('X')
plt.ylabel('y')
plt.title('Daten und zugrunde liegendes Muster')
plt.legend()
plt.grid(True)
plt.show()
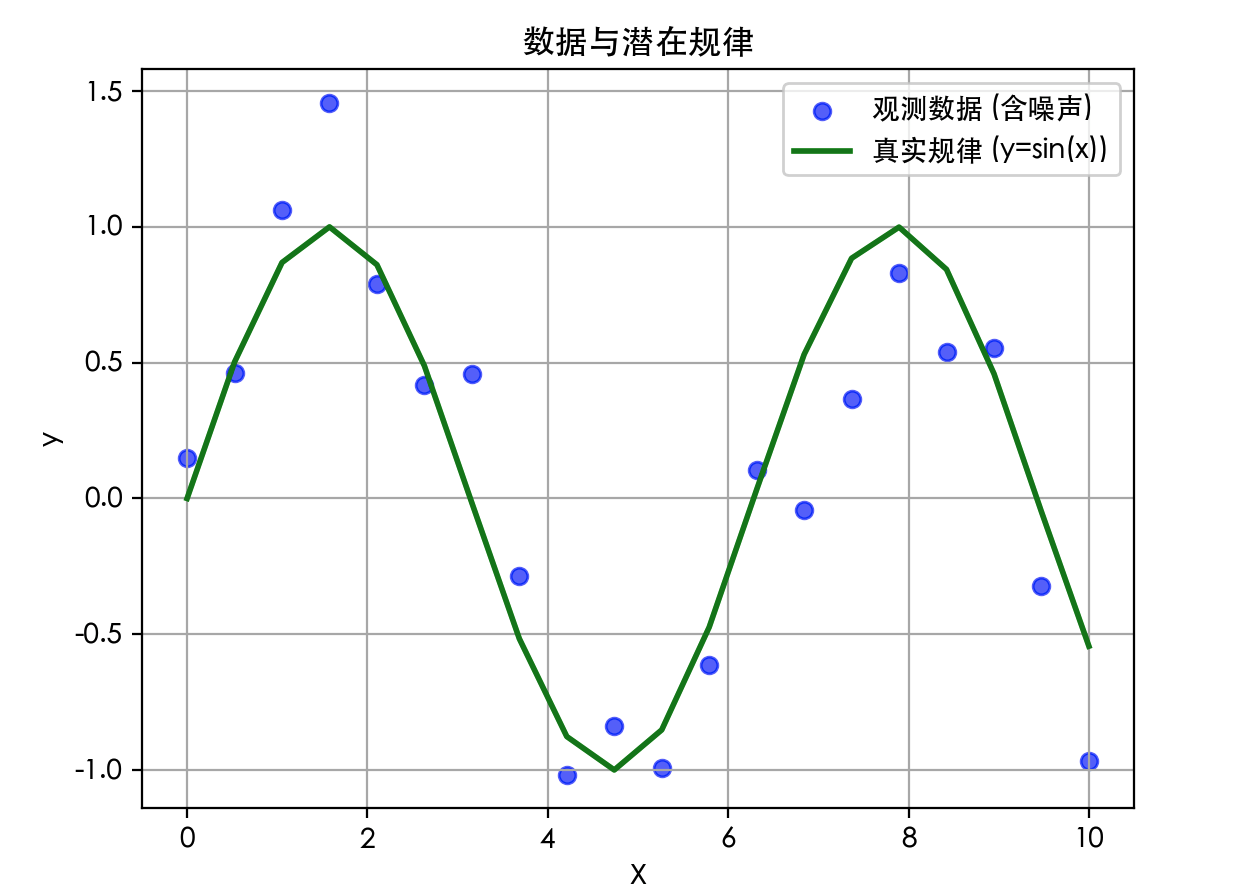
Unser Ziel ist es, eine Kurve (ein Modell) zu finden, die das Muster am besten beschreibt, das diese blauen verstreuten Punkte (Daten) widerspiegeln.
Das Ausmaß, in dem das Modell die Daten beschreibt, istdie Anpassung。
1. Unteranpassung
Unteranpassungbezieht sich auf ein Modell, das zu einfach ist, um die grundlegenden Muster oder Strukturen in den Daten zu erfassen. Es ist wie ein Schüler, der nur Addition gelernt hat, aber Analysis-Aufgaben lösen soll.
- Verhalten: Das Modell schneidet beiTrainingsdatensehr schlecht ab (z. B. niedrige Genauigkeit, hoher Fehler).
- Ursachen: Die Modellkomplexität ist zu gering, die Merkmale sind unzureichend oder das Training ist unangemessen.
- Analogie: Verwendung einer Geraden (Polynom ersten Grades), um Daten mit einem offensichtlich gekrümmten Trend anzupassen.
Beispiel
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# Versuche, mit einem Polynom 1. Grades (einer Geraden) anzupassen
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Mittlerer quadratischer Fehler (MSE) des Modells mit Unteranpassung auf dem Trainingssatz: {mse_train_under:.4f}")
Ausgabe:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
2. Genau richtige Anpassung
Dies ist der ideale Zustand. Das Modell ist komplex genug, um die wichtigsten Muster in den Daten zu lernen, aber nicht so komplex, dass es zufälliges Rauschen lernt. Es funktioniert gut sowohl auf dem Trainingssatz als auch auf ungesehenen Testsätzen.
- Verhalten: Die Fehler sowohl auf dem Trainingssatz als auch auf dem Testsatz sind niedrig, und die beiden liegen nahe beieinander.
- Analogie: Verwendung eines Polynoms geeigneten Grades (z. B. 3. Grades), um die Daten anzupassen.
Beispiel
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Mittlerer quadratischer Fehler (MSE) des gut angepassten Modells auf dem Trainingssatz: {mse_train_good:.4f}")
Ausgabe:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
良好拟合模型在训练集上的均方误差 (MSE): 0.3988
3. Overfitting
Overfittingbezieht sich auf ein Modell, das zu komplex ist und nicht nur die wahren Muster in den Daten lernt, sondern auch das zufällige Rauschen und die Ausreißer in den Trainingsdaten "auswendig lernt".
- Verhalten: Das Modell schneidet aufTrainingsdaten(mit sehr kleinem Fehler) äußerst gut ab, aber aufneuen, ungesehenen Datenfällt seine Leistung stark ab, was auf eine schlechte Generalisierungsfähigkeit hindeutet.
- Ursachen: Die Modellkomplexität ist zu hoch und die Menge an Trainingsdaten ist zu gering.
- Analogie: Verwende ein Polynom sehr hohen Grades (z. B. 15. Grades), um die Daten anzupassen, wodurch die Kurve fast jeden Datenpunkt durchläuft und extrem verzerrt wird.
Beispiel
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Behebe das Problem, dass negative Vorzeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# Simulierte Daten generieren: etwas zufälliges Rauschen basierend auf einer Sinuskurve hinzufügen
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Das tatsächliche zugrunde liegende Muster (das wir nicht kennen)
y_noise = np.random.randn(20) * 0.3 # Zufälliges Rauschen
y = y_true + y_noise # Die Daten, die wir tatsächlich beobachten
# Versuche, mit einem Polynom 1. Grades (einer Geraden) anzupassen
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Mittlerer quadratischer Fehler (MSE) des Modells mit Unteranpassung auf dem Trainingssatz: {mse_train_under:.4f}")
# Anpassung mit einem Polynom 3. Grades versuchen
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Mittlerer quadratischer Fehler (MSE) des gut angepassten Modells auf dem Trainingssatz: {mse_train_good:.4f}")
# Versuche, mit einem Polynom 15. Grades anzupassen (extrem anfällig für Overfitting)
poly = PolynomialFeatures(degree=15)
X_poly15 = poly.fit_transform(X.reshape(-1, 1))
model_over = LinearRegression()
model_over.fit(X_poly15, y)
y_pred_over = model_over.predict(X_poly15)
mse_train_over = mean_squared_error(y, y_pred_over)
print(f"Mittlerer quadratischer Fehler (MSE) des Overfitting-Modells auf dem Trainingssatz: {mse_train_over:.4f}")
# Visualisiere die drei Anpassungszustände
plt.figure(figsize=(15, 4))
# Underfitting
plt.subplot(1, 3, 1)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_under, color='red', linewidth=2, label='Underfitting (1. Grades)')
plt.plot(X, y_true, color='green', linestyle='--', label='Wahres Muster')
plt.title(f'Underfitting\nTrainings-MSE: {mse_train_under:.4f}')
plt.legend()
plt.grid(True)
# Gute Anpassung
plt.subplot(1, 3, 2)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_good, color='red', linewidth=2, label='Gute Anpassung (3. Grades)')
plt.plot(X, y_true, color='green', linestyle='--', label='Wahres Muster')
plt.title(f'Gute Anpassung\nTrainings-MSE: {mse_train_good:.4f}')
plt.legend()
plt.grid(True)
# Überanpassung
plt.subplot(1, 3, 3)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_over, color='red', linewidth=2, label='Überanpassung (15. Grades)')
plt.plot(X, y_true, color='green', linestyle='--', label='Wahres Muster')
plt.title(f'Überanpassung\nTrainings-MSE: {mse_train_over:.4f}')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
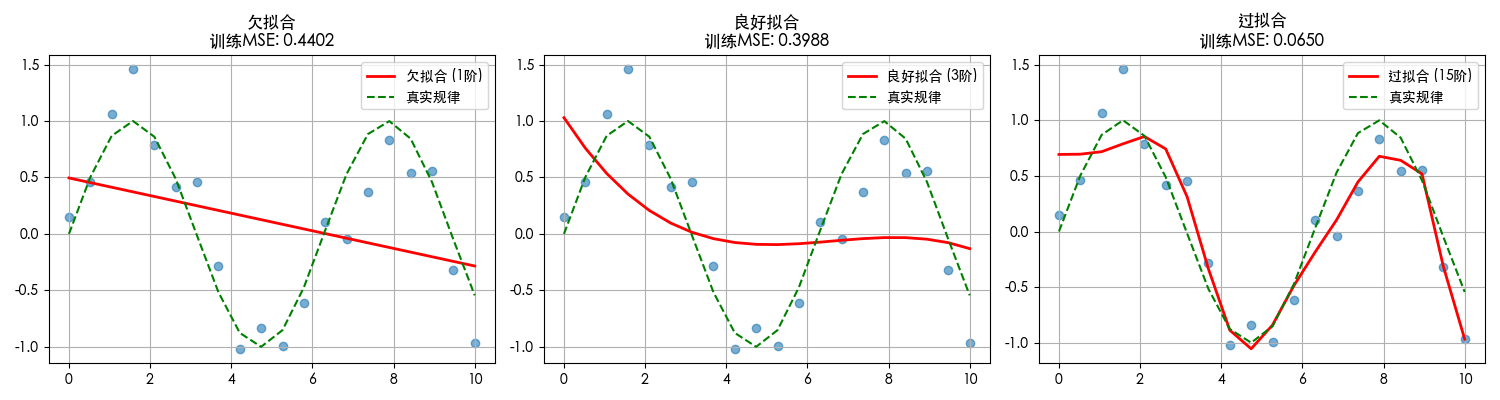
Aus der Abbildung ist deutlich zu erkennen:
- Unteranpassung (links):Die rote Gerade kann den schwankenden Trend der Daten überhaupt nicht erfassen.
- Gute Anpassung (Mitte):Die rote Kurve folgt ungefähr dem Trend des grünen wahren Musters.
- Überanpassung (rechts):Die rote Kurve schwankt heftig und versucht, durch jeden blauen Streupunkt zu verlaufen, einschließlich der Rauschpunkte, und verliert dabei völlig die glatte Form der Sinuskurve.
II. Theoretische Grundlagen: Bias-Varianz-Zerlegung
Bias und Varianz bieten einen theoretischen Rahmen zum Verständnis von Überanpassung und Unteranpassung. Sie beschreiben zwei unterschiedliche Quellen des Modellfehlers.
Wir können denGesamtfehler des Modellszerlegen in:Bias² + Varianz + irreduzibler Fehler。
1. Bias
- Definition: Die Differenz zwischen demErwartungswert(d. h. dem durchschnittlich vorhergesagten Wert) und dem wahren Wert. Sie spiegelt den inhärentensystematischen Fehlerdes Modells wider, das heißt, ob die Annahmen des Modells über die Art des Problems falsch sind.
- Verhalten bei hohem Bias: Das Modell ist zu einfach, um die Eigenschaften der Daten zu erfassen, was zuUnderfittingführt. Unabhängig davon, welche Daten zum Training verwendet werden, weichen die Ergebnisse von den wahren Werten ab.
- Beispiel: Immer das einfache lineare Modell "Hauspreis = Fläche × 1000" zu verwenden, um alle Arten von Häusern vorherzusagen und dabei wichtige Faktoren wie Lage und Stockwerk zu ignorieren, ist hoher Bias.
2. Varianz
- Definition: DieSchwankungsbreiteder Vorhersagen des Modells selbst. Sie spiegelt die Empfindlichkeit des Modells gegenüberzufälligem Rauschenin den Trainingsdaten wider.
- Symptome hoher Varianz: Das Modell ist zu komplex und reagiert überempfindlich auf kleine Änderungen (einschließlich Rauschen) in den Trainingsdaten, was zuOverfittingführt. Training mit einem anderen Datensatz kann ein völlig anderes Modell erzeugen.
- Beispiel: Ein tiefes neuronales Netz kann, wenn es in keiner Weise eingeschränkt wird, für jeden einzelnen Trainingsdatensatz einen völlig anderen, extrem komplexen Satz von Vorhersageregeln erzeugen; das ist hohe Varianz.
3. Bias-Varianz-Tradeoff
Dies ist ein zentraler Tradeoff im maschinellen Lernen.Wir können nicht Bias und Varianz gleichzeitig minimieren.
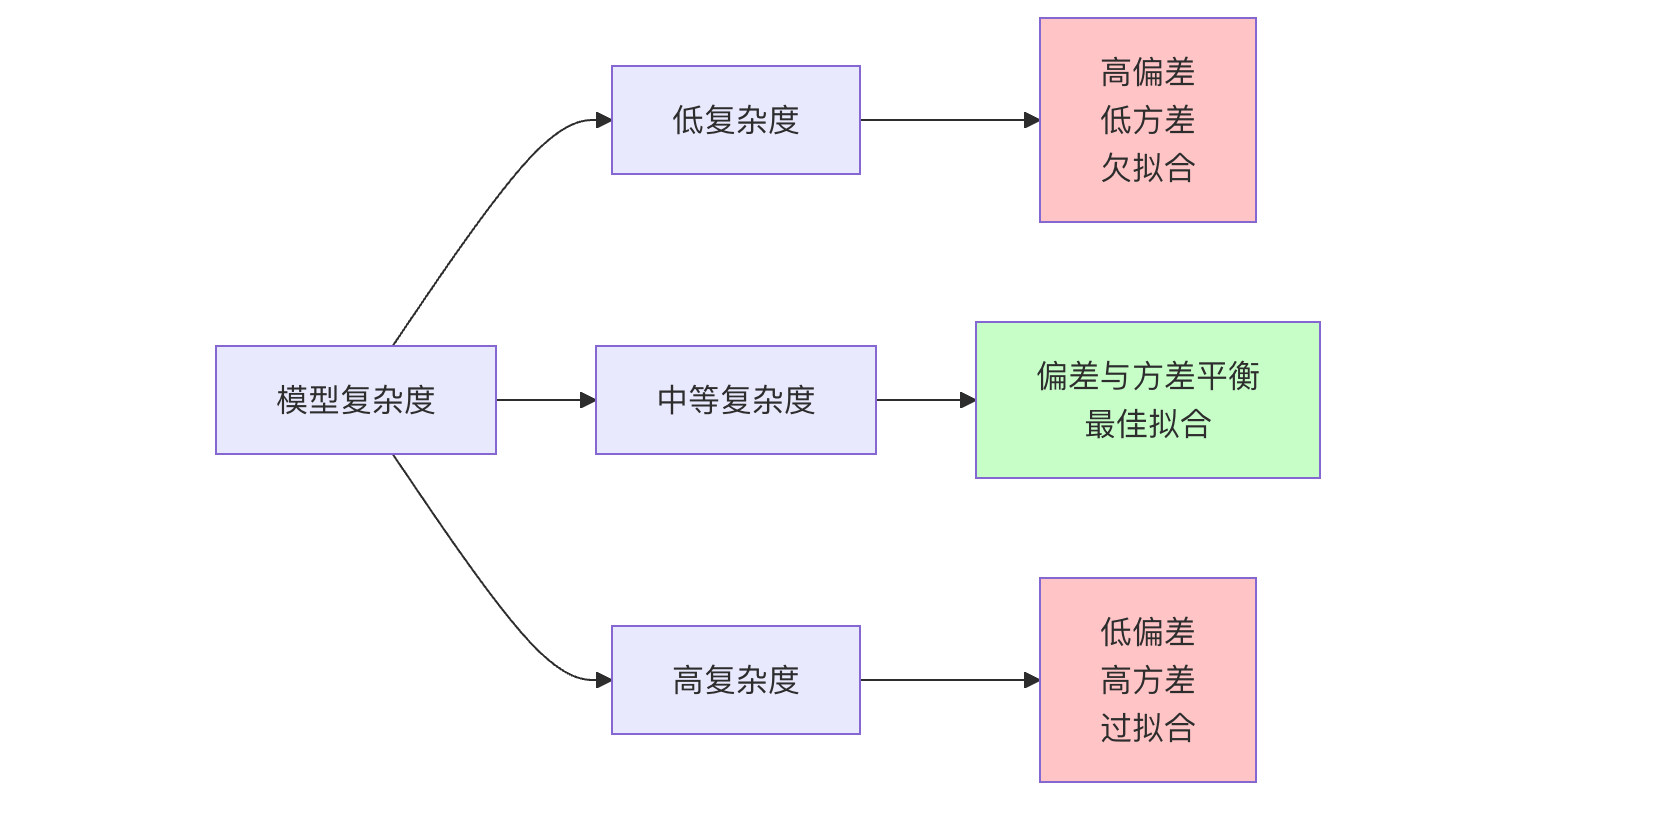
- Modellkomplexität erhöhen: Reduziert normalerweise denBias(das Modell wird leistungsfähiger), erhöht aber dieVarianz(es lernt leichter Rauschen).
- Modellkomplexität reduzieren: Reduziert normalerweise dieVarianz(das Modell wird stabiler), erhöht aber denBias(das Modell wird schwächer).
Unser Ziel ist es, den "Sweet Spot" in der Abbildung zu finden, sodass der Gesamtfehler minimiert wird.
III. Diagnose und Gegenmaßnahmen
Wie können wir feststellen, in welchem Zustand sich das Modell befindet? Wie lösen wir das?
1. Diagnosemethode: Lernkurven
Eine Lernkurve stellt die Leistung des Modells (z. B. Fehler) auf demTrainingssetundValidierungssetals Funktion vonder Anzahl der Trainingsbeispiele daroderModellkomplexität.
Beispiel
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.metrics import mean_squared_error
import warnings
warnings.filterwarnings('ignore')
# -------------------------- Chinesische Schriftart konfigurieren Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, dass negative Vorzeichen als Blöcke angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# Diagrammstil festlegen
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['axes.grid'] = True
plt.rcParams['grid.alpha'] = 0.3
# -------------------------- Ende der Konfiguration der chinesischen Schriftart --------------------------
# Daten laden
data = load_diabetes()
X, y = data.data, data.target
# Nur ein Merkmal verwenden (besser für die Demonstration der polynomialen Regression)
X = X[:, np.newaxis, 2] # Drittes Merkmal auswählen (BMI)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Funktion zum Plotten der Lernkurve definieren (optimierte Version)
def plot_learning_curve(estimator, title, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10)):
"""
Lernkurve plotten
Parameter:
estimator: Modellschätzer
title: Diagrammtitel
X: Merkmalsdaten
y: Zielvariable
cv: Anzahl der Kreuzvalidierungs-Faltungen
train_sizes: Anteile der Trainingsstichproben
"""
# Lernkurvendaten abrufen
train_sizes_abs, train_scores, test_scores = learning_curve(
estimator, X, y, cv=cv, scoring='neg_mean_squared_error',
train_sizes=train_sizes, random_state=42, n_jobs=-1
)
# Mittelwert und Standardabweichung berechnen
train_scores_mean = -train_scores.mean(axis=1)
train_scores_std = train_scores.std(axis=1)
test_scores_mean = -test_scores.mean(axis=1)
test_scores_std = test_scores.std(axis=1)
# Lernkurven darstellen
plt.figure(figsize=(10, 6))
plt.fill_between(train_sizes_abs,
train_scores_mean - train_scores_std,
train_scores_mean + train_scores_std,
alpha=0.1, color='r')
plt.fill_between(train_sizes_abs,
test_scores_mean - test_scores_std,
test_scores_mean + test_scores_std,
alpha=0.1, color='g')
# Mittlere Kurven zeichnen
plt.plot(train_sizes_abs, train_scores_mean, 'o-', color='r', linewidth=2,
markersize=8, label='MSE Trainingsset')
plt.plot(train_sizes_abs, test_scores_mean, 'o-', color='g', linewidth=2,
markersize=8, label='MSE Validierungsset')
# Diagrammeigenschaften festlegen
plt.xlabel('Anzahl der Trainingsbeispiele', fontsize=12)
plt.ylabel('Mittlerer quadratischer Fehler (MSE)', fontsize=12)
plt.title(title, fontsize=14, pad=20)
plt.legend(loc='upper right', fontsize=11)
plt.tight_layout()
plt.show()
# Gib die Leistung des Modells auf dem Testsatz aus
estimator.fit(X_train, y_train)
y_pred = estimator.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f"{title} - MSE des Testsets: {mse:.2f}")
# 1. Underfitting-Modell (Polynom 1. Ordnung - lineare Regression)
print("="*60)
print("Underfitting-Modell (Polynom 1. Ordnung - lineare Regression)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(1), LinearRegression()),
'Lernkurve des Underfitting-Modells (Polynom 1. Ordnung)',
X, y
)
# 2. Modell mit guter Anpassung (Polynom 2. Ordnung)
print("\n" + "="*60)
print("Modell mit guter Anpassung (Polynom 2. Ordnung)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(2), LinearRegression()),
'Lernkurve des Modells mit guter Anpassung (Polynom 2. Ordnung)',
X, y
)
# 3. Overfitting-Modell (Polynom 8. Ordnung)
print("\n" + "="*60)
print("Overfitting-Modell (Polynom 8. Ordnung)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(8), LinearRegression()),
'Lernkurve des Overfitting-Modells (Polynom 8. Ordnung)',
X, y
)
# Extra: Anpassungseffekte von Modellen mit unterschiedlichen Ordnungen visualisieren
plt.figure(figsize=(12, 8))
X_plot = np.linspace(X.min(), X.max(), 100).reshape(-1, 1)
# Ursprüngliche Datenpunkte plotten
plt.scatter(X_train, y_train, alpha=0.5, label='Trainingsdaten', color='blue', s=30)
plt.scatter(X_test, y_test, alpha=0.5, label='Testdaten', color='orange', s=30)
# Anpassungskurven für verschiedene Ordnungen plotten
orders = [1, 2, 8]
colors = ['red', 'green', 'purple']
labels = ['1. Ordnung (Unteranpassung)', '2. Ordnung (gute Anpassung)', '8. Ordnung (Überanpassung)']
for i, order in enumerate(orders):
model = make_pipeline(StandardScaler(), PolynomialFeatures(order), LinearRegression())
model.fit(X_train, y_train)
y_plot = model.predict(X_plot)
plt.plot(X_plot, y_plot, color=colors[i], linewidth=2, label=labels[i])
plt.xlabel('BMI-Merkmal (standardisiert)', fontsize=12)
plt.ylabel('Diabetes-Progressionsindex', fontsize=12)
plt.title('Vergleich der Anpassungseffekte polynomialer Regression mit unterschiedlichen Ordnungen', fontsize=14, pad=20)
plt.legend(fontsize=11)
plt.tight_layout()
plt.show()
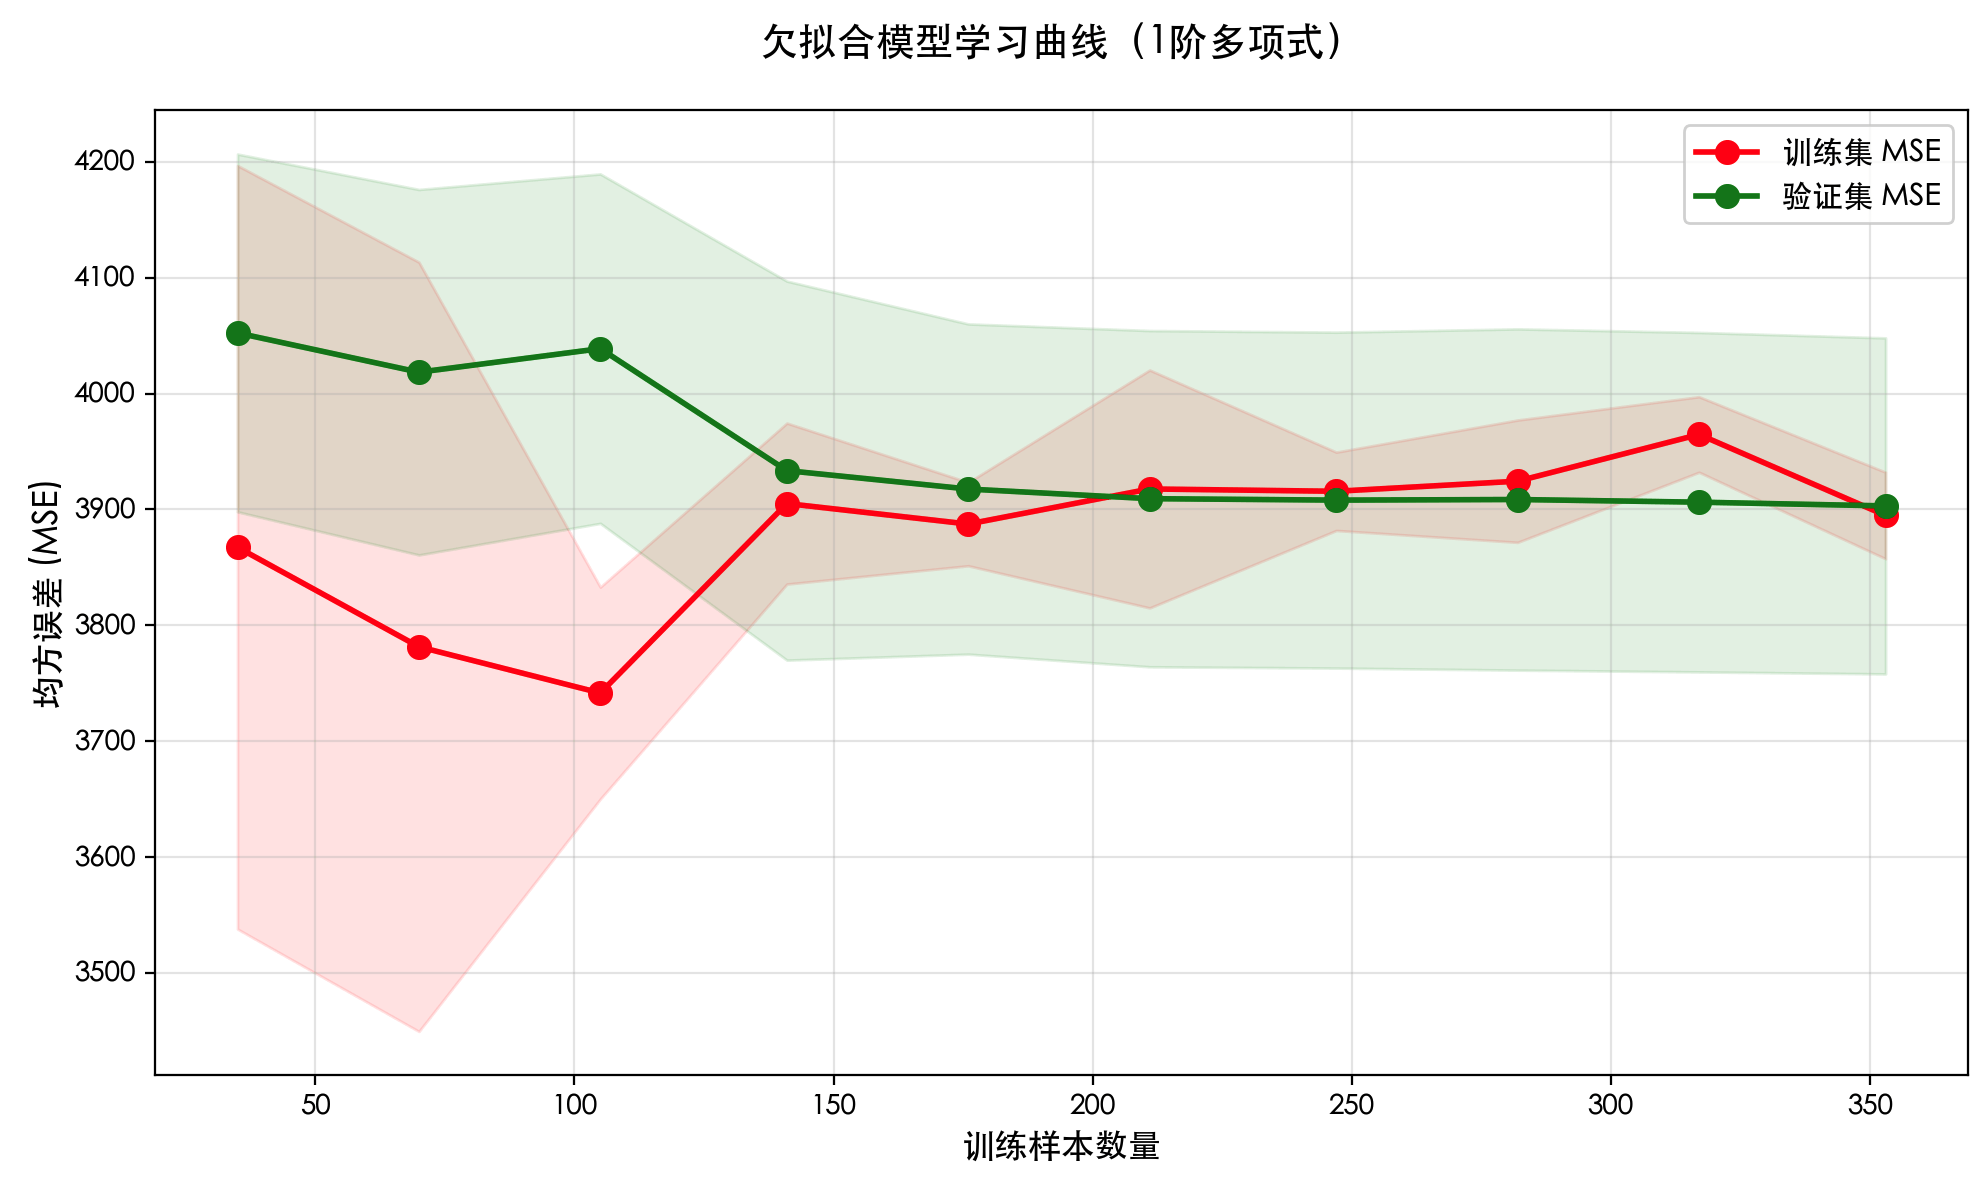
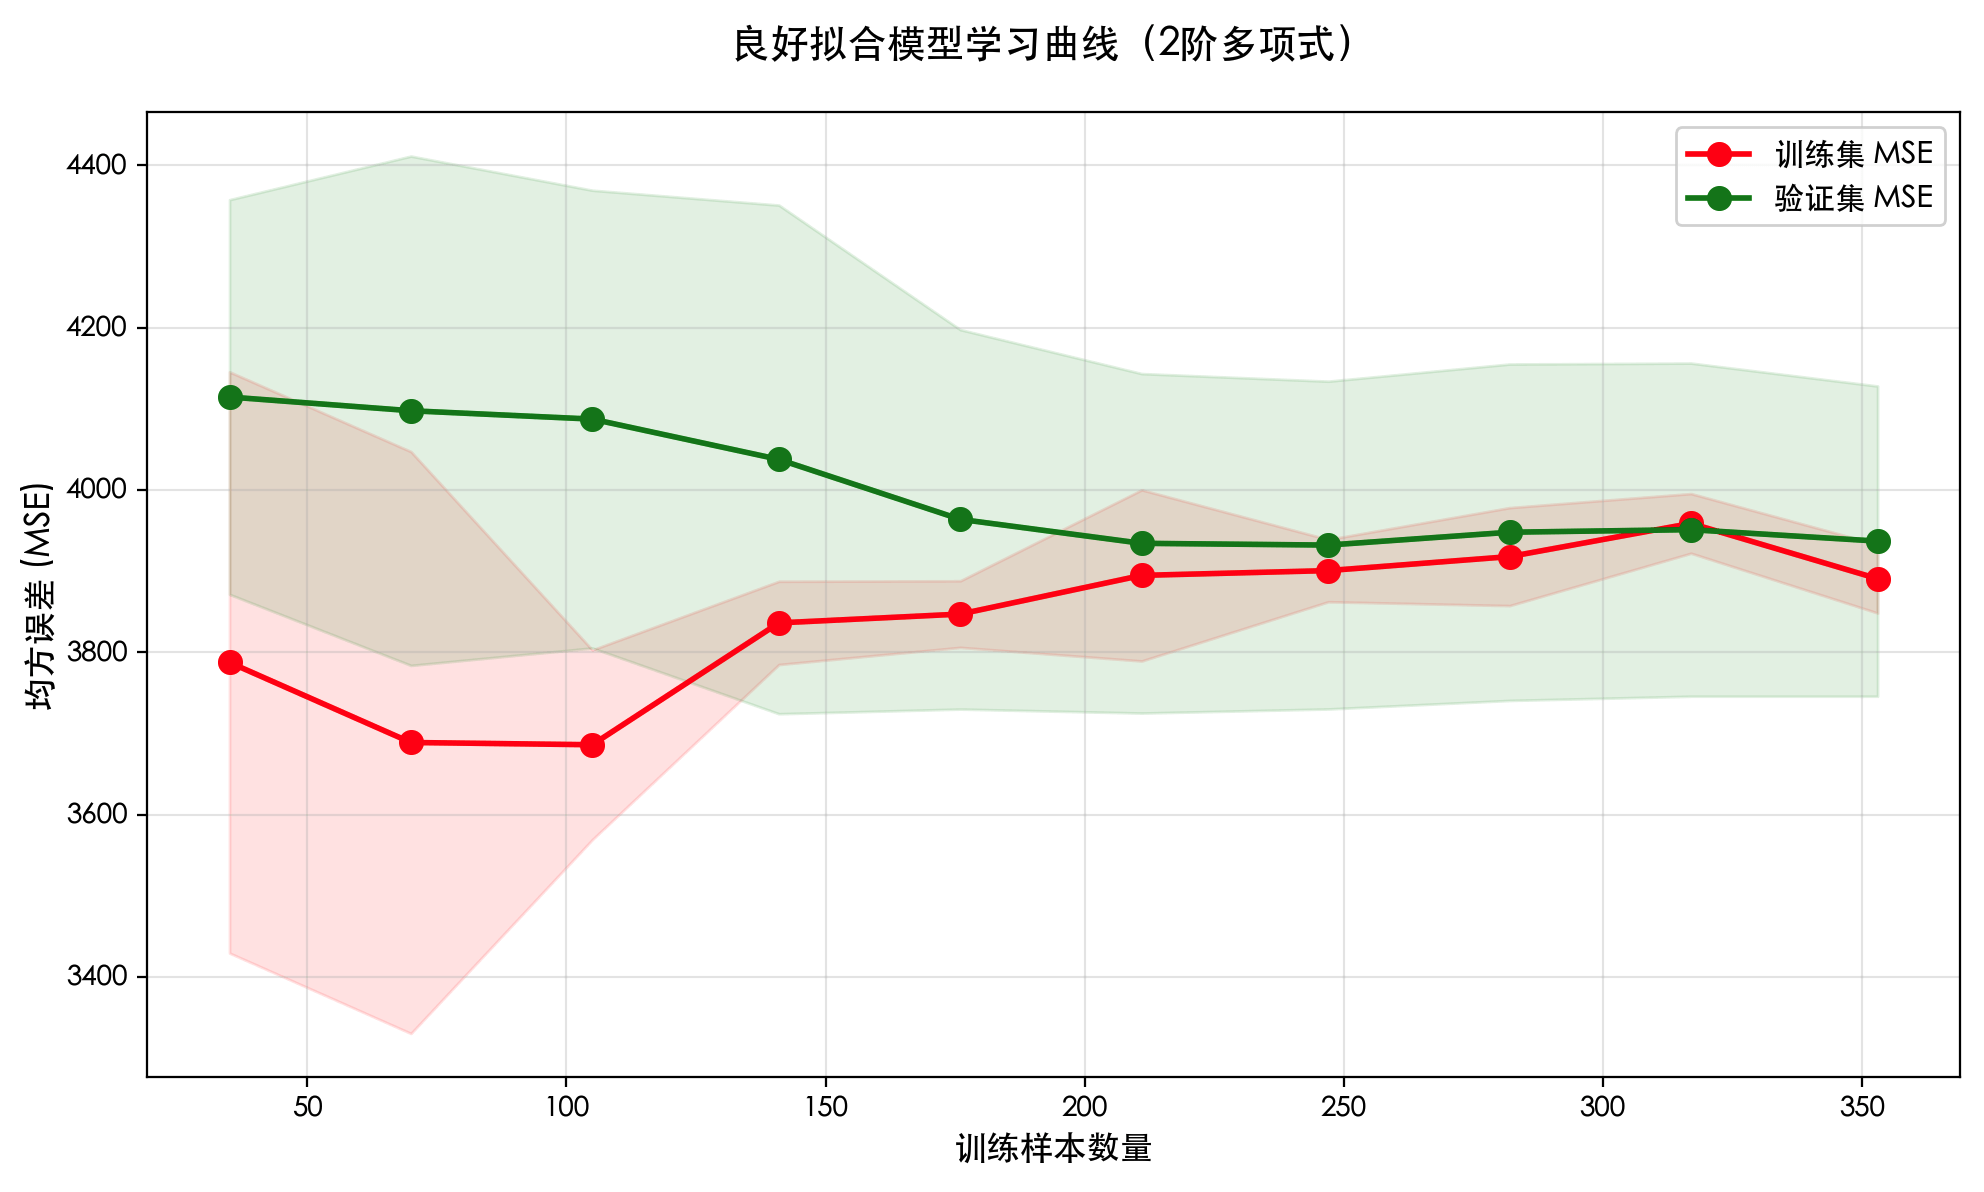
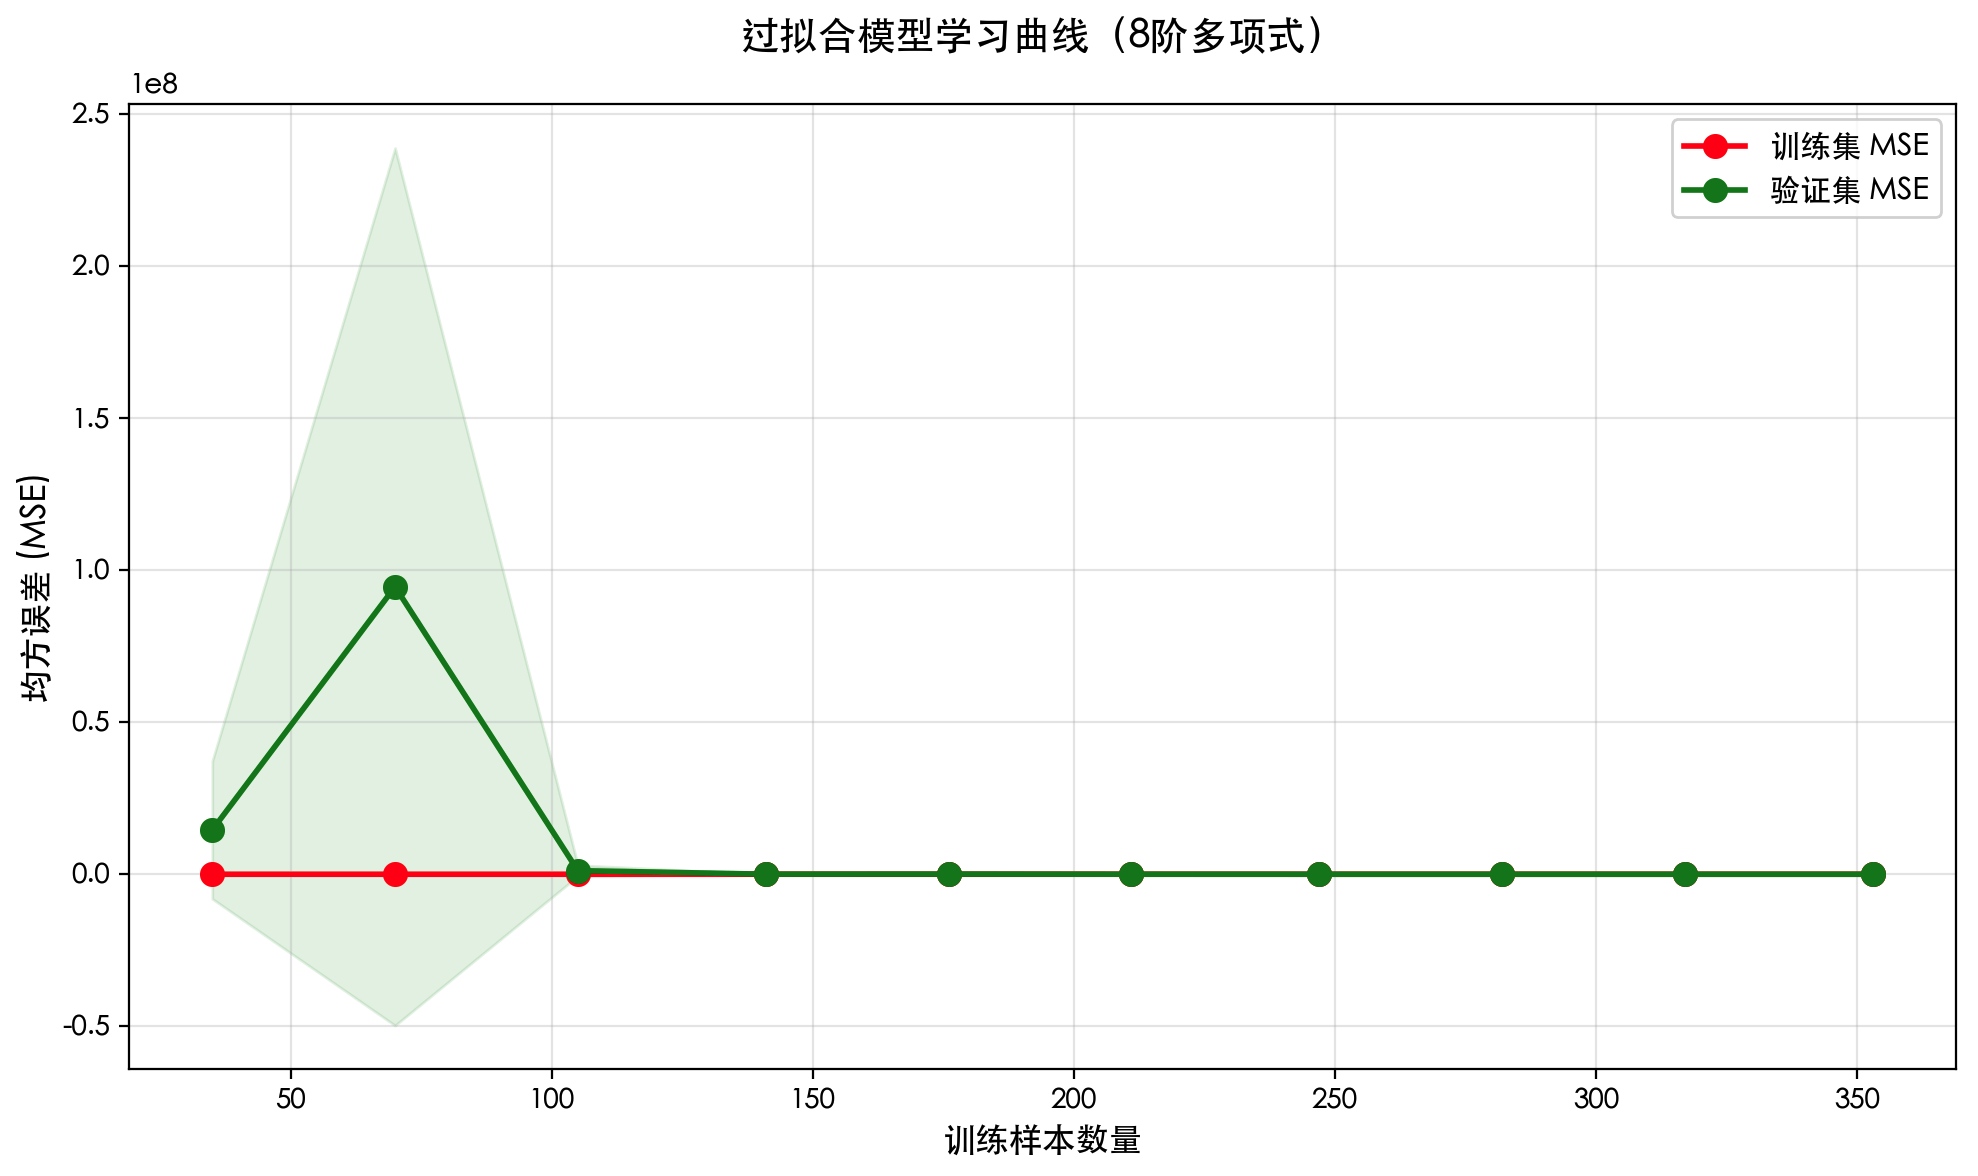
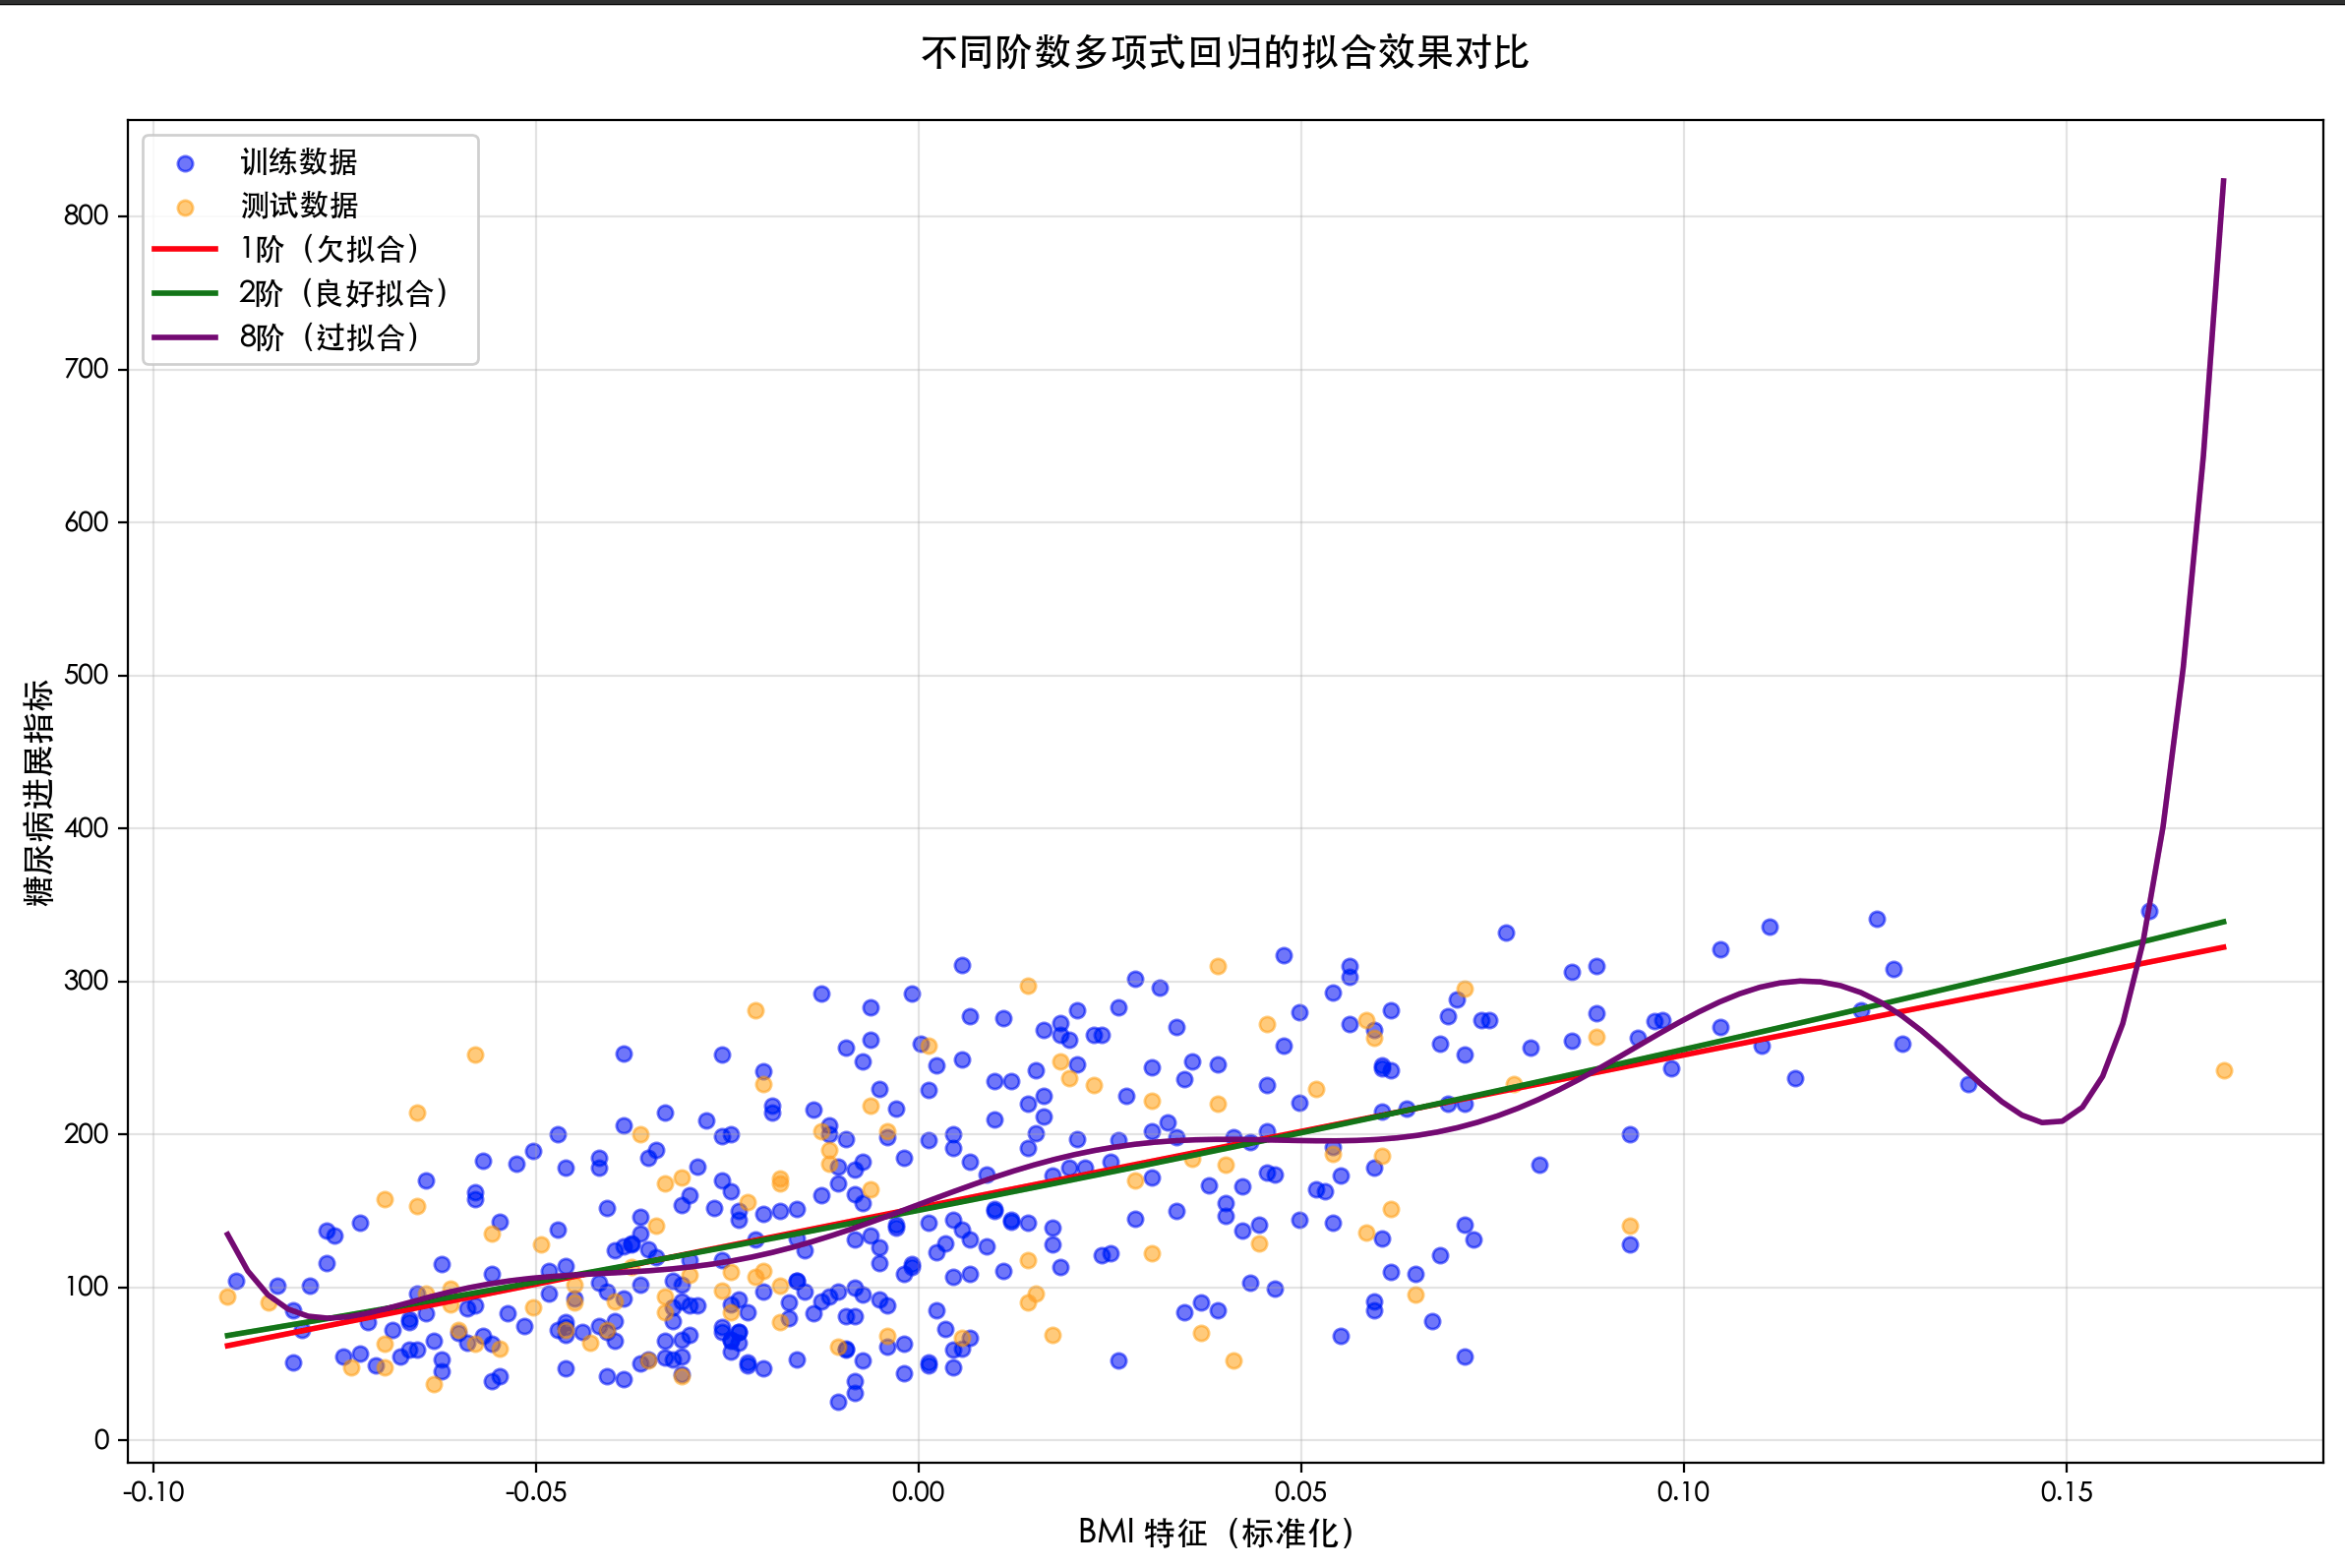
Wie sind Lernkurven zu interpretieren?
| Anpassungszustand | Trainingsfehler | Validierungsfehler | Kurveneigenschaften |
|---|---|---|---|
| Unteranpassung | Hoch | Hoch | Beide Kurven sind hoch und liegen sehr nahe beieinander; das Hinzufügen von Daten hilft nicht. |
| Gute Anpassung | Niedrig | Niedrig | Beide Kurven sind niedrig und liegen nahe beieinander und erreichen einen Gleichgewichtspunkt. |
| Überanpassung (Overfitting) | Sehr gering | Hoch | Der Trainingsfehler ist sehr niedrig, aber der Validierungsfehler ist hoch, mit einer offensichtlichen Lücke dazwischen. Das Hinzufügen von Daten bringt sie normalerweise näher zusammen. |
2. Gegenmaßnahmen
Basierend auf den Diagnoseergebnissen können wir verschiedene Strategien anwenden:
Umgang mit Underfitting (hoher Bias):
- Modellkomplexität erhöhen: Verwenden Sie leistungsfähigere Modelle (z. B. Wechsel von linearen Modellen zu Baummodellen, neuronalen Netzen).
- Mehr Merkmale hinzufügen: Gewinnen oder konstruieren Sie aussagekräftigere Merkmale.
- Regularisierung verringern: Wenn Regularisierung (z. B. L1, L2) verwendet wird, versuchen Sie, ihre Stärke zu verringern.
- Trainingszeit verlängern: Trainieren Sie iterative Modelle (z. B. neuronale Netze) über mehr Epochen.
Umgang mit Overfitting (hohe Varianz):
- Mehr Trainingsdaten beschaffen: Eine der effektivsten Methoden.
- Modellkomplexität reduzieren: Wählen Sie ein einfacheres Modell (z. B. niedrigeren Polynomgrad, geringere Baumtiefe, reduzierte Anzahl an Schichten neuronaler Netze).
- Merkmalsauswahl: Entfernen Sie irrelevante oder redundante Merkmale.
- Regularisierung erhöhen:
- L1-Regularisierung (Lasso): Neigt dazu, dünn besetzte Gewichte zu erzeugen, und kann zur Merkmalsauswahl verwendet werden.
- L2-Regularisierung (Ridge): Verursacht Weight Decay, was dazu führt, dass alle Gewichte tendenziell klein werden.
- Dropout(für neuronale Netze): Während des Trainings zufällig einen Teil der Neuronen "ausschalten".
- Early Stopping(für iterative Modelle): Training beenden, wenn der Validierungsfehler nicht mehr abnimmt.
IV. Praktische Übung: Erfahrung mit echten Datensätzen
Üben wir mit dem klassischen Boston-Housing-Datensatz (oder dem Diabetes-Datensatz, da der Boston-Datensatz veraltet ist).
Beispiel
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error
# -------------------------- Chinesische Schriftart konfigurieren Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, dass negative Vorzeichen als Blöcke angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Ende der Konfiguration der chinesischen Schriftart --------------------------
# Daten laden
data = load_diabetes()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Entscheidungsbäume mit unterschiedlichen Komplexitäten ausprobieren
max_depths = [1, 3, 10, None] # None bedeutet keine Tiefenbegrenzung; der Baum wächst weiter, bis er "rein" ist
train_errors = []
test_errors = []
for depth in max_depths:
model = DecisionTreeRegressor(max_depth=depth, random_state=42)
model.fit(X_train, y_train)
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_error = mean_squared_error(y_train, y_train_pred)
test_error = mean_squared_error(y_test, y_test_pred)
train_errors.append(train_error)
test_errors.append(test_error)
print(f"Maximale Baumtiefe: {depth if depth is not None else 'Unbegrenzt'}")
print(f" MSE des Trainingssets: {train_error:.2f}")
print(f" MSE des Testsets: {test_error:.2f}")
print("-" * 30)
# Visualisierung
plt.figure(figsize=(10, 6))
depths = [str(d) if d else 'Unbegrenzt' for d in max_depths]
x_index = np.arange(len(depths))
width = 0.35
plt.bar(x_index - width/2, train_errors, width, label='Trainingsfehler', color='skyblue')
plt.bar(x_index + width/2, test_errors, width, label='Testfehler', color='lightcoral')
plt.xlabel('Maximale Tiefe des Entscheidungsbaums (Modellkomplexität)')
plt.ylabel('Mittlerer quadratischer Fehler (MSE)')
plt.title('Bias-Varianz-Abwägung: Leistung von Entscheidungsbäumen mit unterschiedlicher Komplexität')
plt.xticks(x_index, depths)
plt.legend()
plt.grid(True, axis='y')
plt.tight_layout()
plt.show()
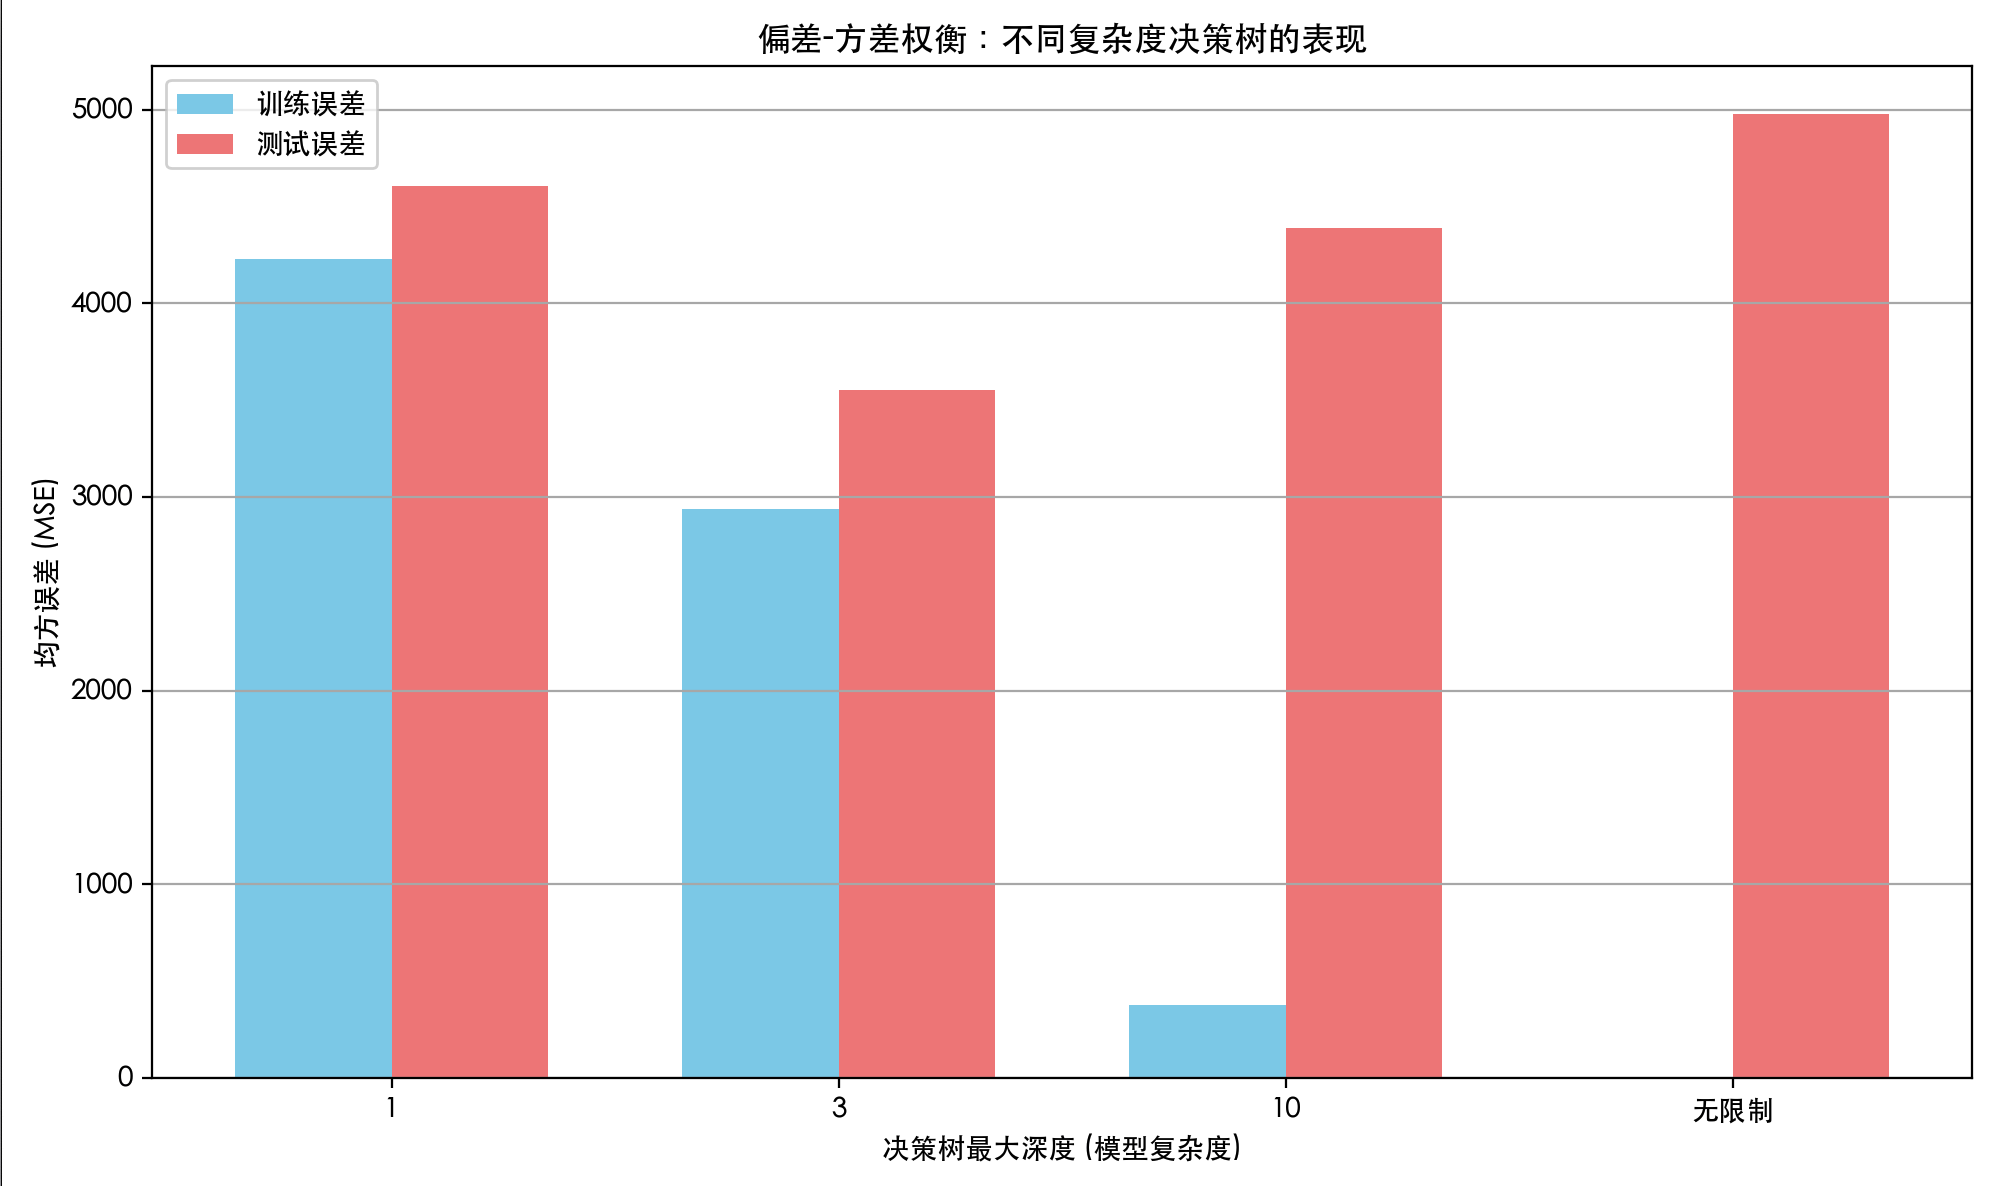
Analyseergebnisse:
- Depth=1: Das Modell ist sehr einfach, sowohl Trainings- als auch Testfehler sind hoch ->hoher Bias, Underfitting。
- Depth=3: Modellkomplexität steigt, beide Fehler nehmen deutlich ab und sind relativ ähnlich ->Bias-Varianz-Gleichgewicht, gute Anpassung。
- Depth=10 oder unbegrenzt: Das Modell ist sehr komplex, der Trainingsfehler ist extrem niedrig, aber der Testfehler beginnt zu steigen (oder ist viel höher als der Trainingsfehler) ->Hohe Varianz, Overfitting。
Zusammenfassung
Das Verständnis von Overfitting, Underfitting, Bias und Varianz ist der Grundpfeiler für den Aufbau hervorragender Machine-Learning-Modelle. Merken Sie sich diese Kernschleife:
- Trainieren Sie das Modell -> Bewerten Sie seine Leistung auf den Trainings- und Validierungssets。
- Diagnostizieren Sie Probleme mithilfe von Lernkurven oder Fehlervergleich: Handelt es sich um hohen Bias (Underfitting) oder hohe Varianz (Overfitting)?
- Wenden Sie die entsprechende Strategie an(Komplexität/Daten erhöhen, Regularisierung usw.), um Verbesserungen zu erzielen.
- Kehren Sie zu Schritt 1 zurück, bis auf dem Validierungsset ein zufriedenstellendes Modell mit starker Generalisierungsfähigkeit erzielt wird.