アンサンブル法
機械学習において、あなたはすでに決定木やロジスティック回帰モデルの訓練方法を習得しているかもしれませんが、単一のモデル(これをベース学習器と呼びます)の性能は時として限界に達します。
このとき、強力な考え方が生まれます:アンサンブル法それは、まったく新しいより複雑なアルゴリズムを生み出すことに依存せず、比較的単純で、さらに平凡な性能のモデルを巧みに組み合わせることで、より強力で、より安定し、より正確なスーパーモデルを構築します。
簡単に言うと、アンサンブル学習の核心的な哲学は三人寄れば文殊の知恵。
アンサンブル法は、複数のモデルの集合知を集約することで、単一のモデルが持つ可能性のあるバイアス、バリアンス、または偶発的な誤りを補い、全体の予測性能を大幅に向上させます。
本稿では、アンサンブル法の原理、主流技術、およびそのエンジニアリング実践について体系的に解説します。
アンサンブル学習の基本思想と利点
具体的な手法に入る前に、まずアンサンブル学習がなぜ有効なのか、そしてどのような利点をもたらすのかを理解する必要があります。
核心思想:誤差の低減
モデルの予測誤差は通常、3つの部分に分解できます:バイアス、バリアンスと削減不可能な誤差。
- バイアス:モデルの問題の本質に対する仮定の誤りによって生じる系統的誤差です。高いバイアスはモデルが未学習(アンダーフィッティング)、データ内の基本的な関係を捉えることができないことを意味します。
- バリアンス:モデルのトレーニングデータの微小な変動に対する敏感さの度合いです。高いバリアンスはモデルが過学習(オーバーフィッティング)、トレーニングデータ内のノイズに過度に注目していることを意味します。
- 削減不可能な誤差:データに本質的に存在するランダムノイズであり、どのモデルでも除去できません。
アンサンブル法の核心的な目標は、複数のモデルを組み合わせることで、全体のモデルのバリアンスまたはバイアスを低減し、それによってよりロバスト(安定)で正確な予測を得ることです。
主な利点
- 精度の向上:これは最も直接的な目標であり、アンサンブルモデルはほとんどのシナリオで最良の単一のベース学習器よりも優れた性能を発揮します。
- 安定性とロバスト性の強化:平均化や投票によって、アンサンブルモデルはノイズデータや外れ値にそれほど敏感ではなくなり、過学習のリスクを低減します。
- 仮説空間の拡大:複数のモデルを組み合わせることは、より広大な解空間を探索することに相当し、問題の最適解に近づく可能性が高まります。
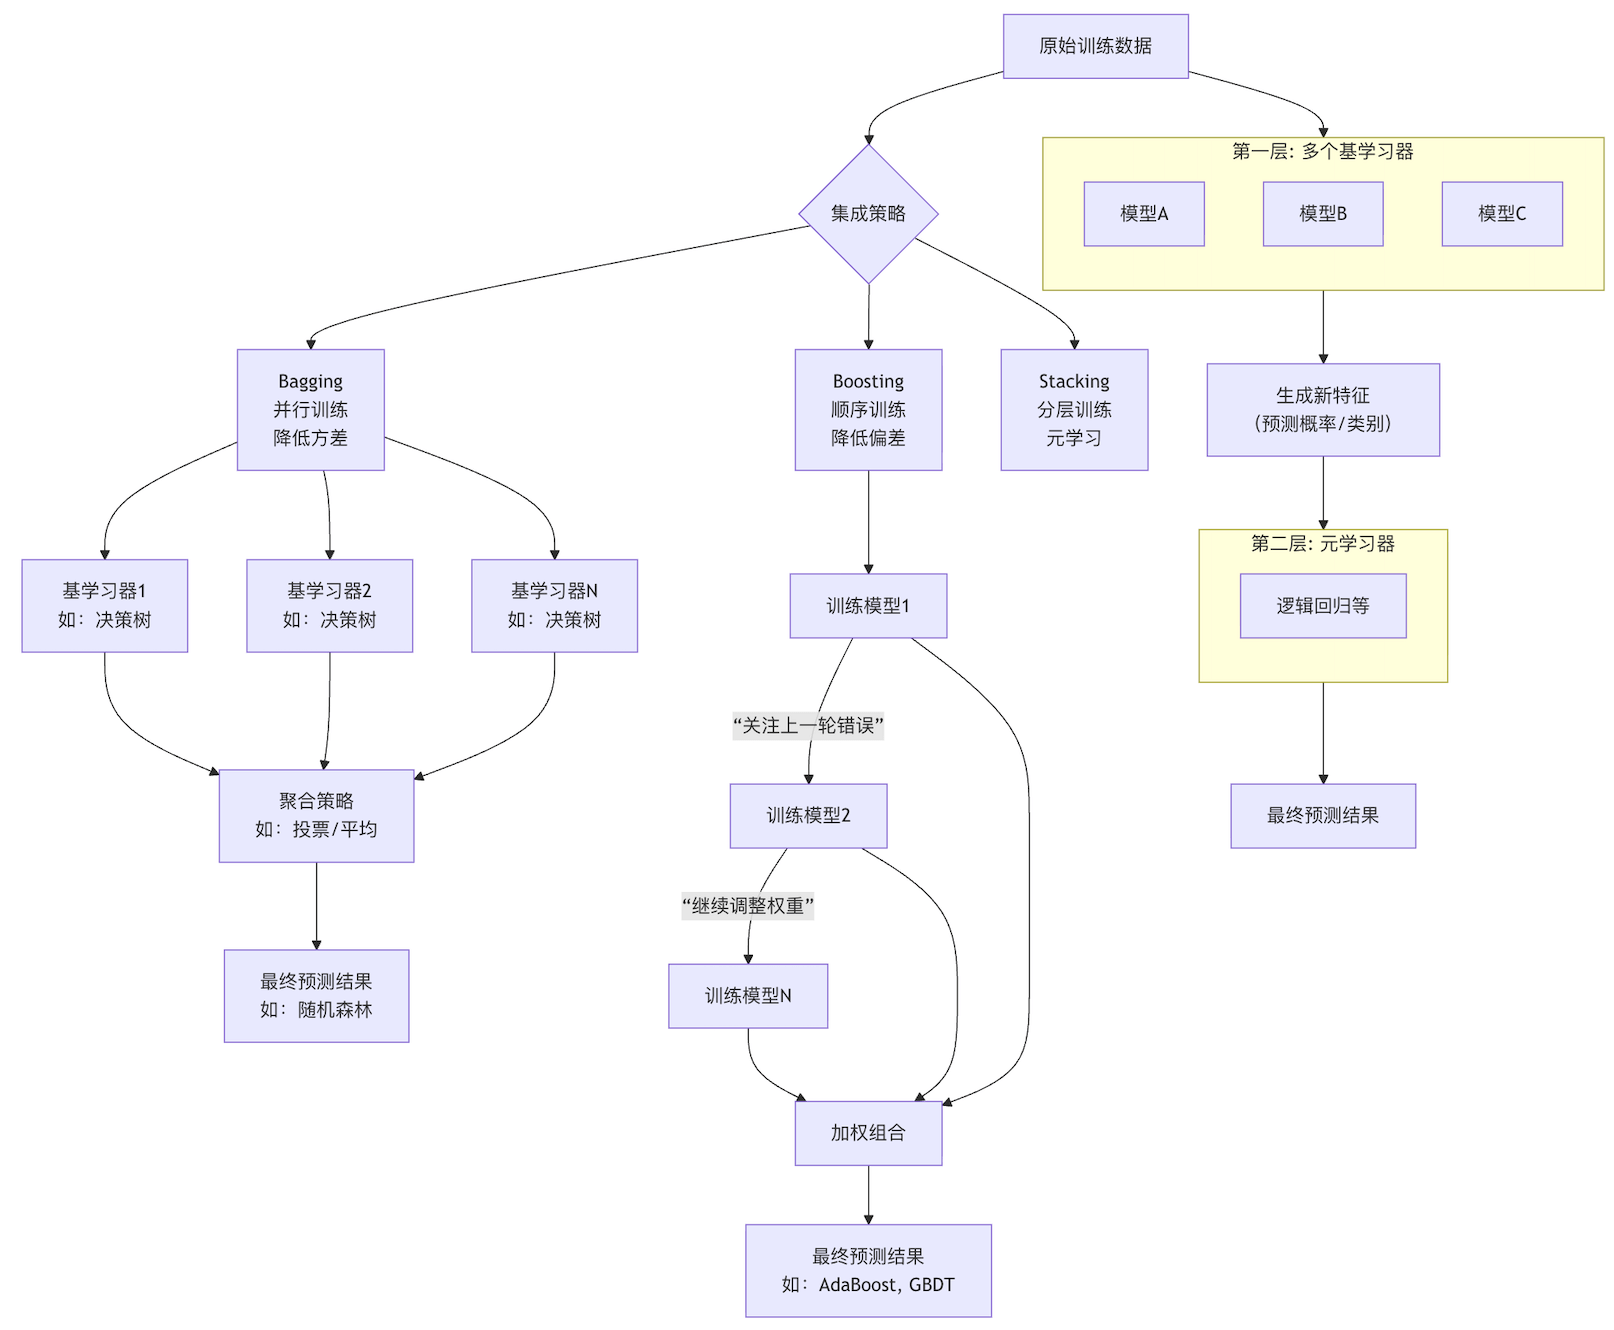
アンサンブル法が複数のモデルを組み合わせてどのように機能するかをより直感的に理解するために、以下のフローチャートを見てみましょう:
主流のアンサンブル法の詳解
ベース学習器の生成方法と組み合わせ戦略に基づいて、アンサンブル法は主に3つのカテゴリに分類されます:Bagging、BoostingとStacking。
Bagging:並列の道、安定最優先
Baggingその核心的な考え方は、Bootstrap Aggregating。
- Bootstrap:元のトレーニングセットから復元抽出(重複を許す)によるランダムサンプリングを行い、複数の異なるサブトレーニングセットを生成します。各サブセットのサイズは元のセットと同じかもしれませんが、復元抽出のため、一部のサンプルは繰り返し抽出され、他のサンプルは抽出されないことがあります。
- 並列トレーニング:同じ学習アルゴリズム(通常は高バリアンス・低バイアスのモデル、例えば剪定されていない決定木)を使用して、各サブトレーニングセットで独立にベース学習器を訓練します。
- Aggregating:分類タスクでは、投票法(多数決)で最終的なクラスを決定します。回帰タスクでは、平均法で最終値を計算します。
代表的なアルゴリズム:ランダムフォレストランダムフォレストはBaggingの考え方の傑出した代表であり、Baggingをさらに一歩進めています:各決定木のノード分割時に、サンプルのランダムサンプリングだけでなく、一部の特徴をランダムに選択して最適分割を行います。この「二重のランダム性」により、モデルの多様性と過学習への耐性がさらに強化されます。
実例
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# データを読み込む
iris = load_iris()
X, y = iris.data, iris.target
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# ランダムフォレスト分類器を作成
# n_estimators: 森の中の木の数、ベース学習器の個数
# max_depth: 木の最大深さ、モデルの複雑さを制御
# random_state: 乱数シード、結果の再現性を確保
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# モデルを訓練
rf_clf.fit(X_train, y_train)
# 予測して評価
y_pred = rf_clf.predict(X_test)
print(f"ランダムフォレスト精度: {accuracy_score(y_test, y_pred):.4f}")
# 単一の木の深さを確認(例)
print(f"最初の木の深さ: {rf_clf.estimators_)
Boosting:逐次的な知恵、誤り訂正に集中
Boostingまったく異なる戦略を採用します。
- 逐次トレーニング:ベース学習器は順番に訓練され、並列ではありません。
- 誤りへの注目:後続の各モデルは、前のモデルが誤って予測したサンプルに注目します。通常はトレーニングサンプルの重みを調整することで実現します(誤分類されたサンプルにより高い重みを与えます)。
- 重み付き組み合わせ:すべてのベース学習器を重み付き合計して最終モデルを得ます。性能の良いベース学習器ほど重みが高くなります。
Boostingの核心は、先行モデルの誤りを継続的に修正し、「弱学習器」(ランダムな推測よりわずかに良いだけ)の集団を強力な「強学習器」に高めることです。
代表的なアルゴリズム:AdaBoost と 勾配ブースティング決定木(Gradient Boosting Decision Tree)
- AdaBoost:最も初期のBoostingアルゴリズムの1つです。誤分類されたサンプルの重みを増加させ、後続モデルにこれらの「難しい」サンプルを重点的に学習させます。
- 勾配ブースティング決定木(Gradient Boosting Decision Tree):現在最も人気があり、最も強力なBoostingアルゴリズムの1つです。サンプルの重みを調整するのではなく、トレーニングプロセスを勾配降下法の最適化プロセスとみなします。各新しい木の目標は、現在のモデルの予測結果と真のラベルとの間の残差(負の勾配)をフィッティングすることです。
実例
from sklearn.ensemble import GradientBoostingClassifier
# 勾配ブースティング分類器を作成
# n_estimators: ブースティング段階の数(木の数)
# learning_rate: 学習率、各木の最終結果への寄与度を制御(収縮係数)
# max_depth: 各回帰木の最大深さ、通常は小さい(3-5)、弱学習器を表す
gb_clf = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, max_depth=3, random_state=42)
# モデルを訓練
gb_clf.fit(X_train, y_train)
# 予測して評価
y_pred_gb = gb_clf.predict(X_test)
print(f"勾配ブースティング木の精度: {accuracy_score(y_test, y_pred_gb):.4f}")
# 特徴量の重要度を確認(アンサンブル法は通常これを提供できる)
print("特徴量の重要度:", gb_clf.feature_importances_)
出力:
随机森林准确率: 1.0000
第一棵树的深度: 4
Stacking:モデルのスタッキング、メタ学習戦略
Stackingより高度なアンサンブル技術であり、「メタ学習器」の概念を導入します。
- 第1層:多様なベース学習器。異なる学習アルゴリズム(KNN、SVM、決定木など)を使用して、元のデータ上で複数のモデルを訓練します。
- 新しい特徴量の生成:これらの第1層モデルでトレーニングデータを予測し(通常はデータリークを防ぐために交差検証を使用)、その予測結果(クラスラベルまたは確率)を新しい特徴量。
- 第2層:メタ学習器の訓練。これらの新しい特徴量を入力とし、元のラベルを出力として、最終的なモデル(ロジスティック回帰、線形回帰など)を訓練します。このメタ学習器は、第1層モデルの出力を最も良く組み合わせる方法を学習する役割を担います。
Stackingは可能性が非常に高いですが、計算コストが高く、過学習を防ぐために慎重な設計が必要です。
手法の比較とエンジニアリング実践の提案
原理を理解した後、実際のプロジェクトでこれらの手法をどのように選択し適用するのでしょうか?
三大手法の比較
| 特性 | Bagging(例:ランダムフォレスト) | Boosting(例:GBDT, XGBoost) | Stacking |
|---|---|---|---|
| 核心目標 | バリアンスの低減、過学習の防止 | バイアスを低減する、予測力を向上させる | 組み合わせ戦略の最適化 |
| 訓練方法 | 並列、独立して訓練 | 直列、前のラウンドの結果に依存 | 階層的、まず基本学習器、次にメタ学習器 |
| サンプル重み | 平等に扱い、ブートストラップサンプリング | 動的に調整し、誤りに注目 | 通常は平等 |
| 基本学習器の関係 | 相互に独立しており、多様性はデータの摂動に由来する | 相互に依存しており、共通の最適化目標を持つ | 相互に独立しており、多様性はアルゴリズムの違いに由来する |
| 利点 | 安定しており、過学習に強く、並列化が容易 | 予測精度は通常非常に高い | 理論上、最良の性能が得られる |
| 欠点 | バイアス低減には限界があり、計算リソースの消費が大きい | ノイズに敏感で、過学習しやすく、ハイパーパラメータ調整が複雑 | 計算コストが非常に高く、構造が複雑で、過学習しやすい |
| 典型的な応用例 | ランダムフォレスト、Extra-Trees | AdaBoost, GBDT, XGBoost, LightGBM, CatBoost | 機械学習コンペティションでよく見られる |
エンジニアリング実践ガイド
ベースラインモデルを優先する:最初から複雑なアンサンブル手法を使わないこと。まず単純なモデル(ロジスティック回帰、単一の決定木など)で性能ベースラインを構築する。
問題に応じて選択する:
- ベースモデル(深い決定木など)が過学習が深刻な場合(高分散)、優先的に試すのはBagging(ランダムフォレスト)。
- ベースモデルが未学習(高バイアス)の場合、または極めて高い予測精度を追求する場合、優先的に試すのはBoosting(XGBoost、LightGBMなど)。
- に機械学習コンペティションまたは精度に究極の要求がある場面で、計算リソースが十分な場合は、検討できるのはStacking 或 Blending。
最新の最適化ライブラリの活用:実践では、高度に最適化されたライブラリを直接使用する。これらは最先端のアンサンブルアルゴリズムを実装している:
- Scikit-learn:提供しているのは
RandomForest,GradientBoostingなどの優れた実装で、入門や迅速なプロトタイプ開発に適している。 - XGBoost:速度が速く、精度が高く、機能が充実しており、Kaggleコンペティションの常勝モデルである。
- LightGBM:マイクロソフトが開発し、訓練速度がより速く、メモリ消費が少なく、特に大規模データセットに適している。
- CatBoost:Yandexが開発し、カテゴリ特徴量をうまく処理でき、デフォルトパラメータでも優れた性能を発揮する。
ハイパーパラメータ調整に注意する:アンサンブルモデルはハイパーパラメータが多い。重点的に注目すべきパラメータは次の通り:
n_estimators:基本学習器の数(多ければ多いほど良いが、計算コストは増加する)。learning_rate(Boosting):学習率。各ステップの貢献度を制御する。通常はn_estimatorsトレードオフ(学習率が小さいとより多くの木が必要)。max_depth(ツリー手法):モデルの複雑さと過学習を制御する鍵。- 使用する交差検証とグリッドサーチ/ランダムサーチを用いて体系的にハイパーパラメータを調整する。