Logistische Regression
Die logistische Regression ist eine statistische Lernmethode, die häufig für Klassifikationsprobleme verwendet wird. Trotz des Wortes "Regression" in ihrem Namen handelt es sich tatsächlich um einen Algorithmus für binäre oder Mehrklassen-Klassifikationsprobleme.
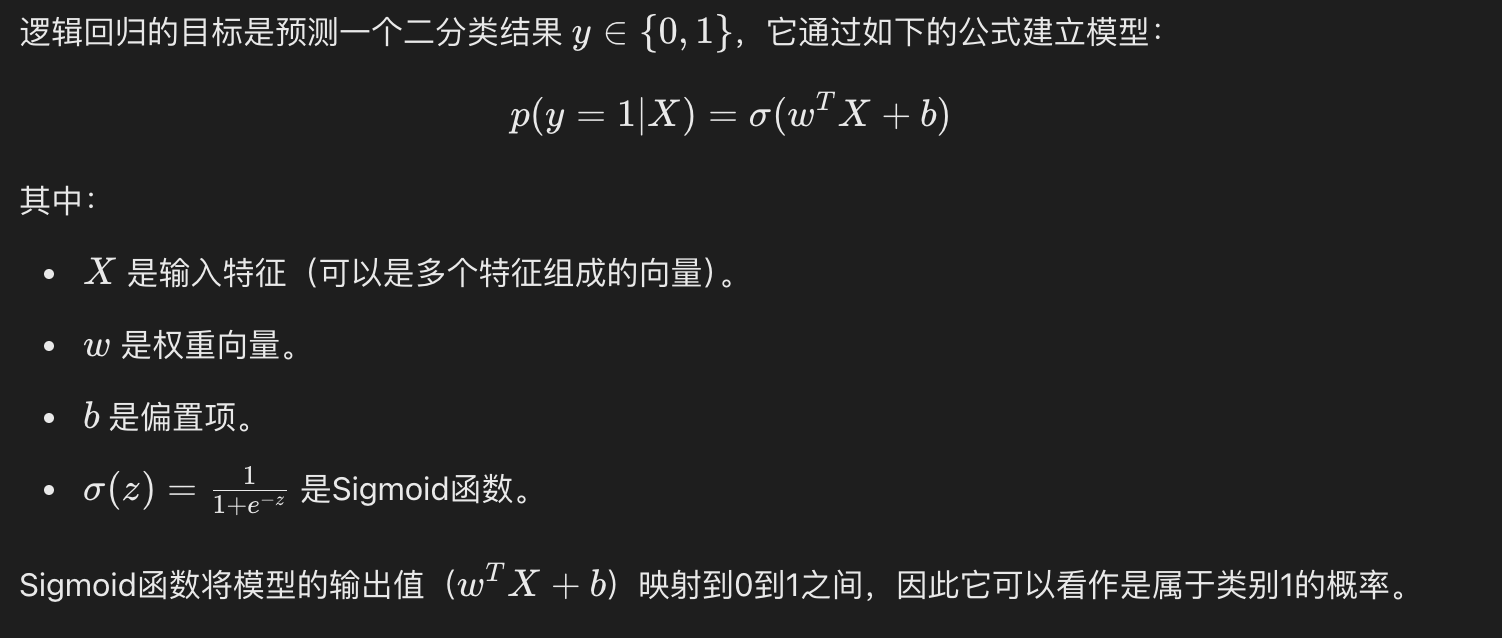
Die logistische Regression verwendet eine logistische Funktion (auch Sigmoid-Funktion genannt), um die Ausgabe der linearen Regression auf einen Wert zwischen 0 und 1 abzubilden und damit die Wahrscheinlichkeit des Eintretens eines bestimmten Ereignisses vorherzusagen.
Die logistische Regression wird häufig in verschiedenen Klassifikationsproblemen eingesetzt, wie zum Beispiel:
- Spam-Erkennung (Spam / kein Spam)
- Krankheitsvorhersage (Krankheit / keine Krankheit)
- Vorhersage der Kundenabwanderung (Abwanderung / keine Abwanderung)
Logistisches Regressionsmodell
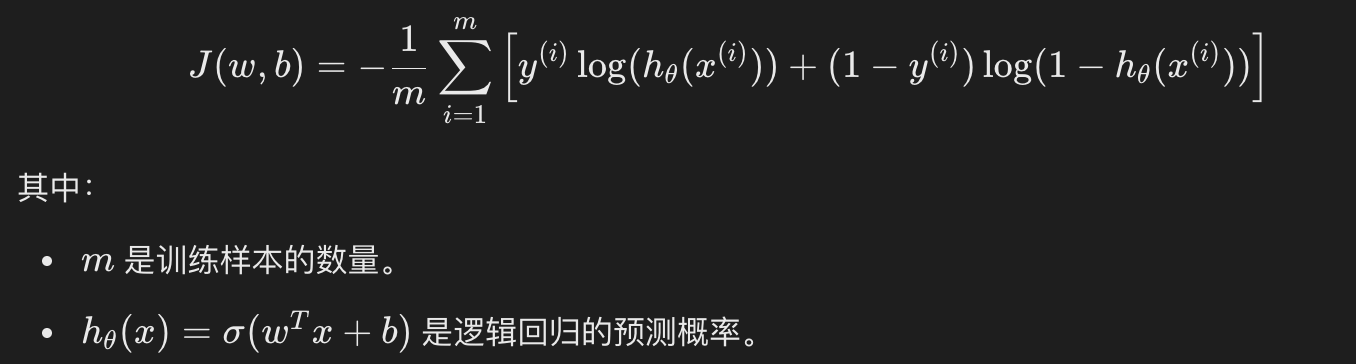
Verlustfunktion
Die Verlustfunktion der logistischen Regression ist der Log-Loss, welcher die folgende Form hat:
Lösen mit Gradientenabstieg
Wie bei der linearen Regression verwendet die logistische Regression normalerweise ebenfalls den Gradientenabstieg, um die Verlustfunktion zu optimieren und die Parameter w und b zu bestimmen. Die Gradientenaktualisierungsregeln für die logistische Regression lauten wie folgt:

Durch kontinuierliches Aktualisieren von w und b, bis die Verlustfunktion konvergiert.
Implementierung der logistischen Regression mit Python
Als Nächstes verwenden wir Python und die Scikit-learn-Bibliothek, um ein einfaches logistisches Regressionsmodell zu implementieren.
1. Notwendige Bibliotheken importieren
Beispiel
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
2. Datensatz laden
Wir verwenden den Iris-Datensatz, der mit Scikit-learn mitgeliefert wird. Der Iris-Datensatz enthält 150 Stichproben mit jeweils 4 Merkmalen, und das Ziel ist, die Stichproben in 3 Klassen zu klassifizieren. Um das Problem zu vereinfachen, verwenden wir nur die ersten beiden Merkmale und wandeln das Problem in ein binäres Klassifikationsproblem um.
Beispiel
iris = load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale verwenden
y = (iris.target != 0) * 1 # Zielvariable in ein binäres Klassifikationsproblem umwandeln
# Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Logistisches Regressionsmodell trainieren
Beispiel
model = LogisticRegression()
# Modell trainieren
model.fit(X_train, y_train)
4. Modellbewertung
Beispiel
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Datensatz laden
iris = load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale verwenden
y = (iris.target != 0) * 1 # Zielvariable in ein binäres Klassifikationsproblem umwandeln
# Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Logistisches Regressionsmodell erstellen
model = LogisticRegression()
# Modell trainieren
model.fit(X_train, y_train)
# Testmenge vorhersagen
y_pred = model.predict(X_test)
# Genauigkeit berechnen
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.2f}")
# Konfusionsmatrix
conf_matrix = confusion_matrix(y_test, y_pred)
print("Konfusionsmatrix:")
print(conf_matrix)
# Klassifikationsbericht
class_report = classification_report(y_test, y_pred)
print("Klassifikationsbericht:")
print(class_report)
Die Ausgabe ist:
模型准确率: 1.00
混淆矩阵:
[[19  0]
 [ 0 26]]
分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        19
           1       1.00      1.00      1.00        26

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
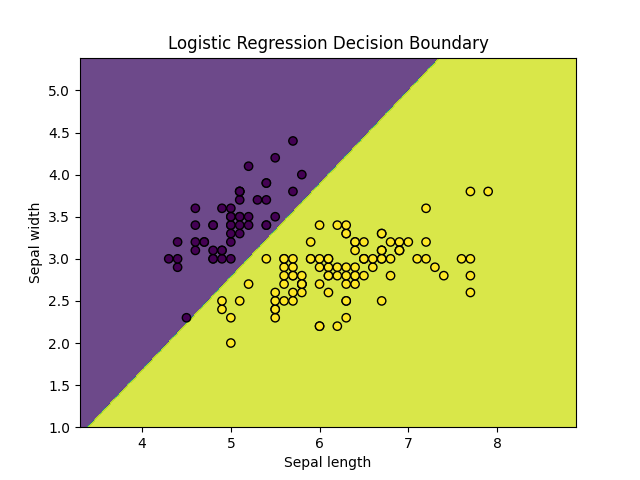
5. Entscheidungsgrenze visualisieren
Beispiel
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Datensatz laden
iris = load_iris()
X = iris.data[:, :2] # Nur die ersten beiden Merkmale verwenden
y = (iris.target != 0) * 1 # Zielvariable in ein binäres Klassifikationsproblem umwandeln
# Trainings- und Testsets aufteilen
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Logistisches Regressionsmodell erstellen
model = LogisticRegression()
# Modell trainieren
model.fit(X_train, y_train)
# Testmenge vorhersagen
y_pred = model.predict(X_test)
# Entscheidungsgrenze visualisieren
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Kelchblattlänge')
plt.ylabel('Kelchblattbreite')
plt.title('Entscheidungsgrenze der logistischen Regression')
plt.show()
Wird folgendermaßen angezeigt:
Zusammenfassung
- Die logistische Regression verwendet die Sigmoid-Funktion, um die Ausgabe der linearen Regression in Wahrscheinlichkeitswerte umzuwandeln, und wird zur Lösung binärer Klassifikationsprobleme eingesetzt.
- Der Trainingsprozess der logistischen Regression optimiert die Modellparameter durch Minimierung der Log-Loss-Funktion.
- Der Gradientenabstieg ist eine häufig verwendete Optimierungsmethode, um Modellparameter zu aktualisieren.und。
- In Python bietet die
scikit-learnBibliothek eine einfache und benutzerfreundliche Schnittstelle zur Implementierung der logistischen Regression und erleichtert das Trainieren, Bewerten und Visualisieren von Modellen.