Feature-Engineering
Stellen Sie sich vor, Sie sind ein Koch und bereiten ein köstliches Gericht zu. Das Machine-Learning-Modell ist wie Ihr „Kochalgorithmus“, und die Rohdaten sind die verschiedenen Zutaten, die Sie auf dem Markt gekauft haben: Gemüse, Fleisch, Gewürze, aber einige sind vielleicht mit Schlamm bedeckt, einige sind ganze Stücke, und einige haben einen starken Geruch.Feature Engineeringist der Prozess des Bereinigens, Schneidens, Marinierens und Kombinierens dieser rohen „Zutaten“ zu „Halbfertigprodukten“, die direkt gekocht werden können. Es ist die Brücke zwischen Rohdaten und Machine-Learning-Modellen und ein entscheidender Schritt, der die Obergrenze der Modellleistung bestimmt.
Einfach ausgedrückt,Feature Engineeringist der Prozess, mithilfe von Domänenwissen durch eine Reihe technischer Mittel Merkmale (Variablen) aus Rohdaten zu extrahieren, zu konstruieren und auszuwählen, die wertvoller und für Machine-Learning-Modelle leichter zu erlernen sind.
I. Warum ist Feature Engineering so wichtig?
In Machine-Learning-Projekten bestimmt die Qualität der Daten und Merkmale direkt die Obergrenze der Modellleistung, während Modelle und Algorithmen sich dieser Grenze nur annähern. Hervorragendes Feature Engineering kann:
- Modellleistung verbessern: Gute Merkmale machen es dem Modell leichter, Muster in den Daten zu entdecken.
- Modelltraining beschleunigen: Das Reduzieren irrelevanter oder redundanter Merkmale kann die Rechenkomplexität verringern.
- Modellgeneralisierung verbessern: Überanpassung des Modells an Rauschen in den Trainingsdaten verhindern.
- Anpassung an Modellanforderungen: Verschiedene Modelle haben unterschiedliche Annahmen über Daten (z. B. lineare Modelle nehmen lineare Beziehungen an); Feature Engineering kann Daten dazu bringen, diese Annahmen zu erfüllen.
Mit dem folgenden Flussdiagramm können wir die Position des Feature Engineering in der gesamten Machine-Learning-Pipeline intuitiv verstehen:
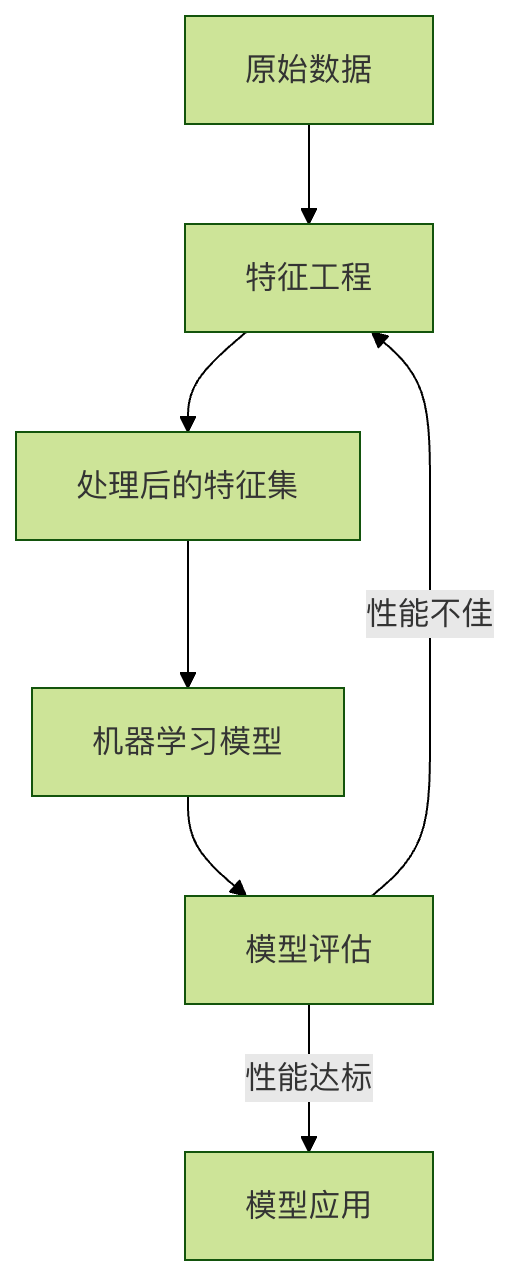
II. Kernoperationen des Feature Engineering
Feature Engineering umfasst hauptsächlich drei Hauptkategorien von Operationen:Feature-Verarbeitung、Feature-KonstruktionundFeature-Auswahl。
1. Feature-Verarbeitung
Dies ist der grundlegendste Schritt, mit dem Ziel, die Rohdaten in ein sauberes und gut organisiertes Format zu "bereinigen".
a) Umgang mit fehlenden Werten
Fehlende Werte kommen häufig in Daten vor (z. B.NaN, NULL), und müssen angemessen behandelt werden.
| Behandlungsmethode | Beschreibung | Anwendungsszenario |
|---|---|---|
| Delete | Zeilen oder Spalten mit fehlenden Werten direkt löschen | Wenn fehlende Daten sehr selten sind oder das Merkmal unwichtig ist |
| Imputation | Mit einem bestimmten Wert füllen, z. B. Mittelwert, Median, Modus oder einem speziellen Wert (z. B. -1) | Die am häufigsten verwendete Methode, anwendbar auf verschiedene Situationen |
| Interpolation | Zeitreihen oder benachbarte Datenpunkte zur Interpolationsberechnung verwenden | Zeitreihendaten |
Codebeispiel (unter Verwendung der Python-Bibliothek pandas):
Beispiel
import numpy as np
# Beispiel-DataFrame mit fehlenden Werten erstellen
data = {'age': [25, np.nan, 30, 35, np.nan],
'salary': [50000, 54000, np.nan, 62000, 58000],
'city': ['Beijing', 'Shanghai', 'Guangzhou', np.nan, 'Beijing']}
df = pd.DataFrame(data)
print(“Rohdaten:”)
print(df)
# 1. Fehlende Werte löschen (alle Zeilen mit NaN löschen)
df_dropped = df.dropna()
print("\nNach dem Entfernen fehlender Werte:")
print(df_dropped)
# 2. Fehlende Werte auffüllen
# Numerische Spalten mit Mittelwert füllen
df_filled = df.copy()
df_filled['age'].fillna(df_filled['age'].mean(), inplace=True)
df_filled['salary'].fillna(df_filled['salary'].mean(), inplace=True)
# Kategorische Spalten mit Modalwert füllen
df_filled['city'].fillna(df_filled['city'].mode()[0], inplace=True)
print("\nNach dem Auffüllen fehlender Werte:")
print(df_filled)
b) Umgang mit Ausreißern
Ausreißer sind Werte, die sich deutlich vom Großteil der Daten unterscheiden und das Modell beeinträchtigen können. Gängige Erkennungsmethoden sind:
- Standardabweichungsmethode: Werte außerhalb des Bereichs Mittelwert ± 3 mal Standardabweichung gelten als Ausreißer.
- Box-Plot-Methode: Werte kleiner als
Q1 - 1.5*IQRoder größer alsQ3 + 1.5*IQRgelten als Ausreißer (IQR = Q3 - Q1)。
Behandlungsmethoden können Löschen, Ersetzen durch Grenzwerte oder Behandeln als fehlende Werte sein.
c) Datenstandardisierung/Normalisierung
Viele Modelle (wie SVM, KNN, neuronale Netze) sind empfindlich gegenüber Merkmalskalen. Wir müssen Merkmale unterschiedlicher Skalen auf dieselbe Skala transformieren.
| Methode | Formel | Beschreibung | Anwendungsszenario |
|---|---|---|---|
| Standardisierung | (x - 均值) / 标准差 |
Nach der Verarbeitung haben die Daten einen Mittelwert von 0 und eine Standardabweichung von 1 | Wenn die Datenverteilung annähernd normal ist |
| Normalisierung | (x - min) / (max - min) |
Skalieren Sie die Daten auf das Intervall [0, 1] | Wenn Datengrenzen klar sind und eine schnelle Berechnung erforderlich ist |
Codebeispiel (unter Verwendung der scikit-learn-Bibliothek):
Beispiel
import numpy as np
# Beispieldaten
data = np.array([[1000, 25],
[1500, 30],
[800, 20],
[1200, 28]])
# Standardisierung
scaler_standard = StandardScaler()
data_standardized = scaler_standard.fit_transform(data)
print("Standardisierte Daten (Mittelwert ~ 0, Standardabweichung ~ 1):")
print(data_standardized)
print(f"Mittelwert: {data_standardized.mean(axis=0)}")
print(f"Standardabweichung: {data_standardized.std(axis=0)}")
# Normalisierung
scaler_minmax = MinMaxScaler()
data_normalized = scaler_minmax.fit_transform(data)
print("\nNormalisierte Daten (Bereich [0,1]): ")
print(data_normalized)
2. Merkmalskonstruktion
Erstellen Sie neue, prädiktivere Merkmale, indem Sie vorhandene Merkmale kombinieren oder transformieren.
a) Numerische Merkmale transformieren
- Polynomielle Merkmale: Erstellen Sie Quadrate, Kuben usw. von Merkmalen, damit lineare Modelle nichtlineare Beziehungen lernen können.
- Binning: Teilen Sie das kontinuierliche Alter in Intervalle wie "jung", "mittelalt", "alt" ein, wodurch kontinuierliche Daten diskretisiert werden.
- Mathematische Transformation: Verwenden Sie Transformationen wie Logarithmus, Exponentialfunktion usw., um die Datenverteilung zu verändern.
b) Kategorische Merkmale kodieren
Modelle des maschinellen Lernens können Text wie "Beijing", "Shanghai" nicht direkt verarbeiten. Solche Texte müssen in Zahlen umgewandelt werden.
| Methode | Beschreibung | Eigenschaften |
|---|---|---|
| Label-Kodierung | Weisen Sie jeder Kategorie eine eindeutige ganze Zahl zu, z. B.,北京:0, 上海:1 |
Einfach, kann aber falsche Ordnungsbeziehungen einführen (das Modell könnte denken, 1>0) |
| One-Hot-Encoding | Erstelle ein neues binäres Merkmal (0 oder 1) für jede Kategorie | Kann Missverständnisse bezüglich der Reihenfolge beseitigen, aber wenn es viele Kategorien gibt, führt es zu einer Explosion der Merkmalsdimension |
Codebeispiel:
Beispiel
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
# Beispieldaten
df_cat = pd.DataFrame({'city': ['Beijing', 'Shanghai', 'Guangzhou', 'Beijing', 'Shenzhen']})
# Label-Kodierung
le = LabelEncoder()
df_cat['city_label_encoding'] = le.fit_transform(df_cat['city'])
print("Ergebnis der Label-Kodierung:")
print(df_cat)
# One-Hot-Encoding
# Methode 1: pandas get_dummies verwenden
df_onehot_pd = pd.get_dummies(df_cat['city'], prefix='city')
print("\nPandas für One-Hot-Encoding verwenden: ")
print(df_onehot_pd)
# Methode 2: OneHotEncoder von sklearn verwenden (wird häufiger in Pipelines verwendet)
ohe = OneHotEncoder(sparse_output=False) # sparse_output=False gibt ein Array statt einer dünnbesetzten Matrix zurück
encoded_array = ohe.fit_transform(df_cat[['city']]) # Beachten Sie, dass die Eingabe 2D sein muss
print("\nOne-Hot-Encoding mit sklearn (Array-Form):")
print(encoded_array)
print("Neuer Feature-Name:", ohe.get_feature_names_out())
3. Feature-Auswahl
Wählen Sie die wichtigste Teilmenge aus allen Merkmalen aus, um Dimensionen zu reduzieren und das Risiko von Overfitting zu verringern.
| Methode | Beschreibung |
|---|---|
| Filter-Methode | Reiht basierend auf der statistischen Korrelation zwischen Merkmalen und Zielvariable ein und filtert (z. B. Varianz, Chi-Quadrat-Test, gegenseitige Information). Unabhängig von jeglichem Modell. |
| Wrapper-Methode | Behandelt die Merkmalsauswahl als Suchproblem, wobei die Modellleistung als Bewertungskriterium dient (z. B. Recursive Feature Elimination, RFE). Bessere Ergebnisse, aber hohe Rechenkosten. |
| Eingebettete Methode | Führt die Merkmalsauswahl automatisch während des Modelltrainings durch (z. B. L1-Regularisierung, LASSO-Regression, Feature-Wichtigkeit von Baummodellen). |
Codebeispiel (Auswahl basierend auf Feature-Wichtigkeit):
Beispiel
from sklearn.ensemble import RandomForestClassifier
import pandas as pd
import matplotlib.pyplot as plt
# Datensatz laden
data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
# Trainiere ein Random-Forest-Modell, das die Feature-Wichtigkeit berechnet
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X, y)
# Feature-Wichtigkeit abrufen
importances = model.feature_importances_
feature_importance_df = pd.DataFrame({
'Feature': data.feature_names,
'Importance': importances
}).sort_values('Importance', ascending=False)
print("Rangfolge der Feature-Wichtigkeit:")
print(feature_importance_df.head(10)) # Zeige die 10 wichtigsten Features an
# Visualisierung
plt.figure(figsize=(10, 6))
plt.barh(feature_importance_df['Feature'][:10], feature_importance_df['Importance'][:10])
plt.xlabel('Feature-Wichtigkeit')
plt.title('Top 10 Feature-Wichtigkeit')
plt.gca().invert_yaxis() # Die wichtigsten oben platzieren
plt.show()
# Angenommen, wir wählen Merkmale mit einer Wichtigkeit größer als 0.03 aus
selected_features = feature_importance_df[feature_importance_df['Importance'] > 0.03]['Feature'].tolist()
print(f"\n" Gefilterte Merkmale: {selected_features}")
III. Praktische Übung: Einen einfachen Datensatz manuell verarbeiten
Aufgabe: Führe grundlegendes Feature-Engineering am berühmten Titanic-Passagierdatensatz durch, um die Vorhersage des Überlebens der Passagiere vorzubereiten.
Schritt-Hinweise:
- Lade die Daten (du kannst verwenden
seabornaus der Bibliothekload_dataset('titanic'))。 - Untersuche die Daten: Überprüfe Merkmalstypen und fehlende Werte.
- Feature-Verarbeitung:
- Fehlende Werte behandeln (z. B. mit Median füllen
age, mit Modalwert füllenembarked)。 - wird
sex(Sex)-Feature unter Verwendung vonLabel-EncodingoderOne-Hot-Encoding。 - Pair
age(Age) unter Verwendung vonBinning, ein neues Altersgruppen-Feature erstellen.
- Fehlende Werte behandeln (z. B. mit Median füllen
- Feature-Konstruktion:
- Kombiniere
sibsp(Anzahl der Geschwister/Ehepartner) undparch(Anzahl der Eltern/Kinder), um ein neuesfamily_size(Familiengröße)-Feature.
- Kombiniere
- Feature-Auswahl:
- Entferne Features, die du für eindeutig irrelevant hältst (z. B.,
passenger_id,name,ticket)。 - Versuchen Sie, die Korrelation zwischen numerischen Merkmalen und dem Überlebensziel zu berechnen, und filtern Sie Merkmale.
- Entferne Features, die du für eindeutig irrelevant hältst (z. B.,
Durch diese Übung erleben Sie aus erster Hand, wie Rohdaten durch schrittweises Feature Engineering für Machine-Learning-Modelle immer "freundlicher" werden.
Zusammenfassung
Feature Engineering ist im Machine Learning ein Handwerk, dasKunst(Domänenwissen, Erfahrung, Intuition) undWissenschaft(statistische Methoden, Algorithmen) vereint. Es gibt keine festen Regeln; es erfordert wiederholtes Ausprobieren und Iterieren auf Basis der konkreten Daten, des Problems und des Modells. Für Anfänger wird die Beherrschung der in diesem Artikel vorgestellten grundlegenden Methoden und fleißiges Üben das stärkste Fundament für den Aufbau effektiver Machine-Learning-Modelle legen. Denken Sie daran,Exzellente Modelle entstehen oft aus exzellenten Merkmalen。
Andere Erweiterungen