Métodos de ensamblaje
En el aprendizaje automático, quizás ya sepas cómo entrenar un árbol de decisión o un modelo de regresión logística; el rendimiento de un solo modelo (al que llamamos aprendiz base) a veces llega a un punto muerto.
En ese momento, surge una poderosa idea:los métodos de ensamblaje, que no dependen de crear un algoritmo completamente nuevo y más complejo, sino de combinar hábilmente varios modelos relativamente simples, incluso de rendimiento mediocre, para construir un supermodelo más potente, estable y preciso.
En pocas palabras, la filosofía central del aprendizaje por ensamblaje es:Tres humildes zapateros pueden más que un Zhuge Liang。
Los métodos de ensamblaje reúnen la sabiduría colectiva de múltiples modelos para compensar el sesgo, la varianza o los errores aleatorios que pueda tener un solo modelo, mejorando así significativamente el rendimiento general de la predicción.
Este artículo te explicará de forma sistemática los principios, las técnicas principales y las prácticas de ingeniería de los métodos de ensamblaje.
Idea básica y ventajas del aprendizaje por ensamblaje
Antes de profundizar en los métodos específicos, primero debemos entender por qué el aprendizaje por ensamblaje es eficaz y qué beneficios puede aportar.
Idea central: reducir el error
El error de predicción de un modelo suele descomponerse en tres partes:Sesgo、VarianzayError irreducible。
- Sesgo: error sistemático causado por suposiciones incorrectas del modelo sobre la naturaleza del problema. Un sesgo alto significa que el modelotiene un ajuste insuficiente (subajuste)y no puede capturar las relaciones básicas de los datos.
- Varianza: grado de sensibilidad del modelo a pequeñas fluctuaciones en los datos de entrenamiento. Una varianza alta significa que el modelotiene sobreajustey presta demasiada atención al ruido en los datos de entrenamiento.
- Error irreducible: ruido aleatorio inherente a los datos que ningún modelo puede eliminar.
El objetivo central de los métodos de ensamblaje es combinar múltiples modelos parareducir la varianza o el sesgo del modelo general, obteniendo así predicciones más robustas (estables) y precisas.
Principales ventajas
- Mejorar la precisión: es el objetivo más directo; en la gran mayoría de los escenarios, el modelo de ensamblaje supera al mejor aprendiz base individual.
- Aumentar la estabilidad y la robustez: mediante el promediado o la votación, el modelo de ensamblaje es menos sensible a los datos ruidosos y a los valores atípicos, reduciendo el riesgo de sobreajuste.
- Ampliar el espacio de hipótesis: combinar varios modelos equivale a explorar un espacio de soluciones más amplio, lo que hace más probable acercarse a la solución óptima del problema.
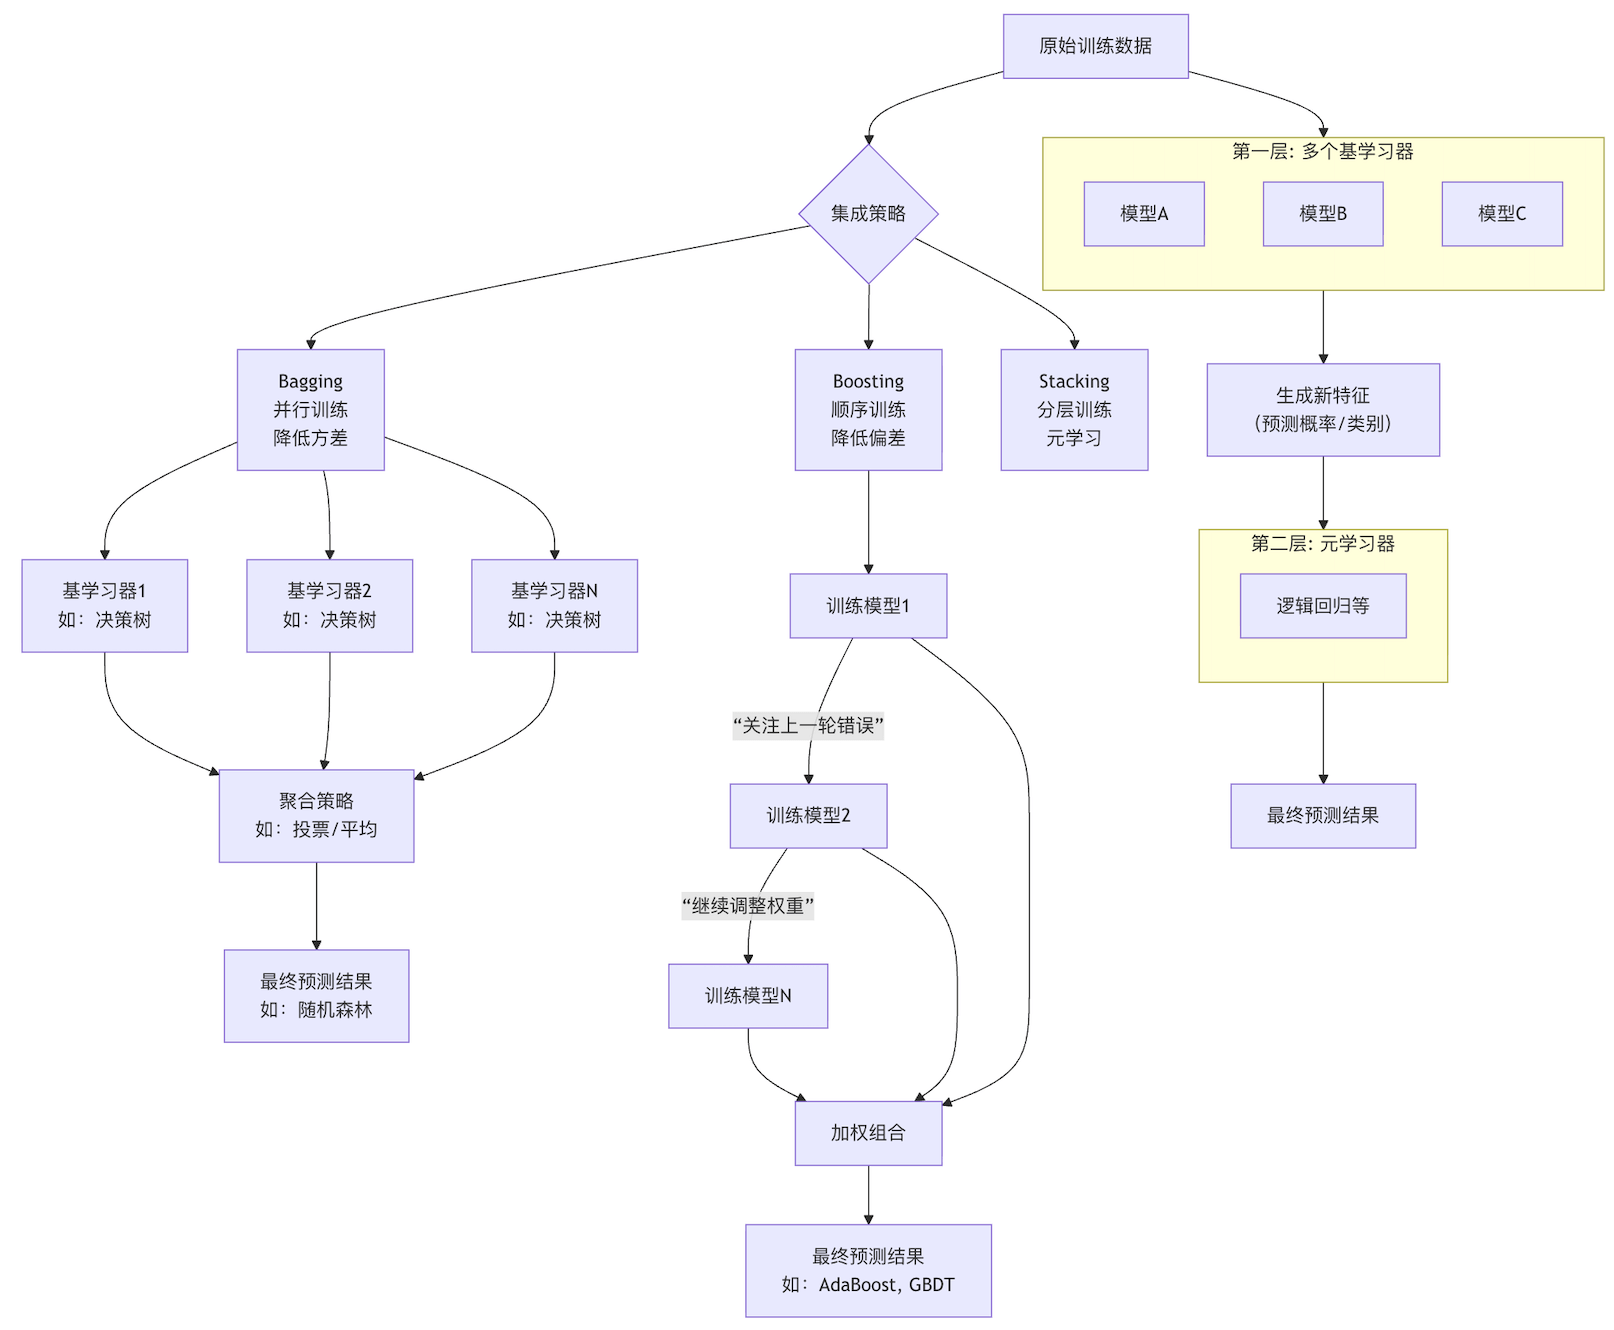
Para entender de forma más intuitiva cómo funcionan los métodos de ensamblaje al combinar múltiples modelos, podemos ver el siguiente diagrama de flujo:
Explicación detallada de los métodos de ensamblaje más populares
Según la forma de generar los aprendices base y la estrategia de combinación, los métodos de ensamblaje se dividen principalmente en tres categorías:Bagging、BoostingyStacking。
Bagging: el camino paralelo, la estabilidad ante todo
BaggingSu idea central es:Bootstrap Aggregating。
- Bootstrap: realizar un muestreo aleatoriocon reemplazodel conjunto de entrenamiento original, generando múltiples subconjuntos de entrenamiento diferentes. El tamaño de cada subconjunto puede ser igual al del conjunto original, pero, debido al reemplazo, algunas muestras se extraen repetidas y otras no se extraen.
- Entrenamiento paralelo: utilizando el mismo algoritmo de aprendizaje (normalmente un modelo de alta varianza y bajo sesgo, como un árbol de decisión sin podar), se entrena un aprendiz base de forma independiente en cada subconjunto.
- Aggregating: para tareas de clasificación, se utilizael método de votación(gana la mayoría) para decidir la clase final; para tareas de regresión, se utilizael método del promediopara calcular el valor final.
Algoritmo representativo: Random ForestRandom Forest es un destacado representante de la idea de Bagging y va un paso más allá: al dividir un nodo en cada árbol de decisión, no solo muestrea aleatoriamente las muestras, sino que tambiénselecciona aleatoriamente un subconjunto de característicaspara realizar la mejor partición. Esta "doble aleatoriedad" aumenta aún más la diversidad del modelo y su capacidad para resistir el sobreajuste.
Ejemplo
from sklearn.ensemble import RandomForestClassifier
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Cargar los datos
iris = load_iris()
X, y = iris.data, iris.target
# Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el clasificador Random Forest
# n_estimators: número de árboles en el bosque, cantidad de aprendices base
# max_depth: profundidad máxima del árbol, controla la complejidad del modelo
# random_state: semilla aleatoria, garantiza la reproducibilidad de los resultados
rf_clf = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Entrenar el modelo
rf_clf.fit(X_train, y_train)
# Predecir y evaluar
y_pred = rf_clf.predict(X_test)
print(f"Precisión de Random Forest: {accuracy_score(y_test, y_pred):.4f}")
# Ver la profundidad de un solo árbol (ejemplo)
print(f"Profundidad del primer árbol: {rf_clf.estimators_)
Boosting: la sabiduría secuencial, centrado en corregir errores
Boostingadopta una estrategia completamente diferente.
- Entrenamiento secuencial: los aprendices base se entrenande forma sucesiva, no en paralelo.
- Enfoque en los errores: cada modelo posterior presta más atención a las muestras que los modelos anteriorespredijeron incorrectamente.. Normalmente se logra ajustando los pesos de las muestras de entrenamiento (dando mayor peso a las muestras mal clasificadas).
- Combinación ponderada: se realiza unasuma ponderadade todos los aprendices base para obtener el modelo final; los aprendices base con mejor rendimiento tienen mayor peso.
El núcleo de Boosting es corregir continuamente los errores de los modelos anteriores, elevando un grupo de "aprendices débiles" (apenas mejores que una suposición aleatoria) a un potente "aprendiz fuerte".
Algoritmos representativos: AdaBoost y Gradient Boosting Decision Tree
- AdaBoost: uno de los primeros algoritmos de Boosting. Aumenta el peso de las muestras mal clasificadas para obligar a los modelos posteriores a centrarse en esas muestras "difíciles".
- Gradient Boosting Decision Tree: actualmente uno de los algoritmos de Boosting más populares y potentes. Ya no ajusta los pesos de las muestras, sino que considera el proceso de entrenamiento como undescenso de gradientede optimización. El objetivo de cada árbol nuevo es ajustar elresiduo(gradiente negativo).
Ejemplo
from sklearn.ensemble import GradientBoostingClassifier
# Crear el clasificador de Gradient Boosting
# n_estimators: número de etapas de boosting (número de árboles)
# learning_rate: tasa de aprendizaje, controla la contribución de cada árbol al resultado final (coeficiente de contracción)
# max_depth: profundidad máxima de cada árbol de regresión, normalmente pequeña (3-5), representa a un aprendiz débil
gb_clf = GradientBoostingClassifier(n_estimators=100, learning_rate=0.1, max_depth=3, random_state=42)
# Entrenar el modelo
gb_clf.fit(X_train, y_train)
# Predecir y evaluar
y_pred_gb = gb_clf.predict(X_test)
print(f"Precisión de Gradient Boosting: {accuracy_score(y_test, y_pred_gb):.4f}")
# Ver la importancia de las características (normalmente disponible en los métodos de ensamblaje)
print("Importancia de las características:", gb_clf.feature_importances_)
Salida:
随机森林准确率: 1.0000
第一棵树的深度: 4
Stacking: apilamiento de modelos, estrategia de metaaprendizaje
Stackinges una técnica de ensamblaje más avanzada que introduce el concepto de "metaaprendiz".
- Primera capa: aprendices base diversificados. Se utilizandiferentesalgoritmos de aprendizaje (como KNN, SVM, árboles de decisión) para entrenar múltiples modelos sobre los datos originales.
- Generar nuevas características: con estos modelos de la primera capa se predice sobre los datos de entrenamiento (normalmente usando validación cruzada para evitar la fuga de datos), y sus predicciones (etiquetas de clase o probabilidades) se utilizan comonuevas características。
- Segunda capa: entrenar el metaaprendiz. Usando estas nuevas características como entrada y las etiquetas originales como salida, se entrena un modelo final (como regresión logística o regresión lineal). Este metaaprendiz se encarga de aprender la mejor manera de combinar las salidas de los modelos de la primera capa.
El potencial de Stacking es enorme, pero su coste computacional es alto y requiere un diseño cuidadoso para evitar el sobreajuste.
Comparación de métodos y recomendaciones para la práctica en ingeniería
Tras conocer los principios, ¿cómo elegir y aplicar estos métodos en proyectos reales?
Comparación de los tres métodos principales
| Característica | Bagging (p. ej., Random Forest) | Boosting (p. ej., GBDT, XGBoost) | Stacking |
|---|---|---|---|
| Objetivo principal | Reducir la varianza, prevenir el sobreajuste | Reducir el sesgo, mejorar el poder predictivo | Optimizar la estrategia de combinación |
| Método de entrenamiento | Paralelo, entrenamiento independiente | En serie, depende del resultado de la ronda anterior | Jerárquico, primero el aprendiz base y luego el meta-aprendiz |
| Peso de las muestras | Trato igualitario, muestreo bootstrap | Ajuste dinámico, prestando atención a los errores | Generalmente igualitario |
| Relación entre aprendices base | Mutuamente independientes, la diversidad proviene de la perturbación de los datos | Mutuamente dependientes, optimizan un objetivo común | Mutuamente independientes, la diversidad proviene de la diferencia de algoritmos |
| Ventajas | Estable, resistente al sobreajuste, fácil de paralelizar | La precisión de predicción suele ser muy alta | En teoría puede lograr el mejor rendimiento |
| Desventajas | La reducción del sesgo es limitada y consume muchos recursos computacionales | Sensible al ruido, propenso al sobreajuste, ajuste de hiperparámetros complejo | Coste computacional extremadamente alto, estructura compleja, propenso al sobreajuste |
| Aplicaciones típicas | Random Forest, Extra-Trees | AdaBoost, GBDT, XGBoost, LightGBM, CatBoost | Común en competiciones de aprendizaje automático |
Guía de práctica en ingeniería
Modelo de referencia preferido: No empieces usando métodos de conjunto complejos. Primero usa un modelo simple (como regresión logística o un árbol de decisión único) para establecer una línea base de rendimiento.
Elige según el problema:
- Si tu modelo base (como un árbol de decisión muy profundo)tiene un sobreajuste severo (alta varianza), prueba primeroBagging(Random Forest).
- Si tu modelo basetiene un bajo ajuste (alto sesgo), o buscas una precisión de predicción extremadamente alta, prueba primeroBoosting(como XGBoost, LightGBM).
- EnCompeticiones de aprendizaje automáticoo escenarios con requisitos extremos de precisión y recursos computacionales suficientes, puedes considerarStackingoBlending。
usar bibliotecas modernas y optimizadas: En la práctica, usa directamente bibliotecas altamente optimizadas que implementan los algoritmos de conjunto más avanzados:
- Scikit-learn: proporciona
RandomForest,GradientBoostingimplementaciones excelentes, adecuadas para principiantes y desarrollo rápido de prototipos. - XGBoost: rápido, preciso y completo, es un ganador frecuente en competiciones de Kaggle.
- LightGBM: lanzado por Microsoft, entrena más rápido, consume menos memoria, especialmente adecuado para grandes conjuntos de datos.
- CatBoost: lanzado por Yandex, maneja bien las características categóricas y funciona bien con los parámetros predeterminados.
Presta atención al ajuste de hiperparámetros: Los modelos de conjunto tienen muchos hiperparámetros. Los parámetros clave incluyen:
n_estimators: número de aprendices base (cuantos más, mejor, pero aumenta el coste computacional).learning_rate(Boosting): tasa de aprendizaje, controla la contribución de cada paso. Generalmente deben_estimatorscompensarse (una tasa de aprendizaje pequeña requiere más árboles).max_depth(métodos de árbol): clave para controlar la complejidad del modelo y el sobreajuste.- Usavalidación cruzadaybúsqueda en cuadrícula / búsqueda aleatoriapara ajustar los parámetros sistemáticamente.