Grundstruktur neuronaler Netze
In der Welle der künstlichen Intelligenz ist Deep Learning zweifellos der strahlendste Stern, und den Kern des Deep Learning bilden genauneuronale Netzwerke. Es ahmt die Arbeitsweise von Neuronen im menschlichen Gehirn nach und verleiht Maschinen durch schichtweise Verbindungen und Berechnungen die Fähigkeit zu lernen und wahrzunehmen.
Für Anfänger ist das Verständnis der grundlegenden Struktur neuronaler Netzwerke der erste Schlüssel, um die Tür zum Deep Learning zu öffnen.
Dieser Artikel führt Sie von Grund auf, zerlegt die Bestandteile neuronaler Netzwerke Schritt für Schritt und verwendet anschauliche Analogien und klaren Code, um Ihnen zu helfen, ihre Funktionsweise gründlich zu beherrschen.
Was ist ein neuronales Netzwerk? Eine anschauliche Analogie
Stellen Sie sich vor, Sie bringen einem Kind, das noch nie Katzen und Hunde gesehen hat, bei, sie zu unterscheiden. Was würden Sie tun?
- Sie könnten ihm zunächst viele Bilder von Katzen und Hunden zeigen.
- Sie würden auf Merkmale hinweisen: Schau, die Ohren von Katzen sind normalerweise spitz und ihre Gesichter relativ rund; die Ohren von Hunden können herabhängen und ihre Gesichter sind länger.
- Das Gehirn des Kindes (das neuronale Netzwerk) wird diese Bilder (Eingabedaten) und Ihre Anleitung (Labels) erhalten.
- Die Neuronen in seinem Gehirn werden anfangen zu arbeiten und versuchen, Schlüsselmuster zu finden, die Katzen von Hunden unterscheiden (wie Ohrenform und Gesichtsform).
- Nach mehreren Korrekturen und Lernprozessen bildet sich ein Beurteilungsmodell in seinem Gehirn. Wenn er das nächste Mal ein neues Tierbild sieht, kann er zuversichtlich sagen, ob es eine Katze oder ein Hund ist.
Ein neuronales Netzwerk ist ein vereinfachtes mathematisches Modell des Gehirns dieses Kindes,Es ist ein Netzwerksystem, das aus einer großen Anzahl vonkünstlichen Neuronenbesteht, die miteinander verbunden sind und automatisch Merkmale und Muster aus Eingabedaten lernen können und für Vorhersagen oder Entscheidungen verwendet werden können.

Grundlegende Bausteine neuronaler Netzwerke: Neuronen
Ein Neuron ist die grundlegendste Recheneinheit eines neuronalen Netzwerks. Es simuliert denSignalempfang → Signalverarbeitung → SignalübertragungProzess eines biologischen Neurons.
Der Arbeitsablauf eines Neurons
Ein typisches künstliches Neuron macht hauptsächlich drei Dinge:
Beispiel
def artificial_neuron(inputs, weights, bias):
"""
Simulieren Sie den Berechnungsprozess eines künstlichen Neurons.
Parameter:
inputs: Liste der Eingangssignale, z. B. [x1, x2, x3]
weights: Liste der Gewichte, die jedem Eingang entsprechen, z. B. [w1, w2, w3]
bias: Bias-Term, eine Konstante
Rückgabe:
output: die Ausgabe des Neurons
"""
# 1. Gewichtete Summe: Multipliziere jeden Eingang mit seinem entsprechenden Gewicht und addiere dann den Bias
weighted_sum = 0
for i in range(len(inputs)):
weighted_sum += inputs[i] * weights[i]
weighted_sum += bias
# 2. Verarbeitung durch die Aktivierungsfunktion: Durch eine nichtlineare Funktion wird entschieden, ob das Signal "aktiviert" und ausgegeben wird
output = activation_function(weighted_sum)
return output
Verwenden wir ein Diagramm und eine Tabelle, um es intuitiver zu verstehen:
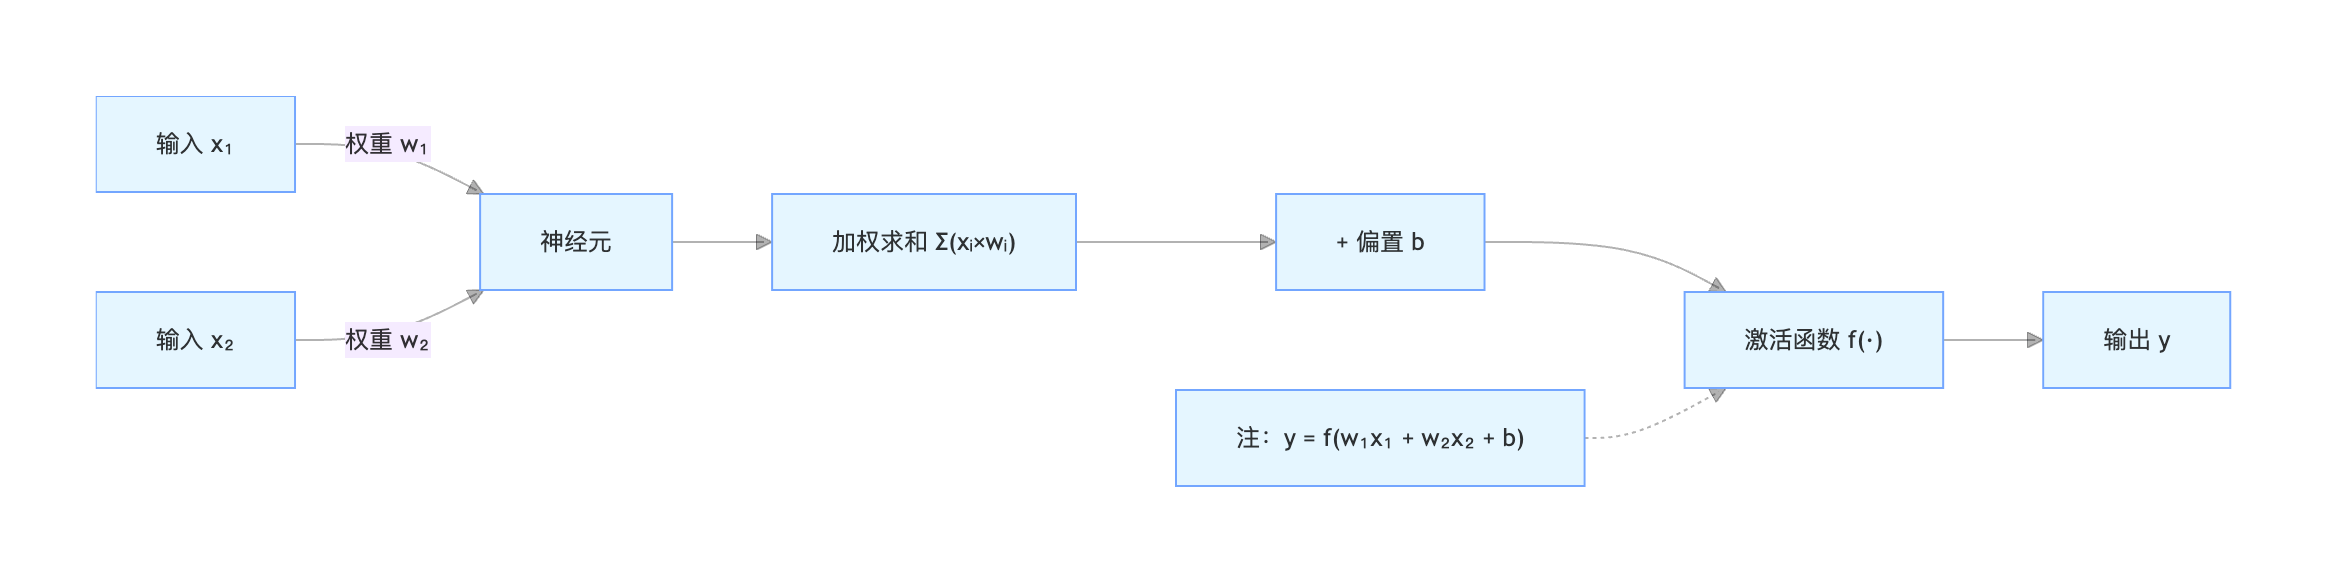
Detaillierte Erklärung der Funktionen jeder Neuronenkomponente:
| Komponente | Analogie | Mathematischer Ausdruck | Funktion |
|---|---|---|---|
| Eingabe \(x\) | Signal von anderen Neuronen | \( x_1, x_2, ..., x_n \) | Empfängt externe Informationen oder die Ausgabe der Neuronen der vorherigen Schicht. |
| Gewicht \(w\) | Bedeutung des Signals | \(w_1, w_2, ..., w_n\) | Bestimmt den Grad, in dem jede Eingabe die Ausgabe des Neurons beeinflusst.Der Lernprozess ist der Prozess der kontinuierlichen Anpassung dieser Gewichte. |
| Bias \(b\) | Aktivierungsschwelle eines Neurons | \(b\) | Eine Konstante, mit der angepasst wird, wie leicht das Neuron aktiviert wird. Sie kann so verstanden werden, dass die gewichtete Summe als Ganzes nach oben oder unten verschoben wird. |
| Gewichtete Summe \(z\) | Gesamtsignalstärke | \(z = (x_1w_1 + x_2w_2 + ... + x_nw_n) + b\) | Synthetisiert alle Eingangssignale. |
| Aktivierungsfunktion \(f\) | Schalter und Prozessor | \(a = f(z)\) | FührtNichtlinearitätein. Ohne sie würde ein mehrschichtiges Netzwerk zu einem einschichtigen Netzwerk degenerieren und könnte keine komplexen Muster lernen. |
Gängige Aktivierungsfunktionen
Aktivierungsfunktionen verleihen neuronalen Netzen Nichtlinearität. Hier sind die drei am häufigsten verwendeten:
Sigmoid
- Formel:\(f(z) = \frac{1}{1 + e^{-z}}\)
- Eigenschaften: Komprimiert die Eingabe auf einen Wert im Intervall (0, 1). Wird häufig in der Ausgabeschicht von binären Klassifikationsproblemen verwendet. Neigt dazu, das Problem des verschwindenden Gradienten zu verursachen.
- Bild: Eine glatte S-förmige Kurve.
ReLU (Rectified Linear Unit)
- Formel:\(f(z) = max(0, z)\)
- Eigenschaften: Einfach zu berechnen, mildert effektiv das Problem des verschwindenden Gradienten und ist derzeit die am häufigsten verwendete Aktivierungsfunktion für versteckte Schichten.
- Bild: Eine geknickte Linie, die am Ursprung abknickt; gibt für negative Zahlen 0 aus und für positive Zahlen den ursprünglichen Wert aus.
Softmax
- Formel:\(f(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}\)
- Eigenschaften: Wandelt die Ausgaben mehrerer Neuronen in eine Wahrscheinlichkeitsverteilung um (die Summe aller Ausgaben ist 1).Wird speziell für die Ausgabeschicht von Mehrklassen-Klassifikationsproblemen verwendet.。
Die hierarchische Struktur neuronaler Netze
Ein einzelnes Neuron hat nur begrenzte Fähigkeiten, so wie eine einzelne Gehirnzelle nicht denken kann. Wenn wir eine große Anzahl von Neuronen in Schichten organisieren, entsteht ein leistungsfähiges neuronales Netz. Ein typisches neuronales Netz enthält die folgenden drei Schichten:
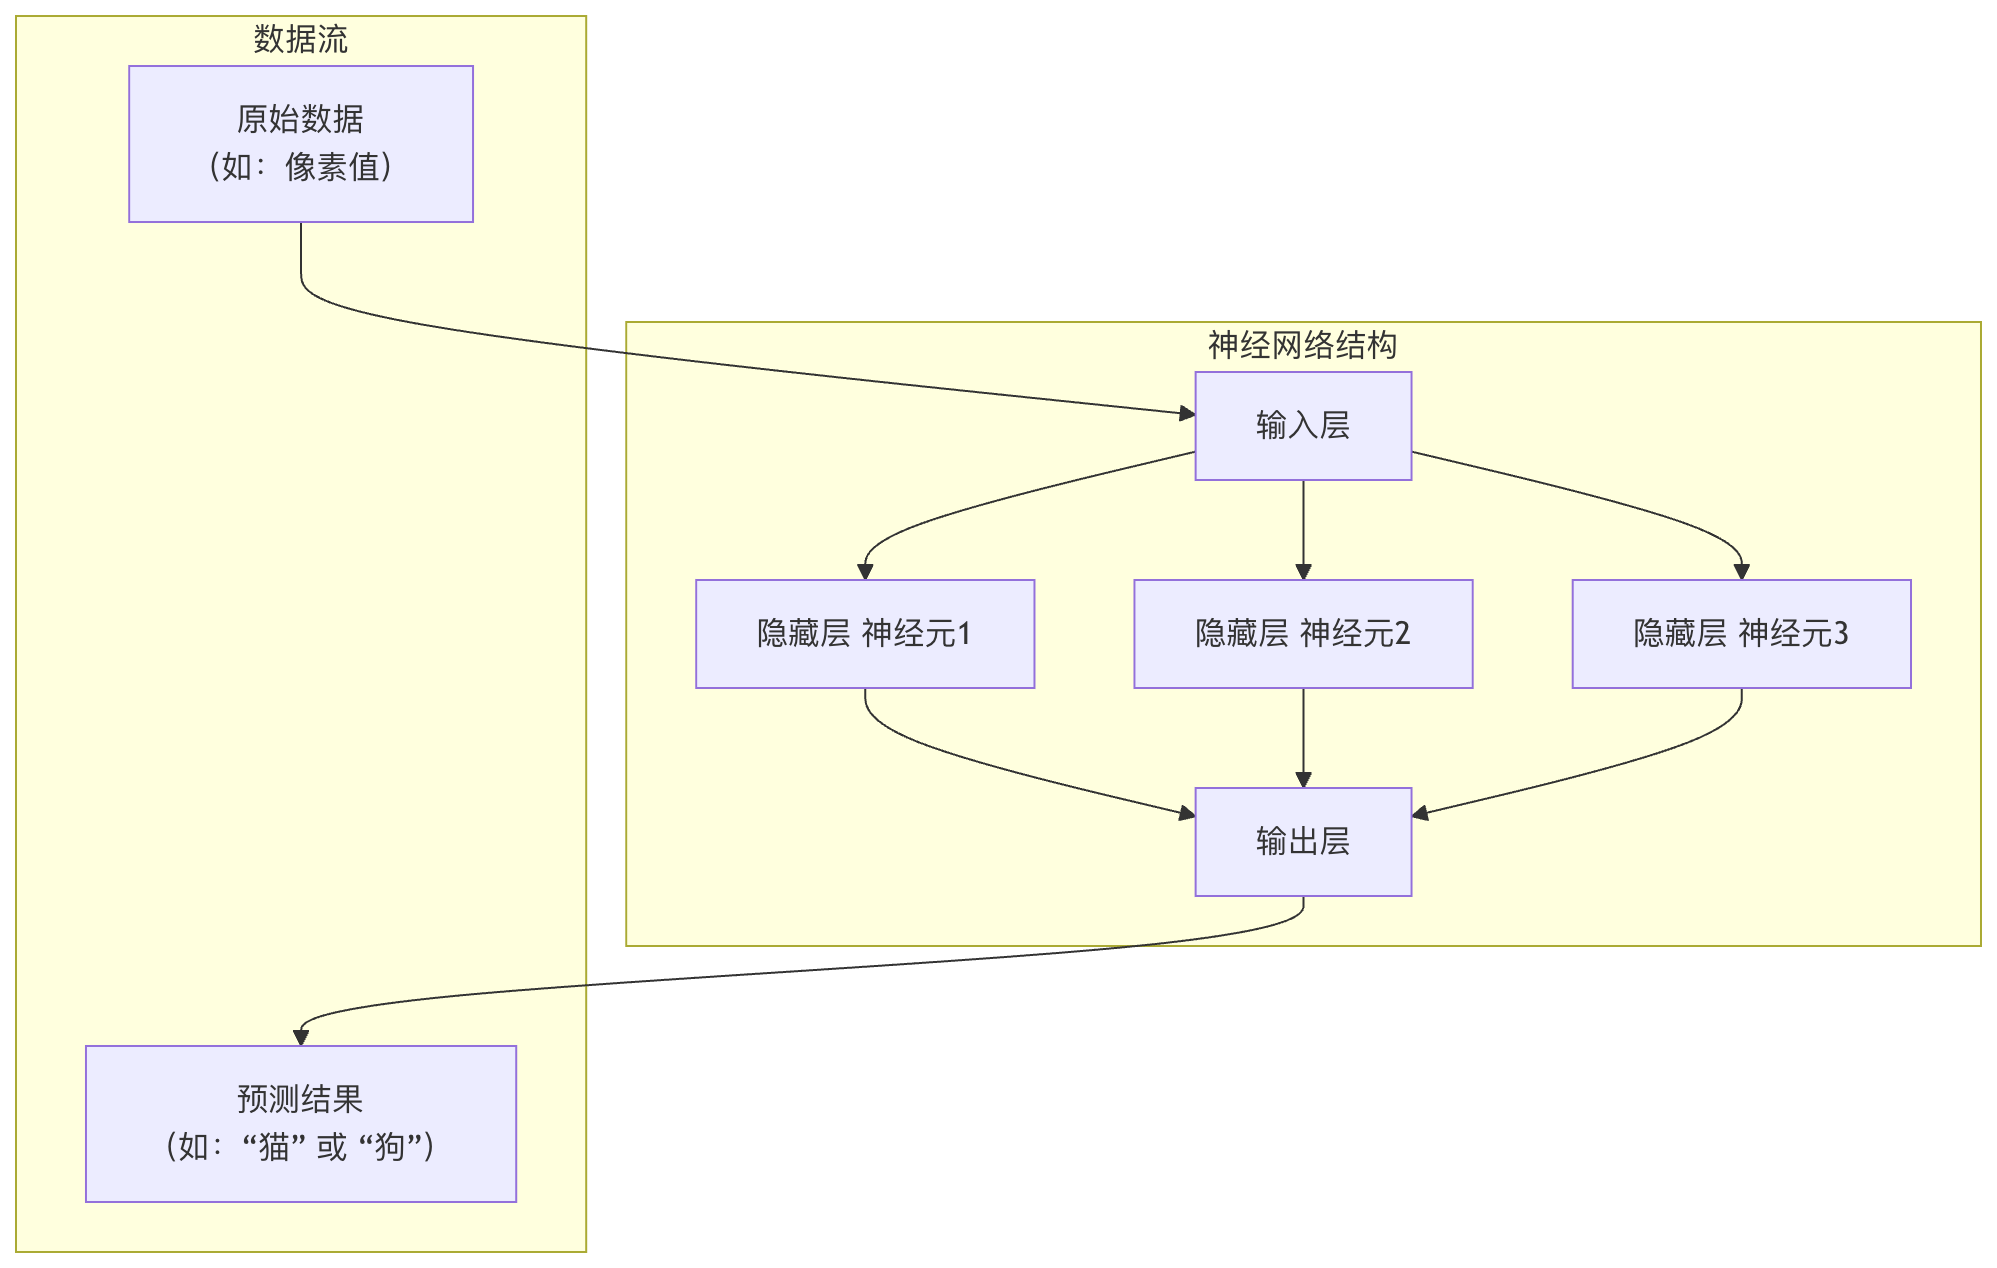
1. Eingabeschicht
- Rolle: Die Sinne des Netzes, verantwortlich für das Empfangen von Rohdaten.
- Eigenschaften: Die Anzahl der Neuronen in dieser Schicht entspricht normalerweise der Anzahl der Merkmale in den Eingabedaten. Beispielsweise wird ein 28x28 Pixel großes Graustufenbild zu 784 Merkmalen abgeflacht, was 784 Eingabeneuronen entspricht.Die Eingabeschicht führt keine Berechnung durch, sie leitet nur Daten weiter.
2. Verdeckte Schicht
Rolle: Das Gehirn des Netzes, verantwortlich für komplexe Merkmalsextraktion und -transformation.
Eigenschaften:
- Liegt zwischen der Eingabeschicht und der Ausgabeschicht und kann eine oder mehrere Schichten haben (daher hat Deep Learning seinen Namen).
- Die Neuronen jeder Schicht erhalten die Ausgaben aller Neuronen der vorherigen Schicht als Eingabe, berechnen ihre eigenen Ausgaben und geben sie an die nächste Schicht weiter (dies wird als Vollverbindung bezeichnet).
- Neuronen in der verdeckten Schicht verwenden Aktivierungsfunktionen wie ReLU, um Nichtlinearität einzuführen.
3. Ausgabeschicht
Rolle: Der Entscheidungsträger des Netzwerks, der das endgültige Vorhersageergebnis ausgibt.
Eigenschaften: Die Anzahl der Neuronen wird durch die Aufgabe bestimmt.
- Binäre Klassifikation: 1 Neuron (mit Sigmoid) oder 2 Neuronen (mit Softmax).
- Multiklassenklassifikation (K Klassen): K Neuronen (mit Softmax).
- Regression(Vorhersage eines kontinuierlichen Werts): 1 Neuron (normalerweise ohne Aktivierungsfunktion).
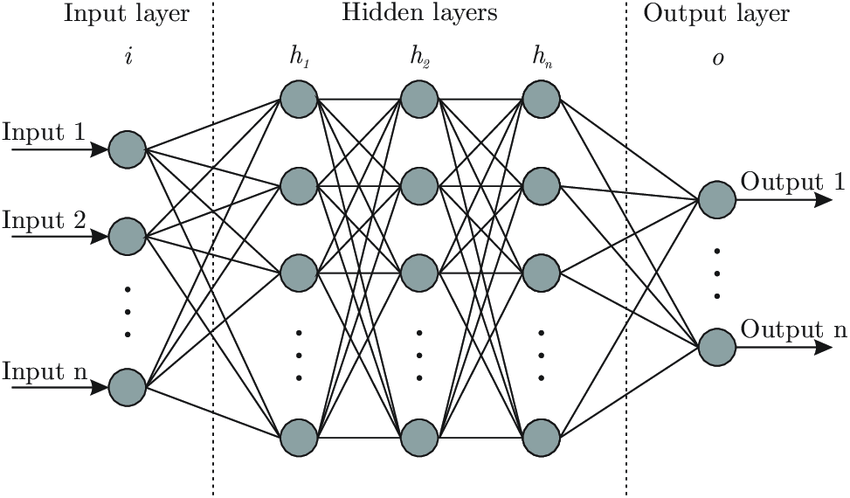
Demo-Diagramm:
Praktische Übung: Ein neuronales Netz mit Python erstellen
Egal, wie viel Theorie man auch bespricht, es ist besser, zu üben. Im Folgenden verwenden wirNumPyeine Bibliothek, um das einfachste dreischichtige neuronale Netz (1 verborgene Schicht) von Grund auf zu erstellen und eine Vorwärtspropagationsberechnung durchzuführen.
Beispiel
"""Sigmoid-Aktivierungsfunktion"""
def sigmoid(x):
"""ReLU-Aktivierungsfunktion"""
return 1 / (1 + np.exp(-x))
def relu(x):
# Ein einfaches neuronales Netz initialisieren
return np.maximum(0, x)
Netzwerkgewichte und Bias-Werte initialisieren.
def initialize_network(input_size, hidden_size, output_size):
"""
Parameter:
input_size: Anzahl der Neuronen in der Eingabeschicht
hidden_size: Anzahl der Neuronen in der versteckten Schicht
output_size: Anzahl der Neuronen in der Ausgabeschicht
Rückgabe:
network: Wörterbuch mit Parametern für jede Schicht
# Zufallsstartwert festlegen, um konsistente Ergebnisse bei jedem Durchlauf zu gewährleisten
"""
np.random.seed(42) # Parameter für Eingabeschicht -> versteckte Schicht initialisieren
network = {}
# Form der Gewichtsmatrix: (Anzahl der Neuronen in der nächsten Schicht, Anzahl der Neuronen in der vorherigen Schicht)
# Der Bias ist ein Spaltenvektor
network['W1'] = np.random.randn(hidden_size, input_size) * 0.01
network['b1'] = np.zeros((hidden_size, 1)) # Parameter für versteckte Schicht -> Ausgabeschicht initialisieren
# Funktion zur Vorwärtspropagation
network['W2'] = np.random.randn(output_size, hidden_size) * 0.01
network['b2'] = np.zeros((output_size, 1))
return network
Führe eine Vorwärtspropagation durch, um die Netzwerkausgabe zu berechnen.
def forward_propagation(network, X):
"""
Parameter:
network: Dictionary, das Gewichte und Bias-Werte enthält
X: Eingabedaten, Form (Anzahl der Merkmale, Anzahl der Stichproben)
Rückgabe:
y_pred: Ausgabe der Netzwerkvorhersage
cache: zwischengespeicherte Zwischenergebnisse (für die anschließende Backpropagation)
# Parameter abrufen
"""
# Parameter abrufen
W1, b1, W2, b2 = network['W1'], network['b1'], network['W2'], network['b2']
# Berechnung von Schicht 1: Eingabeschicht -> verborgene Schicht
Z1 = np.dot(W1, X) + b1 # Gewichtete Summe
A1 = relu(Z1) # Durch die ReLU-Aktivierungsfunktion
# Berechnung von Schicht 2: verborgene Schicht -> Ausgabeschicht
Z2 = np.dot(W2, A1) + b2 # Gewichtete Summe
A2 = sigmoid(Z2) # Durch die Sigmoid-Aktivierungsfunktion (unter Annahme einer binären Klassifikation)
# Zwischenergebnisse für die Verwendung in der Backpropagation zwischenspeichern
cache = {'Z1': Z1, 'A1': A1, 'Z2': Z2, 'A2': A2}
return A2, cache
# --- Lass es uns ausführen! ---
# 1. Netzwerkstruktur definieren: 2 Eingabemerkmale, 3 versteckte Neuronen, 1 Ausgabe (binäre Klassifikation)
input_size = 2
hidden_size = 3
output_size = 1
# 2. Das Netzwerk initialisieren
my_network = initialize_network(input_size, hidden_size, output_size)
print("Form der Gewichte W1 (versteckte Schicht x Eingabeschicht):", my_network['W1'].shape)
print("Form des Bias b1:", my_network['b1'].shape)
print("Form der Gewichte W2 (Ausgabeschicht x versteckte Schicht):", my_network['W2'].shape)
# 3. Beispieleingabedaten erstellen (2 Merkmale, 1 Beispiel)
# In X repräsentieren Spalten Beispiele, Zeilen Merkmale
X_sample = np.array([[1.5], [-0.5]]) # Form (2, 1)
print("\nEingabedaten X:", X_sample.T) # .T wird zum Transponieren für einfacheres Drucken verwendet
# 4. Vorwärtspropagierung durchführen
y_pred, cache = forward_propagation(my_network, X_sample)
print("\nVorhergesagte Ausgabe des neuronalen Netzwerks (A2):", y_pred)
# Wenn die Ausgabe > 0.5 ist, betrachten wir sie als Klasse 1, andernfalls als Klasse 0
predicted_class = 1 if y_pred > 0.5 else 0
print(f"Vorhergesagte Klasse: {predicted_class}")
Code-Erklärung und Analyse der Ausgabe:
Initialisierung: Wir haben eine 2-3-1-Netzwerkstruktur erstellt.W1Es ist eine 3x2-Matrix, die die Verbindungsgewichte von 2 Eingaben zu 3 verborgenen Neuronen darstellt.
Vorwärtspropagierung:
- Eingabe
[1.5, -0.5]zuerst mitW1multipliziert und addiert zub1, was die gewichtete Summe der verborgenen Schicht ergibtZ1。 Z1Nach der ReLU-Funktion erhält man die Aktivierungswerte der verborgenen SchichtA1。A1Dann mitW2multipliziert und addiert zub2, was die gewichtete Summe der Ausgabeschicht ergibtZ2。Z2Schließlich wird sie durch die Sigmoid-Funktion auf (0,1) als endgültige vorhergesagte Wahrscheinlichkeit komprimiertA2。
Ausgabe: Da die Gewichte zufällig initialisiert werden, ist die vorhergesagte Ausgabe dieses untrainierten NetzwerksA2auch ein Zufallswert (nahe 0.5).Das Ziel des Trainierens eines neuronalen Netzwerks ist es, mithilfe großer Datenmengen wiederholt anzupassen,W1, b1, W2, b2, sodassA2es sinnvolle Vorhersagen für verschiedene Eingaben erzeugen kann.
Zusammenfassung der Kernkonzepte und des Lernpfads
In diesem Artikel haben Sie die Grundpfeiler neuronaler Netzwerke gemeistert:
| Konzept | Kernpunkte |
|---|---|
| Neuron | Eine Recheneinheit, die ausführtWeighted sum -> Add bias -> Activation function。 |
| Gewichte und Bias | Kernparameter, die das Modell lernen muss; sie bestimmen das Verhalten des Netzwerks. |
| Aktivierungsfunktion | Führt Nichtlinearität ein (z. B. ReLU, Sigmoid) und ermöglicht dem Netzwerk, komplexe Beziehungen zu lernen. |
| Netzwerkschichten | Eingabeschicht(empfängt Daten),verdeckte Schicht(Merkmalsextraktion),Ausgabeschicht(erzeugt Vorhersagen). |
| Vorwärtspropagation | Der Prozess, bei dem Daten von der Eingabeschicht zur Ausgabeschicht fließen, um vorhergesagte Werte zu berechnen. |
Ihre nächsten Lernschritte:
- Verlustfunktion: Wie quantifiziert man, wie gut das Netzwerk vorhersagt (z. B. mittlerer quadratischer Fehler, Kreuzentropieverlust)?
- Backpropagation und Gradientenabstieg: Wie passt ein neuronales Netz Gewichte und Bias-Werte automatisch an, basierend auf dem Ausmaß der "Schlechtigkeit" (das ist die Essenz des Lernens)?
- Praxis mit Frameworks: Verwenden Sie
TensorFlowoderPyTorchund andere moderne Frameworks können Sie ganz einfach komplexere Netzwerke erstellen und trainieren, ohne von Grund auf neu zu schreibenNumPyCode.
Sobald Sie die Grundstruktur verstanden haben, werden Sie feststellen, dass alle komplexen Deep-Learning-Modelle (wie CNN für Bilder, RNN für Sprache) aus dieser Grundstruktur hervorgehen, indem sie die Verbindungsmuster der Neuronen und Schichtfunktionen ändern. Jetzt haben Sie eine Karte, um die weite Welt des Deep Learning weiter zu erkunden.
Andere Erweiterungen