Deep Reinforcement Learning
Deep Reinforcement Learning ist eine spannende interdisziplinäre Richtung im Bereich der künstlichen Intelligenz. Wir können es in zwei Teile aufteilen, um es zu verstehen:
Reinforcement Learningist die Kernidee, die den Prozess simuliert, in dem Menschen oder Tiere durch „Versuch und Irrtum“ lernen. Stellen Sie sich vor, Sie bringen einem Welpen ein neues Kommando bei: Wenn er es richtig macht, geben Sie ihm ein Leckerli als Belohnung; wenn er es falsch macht, gibt es keine Belohnung oder sogar eine leichte Bestrafung. Nach vielen Versuchen kann der Welpe lernen, in einer bestimmten Situation die richtige Aktion auszuführen, um Belohnungen zu erhalten. Der Agent im Reinforcement Learning ist wie dieser Welpe; er interagiert mit der Umgebung und passt seine Verhaltensstrategie basierend auf den Belohnungen an, die er erhält.
Deep Learningist ein leistungsstarkes Werkzeug. Wenn die Umgebung, mit der das Reinforcement Learning konfrontiert ist, sehr komplex ist (z. B. Videospielbildschirme, Robotersensordaten), ist es für traditionelle mathematische Methoden schwierig, direkt nützliche Merkmale daraus für die Entscheidungsfindung zu extrahieren. Deep Learning, insbesondere tiefe neuronale Netze, zeichnet sich durch die Verarbeitung solcher hochdimensionalen, komplexen Rohdaten (wie Bilder, Ton) aus und kann automatisch hierarchische Merkmalsrepräsentationen der Daten erlernen.
Daher,Deep Reinforcement Learning = Entscheidungsfindungsrahmen des Reinforcement Learning + Wahrnehmungs- und Repräsentationsfähigkeiten des Deep Learning. Es ermöglicht Agenten, direkt zu lernen, wie sie aus komplexen Rohdaten (wie Pixeln) optimale Aktionen auswählen, um langfristige Ziele zu erreichen.
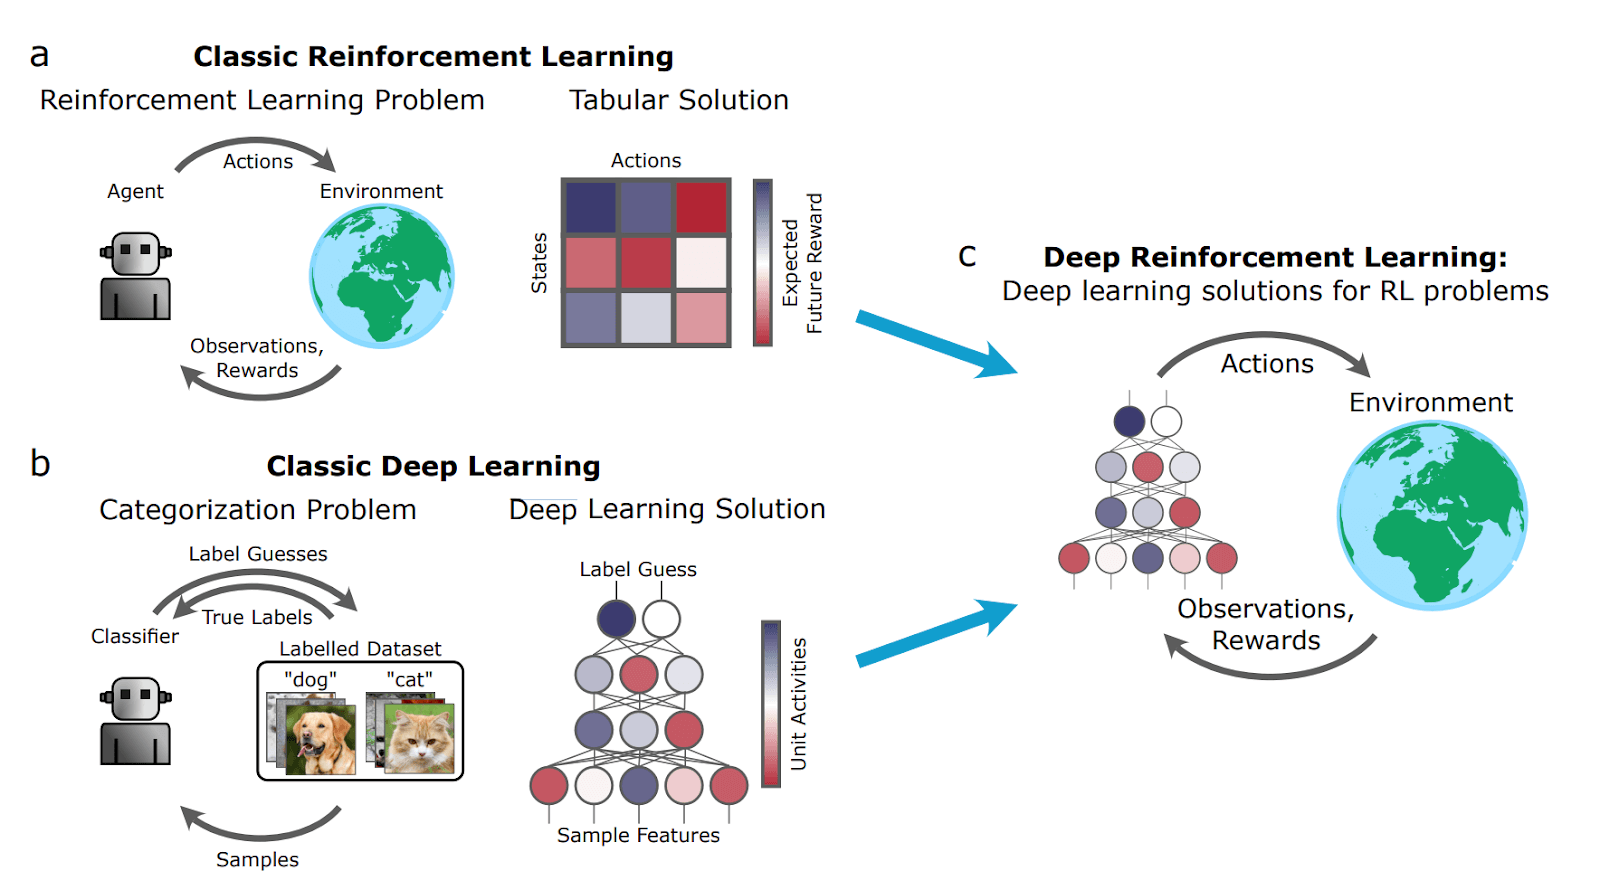
Kernkonzepte und grundlegendes Framework
Um Deep Reinforcement Learning zu verstehen, muss man zunächst mehrere zentrale Rollen in seinem grundlegenden Framework und die Beziehungen zwischen ihnen erfassen.
Grundlegende Elemente des Reinforcement Learning
Agent
- Rolle: Lernender und Entscheidungsträger.
- Verantwortung: Den Zustand der Umgebung beobachten, Aktionen gemäß der erlernten Policy auswählen, Aktionen ausführen und Feedback (neuer Zustand und Belohnung) von der Umgebung erhalten.
Umgebung
- Rolle: Alles Äußere, mit dem der Agent interagiert.
- Verantwortung: Die Aktion des Agenten empfangen, seinen eigenen Zustand aktualisieren und die entsprechende Belohnung bereitstellen.
Zustand (s)
- Definition: Eine Beschreibung der spezifischen Situation der Umgebung zu einem bestimmten Zeitpunkt. Im Deep Reinforcement Learning sind Zustände üblicherweise hochdimensional, wie ein Frame eines Spielbilds.
Aktion (a)
- Definition: Auswahlmöglichkeiten, die der Agent in einem gegebenen Zustand hat. In einem Spiel könnten sie beispielsweise "up", "left", "fire" usw. sein.
Belohnung (r)
- Definition: Ein unmittelbares Rückmeldesignal der Umgebung auf die Aktion des Agenten, ein Skalarwert. Die Belohnung ist der "Kompass" für das Lernen des Agenten, und ihr Ziel ist es, die langfristige kumulative Belohnung zu maximieren.
Strategie (π)
- Definition: Die Verhaltensrichtlinie des Agenten, eine Abbildungsfunktion von Zuständen auf Aktionen. Sie teilt dem Agenten mit, welche Aktion in einem gegebenen Zustand auszuführen ist. Die Strategie kann deterministisch sein (
a = π(s)), oder stochastisch (a ~ π(a|s))。
- Definition: Die Verhaltensrichtlinie des Agenten, eine Abbildungsfunktion von Zuständen auf Aktionen. Sie teilt dem Agenten mit, welche Aktion in einem gegebenen Zustand auszuführen ist. Die Strategie kann deterministisch sein (
Wertfunktion
- Definition: Wird verwendet, um zu bewerten, wie gut ein Zustand oder ein Zustands-Aktions-Paar ist. Es stellt dar, was in der Zukunft ausgehend vom aktuellen Zustand (oder nach Ausführung der aktuellen Aktion) erreicht werden kann.Erwartete kumulative Belohnung。
- Zustandswertfunktion V(s): Im Zustand
s, die erwartete Rendite, die durch Befolgen der aktuellen Strategie erzielt werden kann. - Aktionswertfunktion Q(s, a): Im Zustand
s, Ausführen der Aktiona, und dann die erwartete Rendite, die durch Befolgen der aktuellen Strategie erzielt werden kann.
Interaktionsprozess
Die Interaktion zwischen dem Agenten und der Umgebung ist ein kontinuierlicher zyklischer Prozess, der durch das folgende Flussdiagramm klar dargestellt werden kann:

Diese Schleife wiederholt sich kontinuierlich, und der Agent sammelt eine große Menge an Interaktionsdaten (s, a, r, s') und verwendet diese Daten, um seine Policy zu verbessern.
Wichtige Algorithmen des Deep Reinforcement Learning
Die Algorithmenfamilie des Deep Reinforcement Learning ist hauptsächlich in zwei große Kategorien unterteilt:Value-BasedundPolicy-Based, und dieActor-CriticMethode, die die Vorteile beider kombiniert.
1. Value-Based Deep Q-Network
Der Kern dieser Art von Algorithmus besteht darin, die optimaleAktionswertfunktion Q(s, a)zu lernen. Sobald eine genaue Q-Funktion gelernt wurde, ist die optimale Policy einfach: in jedem Zustands, wähle die Aktion, die bewirken kannQ(s, a)die Aktion mit dem maximalena。
Deep Q-Network (DQN)ist eine Meilensteinarbeit. Es verwendet tiefe neuronale Netze, um komplexe Q-Funktionen zu approximieren.
Wichtige technische Innovationen von DQN:
- Experience Replay: Der Agent speichert Interaktionserfahrungen
(s, a, r, s')in einem Speicherpuffer. Während des Trainings wird ein Batch von Erfahrungen zufällig aus dem Puffer zum Lernen entnommen. Dies durchbricht die Korrelation zwischen den Daten und macht das Training stabiler und effizienter. - Target-Netzwerk: Ein "Target-Netzwerk" mit derselben Struktur, aber langsameren Parameteraktualisierungen wird verwendet, um Lernziele (Q-Zielwerte) zu berechnen, während ein weiteres "Online-Netzwerk" für die Aktionsauswahl und Echtzeit-Aktualisierungen genutzt wird. Dies löst das Problem, dass sich die Zielwerte während des Trainings ständig verändern, und verbessert die Stabilität erheblich.
Ein vereinfachter DQN-Trainingsprozess:
- Initialisiere das Online-Netzwerk
Qund das Target-NetzwerkQ_target(mit denselben Parametern) und leere den Experience-Replay-Puffer. - Der Agent wählt basierend auf dem aktuellen Zustand
s, mit einer gewissen Wahrscheinlichkeit zufällig oder gemäß demQNetzwerk eine Aktion ausa。 - Führe die Aktion aus, die Umgebung gibt eine Belohnung zurück
rund einen neuen Zustands', und speichere die Erfahrung(s, a, r, s')im Replay-Buffer. - Ziehe zufällig einen Batch von Erfahrungen aus dem Replay-Buffer.
- Berechne für jede Stichprobe den Ziel-Q-Wert:
y = r + γ * max_a' Q_target(s', a'). Hierbei,γist der Diskontfaktor, mit dem unmittelbare Belohnungen und zukünftige Belohnungen gegeneinander abgewogen werden. - with
(y - Q(s, a))^2als Verlust, aktualisiere dieQParameter des Online-Netzwerks mittels Gradientenabstieg. - Kopiere nach einer bestimmten Anzahl von Schritten die Parameter des Online-Netzwerks in das Zielnetzwerk.
- Wiederhole die Schritte 2-7.
Vorteile und Einschränkungen:
- Vorteile: Relativ hohe Stichprobeneffizienz und relativ stabiles Training.
- Einschränkungen: Es ist von Natur aus schwierig, kontinuierliche Aktionsräume zu handhaben (da es die Berechnung erfordert
max_a Q(s,a)), und es kann normalerweise nur deterministische Policies lernen.
2. Policy-basierte Policy-Gradient-Methoden
Diese Methoden parametrisieren die Policy direktπ(a|s; θ)(z. B. durch ein neuronales Netz dargestellt) und optimieren die Policy-Parameterθum den erwarteten Ertrag direkt zu maximieren.
Kernidee: Indem man den Gradienten des erwarteten Ertrags berechnetJ(θ)bezüglich der Policy-Parameterθ(d. h. den Policy-Gradienten) und dann die Parameter entlang der Gradientenrichtung aktualisiert, wird die Policy immer besser.
REINFORCE-Algorithmusist ein klassischer Policy-Gradienten-Algorithmus. Seine Aktualisierungsformel lautet:θ ← θ + α * ∇_θ log π(a|s; θ) * G_twobeiG_tist die kumulative Belohnung vom aktuellen Zeitpunkt bis zum Ende der Episode,αist die Lernrate.
Vorteile und Einschränkungen:
- Vorteile: Kann direkt stochastische Policies lernen und eignet sich natürlich für kontinuierliche Aktionsräume.
- Einschränkungen: Aktualisierungen basieren auf der gesamten Episode, was zu hoher Varianz, instabilem Training und geringer Stichprobeneffizienz führt.
3. Actor-Critic-Methoden
Das Actor-Critic-Framework kombiniert auf clevere Weise wertbasierte und policybasierte Methoden, wobei sie die Stärken der jeweils anderen ergänzen.
- Actor: Ein Policy-Netzwerk, das dafür verantwortlich ist, basierend auf dem Zustand Aktionen zu generieren. Es ist wie ein Schauspieler, der seine oder ihre "Leistung" (Policy) unter der Anleitung eines Kritikers verbessert.
- CriticEin Wertnetzwerk (normalerweise ein Q-Netzwerk oder V-Netzwerk), das den Wert der vom Actor in einem gegebenen Zustand ausgeführten Aktionen bewertet. Es fungiert wie ein Kritiker und bewertet die Leistung des Actors.
Workflow:
- Der Actor, basierend auf dem aktuellen Zustand
sund seiner eigenen Policy, wählt eine Aktion aus und führt sie ausa。 - Die Umgebung gibt eine Belohnung zurück
rund einen neuen Zustands'。 - Der Kritiker, basierend auf
(s, a, r, s')berechnet den TD-Fehler (Temporal-Difference Error, ein Signal, das die Differenz zwischen vorhergesagtem Wert und tatsächlichem Wert misst). - Der Kritiker verwendet diesen Fehler, um sein Wertschätzungsnetzwerk zu aktualisieren, wodurch seine Bewertung genauer wird.
- Der Akteur verwendet die vom Kritiker bereitgestellten "Scores" (wie TD-Fehler oder Vorteilsfunktion), um sein Policy-Netzwerk zu aktualisieren, wodurch er eher Aktionen auswählt, die hohe Scores erhalten.
VorteileActor-Critic-Methoden haben im Allgemeinen eine geringere Varianz und sind stabiler als reine Policy-Gradient-Methoden (wie REINFORCE) und können gleichzeitig besser mit kontinuierlichen Aktionen und stochastischen Policies umgehen als reine Wertmethoden (wie DQN).A3C, A2C, PPO, SACusw. sind alle sehr erfolgreiche Actor-Critic-Algorithmen.
Praxis: CartPole mit DQN spielen
Verwenden wir ein klassisches SteuerungsproblemCartPole(Balancierstange), um ein intuitives Gefühl für DQN zu bekommen. In dieser Umgebung kann sich der Wagen nach links und rechts bewegen, und das Ziel ist, die Stange auf dem Wagen aufrecht zu halten.
Umgebungs-Setup
Wir verwenden das OpenAI Gym Reinforcement-Learning-Toolkit.
Beispiel
# !pip install gym numpy torch
import gym
import numpy as np
import random
import torch
import torch.nn as nn
import torch.optim as optim
import collections
# Umgebung erstellen
env = gym.make('CartPole-v1')
state_dim = env.observation_space.shape[0] # Zustandsdimension: 4 (Wagenposition, Geschwindigkeit, Stabwinkel, Winkelgeschwindigkeit)
action_dim = env.action_space.n # Aktionsdimension: 2 (links, rechts)
print(f"Zustandsraumdimension: {state_dim}, Aktionsraumgröße: {action_dim}")
Q-Netzwerk definieren
Dies ist ein einfaches vollständig verbundenes neuronales Netz, mit dem Zustand als Eingabe und dem Q-Wert für jede Aktion als Ausgabe.
Beispiel
def __init__(self, state_dim, action_dim):
super(DQN, self).__init__()
self.fc1 = nn.Linear(state_dim, 128) # Erste vollständig verbundene Schicht
self.fc2 = nn.Linear(128, 128) # Zweite vollständig verbundene Schicht
self.fc3 = nn.Linear(128, action_dim) # Ausgabeschicht, ein Q-Wert pro Aktion
def forward(self, x):
x = torch.relu(self.fc1(x)) # ReLU-Aktivierungsfunktion verwenden, um Nichtlinearität einzuführen
x = torch.relu(self.fc2(x))
return self.fc3(x) # Q-Werte ausgeben, ohne Aktivierungsfunktion
Definiere Experience Replay Buffer
Wird verwendet, um vergangene Erfahrungen zu speichern und Stichproben daraus zu entnehmen.
Beispiel
def __init__(self, capacity):
self.buffer = collections.deque(maxlen=capacity) # Doppelendige Warteschlange, verwirft automatisch alte Erfahrungen
def add(self, state, action, reward, next_state, done):
self.buffer.append((state, action, reward, next_state, done))
def sample(self, batch_size):
transitions = random.sample(self.buffer, batch_size)
# Daten in Tensoren organisieren, spaltenweise gestapelt für effiziente Batch-Verarbeitung durch das neuronale Netz
state, action, reward, next_state, done = zip(*transitions)
return (np.array(state), action, reward, np.array(next_state), done)
def size(self):
return len(self.buffer)
DQN-Agent definieren
Integriert das Netzwerk, Experience Replay und die Trainingslogik.
Beispiel
def __init__(self, state_dim, action_dim, lr=1e-3, gamma=0.98, epsilon=0.01,
target_update_freq=10, buffer_size=10000, batch_size=64):
self.action_dim = action_dim
self.q_net = DQN(state_dim, action_dim) # Online-Netzwerk
self.target_q_net = DQN(state_dim, action_dim) # Zielnetzwerk
self.target_q_net.load_state_dict(self.q_net.state_dict()) # Gleiche Anfangsparameter
self.optimizer = optim.Adam(self.q_net.parameters(), lr=lr) # Optimierer
self.gamma = gamma # Diskontfaktor
self.epsilon = epsilon # Explorationsrate (final)
self.target_update_freq = target_update_freq # Aktualisierungshäufigkeit des Zielnetzwerks
self.batch_size = batch_size
self.buffer = ReplayBuffer(buffer_size)
self.count = 0 # Aktualisierungsschritte aufzeichnen
def take_action(self, state, epsilon=None):
"""Aktion gemäß der Epsilon-Greedy-Strategie auswählen"""
if epsilon is None:
epsilon = self.epsilon
if np.random.random() < epsilon:
return np.random.randint(self.action_dim) # Exploration: Zufallsauswahl
else:
state = torch.tensor(state, dtype=torch.float).unsqueeze(0) # Batch-Dimension hinzufügen
with torch.no_grad():
q_values = self.q_net(state)
return q_values.argmax().item() # Ausnutzung: Wähle die Aktion mit dem größten Q-Wert
def update(self):
"""Stichprobe aus dem Experience-Replay-Puffer ziehen und das Netzwerk aktualisieren"""
if self.buffer.size() < self.batch_size:
return
# 1. Stichprobe
states, actions, rewards, next_states, dones = self.buffer.sample(self.batch_size)
# In PyTorch-Tensoren umwandeln
states = torch.tensor(states, dtype=torch.float)
actions = torch.tensor(actions).unsqueeze(1) # Form wird zu [batch_size, 1], praktisch für die Gather-Operation
rewards = torch.tensor(rewards, dtype=torch.float).unsqueeze(1)
next_states = torch.tensor(next_states, dtype=torch.float)
dones = torch.tensor(dones, dtype=torch.float).unsqueeze(1)
# 2. Aktuellen Q-Wert berechnen (Q(s, a))
current_q_values = self.q_net(states).gather(1, actions) # Nur den Q-Wert extrahieren, der der ausgeführten Aktion a entspricht
# 3. Ziel-Q-Wert berechnen (r + γ * max_a' Q_target(s', a'))
with torch.no_grad():
next_q_values = self.target_q_net(next_states).max(1)[0].unsqueeze(1) # Den maximalen Q-Wert des nächsten Zustands nehmen
target_q_values = rewards + self.gamma * next_q_values * (1 - dones) # Wenn die Episode endet (done=1), gibt es keine zukünftige Belohnung
# 4. Verlust berechnen (mittlerer quadratischer Fehler)
loss = nn.MSELoss()(current_q_values, target_q_values)
# 5. Online-Netzwerk mit Gradientenabstieg aktualisieren
self.optimizer.zero_grad()
loss.backward()
# Optional: Gradientenclipping, um eine Gradientenexplosion zu verhindern
# torch.nn.utils.clip_grad_norm_(self.q_net.parameters(), max_norm=10)
self.optimizer.step()
self.count += 1
# 6. Target-Netzwerk regelmäßig aktualisieren
if self.count % self.target_update_freq == 0:
self.target_q_net.load_state_dict(self.q_net.state_dict())
Trainingsschleife
Beispiel
"""Trainiere den Agenten"""
return_list = [] # Zeichne die Gesamtbelohnung für jede Episode auf
epsilon = initial_epsilon
for i_episode in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
for step in range(max_steps):
# 1. Aktion auswählen und ausführen
action = agent.take_action(state, epsilon) # Verwende die verringerte Explorationsrate
next_state, reward, done, truncated, _ = env.step(action)
# 2. Erfahrung speichern
agent.buffer.add(state, action, reward, next_state, done)
state = next_state
episode_return += reward
# 3. Netzwerk aktualisieren
agent.update()
if done or truncated:
break
# Zerfall der Explorationsrate
epsilon = max(agent.epsilon, epsilon * epsilon_decay)
return_list.append(episode_return)
if (i_episode + 1) % 50 == 0:
print(f"Episode: {i_episode+1}, Durchschnittliche Belohnung (letzte 50 Episoden): {np.mean(return_list[-50:]):.1f}, Explorationsrate: {epsilon:.3f}")
print("Training abgeschlossen!")
return return_list
# Agenten erstellen und Training starten
agent = DQNAgent(state_dim, action_dim, lr=1e-3, gamma=0.99, Epsilon=0.01)
returns = train_agent(env, agent, num_episodes=300)
Testen des trainierten Agenten
Beispiel
"""Teste die Leistung des Agenten"""
total_rewards = []
for i in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
while not done:
if render:
env.render() # Visualisiere die Umgebung; bei lokaler Ausführung kannst du sehen, wie der Wagen die Stange balanciert
action = agent.take_action(state) # Verwende während des Tests eine minimale Explorationsrate (d. h. reine Ausnutzung)
next_state, reward, done, truncated, _ = env.step(action)
state = next_state
episode_return += reward
if done or truncated:
break
total_rewards.append(episode_return)
print(f"Test-Episode {i+1}: Gesamtbelohnung = {episode_return}")
env.close()
print(f"Durchschnittliche Testbelohnung: {np.mean(total_rewards):.1f}")
# Teste den Agenten
test_agent(env, agent, num_episodes=3, render=False) # Setze render=False in Nicht-GUI-Umgebungen
Herausforderungen und zukünftige Richtungen des Deep Reinforcement Learning
Trotz seines großen Erfolgs steht Deep Reinforcement Learning noch vor vielen Herausforderungen:
- Geringe Sample-Effizienz: Sie benötigt normalerweise weit mehr interaktive Daten als Menschen oder traditionelle Methoden, um eine Aufgabe zu lernen.
- Instabiles Training: Sehr empfindlich gegenüber Hyperparametern (Lernrate, Netzwerkstruktur usw.), und der Trainingsprozess kann leicht divergieren.
- Belohnungsdesign ist schwierig: Eine Belohnungsfunktion zu entwerfen, die den Agenten korrekt zum Erreichen des Endziels führt, ist selbst eine Herausforderung.
- Sicherheit und Interpretierbarkeit: Wie kann sichergestellt werden, dass das Verhalten des Agenten sicher, zuverlässig und im Einklang mit den Erwartungen ist, und wie kann sein Entscheidungsprozess verstanden werden.
Die zukünftige Forschung bewegt sich in Richtung effizienterer Algorithmen (wie modellbasiertes Reinforcement Learning), stärkerem Repräsentationslernen, Multi-Task- und Meta-Learning sowie sicherer Ausrichtung an der realen Welt.
Zusammenfassung und Übungen
Deep Reinforcement Learning kombiniert die Wahrnehmungsfähigkeiten des Deep Learning mit dem Entscheidungsrahmen des Reinforcement Learning, wodurch Maschinen lernen können, fortgeschrittene Aufgaben in komplexen Umgebungen zu bewältigen. Du hast die Kernkonzepte, die wichtigsten Algorithmusfamilien kennengelernt und praktische Erfahrung mit dem DQN-Übungscode gesammelt.
Übungen und Reflexion:
- Ändern Sie den Code: Versuchen Sie, die Hyperparameter anzupassen in
DQNAgent(wie z. B.lr,gamma,batch_size), und beobachten Sie ihre Auswirkungen auf die Trainingsgeschwindigkeit und die endgültige Leistung. - Die Umgebung ändern: Versuchen Sie, den Code auf andere Gym-Umgebungen anzuwenden, wie z. B.
MountainCar-v0oderLunarLander-v2. Achten Sie darauf, die Zustands- und Aktionsdimensionen anzupassen. - Algorithmenvergleich: Informieren Sie sich über einen einfachen Policy-Gradient-Algorithmus (wie REINFORCE) und versuchen Sie, ihn zu implementieren, um das CartPole-Problem zu lösen, und vergleichen Sie seine Unterschiede zu DQN in Bezug auf Trainingsstabilität und Sample-Effizienz.
- Weiterführende Erkundung: Wählen Sie einen modernen fortgeschrittenen Algorithmus (wie PPO oder SAC), lesen Sie dessen Paper oder Open-Source-Implementierung und verstehen Sie, wie er Probleme löst, die in DQN oder Policy-Gradienten auftreten.