Gängige Netzwerktypen
Stellen Sie sich vor, wir bringen einem Kind bei, Katzen und Hunde zu erkennen.
Zunächst zeigen wir ihm viele Bilder von Katzen und Hunden und sagen ihm "Das ist eine Katze, das ist ein Hund." Nach und nach extrahiert das Gehirn des Kindes Muster aus diesen Bildern: Katzen haben normalerweise spitze Ohren und rundere Gesichter; Hundeohren können hängen und ihre Gesichter sind länger. Dieser Prozess ist im WesentlichenMerkmale lernenundund Muster aufbauen.。
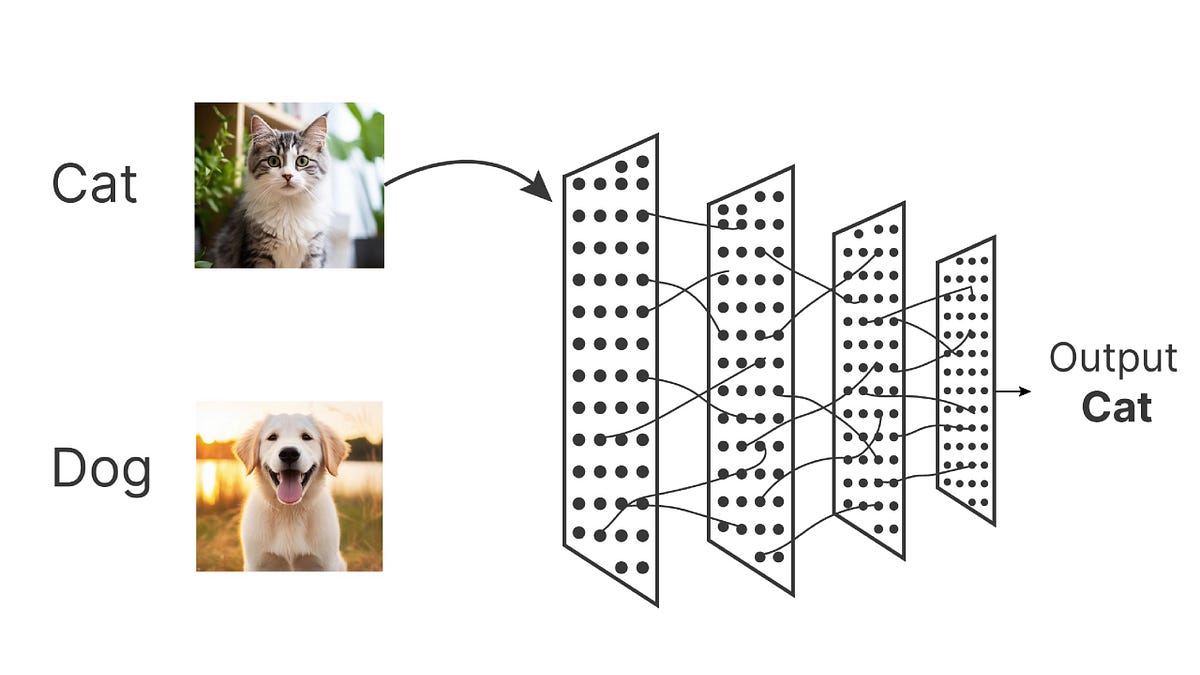
Deep Learning, ein leistungsstarker Zweig des maschinellen Lernens, zielt darauf ab, Computer diesen Prozess simulieren zu lassen. Durch den Aufbau mehrschichtiger neuronaler Netzwerke ermöglicht es Maschinen, automatisch komplexe Merkmale aus riesigen Datenmengen zu lernen und zu extrahieren und letztlich fortgeschrittene Aufgaben wie Bilderkennung, Sprachverständnis und Trendvorhersage zu bewältigen. Unterschiedliche Aufgaben erfordern Netzwerke mit unterschiedlichen Architekturen. Dieser Artikel stellt Ihnen mehrere zentrale, gängige Typen von Deep-Learning-Netzwerken vor und hilft Ihnen, ihre Designphilosophien und typischen Anwendungen zu verstehen.
Deep-Learning-Netzwerke
| Chinesischer vollständiger Name | Englischer vollständiger Name | Abkürzung |
|---|---|---|
| Künstliches Neuronales Netz | Künstliches Neuronales Netz | ANN |
| Faltungsneuronales Netz | Faltungsneuronales Netz | CNN |
| Rekurrentes Neuronales Netz | Rekurrentes Neuronales Netz | RNN |
| Long Short-Term Memory-Netzwerk | Long Short-Term Memory | LSTM |
| Gated Recurrent Unit | Gated Recurrent Unit | GRU |
| Generatives adversarisches Netzwerk | Generatives adversarisches Netzwerk | GAN |
| Transformer | Transformer | Transformer |
| Autoencoder | Autoencoder | AE |
| Variational Autoencoder | Variational Autoencoder | VAE |
| Deep-Belief-Netzwerk | Deep-Belief-Netzwerk | DBN |
| Graph-Neuronales Netz | Graph-Neuronales Netz | GNN |
Grundlagen neuronaler Netze und vollständig verbundene Netzwerke
Bevor wir in verschiedene Netzwerke eintauchen, müssen wir das grundlegendste Modell verstehen —vollständig verbundenes Netzwerk, auch bekannt alsMulti-Layer-Perceptron (MLP)。
Kernidee: Alles kann verbunden werden
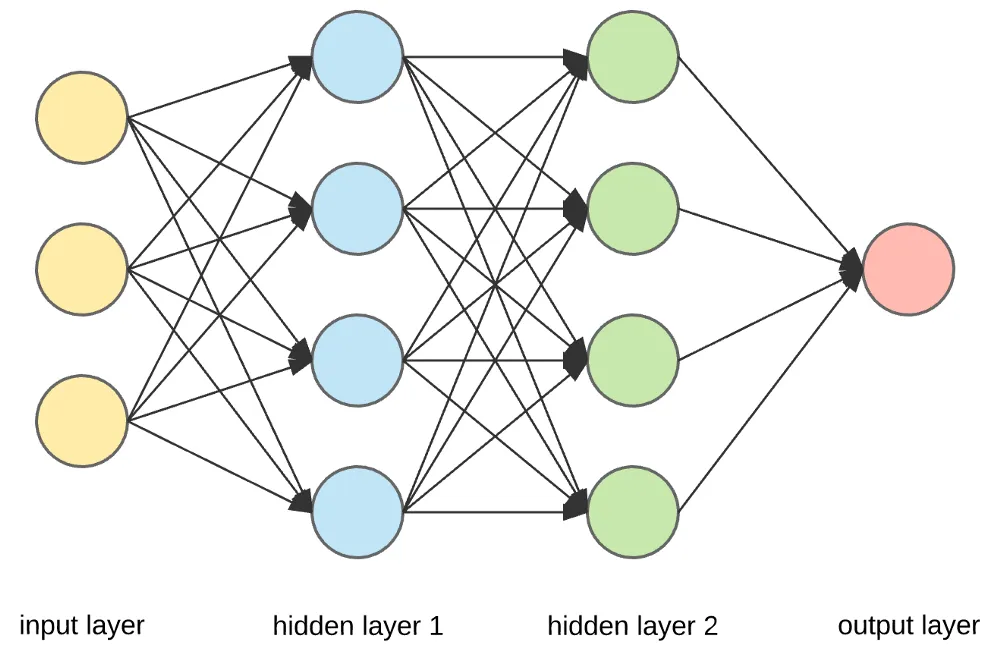
Das vollständig verbundene Netzwerk ist die geradlinigste Architektur im Deep Learning. Wie der Name schon sagt, ist in jeder Schichtjedes Neuronmitjedem Neuron der benachbarten Schicht verbunden.
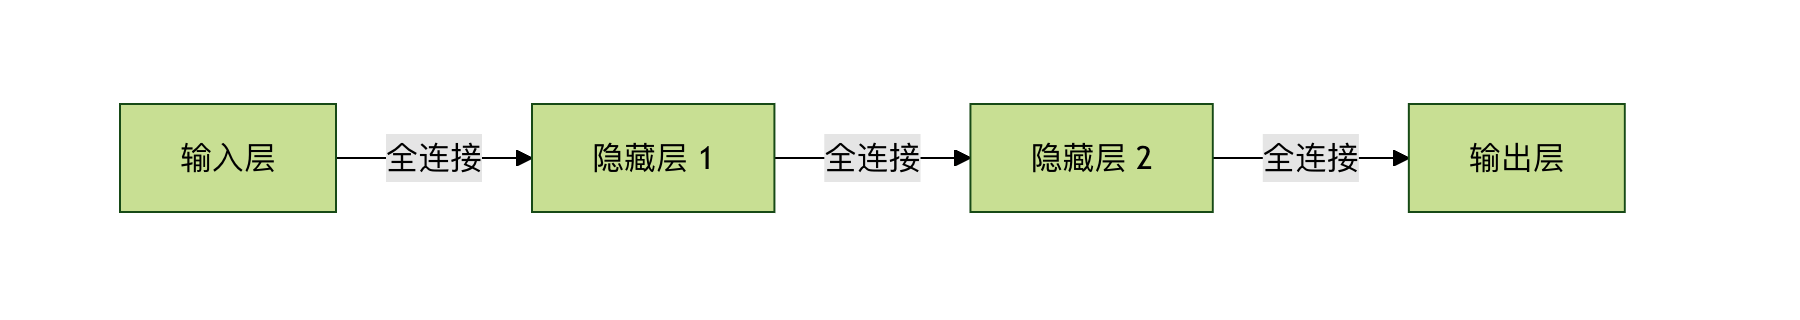
Wir können es uns als ein extrem dichtes informationsverarbeitendes Netzwerk vorstellen. Daten gelangen über die Eingabeschicht hinein, werden durch mehrere verborgene Schichten transformiert und erzeugen schließlich Ergebnisse in der Ausgabeschicht.
Typische Anwendungen und Grenzen
Anwendung: Dank seiner leistungsstarken Anpassungsfähigkeit eignet sich FCN gut für strukturierte Daten (z. B. tabellarische Daten wie Wohnfläche, Lage und Anzahl der Zimmer bei der Vorhersage von Hauspreisen).
Beispiel
import torch.nn as nn
class SimpleFCN(nn.Module):
def __init__(self, input_size, num_classes):
super(SimpleFCN, self).__init__()
# Netzwerkschichten definieren
self.fc1 = nn.Linear(input_size, 128) # Erste versteckte Schicht
self.relu = nn.ReLU() # Aktivierungsfunktion
self.fc2 = nn.Linear(128, 64) # Zweite versteckte Schicht
self.fc3 = nn.Linear(64, num_classes) # Ausgabeschicht
def forward(self, x):
x = self.fc1(x)
x = self.relu(x)
x = self.fc2(x)
x = self.relu(x)
x = self.fc3(x)
return x
# Angenommen, die Eingabe ist ein 100-dimensionales Merkmal für eine 10-Klassen-Klassifikation
model = SimpleFCN(input_size=100, num_classes=10)
Einschränkungen: Bei der Verarbeitung gitterartiger Daten wie Bilder und Sprache steht FCN vor erheblichen Herausforderungen. Da Pixel in einem Bild räumlich stark korreliert sind, ignoriert FCN diese räumliche Struktur und flacht das Bild zu einem eindimensionalen Vektor für die Verarbeitung ab, was zu einer Explosion der Anzahl der Parameter und zu Schwierigkeiten beim Erlernen effektiver räumlicher Merkmale führt.
Convolutional Neural Networks — Der Grundpfeiler der Computer Vision
Um das Problem der Bildverarbeitung zu lösen,Convolutional Neural Networks (CNN)entstanden, wie es die Zeit erforderte, und veränderten das Gebiet der Computer Vision vollständig.
Kernidee: Lokale Wahrnehmung und Parameter-Sharing
CNN lässt sich vom biologischen visuellen Cortex inspirieren, und seine beiden Kernideen sind:
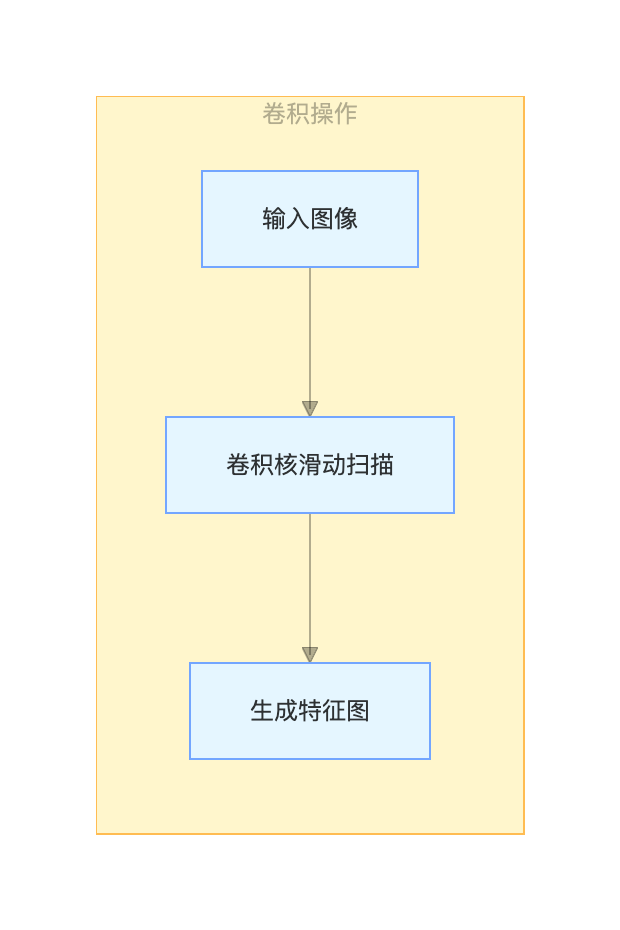
- Lokale Wahrnehmung: Im Gegensatz zu FCN, wo Neuronen mit dem gesamten Bild verbunden sind, nimmt jedes Neuron in CNN nur einekleine lokale Region(z. B. einen 3x3- oder 5x5-Pixel-Ausschnitt) wahr. Dies entspricht besser der Eigenschaft, dass benachbarte Pixel in einem Bild stärker korreliert sind.
- Parameter-Sharing: Durch die Verwendung desselbenFaltungskerns(oder Filters) zum Gleiten und Scannen an verschiedenen Positionen des Bildes, wobei dieselbe Art von Merkmalen (wie Kanten, Texturen) extrahiert wird. Dies reduziert die Netzwerkparameter erheblich.
Kernkomponenten und typische Anwendungen
Ein typisches CNN setzt sich aus den folgenden Komponenten zusammen:
- Faltungsschicht: Verwendet Faltungskerne, um Merkmale zu extrahieren.
- Pooling-Schicht(z. B. Max-Pooling): Führt Downsampling von Feature-Maps durch, wodurch das Datenvolumen reduziert und die Merkmalsinvarianz erhöht wird.
- Vollständig verbundene Schicht: Am Ende des Netzwerks werden erlernte verteilte Merkmale auf den Labelraum der Beispiele abgebildet.
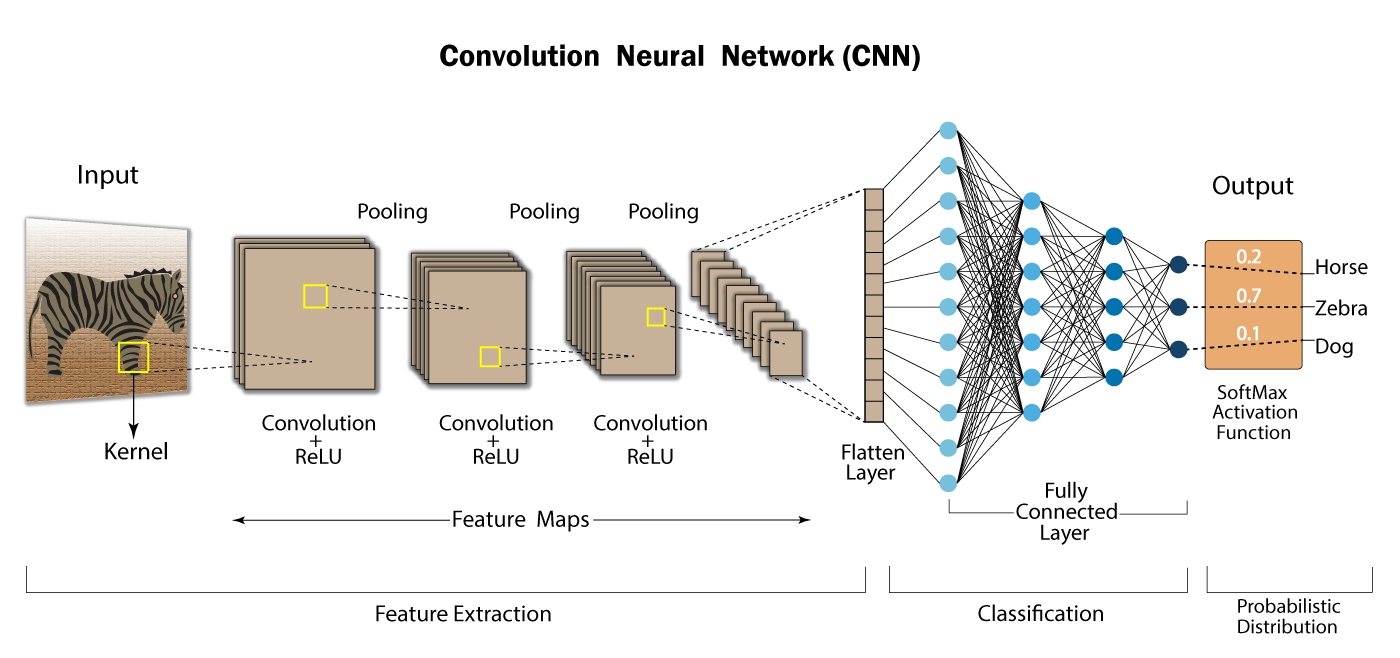
Anwendung: Nahezu alle Aufgaben der Computer Vision wie Bildklassifikation, Objekterkennung und Gesichtserkennung.
Beispiel
class SimpleCNN(nn.Module):
def __init__(self, num_classes=10):
super(SimpleCNN, self).__init__()
self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
self.fc1 = nn.Linear(32 * 8 * 8, 256) # Angenommen, die Feature-Map-Größe beträgt nach zwei Pooling-Operationen 8x8
self.fc2 = nn.Linear(256, num_classes)
def forward(self, x):
x = self.pool(nn.functional.relu(self.conv1(x))) # Faltung -> Aktivierung -> Pooling
x = self.pool(nn.functional.relu(self.conv2(x)))
x = x.view(-1, 32 * 8 * 8) # Merkmalskarte zu einem eindimensionalen Vektor abflachen
x = nn.functional.relu(self.fc1(x))
x = self.fc2(x)
return x
Rekurrente neuronale Netze — Experten für die Verarbeitung sequenzieller Daten
Für Daten wie Sprache, Sprachdaten und Zeitreihen, diesequenzielle Abhängigkeitsbeziehungenaufweisen, benötigen wir ein Netzwerk, das historische Informationen speichern kann. Dies ist dasrekurrente neuronale Netz (RNN)。
Kernidee: Einführung eines Gedächtnismechanismus
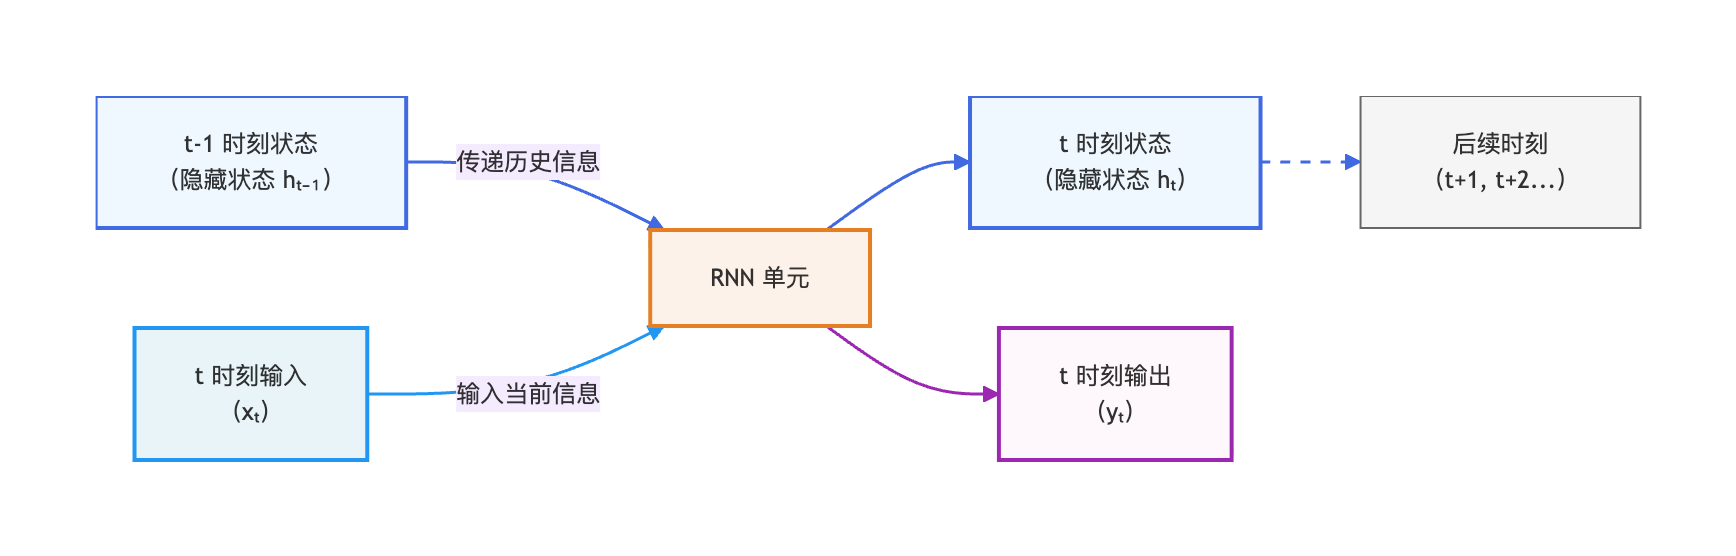
Der Kern des RNN liegt in seiner rekurrenten Struktur. Bei der Verarbeitung der aktuellen Eingabe kombiniert das Netzwerk die aktuelle Eingabe mit demverborgenen Zustand aus dem vorherigen Zeitschritt, um gemeinsam die aktuelle Ausgabe und den an den nächsten Zeitschritt weitergegebenen verborgenen Zustand zu bestimmen. Das ist wie beim Lesen eines Satzes: Um das aktuelle Wort zu verstehen, muss man sich auf zuvor gelesene Wörter stützen.
Varianten und typische Anwendungen
Das einfache RNN leidet unter dem Problem der Langzeitabhängigkeiten, wodurch es schwierig ist, Informationen in langen Sequenzen zu lernen. Dies führte zu zwei wichtigen Varianten:
- Long Short-Term Memory-Netzwerk (LSTM): Durch einen ausgeklügelten Gating-Mechanismus (Eingabe-Gate, Vergessens-Gate, Ausgabe-Gate) merkt es sich selektiv wichtige Informationen und vergisst nutzlose Informationen, wodurch das Problem der Abhängigkeiten in langen Sequenzen effektiv gelöst wird.
- Gated Recurrent Unit (GRU): Eine vereinfachte Version von LSTM mit einer kompakteren Struktur und höherer Recheneffizienz, die bei vielen Aufgaben vergleichbare Leistungen erbringt.
Anwendung: Maschinelle Übersetzung, Textgenerierung, Spracherkennung, Aktienkursvorhersage.
Beispiel
class SimpleRNN(nn.Module):
def __init__(self, vocab_size, embed_size, hidden_size, num_classes):
super(SimpleRNN, self).__init__()
self.embedding = nn.Embedding(vocab_size, embed_size) # Worteinbettungsschicht
self.rnn = nn.RNN(input_size=embed_size, hidden_size=hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, num_classes)
def forward(self, x):
# Form von x: (batch_size, sequence_length)
x = self.embedding(x) # Nach der Einbettung: (batch_size, seq_len, embed_size)
_, h_n = self.rnn(x) # h_n ist der verborgene Zustand des letzten Zeitschritts
out = self.fc(h_n.squeeze(0)) # Verwende den finalen Zustand für die Klassifikation
return out
Generative Adversarial Networks — Vom Lernen zur Kreation
Wenn die vorherigen Netzwerke diskriminative Modelle sind (Lernen, Daten zu unterscheiden), dann istGenerative Adversarial Network (GAN)ein herausragender Vertreter generativer Modelle (Lernen, Daten zu erzeugen).

Kernidee: Evolution durch adversariale Spiele
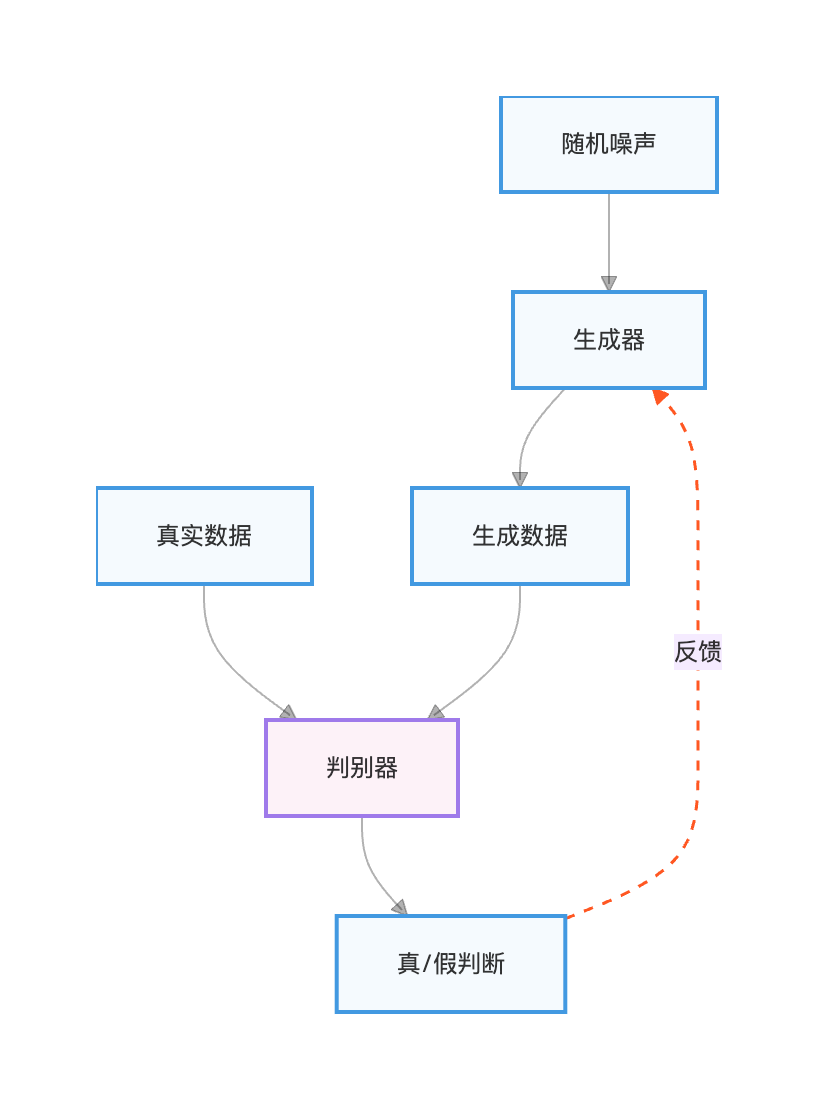
GAN ist von der Spieltheorie inspiriert. Es besteht aus zwei adversarialen Netzwerken:
- Generator: Wie ein Fälscher; sein Ziel ist es, die Verteilung der echten Daten zu erlernen und neue Daten zu erzeugen, die realistisch genug sind, um als echt durchzugehen.
- Diskriminator: Wie ein Authentifizierungsexperte; sein Ziel ist es, genau zu unterscheiden, ob die Eingabedaten aus dem echten Datensatz oder vom Generator stammen.
Die beiden verbessern sich gemeinsam durch kontinuierliches adversariales Training: Der Generator bemüht sich, realistischere Daten zu erzeugen, um den Diskriminator zu täuschen, während der Diskriminator daran arbeitet, seine Unterscheidungsfähigkeit zu verbessern. Schließlich kann der Generator hochwertige neue Daten produzieren.
Typische Anwendungen
Anwendung: Bildgenerierung, Bild-Superauflösung, Stilübertragung, Daten-Augmentierung.
Beispiel
for epoch in range(num_epochs):
# 1. Trainiere den Diskriminator: Maximiere seine Fähigkeit, echte Daten als echt und generierte Daten als gefälscht zu klassifizieren
real_data = get_real_data()
noise = generate_random_noise()
fake_data = generator(noise).detach() # Hinweis: Das detach verhindert, dass der Generator aktualisiert wird
d_loss_real = criterion(discriminator(real_data), real_labels)
d_loss_fake = criterion(discriminator(fake_data), fake_labels)
d_loss = d_loss_real + d_loss_fake
d_loss.backward()
optimizer_D.step()
# 2. Trainiere den Generator: Minimiere die Fähigkeit des Diskriminators, generierte Daten als fake zu klassifizieren (d. h. täusche den Diskriminator)
noise = generate_random_noise()
fake_data = generator(noise)
g_loss = criterion(discriminator(fake_data), real_labels) # Bringe den Diskriminator dazu, zu glauben, dass die generierten Daten echt sind
g_loss.backward()
optimizer_G.step()
Zusammenfassung und Vergleich
| Netzwerktyp | Kernidee | Datentypen, die es hervorragend verarbeitet | Typische Anwendungen |
|---|---|---|---|
| Vollständig verbundenes Netzwerk | Globale Verbindung, dichte Anpassung | Strukturierte Daten (Tabellen) | Hauspreisvorhersage, Bonitätsbewertung |
| Faltungsneuronales Netz | Lokale Wahrnehmung, Parameter-Sharing | Gitterdaten (Bilder) | Bildklassifizierung, Objekterkennung |
| Rekurrentes Neuronales Netz | Zeitliche Abhängigkeit, Gedächtniszustand | Sequenzdaten (Text, Zeitreihen) | Maschinelle Übersetzung, Spracherkennung |
| Generatives adversarisches Netzwerk | Gegnerisches Spiel, Datengenerierung | Wird verwendet, um Daten zu erzeugen, die echten Daten ähneln | Bilderzeugung, Stilübertragung |