Titanic-Überlebensvorhersage
Wenn Sie gerade erst anfangen, Machine Learning zu lernen, könnte es sich für Sie so anfühlen, als wären diese komplexen Algorithmen und mathematischen Formeln weit von der realen Welt entfernt. Doch heute werden wir anhand eines klassischen Falls – der Titanic-Überlebensvorhersage – einen vollständigen Machine-Learning-Projektworkflow aus erster Hand erleben.
Der Titanic-Datensatz ist eines der berühmtesten Einführungsprojekte im Machine Learning. Er basiert auf echten Informationen über Passagiere während des Untergangs der Titanic im Jahr 1912. Unser Ziel ist:Ein Modell zu erstellen, das vorhersagt, ob sie die Katastrophe überlebt haben, basierend auf Alter, Geschlecht, Ticketklasse und anderen Informationen der Passagiere.。
Dieses Projekt ist ein Klassiker, weil es die Kernschritte eines Machine-Learning-Projekts perfekt abdeckt:
- Datenverständnis und Datenexploration
- Datenbereinigung und Vorverarbeitung
- Feature-Engineering
- Modellauswahl und -training
- Modellbewertung und Optimierung
In diesem praxisnahen Fallbeispiel werden Sie nicht nur Theorie lesen, sondern wirklich verstehen, wie man maschinelles Lernen anwendet, um reale Probleme zu lösen.
Schritt 1: Unsere Daten verstehen
Bevor wir Code schreiben, müssen wir zunächst die vorliegenden Daten verstehen. Der Titanic-Datensatz enthält typischerweise die folgenden Felder (Merkmale):
| Feldname | Beschreibung | Datentyp | Hinweise |
|---|---|---|---|
PassengerId |
Passagier-ID | Integer | Eindeutige Kennung, für die Vorhersage nicht hilfreich |
Survived |
Survived | Ganzzahl (0/1) | Zielvariable, 0=umgekommen, 1=überlebt |
Pclass |
Ticketklasse (Pclass) | Ganzzahl (1,2,3) | 1=erste Klasse, 2=zweite Klasse, 3=dritte Klasse |
Name |
Passagiername | String | Enthält Titel (z. B. Mr., Miss.), kann neue Merkmale extrahieren |
Sex |
Geschlecht | String | maleoderfemale |
Age |
Alter | Float | Enthält einige fehlende Werte |
SibSp |
Anzahl der Geschwister/Ehepartner an Bord | Integer | |
Parch |
Anzahl der Eltern/Kinder an Bord | Integer | |
Ticket |
Ticketnummer | String | Komplexe Struktur, kann nur begrenzte Informationen enthalten |
Fare |
Fahrpreis | Float | |
Cabin |
Cabin | String | Viele fehlende Werte, aber der erste Buchstabe könnte den Kabinenbereich darstellen |
Embarked |
Embarked (Einschiffungshafen) | String | C=Cherbourg, Q=Queenstown, S=Southampton |
Wichtige Erkenntnis: Aus historischem Wissen wissen wir, dass das Prinzip "Frauen und Kinder zuerst" befolgt wurde und Passagiere der ersten Klasse vorrangigen Zugang zu Rettungsbooten hatten. Daher erwarten wirSex, Age, Pclasssolche Merkmale werden einen erheblichen Einfluss auf die Vorhersageergebnisse haben.
Schritt 2: Datenbereinigung und Vorverarbeitung
Rohdaten sind fast nie perfekt.
Datenbereinigung ist wie das Vorbereiten hochwertiger Zutaten für das Modell; dieser Schritt ist entscheidend.
Speichern Sie die folgenden Daten in der Datei train.csv:
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,"Braund, Mr. Owen Harris",male,22,1,0,A/5 21171,7.25,,S
2,1,1,"Cumings, Mrs. John Bradley",female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,"Heikkinen, Miss. Laina",female,26,0,0,STON/O2. 3101282,7.925,,S
4,1,1,"Futrelle, Mrs. Jacques Heath",female,35,1,0,113803,53.1,C123,S
5,0,3,"Allen, Mr. William Henry",male,35,0,0,373450,8.05,,S
6,0,3,"Moran, Mr. James",male,,0,0,330877,8.4583,,Q
7,0,1,"McCarthy, Mr. Timothy J",male,54,0,0,17463,51.8625,E46,S
8,0,3,"Palsson, Master. Gosta Leonard",male,2,3,1,349909,21.075,,S
9,1,3,"Johnson, Mrs. Oscar W",female,27,0,2,347742,11.1333,,S
10,1,2,"Nasser, Mrs. Nicholas",female,14,1,0,237736,30.0708,,C
Speichern Sie die folgenden Daten in der Datei test.csv:
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
11,3,"Kelly, Mr. James",male,34.5,0,0,330911,7.8292,,Q
12,3,"Wilkes, Mrs. James",female,47,1,0,363272,7,,S
13,2,"Myles, Mr. Thomas Francis",male,62,0,0,240276,9.6875,,Q
14,3,"Dwyer, Miss. Ellen",female,18,0,0,330959,7.75,,Q
15,1,"Jones, Mr. Charles",male,,1,0,PC 17603,82.1708,B28,C
Wir werden PythonspandasundnumpyBibliothek, um diese Aufgabe zu erledigen.
Beispiel
import pandas as pd
import numpy as np
# Daten laden
train_data = pd.read_csv('train.csv') # Trainingsdatensatz, enthält die Zielvariable Survived
test_data = pd.read_csv('test.csv') # Testdatensatz, enthält Survived nicht, wird für die abschließende Bewertung verwendet
# 1. Erster Blick auf die Daten
print("Form des Trainingsdatensatzes: ", train_data.shape)
print(train_data.info()) # Datentypen und fehlende Werte prüfen
print(train_data.head()) # Die ersten paar Zeilen der Daten anzeigen
Ausgabe:
训练集形状: (10, 12)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 10 entries, 0 to 9
Data columns (total 12 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   PassengerId  10 non-null     int64
 1   Survived     10 non-null     int64
 2   Pclass       10 non-null     int64
 3   Name         10 non-null     object
 4   Sex          10 non-null     object
 5   Age          9 non-null      float64
 6   SibSp        10 non-null     int64
 7   Parch        10 non-null     int64
 8   Ticket       10 non-null     object
 9   Fare         10 non-null     float64
 10  Cabin        3 non-null      object
 11  Embarked     10 non-null     object
dtypes: float64(2), int64(5), object(5)
memory usage: 1.1+ KB
None
   PassengerId  Survived  Pclass                          Name     Sex  ...  Parch            Ticket     Fare Cabin  Embarked
0            1         0       3       Braund, Mr. Owen Harris    male  ...      0         A/5 21171   7.2500   NaN         S
1            2         1       1    Cumings, Mrs. John Bradley  female  ...      0          PC 17599  71.2833   C85         C
2            3         1       3        Heikkinen, Miss. Laina  female  ...      0  STON/O2. 3101282   7.9250   NaN         S
3            4         1       1  Futrelle, Mrs. Jacques Heath  female  ...      0            113803  53.1000  C123         S
4            5         0       3      Allen, Mr. William Henry    male  ...      0            373450   8.0500   NaN         S

[5 rows x 12 columns]
Nach dem Ausführen des obigen Codes können Ihnen zwei Hauptprobleme auffallen:Fehlende WerteundNicht-numerische Daten。
Umgang mit fehlenden Werten
Beispiel
print(train_data.isnull().sum())
# Age behandeln: mit Median füllen
train_data['Age'] = train_data['Age'].fillna(train_data['Age'].median())
test_data['Age'] = test_data['Age'].fillna(test_data['Age'].median())
# Embarked behandeln: mit Modus füllen
most_common_port = train_data['Embarked'].mode()[0]
train_data['Embarked'] = train_data['Embarked'].fillna(most_common_port)
test_data['Embarked'] = test_data['Embarked'].fillna(most_common_port)
# Fare (Ticketpreis) behandeln: Testdatensatz
test_data['Fare'] = test_data['Fare'].fillna(test_data['Fare'].median())
# Cabin behandeln: direkt verwerfen
train_data.drop(columns=['Cabin'], inplace=True)
test_data.drop(columns=['Cabin'], inplace=True)
Konvertieren nicht numerischer Daten
Modelle für maschinelles Lernen können normalerweise nur numerische Werte verarbeiten. Wir müssenSexundEmbarkedTextspalten wie diese in Zahlen umwandeln.
Beispiel
train_data['Sex'] = train_data['Sex'].map({'female': 0, 'male': 1})
test_data['Sex'] = test_data['Sex'].map({'female': 0, 'male': 1})
# Embarked-Spalte in numerische Werte umwandeln (One-Hot-Encoding)
# Da Häfen keine Reihenfolge haben, ist eine einfache Zuordnung mit 0,1,2 nicht geeignet
train_data = pd.get_dummies(train_data, columns=['Embarked'])
test_data = pd.get_dummies(test_data, columns=['Embarked'])
Schritt 3: Feature Engineering
Feature Engineering ist die "Magie" im maschinellen Lernen; es hilft dem Modell, besser zu lernen, indem es Merkmale erstellt oder transformiert. WirNameDas Extrahieren von "Titeln" aus der Spalte ist ein klassisches Beispiel.
Beispiel
# Titel spiegeln oft Alter, sozialen Status und Geschlecht wider und können die Rettungspriorität beeinflussen
train_data['Title'] = train_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
test_data['Title'] = test_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
# Verfügbare Titel anzeigen
print(pd.crosstab(train_data['Title'], train_data['Sex']))
# Ungewöhnliche Titel zu 'Rare' gruppieren
title_mapping = {
'Mr': 'Mr', 'Miss': 'Miss', 'Mrs': 'Mrs',
'Master': 'Master', 'Dr': 'Rare', 'Rev': 'Rare',
'Col': 'Rare', 'Major': 'Rare', 'Mlle': 'Miss',
'Countess': 'Rare', 'Ms': 'Miss', 'Lady': 'Rare',
'Jonkheer': 'Rare', 'Don': 'Rare', 'Dona': 'Rare',
'Mme': 'Mrs', 'Capt': 'Rare', 'Sir': 'Rare'
}
train_data['Title'] = train_data['Title'].map(title_mapping)
test_data['Title'] = test_data['Title'].map(title_mapping)
# Ebenfalls One-Hot-Encoding für die verarbeitete Title-Spalte durchführen
train_data = pd.get_dummies(train_data, columns=['Title'])
test_data = pd.get_dummies(test_data, columns=['Title'])
# Neues Merkmal erstellen: Familiengröße
train_data['FamilySize'] = train_data['SibSp'] + train_data['Parch'] + 1
test_data['FamilySize'] = test_data['SibSp'] + test_data['Parch'] + 1
# Neues Merkmal erstellen: Alleinreisend
train_data['IsAlone'] = (train_data['FamilySize'] == 1).astype(int)
test_data['IsAlone'] = (test_data['FamilySize'] == 1).astype(int)
# Ursprüngliche Spalten entfernen, die nicht mehr benötigt werden
columns_to_drop = ['PassengerId', 'Name', 'Ticket', 'SibSp', 'Parch']
train_data.drop(columns_to_drop, axis=1, inplace=True)
test_passenger_ids = test_data['PassengerId'] # Testset-IDs für spätere Einreichung speichern
test_data.drop(columns_to_drop, axis=1, inplace=True)
print("Spaltennamen des Trainingssets nach Feature Engineering: ", train_data.columns.tolist())
Schritt 4: Auswählen und Trainieren des Modells
Jetzt haben wir saubere und informative numerische Daten. Als Nächstes teilen wir sie inMerkmale (X)undZielvariable (y)auf und wählen dann ein Modell zum Trainieren aus.
Wir beginnen mit einem einfachen und effizientenRandom Forest-Modell.
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# Daten vorbereiten
# X ist die Feature-Matrix, y ist der Zielvektor, den wir vorhersagen wollen
X = train_data.drop('Survived', axis=1)
y = train_data['Survived']
# Um die Modellleistung während des Trainings zu bewerten, teilen wir die Daten in Trainings- und Validierungssets auf
# test_size=0.2 bedeutet, dass 20% der Daten für die Validierung und 80% für das Training verwendet werden
# random_state ist ein Zufallsseed, um jedes Mal konsistente Split-Ergebnisse zu gewährleisten
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
# Initialisiere den Random-Forest-Klassifikator
# n_estimators: Anzahl der Bäume im Wald
# max_depth: maximale Tiefe der Bäume, kontrolliert die Modellkomplexität, verhindert Overfitting
# random_state: gewährleistet reproduzierbare Ergebnisse
model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Trainiere das Modell (lass das Modell Muster aus den Daten lernen)
model.fit(X_train, y_train)
# Mache Vorhersagen auf dem Validierungssatz
y_pred = model.predict(X_val)
# Bewerte die Modellgenauigkeit
accuracy = accuracy_score(y_val, y_pred)
print(f"Die Genauigkeit des Modells auf dem Validierungssatz beträgt: {accuracy:.4f} (d. h. {accuracy*100:.2f}%)")
Schritt 5: Modellbewertung, Optimierung und Einreichung
Evaluierung und Optimierung
Das Ergebnis eines einzelnen Trainingsdurchlaufs ist möglicherweise nicht optimal. Wir können es auf folgende Weise verbessern:
- Modellparameter abstimmen: zum Beispiel verschiedene ausprobieren
n_estimatorsodermax_depth。 - Andere Modelle ausprobieren: wie logistische Regression, Support Vector Machines, Gradient Boosting Trees usw.
- Weiteres Feature Engineering: zum Beispiel für
AgeoderFareBinning durchführen.
Beispiel
for depth in [3, 5, 10, None]: # None bedeutet keine Tiefenbegrenzung
model_temp = RandomForestClassifier(n_estimators=100, max_depth=depth, random_state=42)
model_temp.fit(X_train, y_train)
y_pred_temp = model_temp.predict(X_val)
acc = accuracy_score(y_val, y_pred_temp)
print(f"Wenn max_depth={depth}, Genauigkeit des Validierungssatzes: {acc:.4f}")
Analyse der Feature-Wichtigkeit
Random Forest kann uns sagen, welche Merkmale am meisten zu den Vorhersagen beitragen.
Beispiel
feature_importances = pd.DataFrame({
'feature': X_train.columns,
'importance': model.feature_importances_
}).sort_values('importance', ascending=False)
print("Rangfolge der Feature-Wichtigkeit:")
print(feature_importances)
Sie werden vielleicht feststellenSex, Fare(verwandtPclass), Age, Titleist das wichtigste Merkmal, was mit unserer historischen Intuition übereinstimmt.
Endgültige Vorhersagen auf dem Testset generieren
Sobald wir mit der Leistung des Modells zufrieden sind, trainieren wir mit den vollständigen Trainingsdaten erneut und treffen Vorhersagen auf dem tatsächlichen Testset.
Beispiel
final_model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
final_model.fit(X, y) # Dieses Mal alle Trainingsdaten X, y verwenden
# Stelle sicher, dass die Feature-Spalten des Testsets genau mit dem Trainingsset übereinstimmen (Reihenfolge und Anzahl der Spalten)
# pd.get_dummies kann zu unterschiedlichen Spaltenanzahlen in Trainings- und Testsets führen (wenn eine Kategorie nur auf einer Seite vorkommt)
# Hier müssen wir die Spalten ausrichten. Ein einfacher Weg ist, zusammenzuführen und dann wieder aufzuteilen, aber ein robusterer Ansatz ist, die Konsistenz der Kodierung sicherzustellen.
# Der Einfachheit halber nehmen wir an, dass die Spalten des verarbeiteten Testsets ausgerichtet sind.
final_predictions = final_model.predict(test_data)
# Erstelle die Einreichungsdatei
submission = pd.DataFrame({
'PassengerId': test_passenger_ids,
'Survived': final_predictions
})
submission.to_csv('my_titanic_submission.csv', index=False)
print(Die Vorhersageergebnisse wurden in 'my_titanic_submission.csv' gespeichert. Du kannst sie auf der Kaggle-Plattform einreichen, um das Ranking einzusehen!)
Zusammenfassung und Projekt-Flussdiagramm
Wir haben eine vollständige Machine-Learning-Pipeline abgeschlossen. Lassen Sie uns den gesamten Prozess anhand eines Flussdiagramms durchgehen:
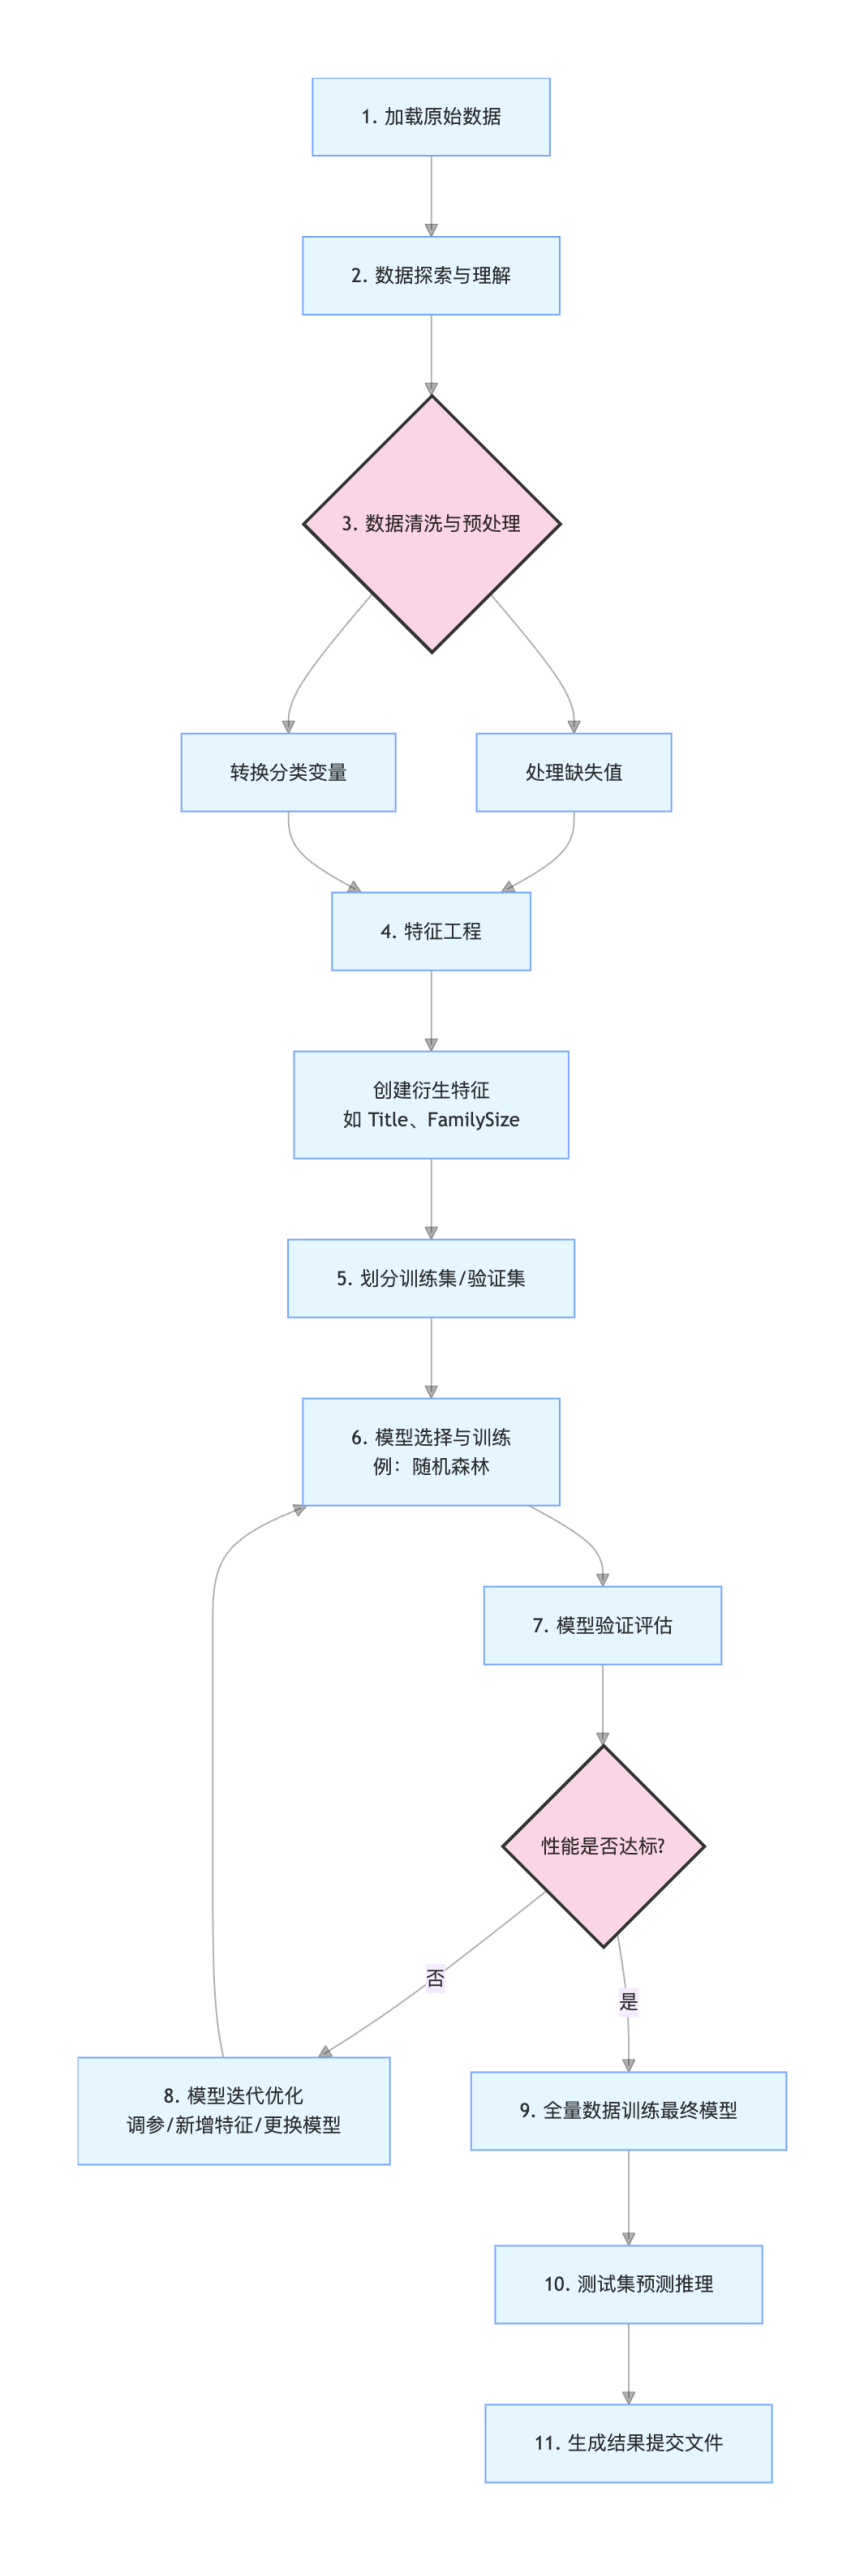
Durch dieses praktische Projekt haben Sie nicht nur gelerntpandasDatenverarbeitung durchzuführen,sklearndie Techniken zum Erstellen von Modellen, sondern – was noch wichtiger ist – Sie habenden Standardansatz zum Lösen eines Machine-Learning-Problems gemeistert.。
Dieser Workflow – vom Datenverständnis bis zur Modellbereitstellung – ist der Kern der überwiegenden Mehrheit aller Data-Science-Projekte.
Weitere Erweiterungen