Bestärkendes Lernen: Exploration vs. Exploitation
In der Welt des bestärkenden Lernens ist der Agent wie ein Entdecker, der in einer unbekannten Umgebung ständig lernt und wächst. Er steht vor einem zentralen Widerspruch, der sich durch alles zieht: Sollte ererkunden (Exploration)unbekanntes Terrain und nach neuen Wegen suchen, die höhere Belohnungen bringen könnten, oder sollte erausnutzen (Exploitation)die bekannte beste Strategie, um stetig die aktuell bekannte maximale Belohnung zu erhalten? Dieser „Exploration-Exploitation-Kompromiss“ ist eine der grundlegendsten und kritischsten Herausforderungen im Design von Reinforcement-Learning-Algorithmen. Diesen Widerspruch gut zu verstehen und zu handhaben, ist der notwendige Weg für einen Agenten, vom Anfänger zum Meister zu wachsen.
Was sind Exploration und Exploitation?
Lassen Sie uns zunächst diese beiden Kernkonzepte anhand einer Analogie aus dem täglichen Leben verstehen.
Stell dir vor, dass du jeden Tag mittags ein Restaurant zum Mittagessen auswählen musst.
- Ausbeutung: Du entscheidest dich, zu dembekannten Restaurant zu gehen, das du am meisten magst. Du weißt, dass das Essen dort deinem Geschmack entspricht, die Preise angemessen sind und die Servicequalität stabil ist. Ausbeutung zu wählen bedeutet, dass du Entscheidungen auf der Grundlage vonden besten derzeit bekannten Informationen, mit dem Ziel,die sicheren unmittelbaren Gewinne zu maximieren. Beim bestärkenden Lernen entspricht dies dem Agenten, der die Aktion mit der höchsten aktuellen Schätzung (wie dem Q-Wert) auswählt.
- Erkundung: Du entscheidest dich,ein neues Restaurant auszuprobieren, das du noch nie besucht hast. Dieses neue Restaurant könnte schrecklich sein und dich dazu bringen, es zutiefst zu bereuen, aber es könnte auch unerwartet köstlich sein und dein neuer Favorit werden. Erkundung zu wählen bedeutet, dass duhandelst, um mehr Informationen über die Umgebung zu erhalten, mit dem Ziel,langfristige zukünftige Belohnungen zu optimieren. Beim bestärkenden Lernen entspricht dies dem Agenten, der zufällig Aktionen auswählt oder Aktionen auswählt, die derzeit nicht optimal sind, um sein Verständnis des Umgebungsmodells zu aktualisieren.
Das Ziel eines Agenten für bestärkendes Lernen ist nicht, ein einzelnes Mittagessen zu gewinnen, sondernüber unzählige Mittagessen-Entscheidungen hinweg die größtmögliche langfristige Zufriedenheit (kumulative Belohnung) zu erzielen.Wenn du nur ausbeutest und nie erkundest, entdeckst du möglicherweise nie das bessere neue Restaurant, und langfristige Belohnungen können das Optimum nicht erreichen. Wenn du nur erkundest und nie ausbeutest, verschwendest du möglicherweise viel Zeit und Geld für schlechte Restaurants und kannst die beste bekannte Wahl nicht genießen.
Warum ist eine Abwägung erforderlich?
Der Grund, warum Erkundung und Ausbeutung gegeneinander abgewogen werden müssen, liegt in derUnsicherheitder Umgebung und derUnvollständigkeit des Wissens des Agenten.。
- Begrenzte Informationen: Der Agent weiß zunächst nichts über die Umgebung. Er muss Daten durch Exploration sammeln, um ein kognitives Modell der Welt aufzubauen (Zustände, Aktionen, Belohnungen, Übergangswahrscheinlichkeiten).
- Opportunitätskosten: Die Erkundung unbekannter Aktionen kann geringere unmittelbare Belohnungen (oder sogar Bestrafung) liefern, was dem Bezahlen eines Preises für Informationen entspricht. Übermäßige Exploration opfert einen großen Teil der kurzfristigen Belohnung, die andernfalls hätte erzielt werden können.
- Dynamische Natur der optimalen Lösung: In nicht-stationären Umgebungen kann sich die optimale Strategie im Laufe der Zeit ändern. Selbst wenn der Agent die aktuelle optimale Strategie gefunden hat, muss er weiterhin in gewissem Maße erkunden, um sich an Umgebungsänderungen anzupassen und zu verhindern, dass die Strategie veraltet.
Daher muss ein exzellenter Reinforcement-Learning-Algorithmus ein dynamisches Gleichgewicht finden zwischen "vorhandenes Wissen zu nutzen, um Belohnungen zu erzielen" und "das Unbekannte zu erkunden, um Wissen zu erweitern."
Gängige Explorationsstrategien
Wie können Explorationsmechanismen in einen Algorithmus integriert werden? Hier sind mehrere klassische Methoden:
ε-Greedy-Strategie (ε-Greedy)
Dies ist die einfachste und am häufigsten verwendete Explorationsstrategie. Der Agent wählt die meiste Zeit (mit Wahrscheinlichkeit1-ε) die Aktion, die er derzeit für optimal hält (Ausnutzung), aber mit einer kleinen Wahrscheinlichkeitε(zum Beispiel 5%) wählt er eine Aktion völlig zufällig (Exploration).
Beispiel
def epsilon_greedy(q_values, epsilon=0.1):
"""
Implementierung der ε-Greedy-Strategie
Argumente:
q_values: ein Array, das die Schätzung des Q-Werts jeder Aktion im aktuellen Zustand darstellt.
epsilon: die Explorationswahrscheinlichkeit, zwischen 0 und 1.
Rückgabe:
selected_action: der Index der gemäß der Strategie ausgewählten Aktion.
"""
n_actions = len(q_values)
# Mit Wahrscheinlichkeit epsilon explorieren (zufällige Auswahl)
if np.random.random() < epsilon:
selected_action = np.random.randint(n_actions)
# Mit Wahrscheinlichkeit 1-epsilon ausnutzen (die Aktion mit dem größten Q-Wert wählen)
else:
# Wenn mehrere Aktionen denselben Q-Wert haben, wähle zufällig eine aus
selected_action = np.random.choice(np.where(q_values == np.max(q_values))[0])
return selected_action
# Beispiel: Angenommen, in einem bestimmten Zustand sind die Q-Wert-Schätzungen der drei Aktionen [1.5, 2.8, 2.3]
state_q_values = [1.5, 2.8, 2.3]
for i in range(10):
action = epsilon_greedy(state_q_values, epsilon=0.2)
print(f"Auswahl {i+1}: Aktion {action} (Q-Wert: {state_q_values[action]:.1f})")
Vorteile: Einfach und leicht verständlich, einfach zu implementieren.Nachteile: Die Erkundung ist völlig zufällig und nutzt keine vorhandenen Informationen (zum Beispiel: Obwohl eine Aktion nicht optimal ist, liegt ihr Q-Wert nahe am Optimum; ihre Wahrscheinlichkeit, erkundet zu werden, ist genauso hoch wie die einer schlechten Aktion mit einem sehr niedrigen Q-Wert).
Algorithmus der oberen Konfidenzschranke (Upper Confidence Bound, UCB)
UCB ist eine "intelligentere" Erkundungsstrategie. Ihre Kernidee besteht darin, der Schätzung jeder Aktion einen "Unsicherheitsbonus" hinzuzufügen. Je seltener eine Aktion ausprobiert wurde, desto größer ist ihre Unsicherheit und desto höher ist dieser Bonus-Term, wodurch der Agent ermutigt wird, sie auszuprobieren.
Die Formel zur Aktionsauswahl lautet normalerweise: \[ a_t = \arg\max_a \left[ Q(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right] \]
wobei:
Q(a)ist dieaaktuelle durchschnittliche Belohnungsschätzung der Aktion (Exploitation-Term).N_t(a)ist bis zum Zeitpunktt, die Anzahl der Male, in denen Aktionaausgewählt wurde.cist ein Balance-Parameter, der die Stärke der Exploration steuert.ln tist der Logarithmus des gesamten Zeitschritts.- Der Quadratwurzel-Term ist der "Unsicherheitsbonus" oder "Explorationsbonus." Je seltener eine Aktion ausgewählt wird (
N_t(a)klein ist), desto größer wird dieser Term.
Beispiel
import math
class UCB:
def __init__(self, n_actions, c=2):
self.n_actions = n_actions
self.c = c # Explorationsparameter
self.Q = np.zeros(n_actions) # Aktionswertschätzungen
self.N = np.zeros(n_actions) # Aktionsauswahlzählungen
self.total_steps = 0
def select_action(self):
self.total_steps += 1
# Stelle sicher, dass jede Aktion mindestens einmal ausgewählt wird
if np.any(self.N == 0):
action = np.random.choice(np.where(self.N == 0)[0])
else:
# Berechne den UCB-Wert jeder Aktion: Q(a) + c * sqrt(ln(t) / N(a))
ucb_values = self.Q + self.c * np.sqrt(np.log(self.total_steps) / self.N)
action = np.argmax(ucb_values)
return action
def update(self, action, reward):
"""Aktualisiere den geschätzten Wert der Aktion"""
self.N[action] += 1
# Aktualisiere den Q-Wert inkrementell: NewEstimate = OldEstimate + (1/N) * (Target - OldEstimate)
self.Q[action] += (reward - self.Q[action]) / self.N[action]
# Simuliere ein Multi-Armed-Bandit-Problem, bei dem jeder Arm eine unterschiedliche wahre Belohnungswahrscheinlichkeit hat
true_means = [0.1, 0.5, 0.9] # Wahre durchschnittliche Belohnungen der drei Arme
n_actions = len(true_means)
bandit = UCB(n_actions, c=2)
total_reward = 0
for step in range(1000):
action = bandit.select_action()
# Simuliere das Ziehen an einem Banditenarm, bei dem mit einer bestimmten Wahrscheinlichkeit Belohnung 1 erzielt wird, andernfalls 0
reward = 1 if np.random.random() < true_means[action] else 0
bandit.update(action, reward)
total_reward += reward
print(f"Gesamtbelohnung, die mit der UCB-Strategie nach 1000 Schritten erzielt wurde: {total_reward}")
print(f"Wie oft jede Aktion ausgewählt wurde: {bandit.N}")
print(f"Q-Wert-Schätzungen für jede Aktion: {bandit.Q}")
Vorteile: Exploration ist zielgerichteter; sie erkundet bevorzugt Aktionen mit hoher Unsicherheit (wenigen Versuchen) und kann schneller zur optimalen Aktion konvergieren.Nachteile: Es muss die Anzahl der Auswahlen jeder Aktion mitgeführt werden, und es ist möglicherweise nicht anwendbar, wenn der Aktionsraum kontinuierlich oder sehr groß ist.
Thompson-Sampling
Dies ist eine probabilistische Methode, die auf bayesschen Ideen basiert. Für die Belohnungsverteilung jeder Aktion (z. B. den Parameter einer Bernoulli-Verteilungθ_a), verwaltet der Agent eine Prior-Verteilung (wie eine Beta-Verteilung). Bei jedem Schritt entnimmt er aus der Posterior-Verteilung jeder Aktioneine Stichprobe füreinen möglichen Belohnungsparameterθ_a, und führt dann die Aktion mit dem größten Stichprobenwert aus. Nach Erhalt der tatsächlichen Belohnung aktualisiert er die Posterior-Verteilung dieser Aktion entsprechend dem Ergebnis.
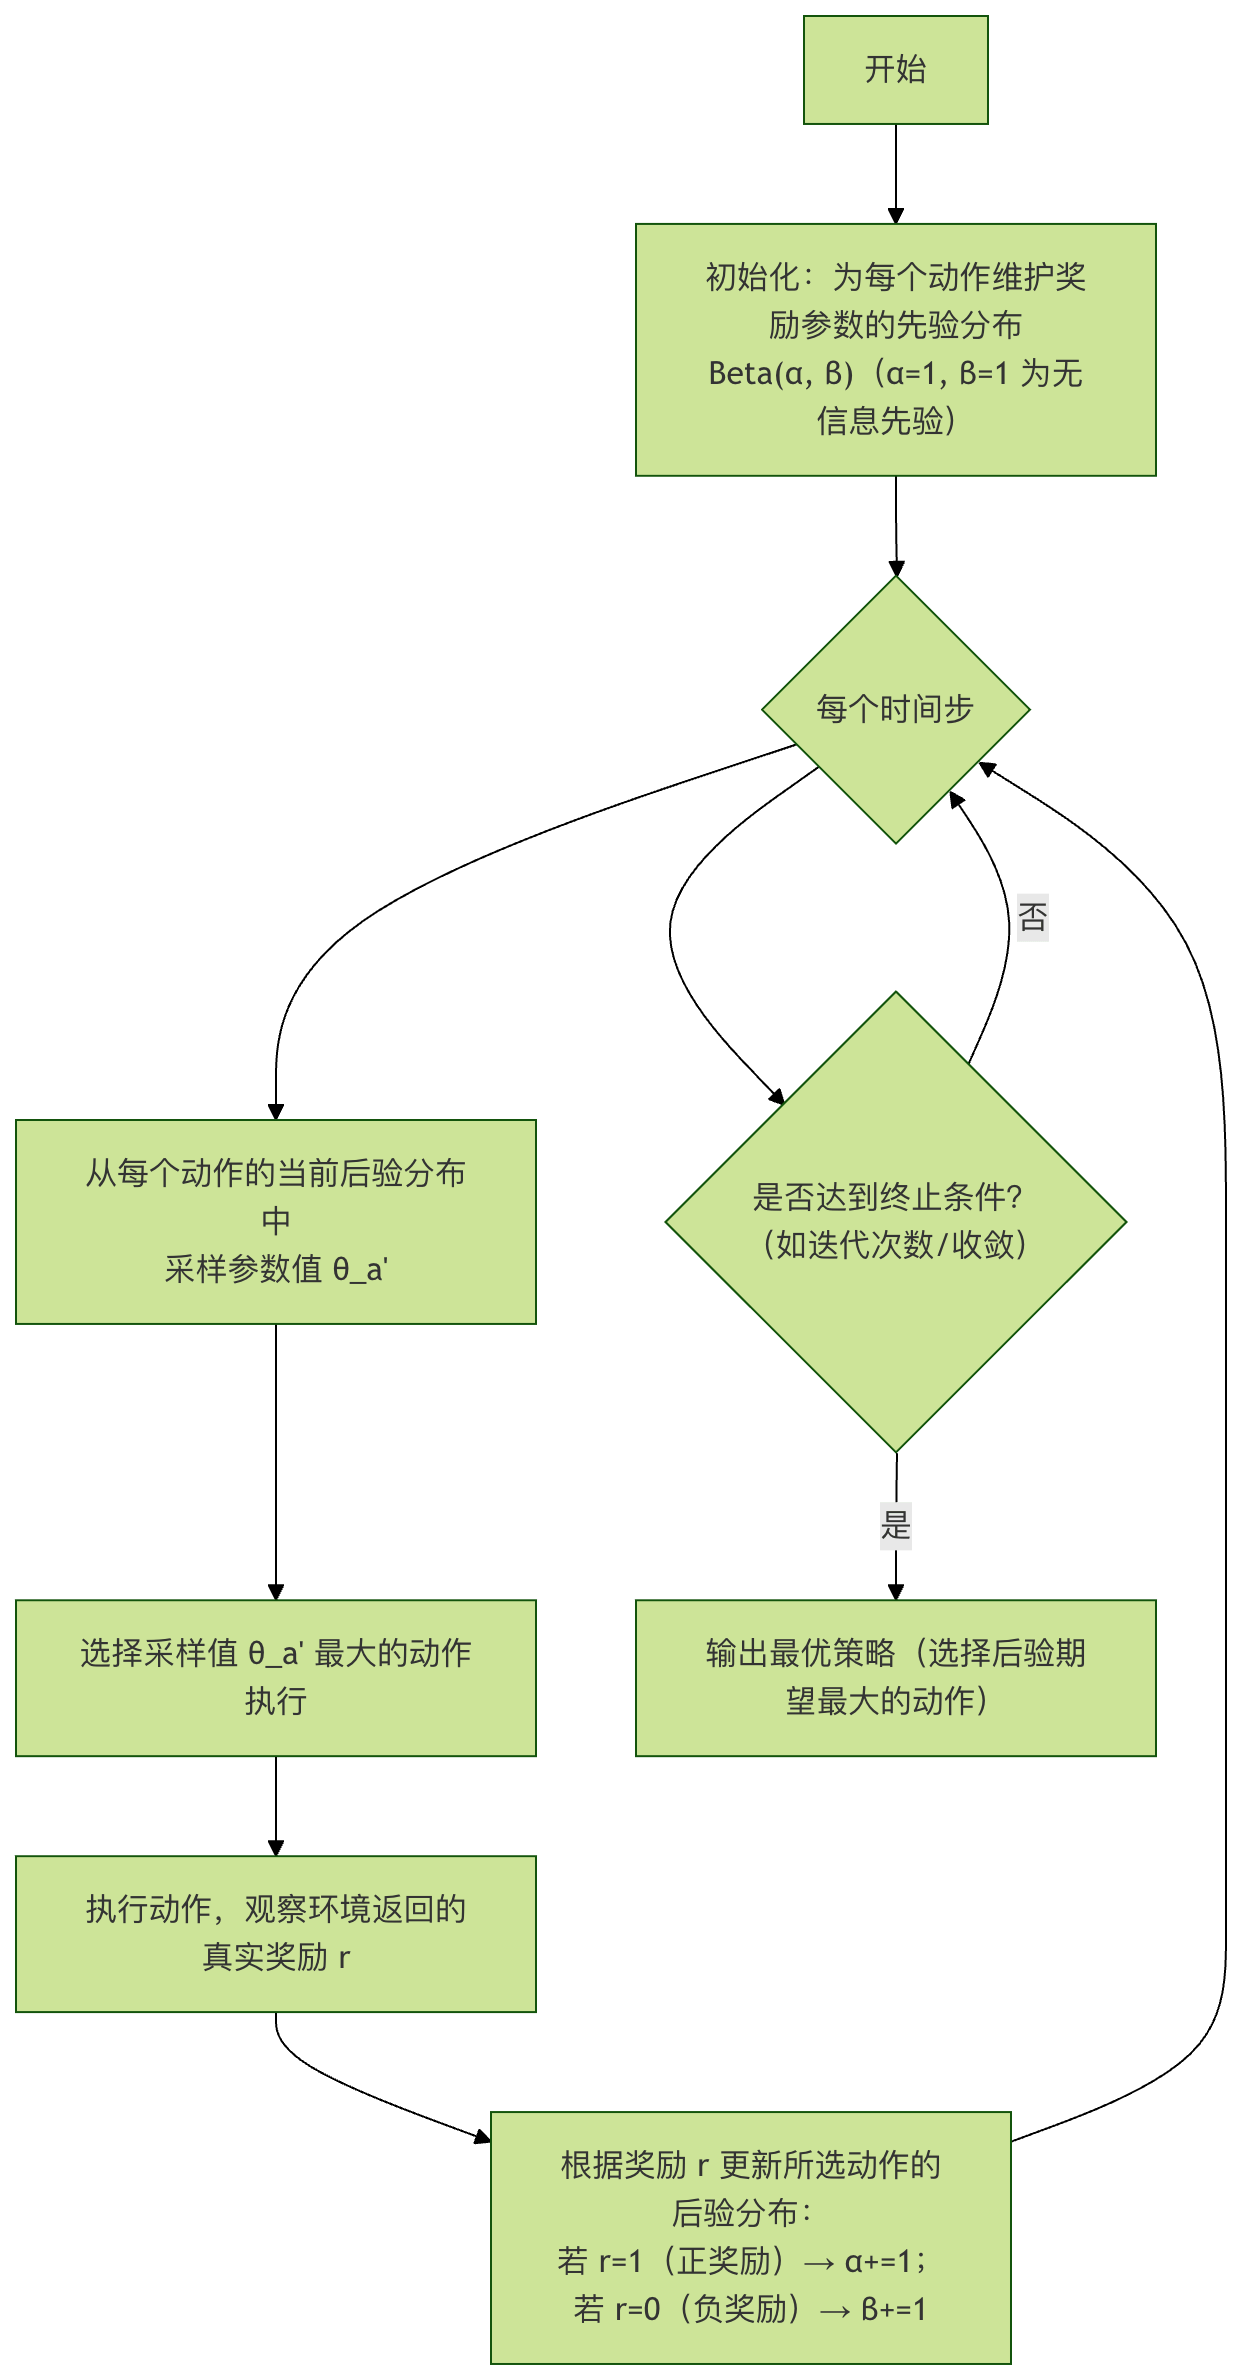
Erklärung des Verfahrens:
- Initialisierung: Für jede Aktion
awird angenommen, dass die Wahrscheinlichkeit, eine Belohnung zu erhalten,θ_aeiner Beta(α=1, β=1)-Verteilung folgt, was einem uniformen Prior entspricht. - Stichprobenziehung: Bei jedem Schritt, aus der Verteilung jeder Aktion
aaktuelle Beta(α_a, β_a)-Verteilung, unabhängig einen Wert ziehenθ_a'。 - Auswahl: Führe die Aktion mit dem gezogenen Wert aus
θ_a'der am größten ist. - Aktualisierung: Wenn eine Belohnung erhalten wird
r=1, dann der Aktionαum 1 erhöhen; wennr=0, dann denβum 1 erhöhen. Dies entspricht der Aktualisierung der Bayes-Posterior-Verteilung mit beobachteten Daten.
Vorteile: Gleicht Exploration und Exploitation auf natürliche Weise aus, hat gute theoretische Eigenschaften und funktioniert in der Praxis oft sehr gut.Nachteile: Es erfordert die Annahme der Form der Belohnungsverteilung, und die Berechnung kann komplexer sein als bei ε-greedy.
Dynamisches Gleichgewicht zwischen Exploration und Exploitation
In praktischen Anwendungen sind Explorationsstrategien oft nicht statisch, sondern werden dynamisch angepasst, während der Lernprozess des Agenten fortschreitet.
- Starke Exploration in der frühen Phase: Zu Beginn des Trainings weiß der Agent nichts über die Umgebung, daher sollte eine höhere Explorationsrate festgelegt werden (z. B. eine größere
εoderc), um in großem Umfang Daten zu sammeln. - Starke Ausnutzung in der späteren Phase: Im weiteren Verlauf des Lernens wird das Verständnis des Agenten für die Umgebung genauer, und die Explorationsrate sollte allmählich reduziert werden (zum Beispiel, lassen Sie
εmit der Zeit abklingen), wobei der Fokus darauf verlagert wird, die bereits erlernten hervorragenden Strategien auszunutzen, um stetig hohe Erträge zu erzielen.
Dieser dynamische Anpassungsprozess simuliert den menschlichen Lernprozess vom "ausgiebigen Ausprobieren zur kontinuierlichen Verbesserung".
Praktische Übung: Vergleich verschiedener Strategien
Lassen Sie uns ein einfaches Experiment entwerfen, um die Leistung von ε-greedy- und UCB-Strategien beim klassischen "Multi-Armed-Bandit"-Problem zu vergleichen.
Aufgabe:
- Erstellen Sie einen Banditen mit 5 Armen, bei dem die wahren Belohnungswahrscheinlichkeiten jedes Arms jeweils
[0.1, 0.2, 0.8, 0.5, 0.3]。 - Implementieren Sie die ε-greedy-Strategie (ε=0.1) bzw. die UCB-Strategie (c=2).
- Lassen Sie jede Strategie 2000 Schritte laufen und zeichnen Sie bei jedem Schritt die unmittelbare Belohnung und die kumulierte Belohnung auf.
- Zeichnen Sie die Kurve der kumulierten Belohnung über die Zeitschritte und beobachten Sie, welche Strategie schneller und stabiler eine höhere Gesamtbelohnung erzielen kann.
Denken Sie nach:
- Versuchen Sie, die Parameter ε und c anzupassen, und beobachten Sie, welchen Einfluss sie auf die Ergebnisse haben?
- Wenn der Abstand zwischen dem optimalen Arm (Wahrscheinlichkeit 0.8) und dem suboptimalen Arm (Wahrscheinlichkeit 0.5) kleiner wird, wie wird sich die Leistung der Strategien ändern?
- In komplexeren Reinforcement-Learning-Umgebungen (wie z. B.
Gym), wie können diese Explorationsstrategien mit Q-Learning, DQN und anderen Algorithmen kombiniert werden?