Kreuzvalidierung
In der Praxis des maschinellen Lernens stehen wir oft vor einem Kernproblem: Wie bewertet man die Qualität eines Modells? Man könnte daran denken, einen Teil der Daten zum Trainieren des Modells zu verwenden und dann einen anderen Teil ungesehener Daten zum Testen seiner Leistung zu nutzen. Diese Idee ist völlig richtig, aber wie können wir das Modell zuverlässiger und stabiler bewerten? Das istKreuzvalidierungdas Kernproblem, das gelöst werden muss.
Einfach gesagt ist die Kreuzvalidierung eine statistische Methode, die die Generalisierungsfähigkeit eines Modells (d. h. seine Fähigkeit, mit neuen Daten umzugehen) bewertet, indem sie den Datensatz wiederholt aufteilt. Sie ist wie eine Probeprüfung für das Modell, bei der mehrere verschiedene Probeklausuren (Datenuntermengen) verwendet werden, um sein wahres Niveau zu überprüfen und Fehlurteile aufgrund der Zufälligkeit einer einzelnen Prüfung zu vermeiden.
Dieser Artikel führt Sie dazu, die Prinzipien, gängigen Methoden und die Schlüsselrolle der Kreuzvalidierung bei der Modelloptimierung und im Engineering eingehend zu verstehen.
Warum brauchen wir Kreuzvalidierung?
Bevor wir in technische Details eintauchen, wollen wir ihre Notwendigkeit zunächst anhand einer Analogie verstehen.
Stellen Sie sich vor, Sie sind ein Student, der kurz vor einer wichtigen Matheprüfung steht. Es gibt zwei Methoden, um Ihr Niveau zu bewerten:
- Methode A (einfache Aufteilung): Der Lehrer wählt zufällig 10 Fragen aus dem Aufgabenpool aus, die Sie in einer Probeklausur bearbeiten, und verwendet dann diese Punktzahl, um Ihre Endnote vorherzusagen.
- Methode B (Kreuzvalidierung): Der Lehrer teilt den Aufgabenpool in 5 Teile. Beim ersten Mal verwenden Sie die Teile 2, 3, 4, 5, um Sie zu trainieren, und Teil 1 zum Testen; beim zweiten Mal verwenden Sie die Teile 1, 3, 4, 5, um Sie zu trainieren, und Teil 2 zum Testen ... Wiederholen Sie dies 5 Mal. Bilden Sie schließlich den Durchschnitt der 5 Testergebnisse, um Sie zu bewerten.
Welche Methode ist zuverlässiger? OffensichtlichMethode B。
- Methode ADas Risiko von Methode A besteht darin: Wenn die 10 ausgewählten Fragen zufällig die Typen sind, in denen Sie gut sind, wird Ihr Ergebnis in der Probeprüfung künstlich erhöht, was zu übermäßigem Optimismus bezüglich Ihres wahren Niveaus führt; umgekehrt, wenn die ausgewählten Fragen alle Ihre blinden Flecken sind, fällt das Ergebnis zu niedrig aus, was zu übermäßigem Pessimismus führt. Die Bewertungsergebnisse schwanken stark und sind instabil.
- Methode BDurch mehrere unterschiedliche Trainings-/Testkombinationen ermöglicht sie Ihnen, verschiedene Fragetypen in der Fragenbank zu erleben, und die erzielte Durchschnittspunktzahl ist repräsentativer für Ihr allgemeines, stabiles Niveau und sagt das Ergebnis der Abschlussprüfung genauer voraus.
Im maschinellen Lernen:
- die Fragenbankist unsergesamter Datensatz。
- der Studentist das Modell, das wir trainieren wollen,ein maschinelles Lernmodell。
- das Ergebnis der Probeprüfungist dieBewertungsmetrik des Modells(wie Genauigkeit, mittlerer quadratischer Fehler usw.).
- die Abschlussprüfungist die zukünftige Leistung des Modells aufrealen, ungesehenen Daten.
Das Kernziel der Kreuzvalidierung ist es, für die Generalisierungsfähigkeit des Modells einerobustere und weniger verzerrte Schätzungbereitzustellen und uns dadurch zu helfen, eine zuverlässigere Modellauswahl, Parameterabstimmung und Leistungsbewertung durchzuführen.
Gängige Methoden der Kreuzvalidierung
Für die Kreuzvalidierung gibt es mehrere Implementierungsmethoden, die für unterschiedliche Daten und Szenarien geeignet sind. Die gebräuchlichsten werden im Folgenden vorgestellt.
1. Hold-Out-Validierung
Dies ist die einfachste und intuitivste Methode.
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# Ausführbare Daten erstellen
# 200 Stichproben, 4 Merkmale, binäre Klassifikation
np.random.seed(42)
X = np.random.randn(200, 4)
y = (X[:, 0] + X[:, 1] * 0.7 - X[:, 2] * 0.4 > 0).astype(int)
# 1. Trainings- und Testsatz aufteilen (7:3)
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# 2. Modell trainieren
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
# 3. Auf dem Testsatz auswerten
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"Modellgenauigkeit: {accuracy:.4f}")
Ausgabeergebnis:
模型准确率: 0.8833
Prozessbeschreibung:
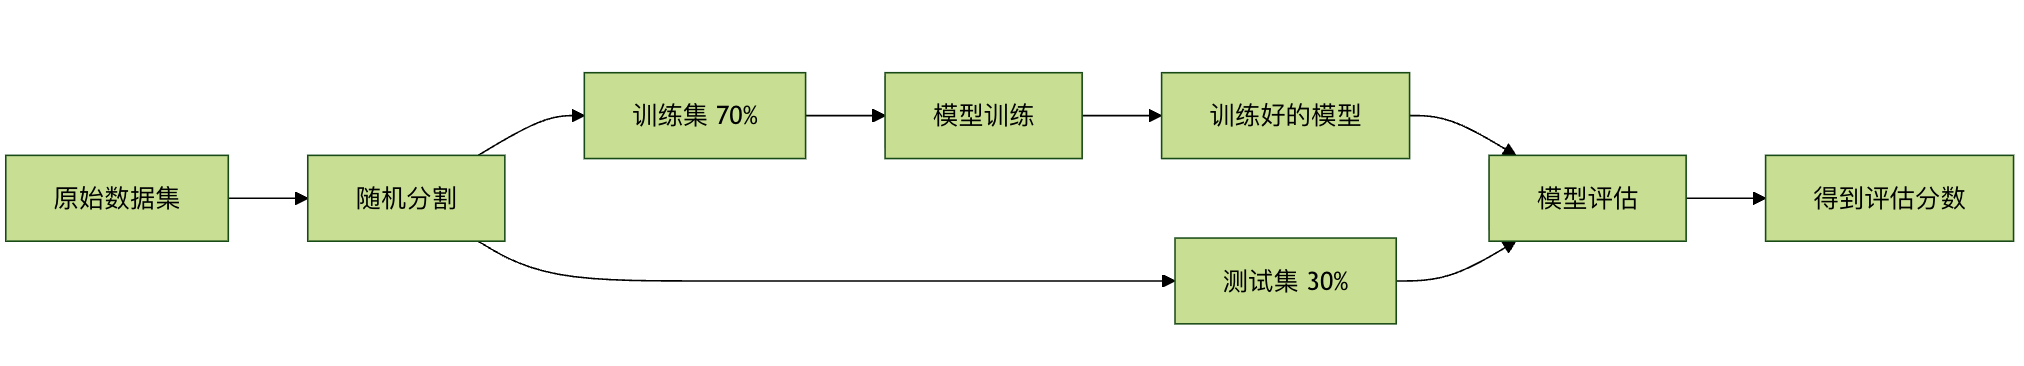
-
Vorteile:Einfach und schnell, geringer Rechenaufwand.
- Nachteile:Das Bewertungsergebnis hängt stark von einer einzelnen zufälligen Aufteilung ab. Wenn die Aufteilung ungünstig ist, ist das Bewertungsergebnis möglicherweise nicht repräsentativ. Da das Testset zudem nur einmal verwendet wird, ist die Datennutzung unzureichend.
2. K-Fold-Kreuzvalidierung
Dies ist derzeit die am häufigsten verwendete und standardmäßige Kreuzvalidierungsmethode.
Prinzip:Teile den Datensatzgleichmäßigzufällig in K disjunkte Teilmengen (Folds) auf.
In jedem Experiment wird abwechselnd eine Teilmenge als Testset und die verbleibenden K-1 Teilmengen als Trainingsset verwendet. Dieser Prozess wird K-mal wiederholt, wobei sichergestellt wird, dass jede Teilmenge einmal als Testset verwendet wird. Schließlich erhalten wir K Bewertungsergebnisse und bilden deren Durchschnitt als endgültige Leistungsschätzung des Modells.
Beispiel
from sklearn.model_selection import cross_val_score, KFold
from sklearn.linear_model import LogisticRegression
# Ausführbare Beispieldaten konstruieren
# 100 Beispiele, 4 Merkmale, binäre Klassifikationslabels
np.random.seed(42)
X = np.random.randn(100, 4)
y = (X[:, 0] + X[:, 1] * 0.5 > 0).astype(int)
# 1. Modell initialisieren
model = LogisticRegression(max_iter=1000)
# 2. K-Fold-Kreuzvalidierungs-Splitter definieren (K=5)
kfold = KFold(n_splits=5, shuffle=True, random_state=42)
# 3. Kreuzvalidierung durchführen
scores = cross_val_score(model, X, y, cv=kfold, scoring='accuracy')
print(f"Genauigkeit pro Fold: {scores}")
print(f"Durchschnittliche Genauigkeit: {scores.mean():.4f} (+/- {scores.std() * 2:.4f})")
每次折叠的准确率: [0.9  0.95 1.   0.95 1.  ]
平均准确率: 0.9600 (+/- 0.0748)
Schematische Darstellung des Ablaufs, wenn K=5:

Wie wählt man den K-Wert?
- Übliche Werte: 5 oder 10. Dies ist ein empirischer Kompromiss.
- Kleinerer K-Wert (z. B. 3): Das Trainingsset ist größer, aber die Anzahl der Bewertungen ist gering, und die Varianz der Schätzung kann groß sein.
- Größerer K-Wert (z. B. 10 oder 20): Die Bewertung ist stabiler (kleine Varianz), aber das Trainingsset kommt jedes Mal näher an den ursprünglichen Datensatz heran, was zu einer optimistischeren Schätzverzerrung führen kann, und der Rechenaufwand steigt deutlich.
- Extremer Fall K = N (Anzahl der Stichproben): Dies ist Leave-one-out, wobei jedes Mal mit nur einer Stichprobe getestet wird. Die Bewertung ist am unverzerrtesten, aber der Rechenaufwand ist extrem hoch; wird nur für sehr kleine Datensätze verwendet.
Vorteile:Die Daten werden vollständig genutzt, und die Bewertungsergebnisse sind stabil und zuverlässig.
Nachteile:Der Rechenaufwand ist K-mal so hoch wie bei der Hold-out-Methode.
3. Stratifizierte K-Fold-Kreuzvalidierung
Dies ist eine wichtige Variante der K-Fold-Kreuzvalidierung, besonders geeignet fürKlassifikationsproblemeMittelbei unausgewogener KlassenverteilungDatensätzen.
Gelöstes Problem:Bei der gewöhnlichen K-Fold-Kreuzvalidierung kann eine zufällige Aufteilung dazu führen, dass der Anteil einer bestimmten Klasse in einigen Folds stark vom ursprünglichen Datensatz abweicht. Wenn ein Datensatz beispielsweise 90% positive Klasse und 10% negative Klasse hat, kann eine zufällige Aufteilung in 5 Folds dazu führen, dass ein Fold vollständig positiv ist und keine negative Klasse enthält, was die Bewertung in diesem Fold bedeutungslos macht.
Die stratifizierte K-Fold-Kreuzvalidierung stellt sicher, dass beim Aufteilen der Anteil der Stichproben jeder Klasse in jedem Fold mit dem Gesamtanteil im ursprünglichen Datensatz übereinstimmt.
Beispiel
# Die Verwendung ist fast die gleiche wie bei KFold; ersetzen Sie einfach den Splitter.
stratified_kfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(model, X, y, cv=stratified_kfold, scoring='accuracy')
Für Klassifikationsaufgaben, insbesondere wenn die Klassen unausgewogen sind,verwenden Sie vorrangigStratifiedKFold。
4. Zeitreihen-Split
FürZeitreihendatenist die Reihenfolge der Daten entscheidend (die Daten von morgen hängen von denen von heute und gestern ab). Wir können die Daten nicht zufällig mischen; wir müssen die zeitliche Reihenfolge beibehalten.
Das Prinzip ist: Das Trainingsset besteht immer aus zeitlich früheren Daten, und das Testset sind die unmittelbar darauffolgenden Daten. Mit zunehmender Anzahl von Folds erweitert sich das Fenster des Trainingssets kontinuierlich.
Beispiel
from sklearn.model_selection import TimeSeriesSplit
# Ausführbare Zeitreihendaten erstellen
# 100 Zeitpunkte, 2 Merkmale
np.random.seed(42)
X = np.random.randn(100, 2)
# TimeSeriesSplit-Beispiel
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
print(f"Indexbereich des Trainingssets: {train_index)
print(f"Indexbereich des Testsets: {test_index)
print("---")
Ausgabe:
训练集索引范围: 0 到 19
测试集索引范围: 20 到 35
---
训练集索引范围: 0 到 35
测试集索引范围: 36 到 51
---
训练集索引范围: 0 到 51
测试集索引范围: 52 到 67
---
训练集索引范围: 0 到 67
测试集索引范围: 68 到 83
---
训练集索引范围: 0 到 83
测试集索引范围: 84 到 99
---
Anwendungen der Kreuzvalidierung im Modell-Engineering
Kreuzvalidierung ist nicht nur ein Bewertungswerkzeug, sondern auch ein Kernbestandteil des Modelloptimierungs- und Modellengineering-Prozesses.
Anwendung 1: Modellauswahl und Modellvergleich
Wenn wir unter mehreren Kandidatenmodellen (wie lineare Regression, Entscheidungsbaum, Support Vector Machine) wählen müssen, können wir nicht das Testset zur Auswahl verwenden (andernfalls wird das Testset Teil des Trainingsprozesses und "leakt" Informationen). Die richtige Vorgehensweise ist:
- Für jedes Kandidatenmodell: Verwende auf demTrainingssatzKreuzvalidierung, um eine Schätzung seiner Leistung zu erhalten.
- Vergleiche die Durchschnittswerte dieser Kreuzvalidierungsergebnisse und wähle das Modell mit dem höchsten Wert aus.
- Schließlich, trainiere das ausgewählte Modell auf dem gesamten Trainingssatz neu und verwendeden unabhängigen Testsatz, um eine abschließende einmalige Bewertung durchzuführen und diesen Wert als endgültige Leistung des Modells anzugeben.
Beispiel
from sklearn.model_selection import cross_val_score, StratifiedKFold, train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
# Lauffähige Klassifikationsdaten erstellen
# 200 Stichproben, 4 Merkmale, binäre Klassifikation
np.random.seed(42)
X = np.random.randn(200, 4)
y = (X[:, 0] + X[:, 1] * 0.8 - X[:, 2] * 0.3 > 0).astype(int)
# Trainingssatz / Testsatz aufteilen
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.25, random_state=42, stratify=y
)
# Modelle definieren
models = {
'Logistische Regression': LogisticRegression(max_iter=1000),
'SVM': SVC(),
'Entscheidungsbaum': DecisionTreeClassifier()
}
# Stratifizierte K-fache Kreuzvalidierung
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
results = {}
# Kreuzvalidierungsbewertung
for name, model in models.items():
scores = cross_val_score(model, X_train, y_train, cv=cv, scoring='accuracy')
results[name] = scores.mean()
print(f"{name} durchschnittliche Genauigkeit: {scores.mean():.4f}")
# Bestes Modell auswählen
best_model_name = max(results, key=results.get)
print(f"\nLaut Kreuzvalidierung ist das beste Modell: {best_model_name}")
# Abschließende Bewertung des Trainings- und Testsets
best_model = models[best_model_name]
best_model.fit(X_train, y_train)
final_score = best_model.score(X_test, y_test)
print(f"Endgültige Genauigkeit des besten Modells auf dem unabhängigen Testset: {final_score:.4f}")
Ausgabe:
Logistic Regression 平均准确率: 0.9533
SVM 平均准确率: 0.9400
Decision Tree 平均准确率: 0.8467

根据交叉验证,最佳模型是: Logistic Regression
最佳模型在独立测试集上的最终准确率: 1.0000
Anwendung 2: Hyperparameter-Tuning
Hyperparameter sind Parameter, die vor dem Modelltraining festgelegt werden müssen (wie die Anzahl der Bäume in einem Random Forestn_estimators, der Penalty-Koeffizient von SVMC). Der Prozess, die beste Hyperparameter-Kombination zu finden, wirdHyperparameter-Tuninggenannt, und Kreuzvalidierung ist seine Standardbewertungsmethode.
Die am häufigsten verwendete Methode istRastersuche-Kreuzvalidierung。
Beispiel
from sklearn.model_selection import GridSearchCV, train_test_split
from sklearn.ensemble import RandomForestClassifier
# Lauffähige Klassifikationsdaten erstellen
# 300 Stichproben, 5 Merkmale, binäre Klassifikation
np.random.seed(42)
X = np.random.randn(300, 5)
y = (X[:, 0] * 0.6 + X[:, 1] * 0.4 - X[:, 2] > 0).astype(int)
# Trainingssatz / Testsatz aufteilen
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.25, random_state=42, stratify=y
)
# 1. Parameterraster
param_grid = {
'n_estimators': [50, 100, 200],
'max_depth': [None, 10, 20],
'min_samples_split': [2, 5, 10]
}
# 2. Basismodell
rf = RandomForestClassifier(random_state=42)
# 3. GridSearchCV
grid_search = GridSearchCV(
estimator=rf,
param_grid=param_grid,
cv=5,
scoring='accuracy',
n_jobs=-1
)
# 4. Grid-Suche (nur Trainingssatz)
grid_search.fit(X_train, y_train)
# 5. Optimale Parameter und Score
print(f"Beste Parameter: {grid_search.best_params_}")
print(f"Bester Kreuzvalidierungs-Score: {grid_search.best_score_:.4f}")
# 6. Testset-Bewertung
best_rf_model = grid_search.best_estimator_
test_accuracy = best_rf_model.score(X_test, y_test)
print(f"Genauigkeit des optimierten Modells auf dem Testset: {test_accuracy:.4f}")
Ausgabe:
最佳参数: {'max_depth': None, 'min_samples_split': 2, 'n_estimators': 100}
最佳交叉验证分数: 0.9067
调优后模型在测试集上的准确率: 0.9467
Wichtige Punkte: GridSearchCVIntern ist die Kreuzvalidierung bereits abgeschlossen. Sie unterteilt den Trainingssatz weiterX_trainin kleinere "Trainings-Teilmengen" und "Validierungs-Teilmengen", um Parameter zu bewerten, sodass das, was wir übergeben,X_traindem gesamten "Fragenkatalog" entspricht, währendX_testist die "ultimative Prüfungsfrage", die nie am Tuning-Prozess teilgenommen hat und für die abschließende Verifikation verwendet wird.
Übungsaufgaben und Zusammenfassung
Praktische Übung
- Grundlegende Implementierung: Verwenden Sie
sklearnden integrierten Iris-Datensatz, jeweils mittrain_test_splitundcross_val_score(K=5), um ein Modell zu trainieren und zu bewertenKNeighborsClassifier, und vergleichen Sie die von den beiden Bewertungsmethoden erhaltenen Scores. - Modellvergleich: Verwenden Sie auf demselben Datensatz die Kreuzvalidierung, um
SVC、RandomForestClassifierundGradientBoostingClassifierdie Leistung der Modelle zu vergleichen. - Parameter-Tuning: Für
SVCdas Modell entwerfen Sie ein Parameterraster (einschließlichCundgamma), verwenden SieGridSearchCVum die optimalen Parameter zu finden.
Zusammenfassung der wichtigsten Punkte
- Zweck der Kreuzvalidierung: Eine robustere und zuverlässigere Schätzung der Generalisierungsfähigkeit des Modells zu erhalten.
- Kernmethode:K-Fold-Kreuzvalidierungist der Goldstandard; bei Klassifikationsproblemen sollte vorrangig diestratifizierte K-Fold-Kreuzvalidierung verwendet werden。
- Hauptunterschied:
- Trainingsset/Validierungsset: Wird für das Modelltraining unddie Evaluierung während des Entwicklungsprozesses verwendet(z. B. Auswahl von Modellen, Parameteroptimierung). Die Kreuzvalidierung findet in dieser Phase statt.
- Testset: Wird erst nach Abschluss der gesamten Entwicklung fürden abschließenden einmaligen Leistungsbericht verwendet. Es muss streng isoliert sein und darf niemals für irgendeine Entscheidungsfindung verwendet werden.
- Rolle im Engineering: Die Kreuzvalidierung ist die Brücke zwischen Modellentwicklung (Training, Tuning) und Modellevaluierung (Testing) und ist der Eckpfeiler, um Modellqualität zu gewährleisten, Overfitting zu verhindern und eine zuverlässige Modellauswahl und -optimierung zu erreichen.