Verlustfunktionen und Gradienten
In diesem Kapitel werden wir zwei entscheidende Kernkonzepte untersuchen:VerlustfunktionundGradient, die den Grundpfeiler bilden, der es Machine-Learning-Algorithmen ermöglicht, zulernenund zuverbessern.
Stellen Sie sich vor, Sie lernen, einen Basketball zu werfen. Nach jedem Wurf beobachten Sie, ob der Ball hineinging, nach links oder nach rechts abwich. Der Abstand zwischen diesem beobachteten Ergebnis und einem perfekten Wurf ist IhrVerlust. Um beim nächsten Mal genauer zu werfen, passen Sie Ihre Haltung und Kraft entsprechend der Richtung und Größe dieser Abweichung an. DiesRichtung und Größe der Anpassungist ähnlich wie derGradient。
Beim maschinellen Lernen ist das Modell derLernende, die Verlustfunktion misst seinenFehlergrad, und der Gradient sagt ihm, wie es sich verbessern kann. Das Verständnis dieser Konzepte vermittelt Ihnen die Kernlogik, wie maschinelles Lernen funktioniert.
I. Verlustfunktionen: Das Zeugnis des Modells
1.1 Was ist eine Verlustfunktion?
Eine Verlustfunktion, manchmal auchKostenfunktionoderZielfunktiongenannt, ist eine Funktion, mit derdie Differenz zwischen Modellvorhersagen und wahren Werten quantifiziert wird.
- Kernrolle: Sie gibt der Vorhersageleistung des Modells eine konkrete "Bewertung". Je niedriger diese Bewertung, desto genauer die Vorhersagen des Modells; je höher die Bewertung, desto größer der Vorhersagefehler.
- Analogie: Ähnlich wie bei einer Prüfung ist der "Wert" der Verlustfunktion die Prüfungsnote des Modells. Unser ultimatives Ziel ist es, diesen Wert (Verlust) durch "Lernen" (Anpassen der Modellparameter) immer weiter zu senken.
1.2 Beispiele für gängige Verlustfunktionen
Verschiedene Aufgaben erfordern unterschiedlicheBewertungsstandards. Hier sind zwei der grundlegendsten Verlustfunktionen:
Mittlerer quadratischer Fehler- Geeignet für Regressionsprobleme (Vorhersage kontinuierlicher Werte, wie Hauspreise, Temperatur)
Der mittlere quadratische Fehler berechnet denDurchschnitt der quadrierten Differenzen zwischen vorhergesagten Werten und wahren Werten über alle Stichproben。
Formel: MSE = (1/n) * Σ(真实值ᵢ - 预测值ᵢ)²
n: Anzahl der StichprobenΣ: SummenzeichenTrue valueᵢ: wahrer Wert der i-ten StichprobePredicted valueᵢ: vom Modell vorhergesagter Wert für die i-te Stichprobe
Eigenschaften: Da es die Quadrierung verwendet, bestraft es größere Fehler stärker (bei einem Fehler von 2 ist der quadrierte Beitrag 4; bei einem Fehler von 10 ist der quadrierte Beitrag bis zu 100).
Codebeispiel:
Beispiel
# Angenommen, wir haben wahre und vorhergesagte Werte für 5 Stichproben
y_true = np.array([3, -0.5, 2, 7, 4]) # Wahre Werte
y_pred = np.array([2.5, 0.0, 2, 8, 5]) # Vorhergesagte Werte
# MSE manuell berechnen
n = len(y_true)
squared_errors = (y_true - y_pred) ** 2 # Berechne den quadratischen Fehler für jede Stichprobe
mse_manual = np.sum(squared_errors) / n # Summieren und den Mittelwert bilden
print(f"Manuell berechnete MSE: {mse_manual}")
# Mit der sklearn-Bibliotheksfunktion überprüfen
from sklearn.metrics import mean_squared_error
mse_sklearn = mean_squared_error(y_true, y_pred)
print(f"Von Sklearn berechnete MSE: {mse_sklearn}")
Cross-Entropy-Verlust- Geeignet für Klassifikationsprobleme (Vorhersage von Kategorien, z. B. ob ein Bild eine Katze oder einen Hund zeigt)
Kreuzentropie misst die Differenz zwischen dervom Modell vorhergesagten Wahrscheinlichkeitsverteilungundund der wahren Wahrscheinlichkeitsverteilung. Bei der binären Klassifikation ist die wahre Verteilung normalerweise[1, 0](ist Kategorie A) oder[0, 1](ist Kategorie B).
Formel für binäre Klassifikation (Log Loss):
Log Loss = - (1/n) * Σ [真实值ᵢ * log(预测概率ᵢ) + (1 - 真实值ᵢ) * log(1 - 预测概率ᵢ)]
Intuitives Verständnis: Wenn das wahre Label 1 ist, hoffen wir, dass die vom Modell vorhergesagte Wahrscheinlichkeit ebenfalls nahe bei 1 liegt. Wenn das Modell an dieser Stelle eine sehr niedrige Wahrscheinlichkeit (z. B. 0.1) vorhersagt, dannlog(0.1)wird es eine sehr große negative Zahl; die Multiplikation mit dem vorangehenden negativen Vorzeichen führt dazu, dass der Verlustwert sehr groß wird, was auf eine starke Bestrafung hindeutet.
Codebeispiel:
Beispiel
from sklearn.metrics import log_loss
# Beispiel für binäre Klassifikation: wahre Labels (1 steht für "ja", 0 steht für "nein")
y_true_binary = np.array([1, 0, 0, 1]) # Wahre Klassen: ja, nein, nein, ja
# Vom Modell vorhergesagte Wahrscheinlichkeit für die "ja"-Klasse
y_pred_prob = np.array([0.9, 0.1, 0.2, 0.8]) # Vorhergesagte Wahrscheinlichkeiten: 0.9, 0.1, 0.2, 0.8
# sklearn verwenden, um den Cross-Entropy-Verlust (Log Loss) zu berechnen
ce_loss = log_loss(y_true_binary, y_pred_prob)
print(f"Cross-Entropy-Verlust (Log Loss): {ce_loss}")
II. Gradient: Der "Kompass", der die Optimierungsrichtung vorgibt
Jetzt wissen wir, wie man das Modell bewertet (Verlustfunktion). Die nächste entscheidende Frage ist:Wie verbessert sich das Modell anhand dieser Bewertung?Die Antwort erfolgt durch denGradienten。
2.1 Was ist ein Gradient?
Im maschinellen Lernen besteht ein Modell normalerweise aus vielenParametern(oderGewichten). Wir können dieVerlustfunktion L auffassenals Funktion all dieser Parameter:L(w1, w2, ..., wn)。
- Der Gradientist der Vektor, der durch diepartiellen Ableitungenvonder Verlustfunktion nach jedem Parameter gebildet wird.
- Mathematische Darstellung:
∇L = [∂L/∂w1, ∂L/∂w2, ..., ∂L/∂wn] - Kernbedeutung:
- Richtung: Die Richtung, in die der Gradientenvektor zeigt, ist die Richtung, in der die Verlustfunktionam schnellsten ansteigtan diesem Punkt.
- Größe: Der Absolutwert jeder partiellen Ableitung repräsentiert dieSensitivität。
2.2 Warum können Gradienten die Optimierung leiten?
Unser Ziel ist es, die Verlustfunktion zuminimieren. Da der Gradient in die Richtung zeigt, in der der Verlust am schnellsten zunimmt, ist seine entgegengesetzte Richtung-∇List natürlicherweise die Richtung, in der der Verlustam schnellsten abnimmt.
Der Optimierungsprozess (Gradientenabstieg) lässt sich anschaulich verstehen als:
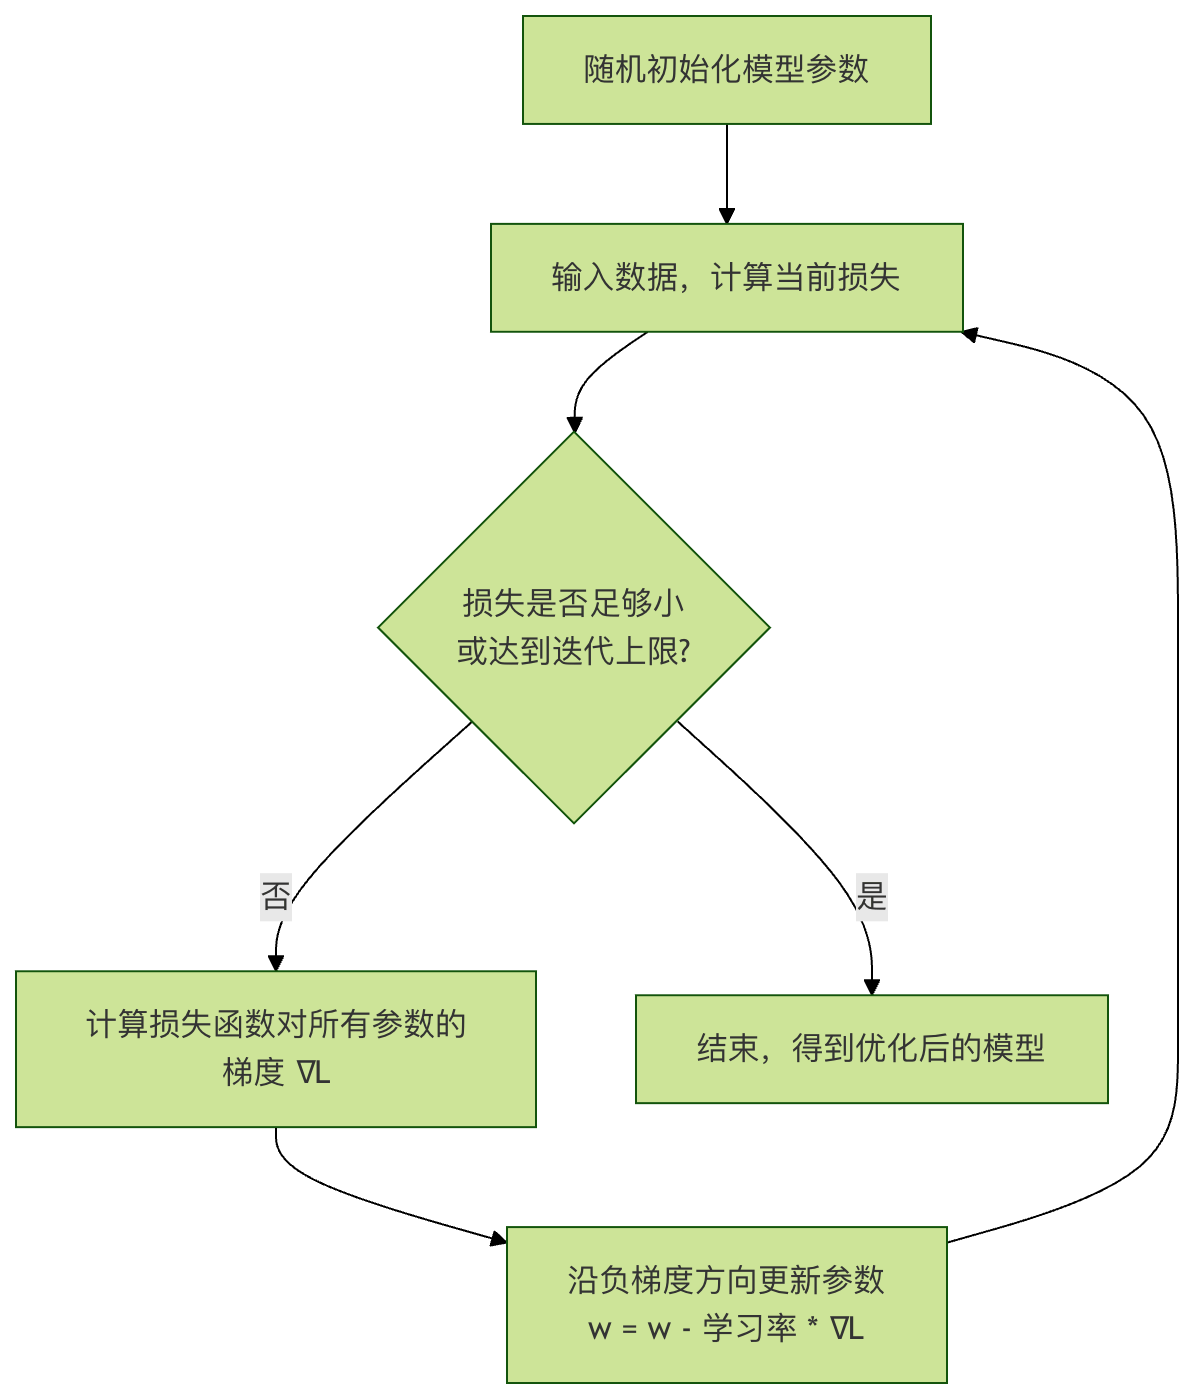
mit verbundenen Augen auf einem Berghang eines Tals (Verlustfläche) zu stehen und den Grund des Tals (den Punkt des minimalen Verlusts) erreichen zu wollen. Vor jedem Schritt ertastet man mit den Füßen, welche Richtung um einen herum die steilste ist (den Gradienten berechnen), und geht dann in die steilstebergabwärts gerichtete Richtung(negative Gradientenrichtung), um einen Schritt zu machen (Parameter aktualisieren). Wenn man diesen Vorgang wiederholt, erreicht man schließlich den Grund des Tals.
Dieser Prozess lässt sich durch das folgende Flussdiagramm zusammenfassen:
2.3 Ein einfaches Beispiel für Gradientenabstieg
Verwenden wir ein sehr einfaches Beispiel — ein lineares Modell mit nur einem Parameterwum den Gradientenabstieg zu demonstrieren.
Angenommen, unsere Verlustfunktion istL(w) = w². Offensichtlich, wennw = 0, ist der Verlust minimal.
- Berechnung des Gradienten:
∇L = dL/dw = 2w - Formel zur Parameteraktualisierung:
w_new = w_old - η * (2 * w_old)ηJaLernrate, steuert, wie groß jeder Schritt ist.
Beispiel
import matplotlib.pyplot as plt
# Definiere die Verlustfunktion L(w) = w^2
def loss(w):
return w ** 2
# Definiere den Gradienten dL/dw = 2*w
def gradient(w):
return 2 * w
# Gradientenabstiegsalgorithmus
def gradient_descent(start_w, learning_rate, iterations):
w = start_w
w_history = [w] # Zeichne den Verlauf der w-Änderungen auf
loss_history = [loss(w)] # Zeichne den Verlauf der Verluständerungen auf
for i in range(iterations):
grad = gradient(w) # Berechne den Gradienten am aktuellen Punkt
w = w - learning_rate * grad # Aktualisiere die Parameter entlang der negativen Gradientenrichtung
w_history.append(w)
loss_history.append(loss(w))
return w_history, loss_history
# Gradientenabstieg ausführen: Start bei w=5, Lernrate 0.1, 20-mal iterieren
w_start = 5.0
lr = 0.1
iters = 20
w_hist, loss_hist = gradient_descent(w_start, lr, iters)
print(f"Anfängliches w: {w_hist)
print(f"Endgültiges w: {w_hist[-1]:.4f}, Endgültiger Verlust: {loss_hist[-1]:.4f}")
# Optimierungsprozess visualisieren
plt.figure(figsize=(12, 4))
# Abbildung 1: Verlustfunktionskurve und Optimierungspfad
plt.subplot(1, 2, 1)
w_vals = np.linspace(-6, 6, 100)
plt.plot(w_vals, loss(w_vals), label='L(w) = w²')
plt.scatter(w_hist, loss_hist, c='red', s=20, label='Schritte des Gradientenabstiegs')
plt.plot(w_hist, loss_hist, 'r--', alpha=0.5)
plt.xlabel('Parameter w')
plt.ylabel('Verlust L(w)')
plt.title('Gradientenabstieg auf L(w)=w²')
plt.legend()
plt.grid(True)
# Abbildung 2: Kurve des Verlustwertrückgangs über die Iterationen
plt.subplot(1, 2, 2)
plt.plot(range(len(loss_hist)), loss_hist, 'b-o')
plt.xlabel('Iteration')
plt.ylabel('Verlust')
plt.title('Verlustreduktion über Iterationen')
plt.grid(True)
plt.tight_layout()
plt.show()
Führen Sie diesen Code aus, und Sie werden sehen:
- Die linke Abbildung zeigt, wie der Parameter
wbei 5.0 beginnt und, Schritt für Schritt, die Parabel „hinunterrollt“, bis er sich schließlich dem Minimalpunkt 0 nähert. - Die rechte Abbildung zeigt, wie der Verlustwert schnell abnimmt, wenn die Anzahl der Iterationen zunimmt.
III. Wichtige Punkte und Zusammenfassung der Zusammenhänge
| Konzept | Metapher | Kernrolle | Kernpunkte |
|---|---|---|---|
| Verlustfunktion | Zeugnis / Fehlermesslineal | Bewertet quantitativ, wie gut oder schlecht die Vorhersagen des Modells sind. | 1. Verschiedene Arten von Aufgaben (Regression, Klassifikation) verwenden unterschiedliche Verlustfunktionen. 2. Je kleiner der Verlustwert, desto besser die Modellleistung. |
| Gradient | Kompass / Richtung des steilsten Abstiegs | Gibt an, wie jeder Modellparameter angepasst werden sollte, um den Verlust am schnellsten zu verringern. | 1. Er ist der Vektor der partiellen Ableitungen der Verlustfunktion nach allen Parametern. 2. Negative GradientenrichtungIst die Richtung, in der der Verlust am schnellsten abnimmt. |
| Gradientenabstieg | Methode des Bergabstiegs mit verbundenen Augen | Verwendet Gradienteninformationen, um Parameter iterativ zu aktualisieren, um den Verlust zu minimieren. | 1. LernrateIst ein zentraler Hyperparameter; zu klein macht das Lernen langsam, zu groß kann die Konvergenz verhindern. 2. Es ist der zugrunde liegende Optimierungsalgorithmus für das Training der meisten Machine-Learning-Modelle. |
Die Beziehungskette zwischen ihnen ist: Modell trifft Vorhersagen → Verlustfunktion berechnet den Fehler → Gradient des Fehlers bezüglich jedes Parameters berechnen → Parameter entlang der negativen Gradientenrichtung aktualisieren → Modell verbessert sich → Wiederholen...
Weitere Erweiterungen