Klassifikationsmetriken
In der Welt des maschinellen Lernens ist das Erstellen eines Klassifikationsmodells nur der erste Schritt. So wie ein Arzt eine Krankheit nicht allein nach Intuition beurteilen kann, brauchen auch wir eine Reihe wissenschaftlicherGesundheitscheck-Metrikenzur Bewertung der Gesundheit des Modells. Diese Metriken sindKlassifikationsmetriken, die uns sagen können, wie genau die Vorhersagen des Modells sind, was es gut macht und wo es Schwächen hat.
Heute lernen wir gemeinsam diese entscheidenden Evaluationswerkzeuge kennen.
Warum brauchen wir Klassifikationsmetriken?
Stellen Sie sich vor, Sie haben ein Modell trainiert, um zu erkennen, ob eine E-Mail Spam ist. Das Modell hat Vorhersagen für 100 E-Mails getroffen, und Sie könnten fragen:
- "Wie viele hat es korrekt vorhergesagt?" -> Das führt zurGenauigkeit。
- "Wie viele der tatsächlichen Spam-E-Mails hat es gefunden?" -> Das führt zurTrefferquote。
- "Von den E-Mails, die als Spam bezeichnet wurden, wie viele sind tatsächlich Spam?" -> Das führt zuPrecision。
Wenn wir nur danach urteilen, wie viele korrekt waren, ist das so, als würde man einen Schüler nur anhand der Gesamtpunktzahl der Prüfung bewerten und dabei viele wichtige Informationen ignorieren. Verschiedene Geschäftsszenarien haben unterschiedliche Prioritäten:
- Krankheitsdiagnose: Es ist uns wichtiger, keinen Patienten zu übersehen (hoher Recall), auch wenn dafür mehr gesunde Menschen untersucht werden müssen (etwas Precision opfern).
- Spam-Filterung: Es ist uns wichtiger, keine wichtigen E-Mails in den Junk-Ordner zu werfen (hohe Precision), auch wenn dafür einige Spam-E-Mails übersehen werden (etwas Recall opfern).
Daher benötigen wir eine Reihe von Metriken, um die Modellleistung aus verschiedenen Perspektiven umfassend zu bewerten.
Kernkonzept: Konfusionsmatrix
Fast alle Klassifikationsmetriken stammen von einem mächtigen Werkzeug ab—der Konfusionsmatrix.Sie ist eine "Panoramakarte" zum Verständnis der Vorhersageergebnisse des Modells.
Was ist eine Konfusionsmatrix?
Sie ist eine Tabelle, die alle vier möglichen Situationen zwischen den vorhergesagten Ergebnissen des Modells und den wahren Labels zeigt.
Beispiel
from sklearn.metrics import confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt
# Angenommen, wir haben wahre Labels und vorhergesagte Labels
y_true = [1, 0, 1, 1, 0, 0, 1, 0, 0, 1] # 1 steht für Spam, 0 steht für normale E-Mail
y_pred = [1, 0, 0, 1, 0, 0, 1, 1, 0, 1] # Modellvorhersagen
# Berechne die Konfusionsmatrix
cm = confusion_matrix(y_true, y_pred)
print("Konfusionsmatrix:")
print(cm)
# Die Ausgabe könnte sein:
# [[4 1] # Tatsächlich 0 (normal), 4 als 0 vorhergesagt (TN), 1 als 1 vorhergesagt (FP)
# [1 4]] # Tatsächlich 1 (Spam), 1 als 0 vorhergesagt (FN), 4 als 1 vorhergesagt (TP)
Um es besser zu verstehen, visualisieren wir es:
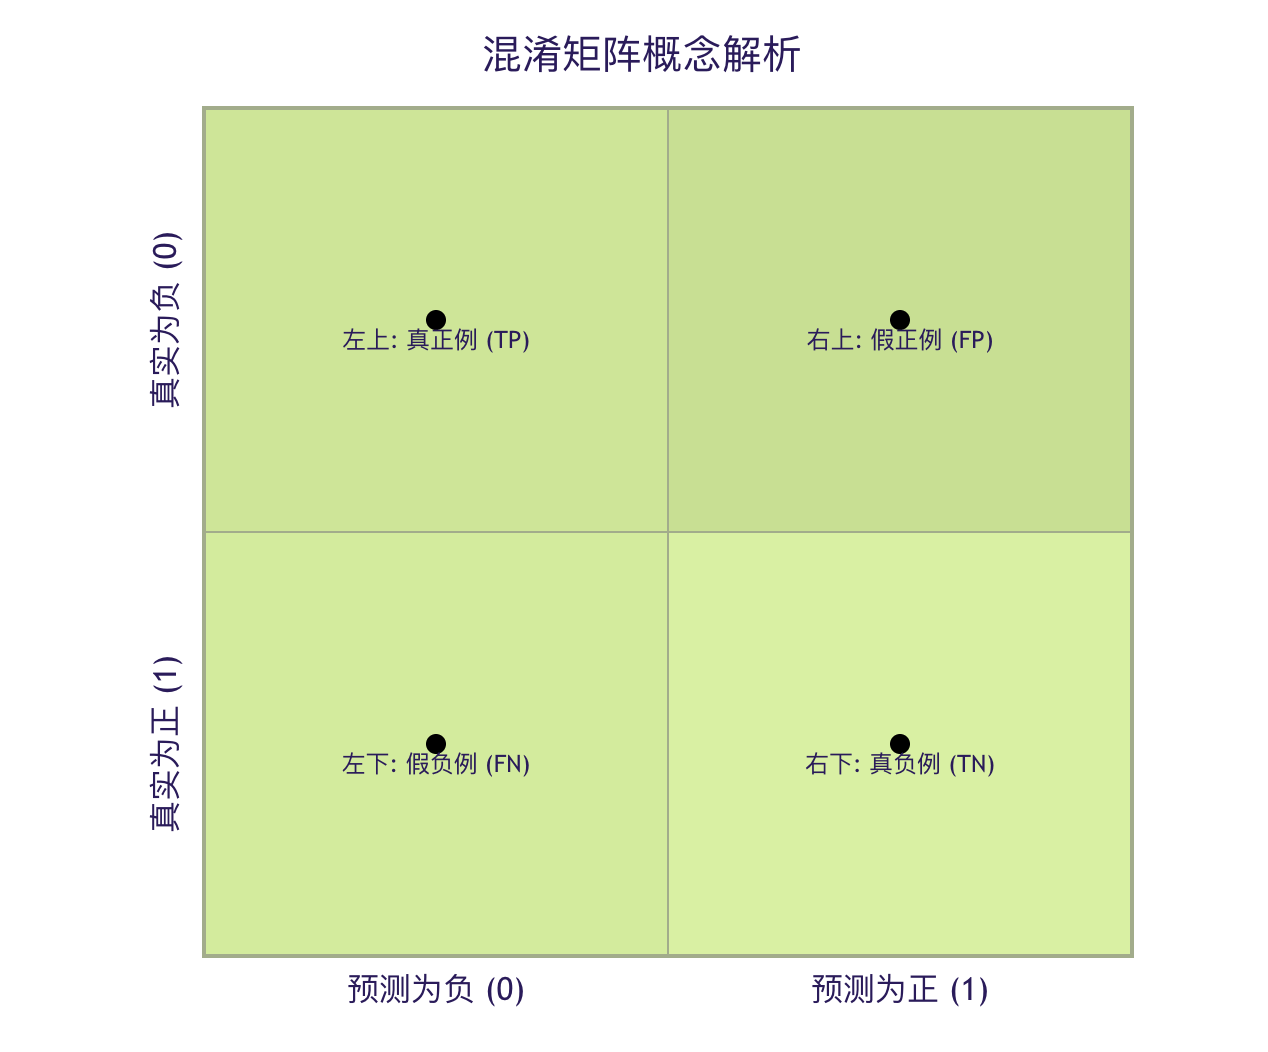
Schlüsseln wir diese vier Kernbegriffe auf:
| Begriff | Abkürzung | Bedeutung | Erklärung am Spam-Beispiel |
|---|---|---|---|
| Richtig Positiv | TP | Modell vorhergesagt alsrichtig, und die tatsächliche ist auchrichtig。 | Vom Modell korrekt identifiziertSpam-E-Mails。 |
| Falsch Positiv | FP | Modell vorhergesagt alsrichtig, aber die tatsächliche istnegativ。 | Das Modellstuft fälschlicherweiseals Spamnormale E-Mailsein. (Typ-I-Fehler) |
| Richtig Negativ | TN | Modell vorhergesagt alsnegativ, und die tatsächliche ist auchnegativ。 | Vom Modell korrekt identifiziertnormale E-Mails。 |
| Falsch-negativ | FN | Das Modell hat alsnegativvorhergesagt, aber der tatsächliche Wert istkorrekt。 | Das ModellverpasstevonSpam-E-Mails。 (Typ-II-Fehler) |
Merkhilfe:
- Wahr/Falschbezieht sich darauf,ob die Vorhersage korrekt ist。
- Positiv/Negativbezieht sich aufdas Vorhersageergebnis des Modells。
3. Detaillierte Erklärung der zentralen Klassifikationsmetriken
Mit der Konfusionsmatrix können wir verschiedene Bewertungsmetriken ableiten, genau wie beim Berechnen mit Formeln.
1. Genauigkeit - Die intuitivste Metrik
Genauigkeitmisst den Anteil korrekt vorhergesagter Beispiele an der Gesamtzahl der Beispiele.
\[ \text{Genauigkeit} = \frac{TP + TN}{TP + TN + FP + FN} \]
Beispiel
Genauigkeit = accuracy_score(y_true, y_pred)
print(f"Genauigkeit: {accuracy:.2f}") # Ausgabe: 0.80 (8/10)
Eigenschaften und Einschränkungen:
- Vorteile: Sehr intuitiv und einfach zu verstehen.
- Nachteile: Beiunausgeglichenen Daten,kann es irreführend sein. Zum Beispiel, wenn 99% der E-Mails normal sind, kann ein "dummes Modell", das alle E-Mails als normal vorhersagt, ebenfalls 99% Genauigkeit erreichen, aber es kann nicht eine einzige Spam-E-Mail erkennen.
2. Präzision – Die Metrik „Qualität vor Quantität“
Präzisionkonzentriert sich darauf, wie viele der vom Modell vorhergesagtenpositiven Beispieletatsächlich echte Positive sind. Sie misst dieZuverlässigkeitder Vorhersageergebnisse oderund Präzision.。
\[ \text{Präzision} = \frac{TP}{TP + FP} \]
Frage: Wie viele der E-Mails, die wir als Spam vorhergesagt haben, sind tatsächlich Spam?Hohe Präzision bedeutet: Wenn das Modell sagt „Das ist Spam“, ist die Glaubwürdigkeit sehr hoch.
Beispiel
Präzision = precision_score(y_true, y_pred)
print(f"Präzision: {precision:.2f}") # Ausgabe: 0.80 (TP=4, TP+FP=5)
3. Recall – Die Metrik "Lieber ein breites Netz auswerfen"
Recallkonzentriert sich auf alle tatsächlichenpositiven Stichproben– wie viele vom Modell gefunden wurden. Er misst die Fähigkeit des Modells,positive Stichproben zu entdecken.。
\[ \text{Recall} = \frac{TP}{TP + FN} \]
Frage: Von allen tatsächlichen Spam-E-Mails, wie viele haben wir gefunden?Hoher Recall bedeutet: Das Modell verpasst nur selten tatsächliche Spam-E-Mails.
Beispiel
recall = recall_score(y_true, y_pred)
print(f"Recall: {recall:.2f}") # Ausgabe: 0.80 (TP=4, TP+FN=5)
4. F1-Score – Das harmonische Mittel von Präzision und Recall
Präzision und Recall stehen normalerweise im Spannungsverhältnis (die Verbesserung des einen geht oft auf Kosten des anderen).Der F1-Scoreist das harmonische Mittel der beiden und zielt darauf ab, ein Gleichgewicht zu finden.
\[ \text{F1 Score} = 2 \times \frac{\text{Precision} \times \text{Recall}}{\text{Precision} + \text{Recall}} \]
Eigenschaften des harmonischen Mittels: Es neigt dazu, Extremwerte zu bestrafen. Nur wenn sowohl Präzision als auch Recall hoch sind, wird der F1-Score hoch sein.
Beispiel
f1 = f1_score(y_true, y_pred)
print(f"F1-Wert: {f1:.2f}") # Ausgabe: 0.80
Leitfaden zum Vergleich und zur Auswahl von Metriken
| Metrik | Formel | Fokus | Beispielhafte Anwendungsszenarien |
|---|---|---|---|
| Genauigkeit | (TP+TN)/Gesamt | Gesamtgenauigkeit der Vorhersage | Szenarien, in denen die Klassen ausgewogen sind und die Kosten von FP und FN ähnlich sind. |
| Precision | TP/(TP+FP) | Als positiv vorhergesagt:Genauigkeit der Stichproben. | Hohe FP-Kosten.Zum Beispiel Spam-Filterung (Angst vor dem Löschen wichtiger E-Mails), Empfehlungssysteme (Angst vor der Empfehlung minderwertiger Produkte). |
| Trefferquote | TP/(TP+FN) | Tatsächlich positivDer Anteil der Stichproben, die gefunden werden | FN-Kosten sind hochZum Beispiel Krankheits-Screening (Angst vor verpasster Diagnose), Betrugserkennung (Angst, betrügerische Transaktionen zu übersehen). |
| F1-Score | 2PR/(P+R) | Ausgewogenheit von Precision und Recall | Szenarien, die eine umfassende Betrachtung ohne klare Bevorzugung erfordern; besser als Accuracy bei unausgewogenen Klassen. |
4. Fortgeschrittene Metriken: ROC-Kurve und AUC
Wenn das Vorhersageergebnis des Modells ein Wahrscheinlichkeitswert ist (z. B. die Wahrscheinlichkeit, dass eine E-Mail Spam ist, beträgt 0.8), müssen wir einenSchwellenwert(z. B. 0.5) festlegen, um die endgültige Klassifizierung zu entscheiden. Die ROC-Kurve hilft uns, die Leistung des Modells unter verschiedenen Schwellenwerten zu bewerten.
1. True Positive Rate und False Positive Rate
- True Positive Rate (TPR): ist eigentlichRecall. TPR = TP / (TP + FN)
- False Positive Rate (FPR): Der Anteil aller tatsächlich negativen Stichproben, die fälschlicherweise als positiv vorhergesagt werden. FPR = FP / (FP + TN)
2. ROC-Kurve
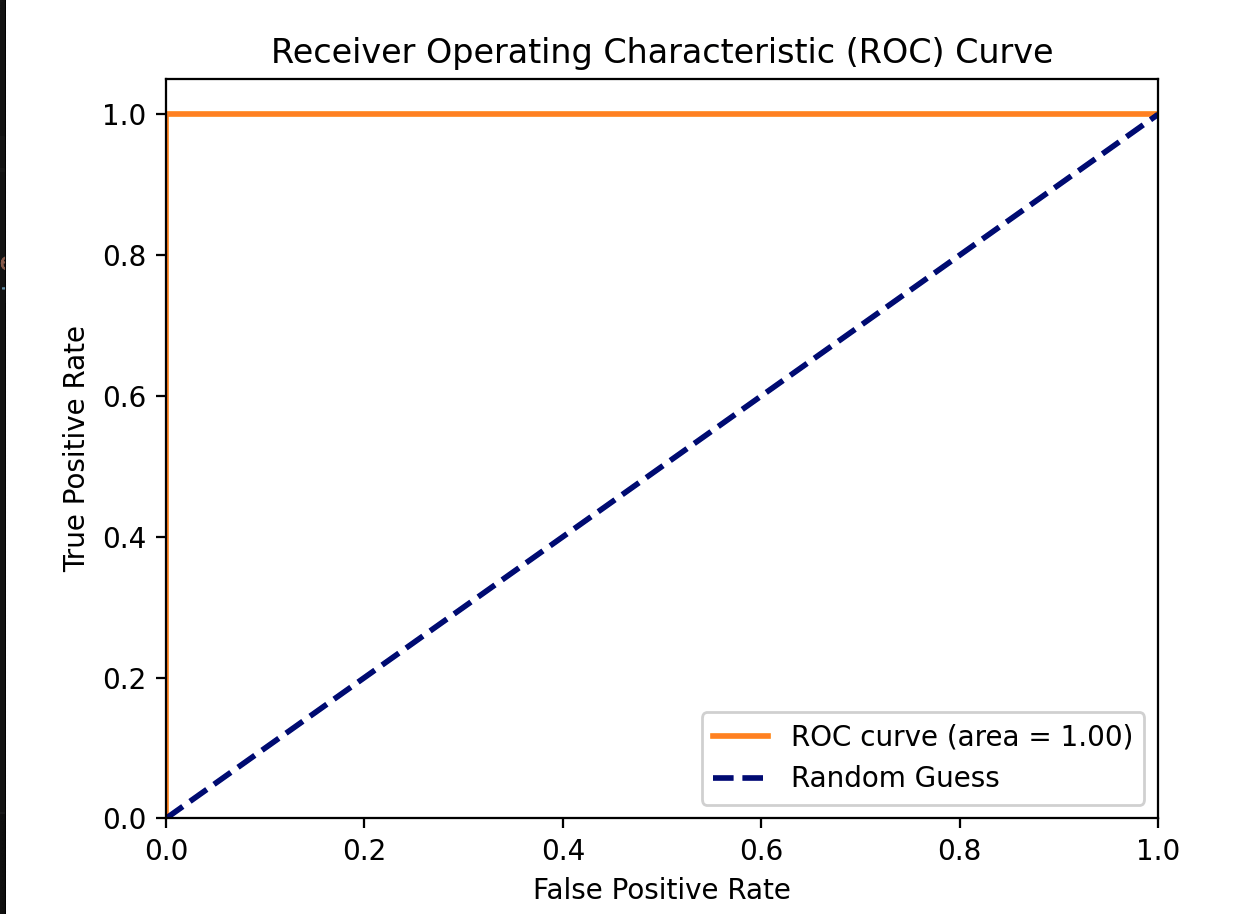
Die ROC-Kurve verwendetFPR als horizontale Achse,TPR als vertikale Achse. Jeder Punkt auf der Kurve entspricht einem bestimmten Klassifizierungsschwellenwert.
- Idealer Punkt: linke obere Ecke (0, 1), d. h., FPR=0 (keine False Positives), TPR=1 (alle Positiven erkannt).
- Zufallsgerade: Diagonale von (0,0) nach (1,1), die die Leistung eines Modells mit zufälligem Raten darstellt.
3. AUC-Wert
AUC ist die Fläche unter der ROC-Kurve.
- AUC = 1: perfektes Modell.
- AUC = 0.5: Das Modell hat keine Diskriminierungsfähigkeit, was zufälligem Raten entspricht.
- 0.5 < AUC < 1: Das Modell hat eine gewisse Vorhersagefähigkeit; je größer der Wert, desto besser.
- AUC < 0.5: Das Modell ist schlechter als zufälliges Raten, was normalerweise bedeutet, dass die Vorhersagerichtung umgekehrt ist.
Der Vorteil von AUC ist, dass esunempfindlich gegenüber Klassenungleichgewicht istund die Gesamt-Ranking-Fähigkeit des Modells bewertet (die Fähigkeit, positive Stichproben vor negativen Stichproben einzustufen).
Beispiel
import numpy as np
import matplotlib.pyplot as plt
# Angenommen, wir haben einige vorhergesagte Wahrscheinlichkeiten (hier mit Zufallszahlen simuliert)
y_true = [1, 0, 1, 0, 1]
y_scores = [0.9, 0.4, 0.6, 0.3, 0.8] # Wahrscheinlichkeit, dass das Modell ein positives Beispiel vorhersagt
fpr, tpr, thresholds = roc_curve(y_true, y_scores)
roc_auc = auc(fpr, tpr)
print(f"AUC-Wert: {roc_auc:.2f}")
# ROC-Kurve darstellen (optional, benötigt matplotlib)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC-Kurve (Fläche = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--', label='Zufälliges Raten')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('Falsch-Positiv-Rate')
plt.ylabel('Richtig-Positiv-Rate')
plt.title('Receiver-Operating-Characteristic-(ROC)-Kurve')
plt.legend(loc="unten rechts")
plt.show()
Ausgabe:
AUC 值: 1.00
Metriken für Multiklassen-Klassifikationsprobleme
Wenn es mehr als zwei Klassen gibt (z. B. Erkennung von Katzen, Hunden, Kaninchen), können die obigen Metriken auf folgende Weise erweitert werden:
- Makro-Durchschnitt: Berechnen Sie zuerst die Metrik für jede Klasse (z. B. Präzision), dann bilden Sie den arithmetischen Mittelwert der Metriken für alle Klassen.Jede Klasse wird gleich behandelt。
- Mikro-Durchschnitt: Aggregieren Sie zuerst die TP, FP usw. aller Klassen, und verwenden Sie dann die aggregierten Werte, um eine globale Metrik zu berechnen.Jede Stichprobe wird gleich behandelt, stärker von großen Klassen beeinflusst.
In Scikit-learn können Sie dies überaveragedie Parameter:
Beispiel
# y_true und y_pred sind jetzt Multiklassen-Labels, z. B. [0, 1, 2, 0, 1]
precision_macro = precision_score(y_true, y_pred, average='macro') # Makro-Durchschnitt
precision_micro = precision_score(y_true, y_pred, average='micro') # Mikro-Durchschnitt
6. Praktische Übung: Umfassende Bewertung eines Klassifikationsmodells
Jetzt üben wir mit einem echten Datensatz. Wir verwenden den berühmten Iris-Datensatz.
Beispiel
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score
# 1. Daten laden
iris = load_iris()
X = iris.data
y = iris.target
target_names = iris.target_names
# 2. Aufteilen in Trainings- und Testsets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Ein einfaches logistisches Regressionsmodell trainieren
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# 4. Vorhersagen auf dem Testset treffen
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test) # Vorhergesagte Wahrscheinlichkeiten für AUC ermitteln
# 5. Verschiedene Metriken berechnen und ausgeben
print("=== Confusion Matrix ===")
print(confusion_matrix(y_test, y_test))
# Hinweis: Die Confusion Matrix ist bei mehreren Klassen N x N
print("\n=== Classification Report (einschließlich Precision, Recall, F1) ===")
print(classification_report(y_test, y_pred, target_names=target_names))
# classification_report ist eine sehr praktische Funktion, die mehrere Metriken auf einmal ausgibt.
print(f"\n=== Accuracy ===")
print(f"{accuracy_score(y_test, y_pred):.4f}")
# 6. Für Multi-Class-AUC berechnet man üblicherweise den "One-vs-Rest"-AUC jeder Klasse gegenüber den anderen Klassen und bildet dann den Mittelwert.
from sklearn.metrics import roc_auc_score
# Hinweis: roc_auc_score erfordert die Angabe von multi_class='ovr' (One-vs-Rest) und average für Multiklassen
try:
auc_ovr = roc_auc_score(y_test, y_pred_proba, multi_class='ovr', average='macro')
print(f"\n=== Makro-Durchschnitt AUC (OvR) ===")
print(f"{auc_ovr:.4f}")
except Exception as e:
print(f"\nFehler beim Berechnen von AUC (einige Klassen erscheinen möglicherweise nicht im Testset): {e}")
Führen Sie diesen Code aus, und Sie sehen einen vollständigen Bericht zur Modellbewertung. Versuchen Sie, die Modellparameter zu ändern oder ein anderes Modell zu verwenden (wie z. B.sklearn.tree.DecisionTreeClassifier) und beobachten Sie, wie sich diese Metriken ändern.
=== 混淆矩阵 ===
[[19  0  0]
 [ 0 13  0]
 [ 0  0 13]]

=== 分类报告(包含精确率、召回率、F1)===
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45


=== 准确率 ===
1.0000

=== 宏平均 AUC (OvR) ===
1.0000
Weitere Erweiterungen