Deep Learning vs. traditionelles maschinelles Lernen
Stellen Sie sich vor, Sie bringen einem Kind bei, Katzen und Hunde zu erkennen. Der traditionelle Ansatz könnte so aussehen: Sie nehmen ein Bilderbuch heraus, zeigen auf die Bilder und sagen: Das ist eine Katze, sie hat spitze Ohren, Schnurrhaare und einen langen Schwanz; das ist ein Hund, seine Ohren können herunterhängen und seine Nase ist länger. Sie sagen dem Kind ausdrücklich die unterscheidendenRegeln und Merkmale。
Der andere Ansatz ist: Sie zeigen dem Kind Tausende von Bildern von Katzen und Hunden und sagen ihm einfach, ob jedes Bild eine Katze oder ein Hund ist. Nach genügend Beobachtungen wird das Gehirn des Kindes selbst die unbeschreiblichen, komplexen Unterscheidungsmerkmale von Katzen und Hunden zusammenfassen, wie Fellbeschaffenheit, Augenausdruck und Körperkontur. Dieser Ansatz kommt dem näher,die Daten für sich selbst sprechen zu lassen。
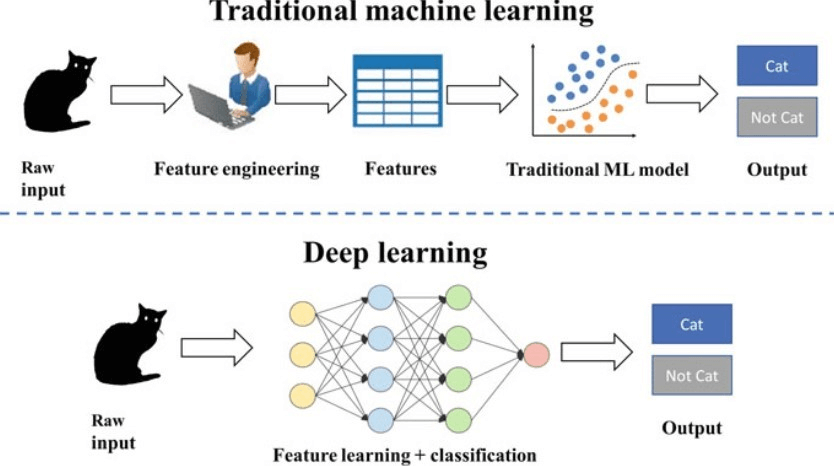
Diese beiden Lehrmethoden entsprechen genau zwei wichtigen Paradigmen im Bereich des maschinellen Lernens:traditionelles maschinelles LernenundDeep Learning. Dieser Artikel wird für Anfänger die Kernideen, Funktionsprinzipien, Vor- und Nachteile sowie Anwendungsszenarien beider klar analysieren und Ihnen helfen, ein Makroverständnis aufzubauen und eine Richtung für das weitere Lernen zu wählen.
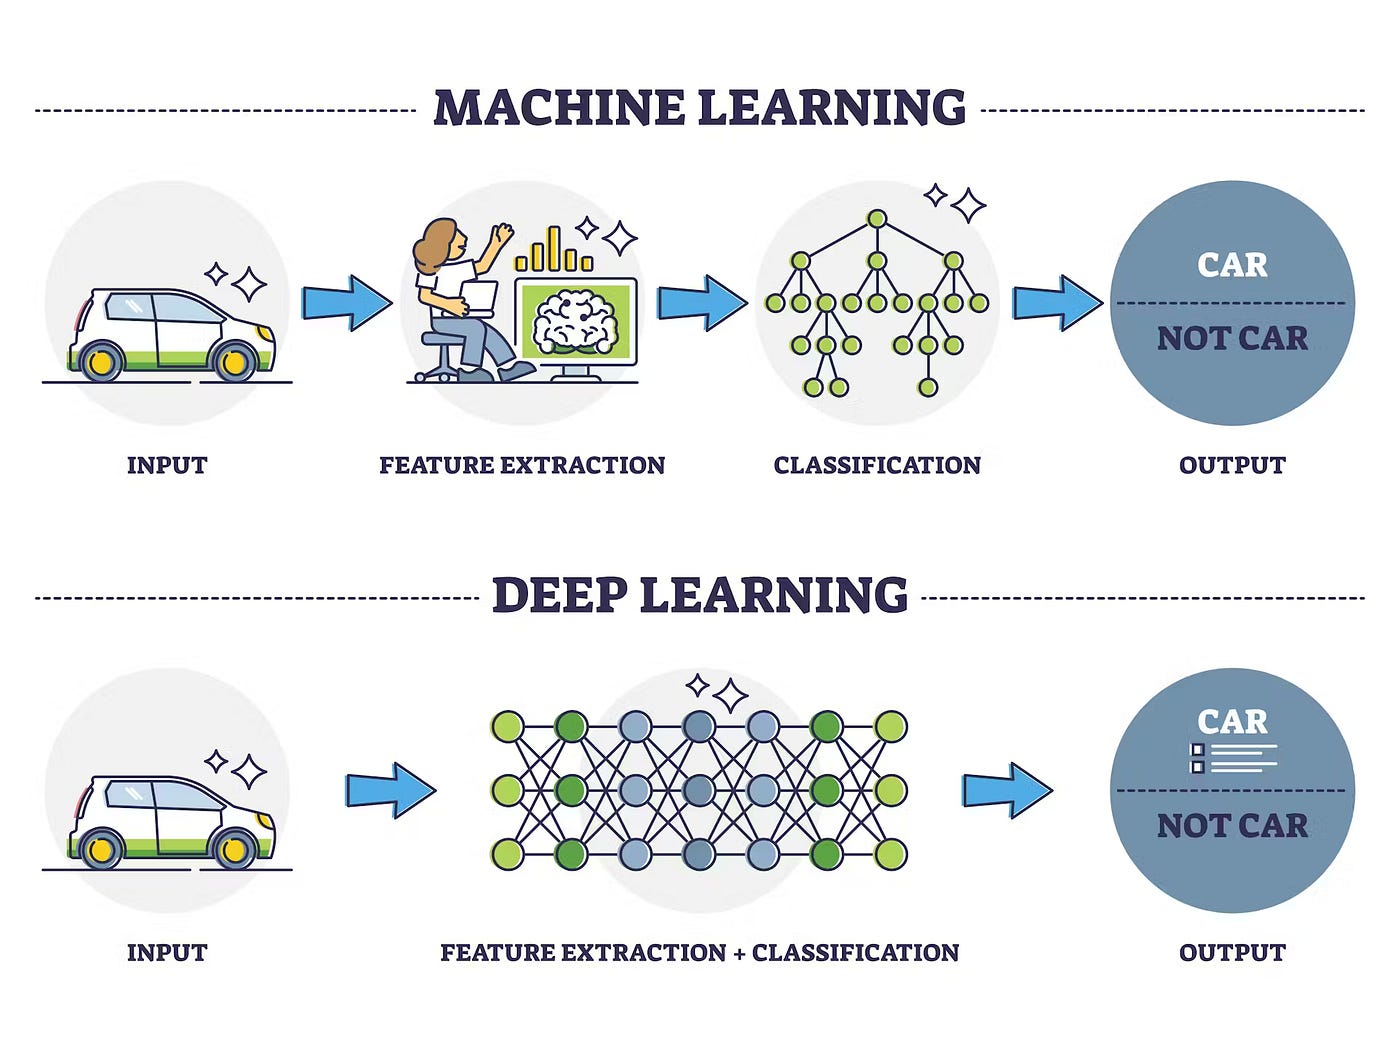
Teil 1: Traditionelles maschinelles Lernen — Der Analyst auf Basis von Regeln und Merkmalen
Traditionelles maschinelles Lernen kann als ein Analyst betrachtet werden, der klare Anweisungen und strukturierte Daten benötigt.
Was ist traditionelles maschinelles Lernen?
Traditionelles maschinelles Lernen ist eine Sammlung von Algorithmen, deren Kernidee darin besteht:Muster (Modelle) aus Daten zu lernen und diese Muster zu verwenden, um Vorhersagen zu treffen oder Entscheidungen auf neuen Daten zu treffen. Der Erfolg hängt stark von einer Voraussetzung und einem kritischen Schritt ab:Feature-Engineering。
Kern-Workflow
Lassen Sie uns den Arbeitsprozess des traditionellen maschinellen Lernens anhand eines Flussdiagramms intuitiv verstehen:
Ablaufanalyse:
- Feature-Engineering: Dies ist die Kernphase und diejenige, die am stärksten von menschlicher Expertise abhängt. Sie müssen aus Rohdaten (z. B. Bildpixel, Textwörter) quantifizierbare Merkmale extrahieren, die zur Lösung des Problems beitragen. Bei der Spam-Erkennung könnten Merkmale beispielsweise umfassen, ob das Wort "free" vorkommt oder ob die Adresse des Absenders in der Kontaktliste steht.
- Algorithmusauswahl und -training: Speisen Sie die verarbeiteten Merkmalsdaten in einen ausgewählten Algorithmus ein (z. B. Support Vector Machine, SVM oder Entscheidungsbaum). Der Algorithmus versucht, eine Funktion oder Regel zu finden, die das Ergebnis (z. B. Spam oder kein Spam) anhand dieser Merkmale am besten vorhersagt.
- Vorhersage: Wenn eine neue E-Mail eintrifft, extrahiert das System zunächst dieselben Merkmale und übergibt sie dann dem trainierten Modell zur Beurteilung.
Hauptmerkmale, Vorteile und Nachteile
| Eigenschaft | Beschreibung | Vorteile | Nachteile |
|---|---|---|---|
| Starke Abhängigkeit vom Feature-Engineering | Die Obergrenze der Modellleistung wird durch die Merkmalsqualität bestimmt. | Starke Interpretierbarkeit, und menschliches Expertenwissen kann integriert werden. | Erfordert viel Domänenwissen und Zeit für Merkmalsdesign und -extraktion; hohe Kosten. |
| Relativ einfache Modelle | Normalerweise werden lineare Modelle, Baummodelle usw. verwendet. | Schnelle Trainingsgeschwindigkeit, geringerer Rechenressourcenbedarf. | Der Umgang mitunstrukturierten Daten(Bilder, Audio, natürliche Sprache) ist begrenzt, was es schwierig macht, tiefe und komplexe Muster zu erfassen. |
| Gute Interpretierbarkeit | Sie können verstehen, wie das Modell Entscheidungen trifft (z. B. den Regelpfad eines Entscheidungsbaums). | Entscheidend in Bereichen, die Entscheidungserklärungen erfordern, wie Finanzen und Gesundheitswesen. | Manchmal wird ein Teil der Vorhersagegenauigkeit zugunsten der Interpretierbarkeit geopfert. |
Einfache Analogie: Traditionelles maschinelles Lernen ist wie einAnalytiker, der über leistungsstarke Formeln und statistische Werkzeuge verfügt, für den Sie jedoch alle Analysematerialien selbst vorbereiten müssen.。
Teil 2: Deep Learning — Der Wahrnehmende, der automatisch lernt
Deep Learning ist ein Teilgebiet des maschinellen Lernens, das versucht, die Funktionsweise von Neuronen im menschlichen Gehirn nachzuahmen, sodass Maschinen automatisch mehrstufige Merkmalsrepräsentationen aus Rohdaten lernen können.
Was ist Deep Learning?
Der Kern des Deep Learning istkünstliche neuronale Netze, insbesondere tiefe neuronale Netze mit vielen Schichten. Seine größte Eigenschaft ist, dass esEnde-zu-Endelernen kann: Sie geben die rohsten Daten ein (z. B. rohe Pixel eines Bildes), und es kann das Endergebnis ausgeben (z. B. die Bildkategorie). Der dazwischenliegende komplexe Merkmalsextraktionsprozess wird automatisch vom Netzwerk durchgeführt.
Kernarbeitsarchitektur
Deep Learning, insbesondere konvolutionale neuronale Netze für die Bilderkennung, hat einen hierarchischen Lernprozess, der von flach nach tief verläuft:

Architekturanalyse:
- Hierarchisches Merkmalslernen: Die erste Schicht des Netzwerks lernt möglicherweise nur,Kanten und Eckenzu erkennen. Die zweite Schicht kombiniert diese Kanten und lernt,einfache Texturen und Formen(wie Kreise, Streifen) zu erkennen. Tiefere Schichten kombinieren dann diese einfachen Formen zukomplexen Teilen und Objekten(wie Augen, Autotüren). Die letzten Schichten kombinieren diese Teile zu vollständigenObjektkonzepten(wie Katzen, Autos).
- End-to-End-Lernen: Sie müssen dem Netzwerk nicht sagen, was Kanten oder Texturen sind. Sie müssen nur eine große Menge beschrifteter Rohdaten (Bilder und entsprechende Katzen-/Hunde-Labels) bereitstellen. Durch denBackpropagation-Algorithmus passt das Netzwerk automatisch seine internen Millionen oder sogar Milliarden von Parametern an und lernt selbst, welche Pixelkombinationsmuster Katzen und welche Hunden entsprechen.
Hauptmerkmale, Vorteile und Nachteile
| Eigenschaft | Beschreibung | Vorteile | Nachteile |
|---|---|---|---|
| Automatisches Feature-Engineering | Kann automatisch mehrstufige, abstrakte Merkmale aus Rohdaten lernen. | Eliminiert mühsames manuelles Feature-Engineering; ist besonders leistungsstark bei der Verarbeitung von Bildern, Sprache und Text. | Wie eine "Blackbox" ist der interne Entscheidungsprozess schwer zu erklären. |
| Starke Fähigkeit, unstrukturierte Daten zu verarbeiten | Von Natur aus geeignet für die Verarbeitung komplexer Daten wie Pixel, Schallwellen und Wortsequenzen. | Erzielt oder übertrifft sogar menschliche Leistungsfähigkeit in Bereichen wie Computer Vision, Verarbeitung natürlicher Sprache und Spracherkennung. | Erfordertriesige Datenmengenfür das Training; wenn Daten unzureichend sind, neigt es zu schlechter Leistung. |
| Komplexe Modelle mit vielen Parametern | Tiefe Netzwerkschichten, die eine große Anzahl von Neuronen und Verbindungen enthalten. | Kann extrem komplexe und nichtlineare Beziehungen modellieren, mit enormem Potenzial. | Das Training dauert extrem lange und erfordert leistungsstarke Rechenressourcen (z. B. GPU), und auch die Bereitstellung des Modells erfordert eine gewisse Rechenleistung. |
| Geringe Interpretierbarkeit | Es ist schwierig zu verstehen, warum das Modell eine bestimmte Entscheidung trifft. | - | Die Anwendung ist in Bereichen eingeschränkt, die eine strenge Erklärung erfordern (wie Kreditgenehmigung und Krankheitsdiagnose). |
Einfache Analogie: Deep Learning ist wie einwahrnehmendes System mit einem mehrschichtigen Informationsverarbeitungsnetz, das durch umfangreiche Beobachtung wachsen kann, aber der Prozess, durch den es zu Schlussfolgerungen gelangt, ist nicht sehr transparent.
Teil 3: Wichtiger Vergleich und wie man wählt
Nun, lassen Sie uns die beiden für einen direkten Vergleich nebeneinanderstellen und Auswahlhinweise geben.
Vergleichstabelle der zentralen Unterschiede
| Vergleichsdimension | Traditionelles maschinelles Lernen | Deep Learning |
|---|---|---|
| Datenabhängigkeit | Relativ geringer Anspruch an die Datenmenge; geeignet für kleine und mittlere Datensätze. | Extrem abhängig von Big Data; je mehr Daten, desto besser ist in der Regel die Leistung. |
| Merkmalsverarbeitung | ManuellFeature Engineering ist der Schlüssel und die Hauptlast. | AutomatischFührt Merkmalsextraktion und -abstraktion durch. |
| Rechenressourcen | Läuft normalerweise effizient auf der CPU; geringe Anforderungen. | Erfordert leistungsstarke GPUs für das Training; hohe Rechenkosten. |
| Modellinterpretierbarkeit | Gut; der Entscheidungsprozess ist relativ transparent. | Schlecht; wird oft als "Black-Box-Modell" angesehen. |
| Problemdomäne | Gut geeignet für die Verarbeitung vonstrukturierten Daten(tabellarische Daten, Szenarien mit klaren Merkmalen). | Gut geeignet für die Verarbeitung vonunstrukturierten Daten(Bilder, Audio, Text, Video). |
| Trainingszeit | Relativ kurz, von Minuten bis Stunden. | Üblicherweise sehr lang, von Stunden bis Wochen oder sogar noch länger. |
| Einstiegshürde | Relativ niedrig; Prototypen sind einfach zu verstehen und umzusetzen. | Relativ hoch; erfordert das Verständnis komplexen Wissens wie neuronale Netze und Hyperparameter-Tuning. |
Praktischer Auswahlleitfaden: Welche sollte ich verwenden?
Du kannst diesen Entscheidungsansatz befolgen:
Welchen Typ haben deine Daten?
- Wenn es sich umstrukturierte tabellarische Datenhandelt (wie Excel-Tabellen mit Spalten wie Alter, Einkommen, Kaufhistorie), priorisiere traditionelles maschinelles Lernen (z. B. Gradient-Boosting-Bäume XGBoost, Random Forests).
- Wenn es sich umBild-, Sprach-, Text- oder Sequenzdatenhandelt, ist Deep Learning (CNN, RNN, Transformer) normalerweise die bessere Wahl.
Wie viele Daten hast du?
- Wenn das Datenvolumen begrenzt ist (Tausende bis Zehntausende von Stichproben), ist traditionelles maschinelles Lernen tendenziell robuster.
- Bei riesigen Datenmengen (Hunderttausende oder mehr) kann die Leistungsfähigkeit von Deep Learning voll entfaltet werden.
Hast du Anforderungen an die Interpretierbarkeit des Modells?
- In Szenarien wie Finanzrisikokontrolle und medizinisch unterstützter Diagnose, in denen du erklären können musst, warum ein Kredit abgelehnt wurde oder warum diese Krankheit vermutet wird, ist traditionelles maschinelles Lernen die sicherere Wahl.
- In Szenarien wie Bildklassifizierung, Sprachassistenten und Empfehlungssystemen, in denen Leistung priorisiert wird und Black-Box-Modelle akzeptabel sind, hat Deep Learning den Vorteil.
Wie sieht es mit deinen Rechenressourcen aus?
- Wenn du keine leistungsstarke GPU und nicht genügend Zeit hast, ist der Einstieg mit traditionellem maschinellem Lernen die praktischere Wahl.
Zusammenfassung in einem Satz:Traditionelles maschinelles Lernen ist die Kunst der Datenanalyse, während Deep Learning die Wissenschaft der Wahrnehmung und Repräsentation ist.Sie sind kein Ersatz füreinander, sondern sich ergänzende Werkzeugkästen. Ein guter KI-Praktiker sollte je nach konkreten Problem das am besten geeignete Werkzeug aus dem Werkzeugkasten auswählen.
Weitere Erweiterungen