Datenverzerrung
Maschinelles Lernen verändert die Welt, von Empfehlungssystemen bis hin zu selbstfahrenden Autos; seine Anwendungen sind überall.
Allerdings sind diese intelligenten Systeme nicht perfekt; sie haben eine gemeinsame„Achillesferse“ (Achilles' Heel)– Datenbias.
Heute befassen wir uns mit diesem Kernproblem, das die Fairness und Genauigkeit von Modellen des maschinellen Lernens beeinflusst.
Was ist Datenbias?
Datenbias bezeichnet Trainingsdaten, die reale Bedingungen nicht genau repräsentieren können, wodurch Modelle des maschinellen Lernens falsche Muster lernen oder verzerrte Vorhersagen treffen. Einfach gesagt: „Müll rein, Müll raus“ – wenn die Eingabedaten Probleme haben, sind auch die Ausgabeergebnisse fehlerhaft.
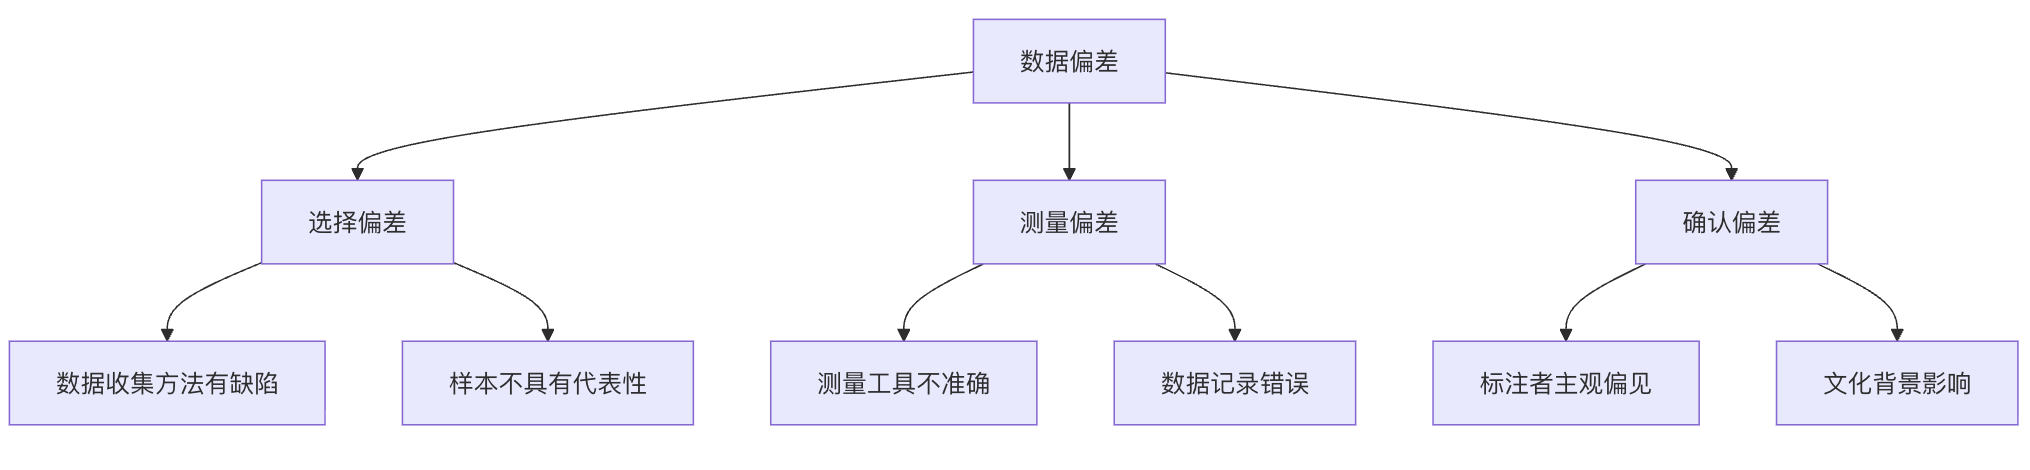
Drei Hauptarten von Datenbias
Selektionsbias:Tritt auf, wenn der Datenerfassungsprozess selbst eine systematische Verzerrung aufweist. Zum Beispiel, wenn nur soziale Medien genutzt werden, um die Meinungen junger Menschen über ein Produkt zu erheben, während ältere Gruppen ignoriert werden, die soziale Medien nicht nutzen.
-
Messbias:Fehler entstehen in den Daten selbst bei der Messung oder Aufzeichnung. Zum Beispiel führt ein Gesichtserkennungssystem, das hauptsächlich mit Fotos hellhäutiger Menschen entwickelt wurde, zu einer geringeren Erkennungsgenauigkeit bei dunkelhäutigen Menschen.
-
Bestätigungsbias:Forscher oder Datenannotatoren bringen ihre eigenen subjektiven Verzerrungen in die Daten ein. Zum Beispiel können Annotatoren bei Sentimentanalyse-Aufgaben die Textstimmung aufgrund ihres eigenen kulturellen Hintergrunds interpretieren und Ausdrucksweisen aus anderen Kulturen ignorieren.
Wie beeinflusst Datenbias Modelle des maschinellen Lernens?
Verschlechterung der Modellleistung
Wenn ein Modell bei Trainingsdaten gut, aber bei realen Daten schlecht abschneidet, liegt wahrscheinlich ein Datenbias-Problem vor.
Beispiel
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
np.random.seed(42)
n_samples = 1000
# Daten aus der realen Welt
X_real = np.random.uniform(-5, 5, n_samples).reshape(-1, 1)
y_real = (X_real.flatten() > 0).astype(int)
# Verzerrte Daten: 90% von X > 0, 10% von X < 0
mask_pos = X_real.flatten() > 0
mask_neg = X_real.flatten() <= 0
X_pos = X_real[mask_pos]
y_pos = y_real[mask_pos]
X_neg = X_real[mask_neg]
y_neg = y_real[mask_neg]
# Nur eine kleine Anzahl negativer Stichproben ziehen
neg_sample_size = int(0.1 * len(X_pos))
neg_indices = np.random.choice(len(X_neg), neg_sample_size, replace=False)
X_biased = np.vstack([X_pos, X_neg[neg_indices]])
y_biased = np.hstack([y_pos, y_neg[neg_indices]])
# Trainings-/Testdaten aufteilen
X_train, X_test, y_train, y_test = train_test_split(
X_biased, y_biased, test_size=0.2, random_state=42
)
# Modell trainieren
model = LogisticRegression()
model.fit(X_train, y_train)
# Auswertung des Trainingssets
train_pred = model.predict(X_train)
train_acc = accuracy_score(y_train, train_pred)
print(f"Trainingsgenauigkeit: {train_acc:.2%}")
# Evaluierung in der realen Welt
real_pred = model.predict(X_real)
real_acc = accuracy_score(y_real, real_pred)
print(f"Genauigkeit in der realen Welt: {real_acc:.2%}")
print("Fazit: Der Trainingsdatensatz schneidet gut ab, aber aufgrund von Verteilungsverzerrung nimmt die Leistung in der realen Welt deutlich ab")
Das Ausgabeergebnis ist:
训练准确率: 99.08%
真实世界准确率: 96.00%
结论:训练集表现良好,但由于分布偏差,真实世界性能显著下降
Fairness-Probleme
Datenbias kann dazu führen, dass Modelle für bestimmte Gruppen diskriminierende Ergebnisse liefern. Wenn beispielsweise ein Einstellungsalgorithmus hauptsächlich mit historischen Daten männlicher Beschäftigter trainiert wird, kann er gegenüber weiblichen Bewerberinnen voreingenommen sein.
Unzureichende Generalisierungsfähigkeit
Das Modell kann sich nicht an neue, ungesehene Datenszenarien anpassen, weil die Trainingsdaten keine ausreichend vielfältige Bandbreite an Situationen abdecken.
Häufige Quellen von Datenbias
Probleme in der Datenerfassungsphase
| Problemtyp | Konkrete Ausprägung | Beispiel |
|---|---|---|
| Stichprobenverzerrung | Die Datenstichprobe kann die Grundgesamtheit nicht repräsentieren | Erfassung von Daten für autonomes Fahren nur in städtischen Gebieten, wobei ländliche Straßen ignoriert werden |
| Zeitliche Verzerrung | Daten sind veraltet oder nicht zeitkritisch | Verwendung von E-Commerce-Daten aus 2010 zur Vorhersage von Konsumtrends für 2023 |
| Überlebensverzerrung | Nur Fokussierung auf "überlebende" Datenpunkte | Nur Daten von erfolgreichen Unternehmen untersuchen und die Erfahrungen gescheiterter Unternehmen ignorieren |
Probleme in der Datenlabeling-Phase
Beispiel
import pandas as pd
# Simulierten Datensatz erstellen
data = {
'text': [
'Dieses Produkt ist wirklich großartig, ich mag es sehr!',
'Nicht sicher, ob das gut funktioniert',
'Auf keinen Fall dieses Schrottprodukt kaufen',
'Es ist okay, nur durchschnittlich',
'Sehr empfehlenswert, tolles Preis-Leistungs-Verhältnis'
],
# Angenommen, Annotatoren haben ihren eigenen Bias: positive Bewertungen werden als 1 gekennzeichnet, alles andere als 0
'biased_label': [1, 0, 0, 0, 1], # Verzerrte Kennzeichnung
'true_label': [1, 0.5, 0, 0.5, 1] # Echte kontinuierliche Sentiment-Werte
}
df = pd.DataFrame(data)
print("Beispiel für Kennzeichnungsverzerrung:")
print(df)
print("\nProblem: Der Annotator hat neutrale Bewertungen fälschlicherweise als negativ gekennzeichnet!")
Die Ausgabe ist:
标注偏差示例:
              text  biased_label  true_label
0  这个产品真的很棒,我非常喜欢!             1         1.0
1       不太确定这个好不好用             0         0.5
2      绝对不要买这个垃圾产品             0         0.0
3          还行吧,一般般             0         0.5
4        超级推荐,物超所值             1         1.0

问题:标注者将中性评价错误地标注为负面!
Probleme in der Datenvorverarbeitungsphase
- Unsachgemäßer Umgang mit Ausreißern
- Voreingenommene Merkmalsauswahl
- Ungeeignete Methoden zur Datenstandardisierung
Wie erkennt man Datenbias?
1. Statistische Datenanalyse
Überprüfen Sie die Verteilung der verschiedenen Gruppen im Datensatz.
Beispiel
import matplotlib.pyplot as plt
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows-Priorität
'SimHei', 'Microsoft YaHei',
# macOS-Priorität
'PingFang SC', 'Heiti TC',
# Linux-Priorität
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Behebe das Problem, dass das Minuszeichen als Quadrat angezeigt wird
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# Demografische Daten simulieren
groups = ['Gruppe A', 'Gruppe B', 'Gruppe C', 'Gruppe D']
population_percent = [40, 30, 20, 10] # Reale Bevölkerungsanteile
dataset_percent = [70, 20, 8, 2] # Anteile im Datensatz
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))
# Reale Bevölkerungsverteilung
ax1.pie(population_percent, labels=groups, autopct='%1.1f%%')
ax1.set_title('Reale Bevölkerungsverteilung')
# Verteilung des Datensatzes
ax2.pie(dataset_percent, labels=groups, autopct='%1.1f%%')
ax2.set_title('Gruppenverteilung im Datensatz')
plt.tight_layout()
plt.show()
print("Erkennungsergebnis: Gruppe A ist im Datensatz überrepräsentiert, während Gruppe D unterrepräsentiert ist!")

2. Analyse der Unterschiede in der Modellleistung
Vergleiche die Modellleistung über verschiedene Untergruppen hinweg.
3. Berechnung der Fairness-Metrik
Verwenden Sie statistische Metriken, um den Grad der Fairness des Modells zu quantifizieren.
Strategien zum Umgang mit Datenbias
Lösungen auf Datenebene
1. Verbesserte Strategien zur Datenerhebung
- Aktives Sampling: Bewusst unterrepräsentierte Daten sammeln
- Daten-Augmentierung: Die Datenvielfalt durch technische Mittel erhöhen
- Mehrere Datenquellen: Daten aus verschiedenen Quellen integrieren
2. Techniken zur Datenvorverarbeitung
Beispiel
import numpy as np
from sklearn.utils import resample
np.random.seed(42)
# 1. Unbalancierte Daten erzeugen (eindimensionale Merkmale + Labels)
X_majority = np.random.normal(0, 1, 900).reshape(-1, 1)
y_majority = np.zeros(900, dtype=int)
X_minority = np.random.normal(2, 1, 100).reshape(-1, 1)
y_minority = np.ones(100, dtype=int)
print(f"Vor dem Resampling:")
print(f"Mehrheitsklasse: {len(X_majority)}")
print(f"Minderheitsklasse: {len(X_minority)}")
# 2. Upsampling der Minderheitsklasse
X_minority_upsampled, y_minority_upsampled = resample(
X_minority,
y_minority,
replace=True,
n_samples=len(X_majority),
random_state=42
)
# 3. Den balancierten Datensatz zusammenführen
X_balanced = np.vstack([X_majority, X_minority_upsampled])
y_balanced = np.hstack([y_majority, y_minority_upsampled])
print(f"\n"Nach dem Resampling:")
print(f"Mehrheitsklasse: {np.sum(y_balanced == 0)}")
print(f"Minoritätsklasse: {np.sum(y_balanced == 1)}")
print("\n"Fazit: Die Stichprobenanzahlen sind vollständig ausbalanciert")
Ausgabe:
重采样前:
多数类: 900
少数类: 100

重采样后:
多数类: 900
少数类: 900

结论:样本数量已完全平衡
Lösungen auf Algorithmusebene
Fairness-Einschränkungen: Fügen Sie während des Modelltrainings Fairness-Einschränkungen hinzu.
-
Adversarial Debiasing: Verwenden Sie adversariale Lerntechniken, um Bias im Modell zu reduzieren.
-
Post-Processing-Methoden: Passen Sie Modellvorhersagen an, um die Fairness zu verbessern.
Praktische Übung: Einen unvoreingenommenen Klassifikator erstellen
Lassen Sie uns anhand eines vollständigen Beispiels lernen, wie man Daten-Bias während des gesamten Prozesses behandelt, von der Datenerfassung bis zur Modellbewertung.
Beispiel
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
from imblearn.over_sampling import SMOTE
import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
# 1. Simulierte unbalancierte Daten generieren
X, y = make_classification(
n_samples=2000,
n_features=10,
n_informative=8,
n_redundant=2,
n_clusters_per_class=1,
weights=[0.9, 0.1], # Absichtlich Klassen-Bias erzeugen
flip_y=0,
random_state=42
)
# In DataFrame für Analyse umwandeln
feature_names = [f'feature_{i}' for i in range(X.shape[1])]
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("=== Daten-Bias-Analyse ===")
print(f"Datensatzform: {df.shape}")
print("Klassenverteilung:")
print(df['target'].value_counts())
print(f"Anteil der Minderheitsklasse: {df['target'].value_counts(normalize=True))
# 2. Datenaufteilung (Klassenanteile beibehalten, um sekundären Bias zu verhindern)
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.3,
random_state=42,
stratify=y
)
print("\n"=== Trainings-/Testset-Verteilung ===")
print("Trainingssatz:", np.bincount(y_train))
print("Testsatz:", np.bincount(y_test))
# 3. SMOTE verwenden, um Bias im Trainingssatz zu behandeln
print("\n"=== Umgang mit Datenbias (SMOTE) ===")
smote = SMOTE(random_state=42)
X_train_balanced, y_train_balanced = smote.fit_resample(X_train, y_train)
print("Vor SMOTE:", np.bincount(y_train))
print("Nach SMOTE:", np.bincount(y_train_balanced))
# 4. Modelltraining
print("\n"=== Modelltraining ===")
# Basismodell: keine Bias-Behandlung
model_imbalanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_imbalanced.fit(X_train, y_train)
# Bias-behandeltes Modell: nach SMOTE trainiert
model_balanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_balanced.fit(X_train_balanced, y_train_balanced)
# 5. Modellbewertung
print("\n"=== Modellbewertung (Testset) ===")
print("\n"【Unbehandelter Bias】Klassifikationsbericht")
y_pred_imbalanced = model_imbalanced.predict(X_test)
print(classification_report(y_test, y_pred_imbalanced, digits=4))
print("Konfusionsmatrix:")
print(confusion_matrix(y_test, y_pred_imbalanced))
print("\n"【Nach SMOTE-Verarbeitung】Klassifikationsbericht")
y_pred_balanced = model_balanced.predict(X_test)
print(classification_report(y_test, y_pred_balanced, digits=4))
print("Konfusionsmatrix:")
print(confusion_matrix(y_test, y_pred_balanced))
print(
"\nFazit:\n"
"1. Ohne Bias-Behandlung hat das Modell einen extrem niedrigen Recall für die Minderheitsklasse"\n"
"2. SMOTE verbessert Recall und F1 für die Minderheitsklasse deutlich"\n"
"3. Accuracy ist keine zuverlässige Metrik für unausgewogene Daten"
)
Ausgabeergebnisse:
=== 数据偏差分析 ===
数据集形状: (2000, 11)
类别分布:
target
0    1800
1     200
Name: count, dtype: int64
少数类占比: 10.00%

=== 训练 / 测试集分布 ===
训练集: [1260  140]
测试集: [540  60]

=== 处理数据偏差(SMOTE)===
SMOTE 前: [1260  140]
SMOTE 后: [1260 1260]

=== 模型训练 ===

=== 模型评估(测试集)===

【未处理偏差】分类报告
              precision    recall  f1-score   support

           0     0.9872    1.0000    0.9936       540
           1     1.0000    0.8833    0.9381        60

    accuracy                         0.9883       600
   macro avg     0.9936    0.9417    0.9658       600
weighted avg     0.9885    0.9883    0.9880       600

混淆矩阵:
[[540   0]
 [  7  53]]

【SMOTE 处理后】分类报告
              precision    recall  f1-score   support

           0     0.9944    0.9944    0.9944       540
           1     0.9500    0.9500    0.9500        60

    accuracy                         0.9900       600
   macro avg     0.9722    0.9722    0.9722       600
weighted avg     0.9900    0.9900    0.9900       600

混淆矩阵:
[[537   3]
 [  3  57]]

结论:
1. 不处理偏差时,模型对少数类 Recall 极低
2. SMOTE 显著提升少数类 Recall 与 F1
3. Accuracy 不是不平衡数据的可靠指标
Branchen-Best-Practices für das Daten-Bias-Management
1. Ein Data-Governance-Framework etablieren
- Standardprozesse für Datenerfassung und -annotation entwickeln
- Datenqualität regelmäßig prüfen
- Mechanismen zur Erkennung von Datenverzerrungen etablieren
2. Ein vielfältiges Team aufbauen
- Vielfalt im Data-Science-Team sicherstellen
- Domänenexperten und Ethiker einbeziehen
- Regelmäßige Schulungen zur Bias-Sensibilisierung durchführen
3. Transparenz und Interpretierbarkeit
- Datenquellen und Verarbeitungsverfahren dokumentieren
- Erklärungen für Modellentscheidungen bereitstellen
- Modellleistung in verschiedenen Gruppen offenlegen
4. Kontinuierliche Überwachung und Aktualisierung
- Modellleistung in der realen Welt regelmäßig bewerten
- Feedback-Mechanismen einrichten, um Nutzerberichte zu sammeln
- Modelle zeitnah aktualisieren, um sie an Änderungen anzupassen
Zusammenfassung und Ausblick
Datenbias ist eine unvermeidbare Herausforderung im maschinellen Lernen, aber durch systematische Erkennungs- und Behandlungsmethoden können wir seine Auswirkungen erheblich abschwächen. Entscheidend ist, zu erkennen:
- Datenbias ist überall: Nahezu alle realen Datensätze enthalten irgendeine Form von Bias
- Früherkennung ist entscheidend: Bias in frühen Projektphasen zu behandeln, ist am kostengünstigsten
- Technologie mit Prozessen kombinieren: Technische Lösungen allein reichen nicht aus; sie müssen mit Prozessen und Management kombiniert werden
- Kontinuierlicher Verbesserungsprozess: Der Umgang mit Datenbias ist ein kontinuierlicher Prozess, keine einmalige Aufgabe
Da die Anforderungen an Fairness und Rechenschaftspflicht im maschinellen Lernen steigen, wird der effektive Umgang mit Datenbias zu einer Kernkompetenz für jeden Data Scientist und Machine-Learning-Ingenieur. Denken Sie daran: Ein gutes maschinelles Lernsystem benötigt nicht nur hohe Genauigkeit, sondern auch hohe Fairness und Zuverlässigkeit.
Weitere Erweiterungen