Grundgerüst für bestärkendes Lernen
Stellen Sie sich vor, Sie bringen einem Welpen bei, den Befehl "Sitz" zu lernen. Sie würden ihm nicht direkt sagen, wie sich jeder Muskel bei der Sitzbewegung bewegen soll; stattdessen würden Sie Folgendes tun:
- Sie geben den Befehl "Sitz".
- Der Welpe probiert eine Aktion aus (er könnte sich setzen, sich hinlegen oder sich im Kreis drehen).
- Wenn er sich setzt, geben Sie ihm sofort ein Leckerli als Belohnung.
- Wenn er es falsch macht, gibst du keine Belohnung oder ein leichtes "nicht richtig"-Signal.
- Nach vielen Versuchen versteht der Welpe allmählich: Wenn er "sit" hört, kann er durch das Ausführen der Sitzaktion ein Leckerli verdienen. So lernt er den Befehl.
Bestärkendes Lernenbedeutet, einen Computer (oder Agenten) wie diesen Welpen lernen zu lassen, wie er durch Interaktion mit der Umgebung und auf der Grundlage der erhaltenen Belohnungen oder Bestrafungen eine Reihe von Entscheidungen trifft, um ein langfristiges Ziel zu erreichen.
Verglichen mit dem vertrautenüberwachten Lernen(einem "Lehrer" mit Standardantworten) undunüberwachten Lernen(dem Finden der internen Struktur von Daten), ist es grundlegend anders. Bestärkendes Lernen istLernen aus Erfahrung, und sein Kern istVersuch und Irrtumundverzögerte Belohnung。
Kernelemente des bestärkenden Lernens
Um diesen Lernprozess zu formalisieren, führen wir mehrere Kernkonzepte ein, die gemeinsam den grundlegenden Rahmen des bestärkenden Lernens bilden.
Agent und Umgebung
Dies ist die grundlegendste interaktive Beziehung im bestärkenden Lernen.
- Agent:Er ist das Subjekt des Lernens, die Entität, die Entscheidungen trifft. Im obigen Beispiel ist der Welpe der Agent. In einem Computer kann er ein Algorithmus, ein Programm oder ein Roboter sein.
- Umgebung:Sie ist die äußere Welt, in der der Agent existiert und mit der der Agent interagiert. Für den Welpen ist die Umgebung du, Leckerlis, der Boden und alle äußeren Dinge. Die Umgebung empfängt die Aktionen des Agenten und liefert neue Zustände und Belohnungen.

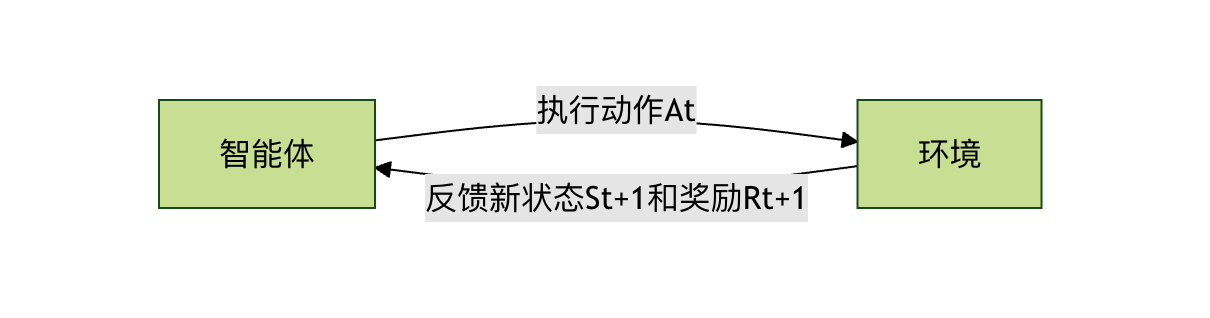
Ihre Beziehung ist eine kontinuierliche Schleife:Agent beobachtet Umgebung -> führt Aktion aus -> Umgebung gibt neuen Zustand und Belohnung zurück -> Agent beobachtet erneut...
Zustand, Aktion und Belohnung
Diese drei Schlüsselinformationen beschreiben jede Interaktion.
- Zustand:Zu einem gegebenen Zeitpunkt eine vollständige Beschreibung der Situation der Umgebung. Zum Beispiel könnte im Welpen-Trainingsbeispiel der Zustand Folgendes umfassen: Der Welpe steht, du hast ein Leckerli in der Hand und du hast gerade "sit" gesagt. Der Zustand ist die Grundlage für die Entscheidungen des Agenten.
- Aktion:Die Entscheidungen, die der Agent in einem bestimmten Zustand treffen kann. Für den Welpen könnte die Aktionsmenge {sit, lie down, stand, spin...} sein.
- Belohnung:Ein skalares Signal, das die Umgebung dem Agenten zurückmeldet, nachdem der Agent eine Aktion ausgeführt hat. Es definiert, was gut und was schlecht ist. Die Belohnung ist der einzige Kompass für das Lernen des Agenten. Dem Welpen ein Leckerli zu geben, ist eine positive Belohnung (+1); "nicht richtig" zu sagen, kann als leichte negative Belohnung (-0.1) angesehen werden.
Policy
Eine Policyist das Gehirn oder die Verhaltensregel des Agenten. Sie definiert, welche Aktion der Agent in einem gegebenen Zustand ausführen sollte.
Eine Policy kann eine einfache Lookup-Tabellen-Funktion oder ein komplexes tiefes neuronales Netz sein. Das ultimative Ziel des Bestärkungslernens ist es, eineoptimale Policyzu finden, sodass dielangfristig kumulierte Belohnung, die der Agent von der Umgebung erhält, maximiert wird。
- .Beispiel: Eine einfache Policy könnte sein: Wenn der Zustand "den Befehl sit hören" ist, dann wähle die Aktion sit mit 90% Wahrscheinlichkeit und wähle andere Aktionen mit 10% Wahrscheinlichkeit.
Wertfunktion
Belohnungen sagen dem Agentendas unmittelbar Gute oder Schlechte der aktuellenAktion, aber der Agent muss sich mehr umlangfristigeErträge kümmern.Eine Wertfunktionist das Werkzeug, das verwendet wird, um diesen langfristigen Ertrag zu messen.
Sie beantwortet die Frage: Wie viel Gesamtbelohnung kann ich, ausgehend vom aktuellen Zustand und durchgängig einer bestimmten Policy folgend,erwartenzu erhalten?
- Zustandswertfunktion V(s): misst den langfristigen Wert der Befolgung der aktuellen Strategie im Zustand
ss. - Aktionswertfunktion Q(s, a): misst, im Zustand
ss,nach Ausführung einer bestimmten Aktionaa, den langfristigen Wert, anschließend der aktuellen Strategie zu folgen. Sie wird häufiger verwendet als die Zustandswertfunktion, weil sie die Aktionsauswahl direkt leiten kann.
Warum brauchen wir eine Wertfunktion?Stellen Sie sich ein Schachspiel vor. Das Schlagen eines gegnerischen Bauern bringt eine sofortige kleine Belohnung, kann aber dazu führen, dass man zehn Züge später mattgesetzt wird und eine riesige negative Belohnung erhält. Durch Berechnung und Schätzung kann die Wertfunktion dem Agenten helfen, diese Art von Verhalten zu vermeiden, das kleine Gewinne begehrt und das ganze Spiel verliert.
Kerninteraktionsprozess: Markov-Entscheidungsprozess
Probleme des bestärkenden Lernens werden üblicherweise als einMarkov-Entscheidungsprozess (MDP)modelliert. Dieser Name klingt komplex, aber er ist eigentlich nur ein Standardrahmenwerk, das die oben genannten Elemente in mathematischer Form organisiert und die Interaktion zwischen dem Agenten und der Umgebung beschreibt.
Die Kernidee des MDP ist:Der nächste Zustand und die Belohnung hängen nur vom aktuellen Zustand und der aktuell ausgeführten Aktion ab und sind unabhängig von der vorherigen Historie(d. h. der Markov-Eigenschaft).
Ein vollständiger MDP-Interaktionszyklus sieht wie folgt aus:
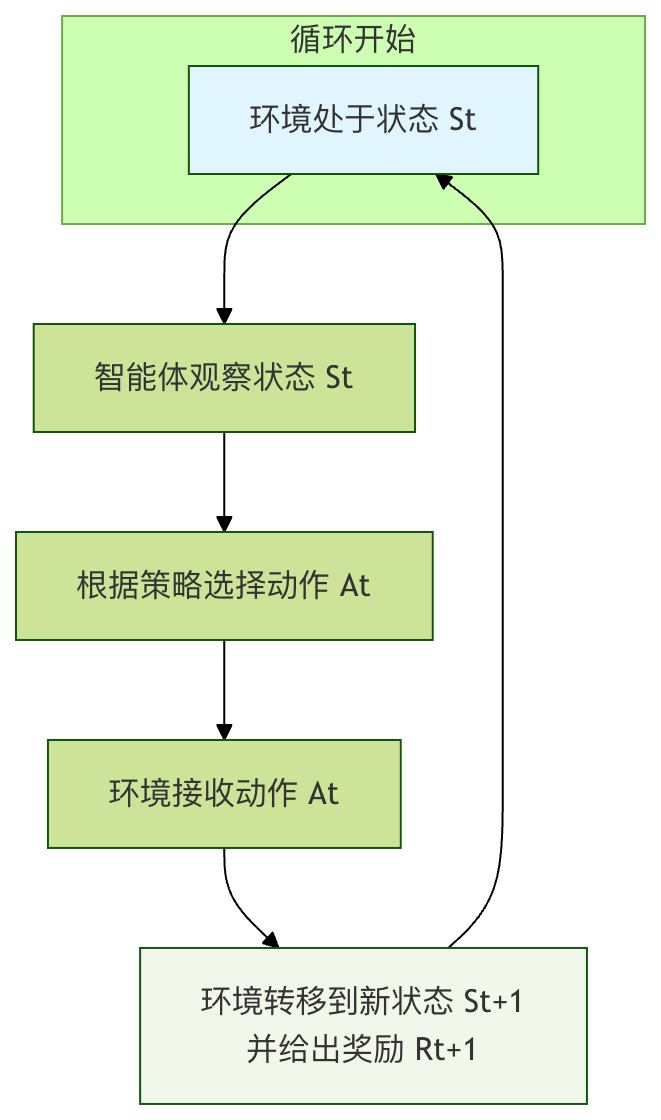
- Zum Zeitschritt
tt, befindet sich die Umgebung im ZustandS_t。 - S_t. Der Agent beobachtet diesen Zustand.
- Der Agent, gemäß seiner Strategie
ππ, wählt eine Aktion ausA_t。 - A_t. Die Umgebung empfängt diese Aktion.
- Die Umgebung geht gemäß ihren internen dynamischen Regeln in den nächsten Zustand über
S_{t+1}S_{t+1}, und erzeugt eine skalare BelohnungR_{t+1}R_{t+1}, die an den Agenten zurückgemeldet wird. - Der Zeitschritt schreitet voran (
t = t+1t = t+1), und eine neue Schleife beginnt.
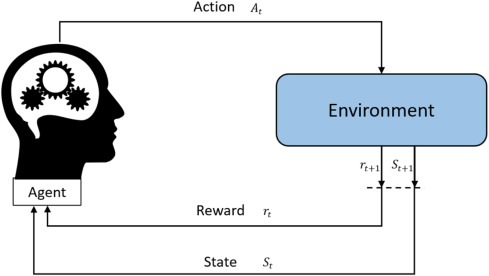
Das Ziel des Agenten ist es, durch das kontinuierliche Erleben dieser Schleife eine Strategie zu erlernenπ*π, sodass ausgehend von einem beliebigen Anfangszustand derErwartungswert der kumulativen Belohnung (d. h. der Return) maximiert wird。
Ein einfaches Codebeispiel: Gitterwelt
Verwenden wir ein klassisches Gitterwelt-Beispiel, um diese Konzepte zu veranschaulichen. Angenommen, es gibt ein 4x4-Gitter. Der Agent startet vom StartpunktSS, mit dem Ziel, den Endpunkt zu erreichenGT. Ein Hindernis erreichen#X bedeutet Fehlschlag, und jeder Schritt hat eine kleine Strafe (um zu fördern, das Ziel so schnell wie möglich zu erreichen).
S . . .
. # . .
. . # .
. . . G
- Zustand: die Koordinaten jeder Rasterzelle, wie (0,0), (0,1)... (3,3). Insgesamt gibt es 16 Zustände.
- Aktion: {up, down, left, right}.
- Belohnung:
- : T erreichen: +10
G: +10 - X treffen
#oder das Spielfeld verlassen: -5 - Andere normale Züge: -0.1 (fördert effiziente Pfade)
- : T erreichen: +10
- Strategie: Wir müssen eine Tabelle lernen, die für jeden Zustand (Rasterzelle) festhält, welche Richtung zu gehen ist.
Unten ist eine extrem vereinfachte Q-Learning-Demonstration (ein klassischer Reinforcement-Learning-Algorithmus) in Pseudocode, mit der der optimale Pfad in dieser Gitterwelt gelernt wird.
Beispiel
import random
from typing import Dict, List, Tuple
# ====================== 1. Umgebungssimulation (Gitterwelt) ======================
class GridWorldEnv:
"""Eine einfache Grid-World-Umgebung zur Demonstration von Q-Learning"""
def __init__(self, grid_size: Tuple[int, int] = (5, 5),
start_pos: Tuple[int, int] = (0, 0),
goal_pos: Tuple[int, int] = (4, 4),
obstacle_pos: List[Tuple[int, int]] = [(1, 1), (2, 2), (3, 1)]):
self.grid_size = grid_size
self.start_pos = start_pos
self.goal_pos = goal_pos
self.obstacle_pos = obstacle_pos
self.current_pos = start_pos
# Aktionsdefinitionen: 0-oben, 1-unten, 2-links, 3-rechts
self.actions = ['up', 'down', 'left', 'right']
self.num_actions = len(self.actions)
def reset(self) -> int:
"""Setze die Umgebung zurück und gib den Index des Anfangszustands zurück"""
self.current_pos = self.start_pos
return self.pos_to_state(self.current_pos)
def pos_to_state(self, pos: Tuple[int, int]) -> int:
"""Wandle Koordinatenposition in Zustandsindex um"""
return pos[0] * self.grid_size[1] + pos[1]
def state_to_pos(self, state: int) -> Tuple[int, int]:
"""Wandle Zustandsindex in Koordinatenposition um"""
return (state // self.grid_size[1], state % self.grid_size[1])
def random_action(self) -> int:
"""Wählt zufällig eine Aktion aus (Exploration)"""
return random.randint(0, self.num_actions - 1)
def action_to_direction(self, action: int) -> str:
"""Wandelt Aktionsindex in Richtungsnamen um"""
return self.actions[action]
def step(self, action: int) -> Tuple[int, float, bool]:
"""
Aktion ausführen, (next_state, reward, done) zurückgeben
Optimierungspunkt: Behebe den Fehler, bei dem die Hindernis-Belohnung nicht ausgelöst werden kann, vereinfache die Logikprüfung
"""
x, y = self.current_pos
# Position gemäß action aktualisieren
if action == 0: # oben
x = max(0, x - 1)
elif action == 1: # unten
x = min(self.grid_size[0] - 1, x + 1)
elif action == 2: # links
y = max(0, y - 1)
elif action == 3: # rechts
y = min(self.grid_size[1] - 1, y + 1)
# Prüfen, ob ein Hindernis getroffen wird (Kernkorrektur: zuerst aufzeichnen, ob ein Hindernis getroffen wird, dann Position behandeln)
new_pos = (x, y)
hit_obstacle = False # Markieren, ob ein Hindernis getroffen wird
if new_pos in self.obstacle_pos:
hit_obstacle = True # Kollisionsstatus mit Hindernis aufzeichnen
new_pos = self.current_pos # Hindernis getroffen, Position unverändert
self.current_pos = new_pos
next_state = self.pos_to_state(new_pos)
# Belohnung berechnen (basierend auf zuvor aufgezeichnetem hit_obstacle, den Widerspruch in der ursprünglichen Logik beheben)
if new_pos == self.goal_pos:
reward = 100.0 # Ziel erreicht, große Belohnung
done = True
elif hit_obstacle: # Basierend auf dem Flag, nicht auf dem geänderten new_pos
reward = -50.0 # Hindernis getroffen, Strafe
done = False
else:
reward = -1.0 # Kleine Strafe für jeden Schritt, um schnelles Erreichen des Ziels zu fördern
done = False
return next_state, reward, done
# ====================== 2. Q-Learning-Hauptprogramm ======================
if __name__ == "__main__":
# Optimierung 1: Zufalls-Seed festlegen, um reproduzierbare Versuchsergebnisse sicherzustellen
random_seed = 42
random.seed(random_seed)
np.random.seed(random_seed)
# Umgebung initialisieren
env = GridWorldEnv(
grid_size=(5, 5), # 5x5-Raster
start_pos=(0, 0), # Startpunkt
goal_pos=(4, 4), # Zielpunkt
obstacle_pos=[(1,1), (2,2), (3,1)] # Hindernispositionen
)
# Anzahl der Zustände berechnen
num_states = env.grid_size[0] * env.grid_size[1]
num_actions = env.num_actions
# Initialisiere die Q-Tabelle (Aktionswertfunktion) mit Form [num_states, num_actions]
Q_table = np.zeros([num_states, num_actions])
# Hyperparameter definieren
learning_rate = 0.1 # Lernrate
discount_factor = 0.9 # Diskontfaktor
epsilon = 0.1 # Explorationsrate
total_episodes = 1000 # Anzahl der Trainingsepisoden
# Trainingsprozess
for episode in range(total_episodes):
state = env.reset() # Umgebung auf den Startpunkt zurücksetzen, Anfangszustand S abrufen
done = False # Markiert, ob diese Episode endet
total_reward = 0 # Gesamtbelohnung für diese Episode aufzeichnen
while not done:
# 1. ε-greedy-Strategie zur Aktionsauswahl
if random.uniform(0, 1) < epsilon:
action = env.random_action() # Exploration: zufällig eine Aktion wählen
else:
# Exploitation: Aktion mit dem höchsten Q-Wert wählen, Gleichstände behandeln
q_values = Q_table[state]
max_q = np.max(q_values)
best_actions = np.where(q_values == max_q)[0]
action = random.choice(best_actions) # Zufällig eine wählen, wenn ein Gleichstand besteht
# 2. Aktion ausführen und mit der Umgebung interagieren
next_state, reward, done = env.step(action)
total_reward += reward
# 3. Q-Tabelle aktualisieren (Kern: Q-Learning-Formel)
# Q(S, A) = Q(S, A) + α * [ R + γ * max(Q(S', a')) - Q(S, A) ]
old_value = Q_table[state, action]
next_max = np.max(Q_table[next_state]) # Maximaler Q-Wert des nächsten Zustands
# Ziel-Q-Wert berechnen
target = reward + discount_factor * next_max
# Q-Wert aktualisieren
new_value = old_value + learning_rate * (target - old_value)
Q_table[state, action] = new_value
# 4. Zum nächsten Zustand wechseln
state = next_state
# Trainingsfortschritt alle 100 Episoden ausgeben
if (episode + 1) % 100 == 0:
print(f"Episode {episode + 1}/{total_episodes}, Gesamtbelohnung: {total_reward:.1f}")
# ====================== 3. Optimale Policy extrahieren (optimiertes Ausgabeformat, intuitiver) ======================
policy: Dict[int, str] = {}
print("\n=== Optimale Policy nach dem Lernen (Rasterlayout) ===")
# Optimierung 2: In Rasterform ausgeben, um die Policy des gesamten Rasters intuitiv darzustellen
grid_rows, grid_cols = env.grid_size
for row in range(grid_rows):
row_str = []
for col in range(grid_cols):
pos = (row, col)
state = env.pos_to_state(pos)
if pos in env.obstacle_pos:
row_str.append(" Hindernis ")
elif pos == env.goal_pos:
row_str.append(" Ziel ")
elif pos == env.start_pos:
# Markiere außerdem den Startpunkt und seine optimale Aktion
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
row_str.append(f" Start({best_action}) ")
else:
best_action_idx = np.argmax(Q_table[state])
best_action = env.action_to_direction(best_action_idx)
policy[state] = best_action
row_str.append(f" {best_action} ")
print("|".join(row_str))
# ====================== 4. Teste die optimale Strategie ======================
print("\n=== Teste die optimale Strategie ===")
state = env.reset()
done = False
steps = 0
path = [env.state_to_pos(state)]
while not done and steps < 50: # Maximal 50 Schritte, um Endlosschleifen zu verhindern
best_action_idx = np.argmax(Q_table[state])
next_state, reward, done = env.step(best_action_idx)
current_pos = env.state_to_pos(next_state)
path.append(current_pos)
state = next_state
steps += 1
print(f"Pfad: {path}")
print(f"Schritte bis zum Ziel: {steps}")
print(f"Ziel erreicht: {env.current_pos == env.goal_pos}")
Code-Erklärung:
Q_tableist die zentrale Aktionswertfunktion, mit der Form[number of states, number of actions](im Beispiel 25×4, entsprechend den 25 Zuständen des 5×5-Gitters und den 4 Aktionen oben/unten/links/rechts).Q_table[s, a]Bezeichnet für Zustands(den Index der Gitterposition), den langfristigen Wert der Ausführung von Aktiona(0-3 entsprechen oben/unten/links/rechts), alle anfangs 0, im Training Schritt für Schritt aktualisiert.env.step(action)Simuliert die zentrale Interaktionslogik des Markov-Entscheidungsprozesses (MDP): Nach Eingabe eines Aktionsindex aktualisiert es zuerst die Gitterposition des Agenten (bei Kollision mit einem Hindernis bleibt die Position unverändert) und gibt dann ein Tripel zurück:(next_state, reward, done)——next_stateist der Index des neuen Zustands,rewardist die differenzierte Belohnung (Ziel +100, Hindernis -50, jeder Schritt -1),donegibt an, ob das Ziel erreicht wurde (Ende dieser Episode).- Die zentrale Aktualisierungsformel von Q-Learning
Q(S,A) = Q(S,A) + α * [R + γ * max(Q(S', a')) - Q(S,A)]wird im Code zerlegt und implementiert: Zuerst wird der aktuelle Q-Wert abgerufenold_value, dann wird der maximale Q-Wert des nächsten Zustands berechnetnext_max, dann wird der Zielwert berechnettarget = 奖励 + 折扣因子 × 下一状态最大Q值, und schließlich wird die Lernrate verwendetα, um den alten Wert mit dem Zielwert zu verrechnen und den aktualisierten Q-Wert zu erhalten, wodurch der Aktionswert iterativ korrigiert wird. epsilon(Erkundungsrate) balanciert "Ausbeutung" und "Erkundung" durch die ε-greedy-Strategie aus: mitepsilonWahrscheinlichkeit wird zufällig eine Aktion gewählt (das Unbekannte erkunden); mit1-epsilonWahrscheinlichkeit wird die Aktion mit dem größten Q-Wert im aktuellen Zustand gewählt (das bekannte Optimum ausnutzen). Der Code behandelt außerdem den Gleichstand bei Q-Werten: Wenn mehrere Aktionen denselben Q-Wert haben, wird eine zufällig ausgewählt, wodurch ein Festfahren der Strategie durch eine einzelne feste Wahl vermieden wird.- Der Code implementiert zusätzlich eine bidirektionale Zuordnung zwischen Zuständen und Rasterpositionen (
pos_to_state/state_to_pos), die Umwandlung zwischen Aktionen und Richtungsnamen (action_to_direction) sowie die Strategieextraktion und das Testen nach dem Training: Alle Zustände durchlaufen, in jedem Zustand die Aktion mit dem größten Q-Wert als optimale Strategie wählen und den Pfad sowie die Anzahl der Schritte vom Startpunkt zum Zielpunkt unter dieser Strategie überprüfen.
Episode 100/1000, Total Reward: 93.0
Episode 200/1000, Total Reward: 90.0
Episode 300/1000, Total Reward: 92.0
Episode 400/1000, Total Reward: 90.0
Episode 500/1000, Total Reward: 93.0
Episode 600/1000, Total Reward: 93.0
Episode 700/1000, Total Reward: 91.0
Episode 800/1000, Total Reward: 93.0
Episode 900/1000, Total Reward: 93.0
Episode 1000/1000, Total Reward: 93.0

=== 学习完成后的最优策略 ===
位置 (0, 0): 最优动作 = right
位置 (0, 1): 最优动作 = right
位置 (0, 2): 最优动作 = down
位置 (0, 3): 最优动作 = down
位置 (0, 4): 最优动作 = down
位置 (1, 0): 最优动作 = up
位置 (1, 1): 最优动作 = 障碍物
位置 (1, 2): 最优动作 = right
位置 (1, 3): 最优动作 = down
位置 (1, 4): 最优动作 = left
位置 (2, 0): 最优动作 = down
位置 (2, 1): 最优动作 = down
位置 (2, 2): 最优动作 = 障碍物
位置 (2, 3): 最优动作 = down
位置 (2, 4): 最优动作 = down
位置 (3, 0): 最优动作 = down
位置 (3, 1): 最优动作 = 障碍物
位置 (3, 2): 最优动作 = right
位置 (3, 3): 最优动作 = right
位置 (3, 4): 最优动作 = down
位置 (4, 0): 最优动作 = right
位置 (4, 1): 最优动作 = right
位置 (4, 2): 最优动作 = right
位置 (4, 3): 最优动作 = right
位置 (4, 4): 最优动作 = 终点

=== 测试最优策略 ===
路径: [(0, 0), (0, 1), (0, 2), (1, 2), (1, 3), (2, 3), (3, 3), (3, 4), (4, 4)]
到达终点步数: 8
是否到达终点: True
Zusammenfassung und praktisches Denken
Das Grundgerüst des bestärkenden Lernens lässt sich wie folgt zusammenfassen:Der Agent interagiert mit der Umgebung in Form eines Markov-Entscheidungsprozesses und optimiert auf Basis der erhaltenen Belohnungssignale kontinuierlich seine Strategie (üblicherweise durch Lernen und Aktualisieren von Wertfunktionen), mit dem ultimativen Ziel, die langfristige kumulative Belohnung zu maximieren.
| Konzept | Analogie | Rolle beim bestärkenden Lernen |
|---|---|---|
| Agent | Lernender Welpe / Schach spielende KI | Das entscheidungsfindende Subjekt, das den Lernalgorithmus ausführt |
| Umgebung | Trainer / Schachbrettregeln | Externes System, das Zustände und Belohnungsfeedback bereitstellt |
| State | Haltung des Welpen / Schachbrettposition | Aktuelle Informationsgrundlage für den Agenten, um Entscheidungen zu treffen |
| Aktion | Sich hinsetzen / Eine Figur ziehen | Auswahlmöglichkeiten, die der Agent hat |
| Belohnung | Leckerli / Sieg- oder Niederlage-Ergebnis | Unmittelbares Signal, das die Qualität einer Aktion bewertet; der Lernkompass |
| Policy | Die Befehlsantwort, die der Welpe gelernt hat | Zuordnungsregel von Zuständen zu Aktionen; das Ziel des Lernens |
| Wertfunktion | Langfristige Bewertung der Situation | Sie bewertet den langfristigen Wert eines Zustands oder einer Aktion; sie ist die Grundlage für die Optimierung der Strategie |