Polynomielle Regression
Stellen Sie sich vor, Sie beobachten die Flugbahn eines Objekts, das vom Himmel fällt. Seine Fallgeschwindigkeit ist nicht gleichmäßig, sondern wird immer schneller. Wenn Sie eine Gerade verwenden, um diese Flugbahn anzupassen, wird das Ergebnis sehr schlecht sein, weil eine Gerade diese gekrümmte Veränderung nicht beschreiben kann. An diesem Punkt brauchen wir eine Linie, die sich biegen kann – die polynomiale Regression ist ein leistungsstarkes Werkzeug zur Lösung solcher Probleme.
Einfach ausgedrückt:Die polynomiale Regressionist eine Erweiterung der linearen Regression. Sie bildet Daten in einen höherdimensionalen Raum ab, indem sie Terme höheren Grades (wie quadratische Terme, kubische Terme) zu den ursprünglichen Merkmalen hinzufügt und dadurch eine "Kurve" verwendet, um die in den Daten vorhandenen nichtlinearen Beziehungen anzupassen.
1. Kernkonzepte: Von Geraden zu Kurven
1.1 Wiederholung der linearen Regression
Die Modellformel für die lineare Regression ist sehr einfach:y = w₁ * x + bwobei:
yist der Zielwert, den wir vorhersagen wollen.xist das Eingabemerkmal.w₁ist das Gewicht (die Steigung) des Merkmals.bist der Bias-Term (Achsenabschnitt).
Dieses Modell bestimmt, dass es nur einegerade Linie zeichnen kann。
1.2 Einführung in die polynomiale Regression
Die Kernidee der polynomialen Regression ist:Behandeln Sie höhere Potenzen des Merkmals als neue Merkmaleund wenden Sie dann lineare Regression auf diese erweiterte Merkmalsmenge an.
Zum Beispiel ein quadratisches polynomiales Regressionsmodell:y = w₁ * x + w₂ * x² + b
Sie sehen, obwohl die Gleichung nun enthältx²aber wenn wirxundx²sie als zwei unabhängige Merkmale betrachtenX1undX2dann wird das Modell zu:y = w₁ * X1 + w₂ * X2 + bDies ist im Wesentlichen immer noch einlineares Modellaber es ist linear bezüglich derMerkmale X1undX2linear. Deshalb wird die polynomiale Regression als "Erweiterung der linearen Regression" bezeichnet.
1.3 Schlüsselbegriffe
- Grad/Ordnung: Der höchste Exponent im Polynom. Grad 2 ist eine quadratische Kurve (Parabel), Grad 3 ist eine kubische Kurve, und so weiter.
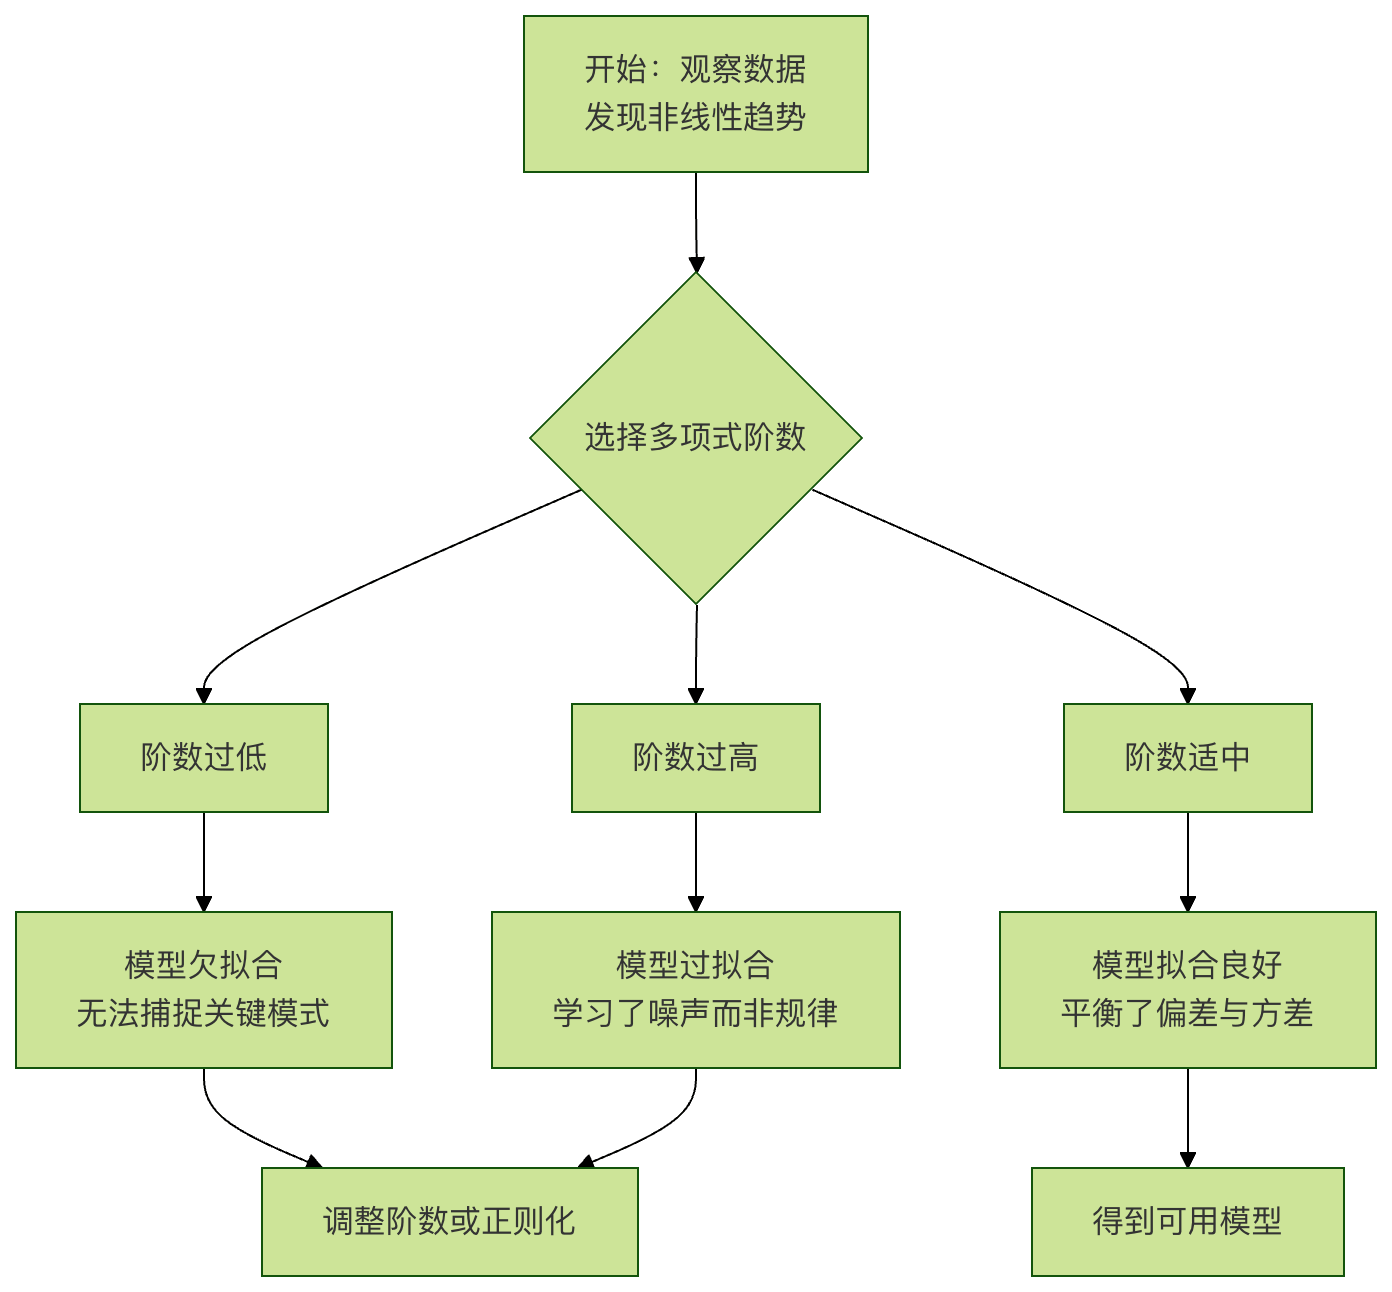
- Overfitting: Wenn der gewählte Grad zu hoch ist, wird das Modell sehr "verdreht", verläuft perfekt durch alle Trainingsdatenpunkte, aber seine Fähigkeit, neue Daten vorherzusagen, sinkt stark. Es ist, als würde man mit einem komplexen Netz ein paar Punkte fangen; wenn die Maschen zu fein sind, kann es große Fische verfehlen.
- Underfitting: Wenn der Grad zu niedrig ist (zum Beispiel, wenn man eine gerade Linie verwendet, um eindeutig gekrümmte Daten anzupassen), kann das Modell das zugrunde liegende Muster in den Daten nicht erfassen, und seine Vorhersagefähigkeit ist ebenfalls schlecht.
Das folgende Flussdiagramm veranschaulicht einen typischen Gedankengang für die Anwendung der polynomialen Regression:
2. Praxis: Implementierung der polynomialen Regression in Python
Wir werdenscikit-learndiese leistungsstarke Machine-Learning-Bibliothek, die die Implementierung der polynomialen Regression sehr einfach macht.
2.1 Vorbereitung der Umgebung und der Daten
Stellen Sie zunächst sicher, dass die erforderlichen Bibliotheken installiert sind, und erstellen Sie einen Satz simulierter nichtlinearer Daten.
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# Zufallsseed setzen, um konsistente Ergebnisse über Durchläufe hinweg sicherzustellen
np.random.seed(42)
# Simulierte Daten erstellen: y ist eine quadratische Funktion von x plus etwas zufälligem Rauschen
X = 6 * np.random.rand(100, 1) - 3 # Erzeuge 100 Zufallszahlen im Intervall [-3, 3)
y = 0.5 * X**2 + X + 2 + np.random.randn(100, 1) # y = 0.5x^2 + x + 2 + Rauschen
# Die Originaldaten visualisieren
plt.scatter(X, y, s=10, alpha=0.7, label='Originaldaten')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Simulierte nichtlineare Daten')
plt.legend()
plt.show()
Wenn Sie diesen Code ausführen, werden Sie sehen, dass die Datenpunkte ungefähr einer "U"-förmigen Verteilung (Parabel) folgen und das Anpassen einer geraden Linie eindeutig ungeeignet ist.
2.2 Kernschritte: Feature-Transformation und Modelltraining
Der entscheidende Schritt ist die Verwendung vonPolynomialFeatureszur Erzeugung von Merkmalen höheren Grades.
Beispiel
# Der Parameter degree bestimmt den Grad des Polynoms; hier versuchen wir Grad 2
poly_features = PolynomialFeatures(degree=2, include_bias=False)
# Transformiere das ursprüngliche Merkmal X in eine neue Merkmalsmatrix X_poly, die X und X^2 enthält
X_poly = poly_features.fit_transform(X)
print(f"Ursprüngliche Form von X: {X.shape}")
print(f"Transformierte Form von X_poly: {X_poly.shape}")
print(f"Erste 5 Zeilen der X_poly-Daten:\n{X_poly[:5]}")
# Die Ausgabe zeigt, dass X_poly zwei Spalten hat: Die erste Spalte ist X und die zweite ist X^2
# 2. Trainiere ein lineares Regressionsmodell auf den transformierten Merkmalen
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y) # Verwende X_poly statt des ursprünglichen X
# 3. Zeige die gelernten Modellparameter (Gewichte und Bias)
print(f"\nModellparameter (Gewichte w1, w2): {lin_reg.coef_.ravel()})
print(f"Modell-Bias (Achsenabschnitt b): {lin_reg.intercept_}")
# Die Ausgabe sollte nahe bei den Parametern [1, 0.5] und 2 liegen, die bei der Generierung der Daten verwendet wurden
2.3 Visualisierung der Anpassungsergebnisse
Schauen wir uns an, wie das trainierte "Kurven"-Modell aussieht.
Beispiel
X_new = np.linspace(-3, 3, 100).reshape(100, 1)
# Wende dieselbe Polynommerkmals-Transformation auf diese neuen Punkte an
X_new_poly = poly_features.transform(X_new)
# Verwende das Modell, um Vorhersagen zu treffen
y_new = lin_reg.predict(X_new_poly)
# Beginne mit dem Zeichnen
plt.scatter(X, y, s=10, alpha=0.7, label='Trainingsdaten')
plt.plot(X_new, y_new, 'r-', linewidth=2, label='Anpassung der polynomialen Regression (Grad=2)')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Anpassungseffekt der quadratischen Polynomregression')
plt.legend()
plt.show()
Sie sollten eine schöne rote Kurve sehen, die den parabolischen Trend der Daten gut erfasst.
3. Wichtiges Thema: Wie wählt man den richtigen Grad?
Die Wahl des Grades ist ein Abwägungsprozess. Wir können dies intuitiv verstehen, indem wir die Anpassungseffekte verschiedener Grade visualisieren.
Beispiel
degrees = [1, 2, 15]
plt.figure(figsize=(15, 4))
for i, degree in enumerate(degrees):
# Subplots erstellen
ax = plt.subplot(1, len(degrees), i + 1)
# Polynommerkmale generieren und das Modell trainieren
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
lin_reg.fit(X_poly, y)
# Vorhersagen und darstellen
y_new = lin_reg.predict(poly_features.transform(X_new))
ax.scatter(X, y, s=10, alpha=0.7)
ax.plot(X_new, y_new, 'r-', linewidth=2)
ax.set_title(f'Grad = {degree}')
ax.set_xlabel('X')
ax.set_ylabel('y')
# R²-Score berechnen und anzeigen (näher an 1 ist besser)
y_pred = lin_reg.predict(X_poly)
r2 = r2_score(y, y_pred)
ax.text(0.05, 0.95, f'$R^2$ = {r2:.3f}', transform=ax.transAxes,
verticalalignment='top', bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))
plt.tight_layout()
plt.show()
Beobachtung und Interpretation:
- Grad=1 (linear): eine gerade Linie,
R²der Score ist niedrig, eindeutigUnteranpassung, nicht in der Lage, die Krümmung der Daten auszudrücken. - Grad=2 (quadratisch): eine glatte Kurve,
R²der Score ist hoch, und der Anpassungseffekt ist sehr gut. - Grad=15 (fünfzehnter Grad): die Kurve schwingt stark, verläuft durch viele Datenpunkte, sagt aber zwischen den Datenpunkten seltsam voraus. Auf den Trainingsdaten kann sein
R²Wert nahe bei 1 liegen, aber seine Vorhersagen für neue Daten werden sehr schlecht sein. Dies ist typisch fürÜberanpassung。
3.1 Ein wissenschaftlicherer Ansatz: Kreuzvalidierung
In der Praxis verwenden wirKreuzvalidierung, um die Leistung von Modellen mit unterschiedlichen Graden auf ungesehenen Daten zu bewerten und das Modell mit der besten Leistung auf dem Validierungssatz auszuwählen.scikit-learnvoncross_val_scorekann dies leicht erreichen.
Beispiel
# Teste einen Bereich von Graden
degrees_to_try = range(1, 11)
cv_scores = []
for degree in degrees_to_try:
poly_features = PolynomialFeatures(degree=degree, include_bias=False)
X_poly = poly_features.fit_transform(X)
lin_reg = LinearRegression()
# Verwende 5-fache Kreuzvalidierung mit negativem mittlerem quadratischem Fehler als Bewertungsmetrik (sklearn-Konvention: höherer Score ist besser, also negativen MSE verwenden)
scores = cross_val_score(lin_reg, X_poly, y, cv=5, scoring='neg_mean_squared_error')
cv_scores.append(-scores.mean()) # Bilde den Durchschnitt und rechne zurück in positiven MSE um
# Finde den Grad, der den Kreuzvalidierungsfehler minimiert
best_degree = degrees_to_try[np.argmin(cv_scores)]
print(f"Laut Kreuzvalidierung ist der beste Grad: {best_degree}")
# Visualisiere, wie sich der Kreuzvalidierungsfehler mit dem Grad ändert
plt.plot(degrees_to_try, cv_scores, 'bo-')
plt.xlabel('Polynomgrad')
plt.ylabel('Durchschnittlicher MSE der 5-fachen Kreuzvalidierung')
plt.title('Kreuzvalidierung zur Auswahl des besten Grades')
plt.axvline(x=best_degree, color='r', linestyle='--', label=f'Bester Grad={best_degree}')
plt.legend()
plt.grid(True)
plt.show()
4. Praktische Übungen
Jetzt ist es an der Zeit, praktisch zu werden und das Gelernte zu festigen.
Übung 1: Diagnose und BehebungFühren Sie den folgenden Code aus. Er versucht, Daten mit polynomialer Regression anzupassen, aber das Ergebnis ist schlecht. Bitte analysieren Sie, wo das Problem liegen könnte, und ändern Sie den Code so, dass die Anpassung korrekt erfolgt.
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
X = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)
y = np.array([2, 4, 9, 16, 25]) # Ungefähr y = x^2
# Versuch, mit einem Polynom 1. Grades (linear) zu fitten
poly = PolynomialFeatures(degree=1)
X_poly = poly.fit_transform(X)
model = LinearRegression().fit(X_poly, y)
X_plot = np.linspace(1, 5, 100).reshape(-1, 1)
X_plot_poly = poly.transform(X_plot)
y_plot = model.predict(X_plot_poly)
plt.scatter(X, y, label='Daten')
plt.plot(X_plot, y_plot, 'r-', label='Anpassung')
plt.legend()
plt.show()
Übung 2: Erkunden Sie einen echten DatensatzVerwenden Siescikit-learnintegriertBoston housing price datasetoderDiabetes dataset, wählen Sie ein Merkmal aus, das eine nichtlineare Beziehung zum Zielwert hat, und wenden Sie die polynomiale Regression an.
- Zeichnen Sie ein Streudiagramm der Originaldaten.
- Probieren Sie verschiedene Grade (2, 3, 4) aus und visualisieren Sie die angepassten Kurven.
- Verwenden Sie die Kreuzvalidierung, um den Polynomgrad zu finden, der die beste Vorhersageleistung für dieses Merkmal liefert.
Übung 3: Herausforderung - Multivariate polynomiale RegressionIn unserem obigen Beispiel gibt es nur ein Merkmalx. Polynomiale Regression funktioniert auch für mehrere Merkmale. Zum Beispiel mit zwei Merkmalenx1undx2,degree=2die Polynommerkmale würden Folgendes umfassen:x1, x2, x1², x1*x2, x2².(x1, x2)Versuchen Sie, einen simulierten Datensatz mit zwei Merkmalen zu erstelleny = x1 + x2² + 噪声(e.g.,PolynomialFeatures(degree=2)) und verwenden