Fehlerbehebung bei häufigen Problemen
Machine-Learning-Projekte, die von einem Laborprototyp in eine Produktionsumgebung übergehen, stoßen häufig auf eine Reihe unerwarteter Herausforderungen.
Ein Modell schneidet auf dem Trainingsdatensatz gut ab, performt aber nach der tatsächlichen Bereitstellung schlecht oder versagt sogar vollständig. Das ist ein Dilemma, das viele Machine-Learning-Ingenieure und Einsteiger erleben.
Dieser Artikel systematisiert die häufigsten Problemarten bei der Optimierung und Entwicklung von Machine-Learning-Modellen und bietet klare Fehlerbehebungsansätze und Lösungen, damit Sie robustere und zuverlässigere Machine-Learning-Systeme aufbauen können.
I. Probleme mit der Modellleistung: Gut im Training, schlecht in der Produktion
Dies ist das klassische und lästigste Problem. Ihr Modell erreicht 95% Genauigkeit in Jupyter Notebook, aber sobald es online bereitgestellt wird, fällt seine Leistung drastisch ab.
1. Inkonsistente Datenverteilung
Dies ist der "Nummer-eins-Killer" für Leistungseinbußen. Es gibt einen Unterschied in der statistischen Verteilung zwischen Trainingsdaten und Echtzeit-Online-Daten.
Häufige Szenarien und Anhaltspunkte zur Fehlerbehebung:
Inkonsistentes Feature-Engineering: Der Code für die Offline-Feature-Verarbeitung (z. B. Normalisierung, Bucketing, Imputation fehlender Werte) ist nicht genau derselbe wie der Code im Online-Dienst.
- Fehlerbehebung: Vergleichen Sie die Beispieldaten nach der Offline-Vorverarbeitung und der Online-Vorverarbeitung. Stellen Sie sicher, dass der verwendete Scaler (z. B.
StandardScaler) online verwendet die offline angepassten Parameter (scaler.mean_,scaler.scale_), anstatt neu anzupassen.
Zeitliche Verzerrung bei der Datenerfassung: Die Trainingsdaten stammen aus den vergangenen drei Monaten, während die Online-Daten aus der Gegenwart kommen. Nutzerverhalten und Marktbedingungen können sich geändert haben (Konzeptdrift).
- Fehlerbehebung: Überwachen Sie die Verteilung der Modelleingabemerkmale im Zeitverlauf. Sie können regelmäßig den Mittelwert, die Varianz und die Quantile der Merkmale berechnen und sie mit dem Trainingsdatensatz vergleichen.
Stichprobenauswahlverzerrung: Die Trainingsdaten können nicht alle Nutzer repräsentieren. Wenn Sie beispielsweise ein Empfehlungsmodell nur mit Daten aktiver Nutzer trainieren, wird es bei neuen oder stillen Nutzern fehlschlagen.
- Fehlerbehebung: Analysieren Sie die Verteilung der Nutzerprofile im Trainingsdatensatz und bei Online-Anfragen (z. B. Verhältnis neuer zu alter Nutzer, geografische Verteilung usw.).
Lösung:Erstellen Sie ein umfassendesDatenüberwachungundModellüberwachungSystem. Überwachen Sie nicht nur die Modellausgabe (z. B. AUC, Genauigkeit), sondern auch die Verteilung der Eingabemerkmale. Sobald Drift festgestellt wird, lösen Sie Warnungen aus und ziehen Sie in Betracht, Trainingsdaten zu aktualisieren oder das Modell neu zu trainieren.
Beispiel
import numpy as np
import pandas as pd
# Angenommen, dies ist der Wert des Merkmals 'feature_a', der in Echtzeit online empfangen wird
online_feature_values = [0.1, 0.5, 1.2, 0.8, 1.5, 2.0, 2.5]
training_mean = 0.5 # Mittelwert von 'feature_a' im Trainingssatz
training_std = 0.3 # Standardabweichung von 'feature_a' im Trainingssatz
current_online_mean = np.mean(online_feature_values[-100:]) # Mittelwert der letzten 100 Punkte
# Z-Score berechnen, um einfach festzustellen, ob signifikante Drift auftritt
z_score = (current_online_mean - training_mean) / training_std
print(f"Aktueller Online-Merkmalsmittelwert: {current_online_mean:.3f}")
print(f"Z-Score des Online-Mittelwerts im Vergleich zum Mittelwert des Trainingssatzes: {z_score:.3f}")
if abs(z_score) > 3: # Schwellenwert, z. B. 3 Standardabweichungen
print("Warnung: Das Feature 'feature_a' hat möglicherweise eine Verteilungsdrift erfahren!")
2. Datenleakage
Während des Trainings "späht" das Modell nach Informationen, die erst zur Vorhersagezeit bekannt sein sollten, was zu überhöhten Evaluierungsergebnissen führt.
Häufige Szenarien:
- Vor dem Aufteilen des Trainings-/Testsetsbevordie globale Normalisierung oder Imputation fehlender Werte durchgeführt wurde (unter Verwendung von Informationen aus dem Testset).
- Bei Zeitreihenproblemen werden zukünftige Daten verwendet, um die Vergangenheit vorherzusagen.
- Merkmale enthalten "zukünftige Informationen", die stark mit der Zielvariable zusammenhängen (z. B. die Verwendung von "ob heute eine Beschwerde eingegangen ist", um vorherzusagen, "ob die Bestellung heute storniert wird").
Fehlerbehebung und Lösung:Strikt den Machine-Learning-Workflow befolgen.Jede Operation, die Parameter aus Daten lernt (wie das Anpassen eines Scalers, die Imputation fehlender Werte, Feature-Auswahl), muss auf dem Trainingsset ausgeführt werden, und dann werden nur diese Parameter verwendet, um das Validierungs- und Testset zu transformieren.VerwendungsklearnvonPipelinekann dieses Problem effektiv vermeiden.
Beispiel
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
# X, y sind die Originaldaten und Labels
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # Falsch! Hier werden alle Daten verwendet, um den Scaler anzupassen
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)
# An diesem Punkt ist die Information in X_test zum scaler "durchgesickert", wodurch die Transformation von X_train beeinflusst wird
# Korrektes Beispiel: zuerst aufteilen, dann getrennt verarbeiten
X_train_raw, X_test_raw, y_train, y_test = train_test_split(X, y, test_size=0.2)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train_raw) # Nur mit dem Trainingssatz fitten
X_test = scaler.transform(X_test_raw) # Die auf dem Trainingssatz angepassten Parameter verwenden, um den Testsatz zu transformieren
II. Engineering- und Deployment-Probleme
Ein Modell aus einer Datei in eine hochverfügbare API zu verwandeln, die stabil bereitgestellt werden kann, ist voller Fallstricke.
1. Umgebungsabhängigkeiten und Versionskonflikte
"Bei mir läuft es!" — ein klassisches Problem. Die Python-Version und die Bibliotheksversionen in der Trainingsumgebung stimmen nicht mit denen in der Online-Inferenzumgebung überein.
Checkliste zur Fehlerbehebung:
- Python-Hauptversion (3.7 vs 3.9)
- Versionen der Kernbibliotheken (
tensorflow==2.8vstensorflow==2.12) - Systemabhängigkeiten (z. B. einige Bibliotheken hängen von bestimmten C++-Laufzeitbibliotheken ab)
- Modell-Serialisierungsformat (unter Verwendung von
picklegespeichertes Modell kann, wenn die Spanne der Python-Versionen groß ist, möglicherweise nicht geladen werden)
Lösung:
- Containerisierung: Verwenden Sie Docker, um das Modell und alle seine Abhängigkeiten in einem Image zu paketieren. Dies ist der Goldstandard für die Gewährleistung einer konsistenten Umgebung.
- Abhängigkeitsverwaltung: Verwenden Sie
requirements.txtoderenvironment.ymlum alle Pakete und ihre Versionen präzise zu erfassen. - Modellformat: Erwägen Sie die Verwendung eines sprachübergreifenden, umgebungsübergreifenden Modellformats wieONNXoderPMML, oder ein frameworkeigenes sicheres Format (z. B.,
TensorFlow SavedModel,PyTorch TorchScript)。
2. Schlechte Leistung bei der Online-Inferenz
Die API-Antwortzeit ist zu lang und der Durchsatz (TPS) reicht nicht aus, wodurch die Geschäftsanforderungen nicht erfüllt werden.
Häufige Engpässe und Optimierungen:
- Hohe Kosten pro einzelner Vorhersage: Das Modell selbst ist komplex (z. B. ein großes Deep-Learning-Modell).
- Optimierung: Modell-Pruning, Quantisierung, Knowledge Distillation oder Neuschreiben mit einer effizienteren Modellarchitektur.
- Häufige I/O- oder Netzwerkaufrufe: Jede Vorhersage erfordert das Abrufen von Merkmalen aus einer Datenbank oder einem Remote-Dienst.
- Optimierung: Implementieren Sie Feature-Caching, Vorberechnung oder Feature-Serving, um die Latenz zu reduzieren.
- Keine Nutzung der Hardwarebeschleunigung: Ein für GPU geeignetes Modell auf CPU ausführen.
- Optimierung: Wählen Sie die richtige Inferenz-Hardware (CPU/GPU/dedizierte KI-Chips) und das richtige Inferenz-Framework (z. B.,
TensorRT,OpenVINO)。
- Optimierung: Wählen Sie die richtige Inferenz-Hardware (CPU/GPU/dedizierte KI-Chips) und das richtige Inferenz-Framework (z. B.,
- Geringe Effizienz des Serving-Frameworks: Die direkte Verwendung von Flask zum Laden des Modells hat eine schwache Fähigkeit zur Nebenläufigkeitsbehandlung.
- Optimierung: Verwenden Sie ein hochperformantes ML-Serving-Framework wieTensorFlow Serving, TorchServeoderTriton Inference Server. Sie unterstützen erweiterte Funktionen wie Hot-Reloading von Modellen, dynamisches Batching und Multi-Modell-Hosting.
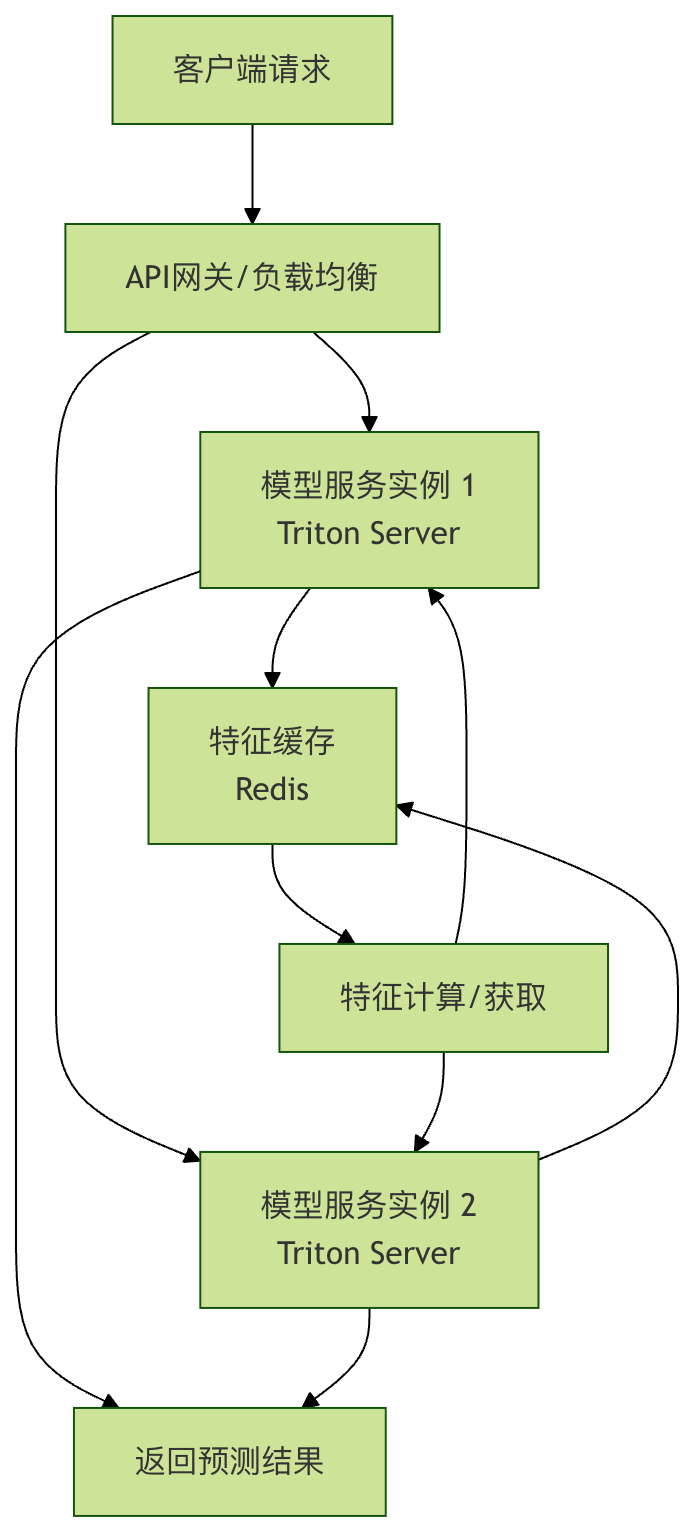
Abbildung: Ein Beispiel einer hochperformanten Modell-Serving-Architektur, einschließlich Lastverteilung, Feature-Caching und eines dedizierten Modellservers.
3. Unsachgemäßes Ressourcenmanagement
Der Modelldienst hat Speicherlecks, oder die Speichernutzung steigt im Laufe der Zeit kontinuierlich an, was schließlich zum Absturz des Dienstes führt.
Fehlerbehebung:
- Modell-Ladeansatz: Wird das Modell bei jeder Anfrage neu geladen? Der richtige Ansatz besteht darin, es beim Dienststart einmal in den Speicher zu laden und es für nachfolgende Anfragen gemeinsam zu nutzen.
- Anhäufung globaler Variablen: Gibt es im Dienstcode eine globale List- oder Dict-Variable, die immer weiter Daten ansammelt, ohne bereinigt zu werden?
- Große Vorhersageergebnisse: Belegen die zurückgegebenen Vorhersageergebnisse (z. B. Bilder, umfangreicher Text) viel Speicher und werden nicht rechtzeitig freigegeben?
Lösung:
- Verwendung
gunicorn、uvicornMultiprozess-/asynchrone Server, verstehen Sie deren Worker-Modell. - Starten Sie den Dienstprozess regelmäßig neu (über ein Prozessverwaltungstool wie z. B.
systemdodersupervisor)。 - Verwenden Sie professionelle Speicheranalysewerkzeuge (z. B.
memory_profiler) um die Leckstelle zu lokalisieren.
III. Modell- und Algorithmusprobleme
1. Überanpassung und Unteranpassung
Dies ist ein grundlegendes Problem der Modellfähigkeit.
| Problem | Symptom | Mögliche Ursachen | Lösung |
|---|---|---|---|
| Unteranpassung | Leistung auf Trainings- und ValidierungssetBeide sind schlecht | Das Modell ist zu einfach (geringe Komplexität), unzureichende Merkmale, nicht genügend Trainings-Epochen | Modellkomplexität erhöhen, effektivere Merkmale hinzufügen, Trainings-Epochen erhöhen |
| Überanpassung (Overfitting) | Leistung auf dem TrainingssetSehr gut, Leistung auf dem ValidierungssetSehr schlecht | Das Modell ist zu komplex, zu wenig Trainingsdaten, zu viel Rauschen | Trainingsdaten erhöhen, Regularisierung verwenden (L1/L2/Dropout), Modellkomplexität reduzieren, Early Stopping |
Fehlerbehebung:Das Zeichnen von Lernkurven ist die beste Methode, um die Fitting-Situation zu beurteilen.
2. Verschwindende/Explodierende Gradienten
Tritt häufig beim Training tiefer neuronaler Netze auf und führt dazu, dass das Modell nicht konvergiert oder das Training instabil wird.
Symptome:
- Der Modell-Loss wird
NaN。 - Gewichtswerte werden extrem groß oder extrem klein.
- Zu Beginn des Trainings ändert sich der Loss-Wert nicht mehr.
Lösungen:
- Gewichtsinitialisierung: Verwenden Sie
He初始化(ReLU-Aktivierungsfunktion) oderXavier初始化(Tanh/Sigmoid). - Gradientenclipping: Legen Sie einen Schwellenwert fest und beschneiden Sie den Gradienten, wenn er diesen überschreitet.
- Batch-Normalisierung: Fügen Sie eine
BatchNormSchicht vor der Aktivierungsfunktion hinzu, die das Training stabilisieren und die Verwendung einer höheren Lernrate ermöglichen kann. - Passen Sie die Netzwerkarchitektur an: Verwenden Sie Strukturen wie Residualverbindungen in ResNet.
IV. Etablieren Sie einen systematischen Fehlerbehebungsprozess
Wenn bei einem Online-Modell Probleme auftreten, kann ein systematischer Fehlerbehebungsprozess Ihnen helfen, das Problem schnell zu lokalisieren.
- Problem bestätigen: Sind alle Vorhersagen falsch oder betrifft es nur bestimmte Gruppen/Szenarien? Wie hoch ist die Fehlerrate?
- Eingabe prüfen: Rufen Sie einen Batch von Anfragedaten ab, die online fehlgeschlagen sind, prüfen Sie, ob die Eingabemerkmale vollständig sind, das Format korrekt ist und ob die Werte in einem vernünftigen Bereich liegen (z. B. das Auftreten von
NaN,Infoder extremen Werten). - Lokal reproduzieren: Verwenden Sie die Eingabedaten, die online fehlgeschlagen sind, und treffen Sie in der lokalen Entwicklungsumgebung mitdemselben Modell und CodeVorhersagen, und sehen Sie, ob das Problem reproduziert werden kann.
- Daten vergleichen: Vergleichen Sie die Datenverteilung der Online-Anfragen mit der Verteilung der Trainingsdaten und prüfen Sie, ob eine Drift vorliegt.
- Code und Konfiguration prüfen: Überprüfen Sie, ob die Codeversion, die Modelldateiversion und die Konfigurationsdatei des Online-Dienstes mit der Umgebung übereinstimmen, die den Test bestanden hat.
- Protokolle und Monitoring prüfen: Prüfen Sie, ob die Dienstprotokolle ungewöhnliche Fehler aufweisen und ob die CPU-, Arbeitsspeicher- und Antwortzeitmetriken im Monitoring-System anomal sind.
- Vereinfachen und lokalisieren: Versuchen Sie, wenn möglich, ein minimalistisches Modell oder ein regelbasiertes System zur Verarbeitung der fehlerhaften Eingabe zu verwenden, und stellen Sie fest, ob es sich um ein Datenproblem oder ein Modellproblem handelt.