Die wahren Kosten von Modellen
Stellen Sie sich vor, Sie haben gerade ein Bilderkennungsmodell trainiert, das 99% Genauigkeit im Testsatz erreicht, und setzen es zuversichtlich in der Produktionslinie einer Fabrik ein.
Doch ein paar Wochen später erhalten Sie Feedback: Das Modell schätzt häufig falsch ein, wodurch die Produktionslinie mehrfach ohne Grund stillgelegt wird, was zu enormen wirtschaftlichen Verlusten führt. Wo liegt das Problem?
Dieses Szenario offenbart eine Wahrheit, die im Bereich des maschinellen Lernens oft übersehen wird:Die hervorragende Leistung eines Modells in einer Labor- oder Testumgebung bedeutet nicht, dass es in der realen Welt erfolgreich ist.
Auf dem Weg eines Modells von der Entwicklung bis zur Bereitstellung gibt es viele Einschränkungen und versteckte Kosten.
Dieser Artikel führt Sie tief in diese realen Kosten ein und hilft Ihnen, eine umfassendere und pragmatischere Sicht auf maschinelles Lernen zu entwickeln.
Jenseits der Genauigkeit - Die Gesamtkosten von Modellen verstehen
Wenn wir über die Kosten eines Modells sprechen, denken die meisten zuerst an die GPU-Zeit und den Strom, der während des Trainings verbraucht wird. Aber das ist nur die Spitze des Eisbergs.
Die Kosten eines vollständigen Machine-Learning-Projekts umfassen mindestens die folgenden vier Dimensionen:
1. Datenkosten: Beschaffung und Reinigung des Treibstoffs
Machine-Learning-Modelle nutzen Daten als „Treibstoff“, und die Kosten für die Beschaffung hochwertigen Treibstoffs sind extrem hoch.
Kosten der Datenerfassung:
- Monetäre Kosten: Ausgaben für den Kauf annotierter Datensätze und die Nutzung von Datenerfassungsdiensten (wie die Crowdsourcing-Plattform MTurk).
- Zeitkosten: Von der Definition von Annotationsspezifikationen und der Schulung von Annotatoren bis zum Abschluss der ersten Annotation kann der Zyklus Wochen oder sogar Monate dauern.
- Compliance-Kosten: Die Sicherstellung, dass die Datenerfassung Gesetze und Vorschriften wie DSGVO (Datenschutz-Grundverordnung) und CCPA (California Consumer Privacy Act) einhält, kann Rechtsberatung und Prozessgestaltung erfordern.
Kosten für Datenvorverarbeitung und Annotation:
- Bereinigungskosten: Daten aus der realen Welt sind voller Rauschen, fehlender Werte und Ausreißer. Die Bereinigung nimmt typischerweise 60-80% der Zeit des gesamten Projekts in Anspruch.
- Annotationskosten: Wenn man die Annotation von Bounding-Boxen in Bildern als Beispiel nimmt, kann die Annotation eines einzelnen komplexen Bildes mehrere Minuten dauern. Bei einem Datensatz mit einhunderttausend Bildern sind die Arbeits- und Verwaltungskosten für die Annotation beträchtlich.
Beispiel
def estimate_labeling_cost(num_images, time_per_image, cost_per_hour):
"""
Schätzen Sie die Gesamtkosten der Datenannotation
Parameter:
num_images (int): Gesamtzahl der zu annotierenden Bilder
time_per_image (float): Durchschnittliche Zeit zum Annotieren eines einzelnen Bildes (Stunden)
cost_per_hour (float): Stündliche Kosten eines Annotators (Währungseinheit)
Rückgabe:
total_hours, total_cost: Gesamtstunden und Gesamtkosten
"""
total_hours = num_images * time_per_image
total_cost = total_hours * cost_per_hour
return total_hours, total_cost
# Angenommen, ein Projekt hat 100,000 Bilder, jedes benötigt 0.05 Stunden (3 Minuten) zum Annotieren, und die stündlichen Kosten betragen 20 yuan
hours, cost = estimate_labeling_cost(100000, 0.05, 20)
print(f"Gesamtstunden: {hours:.0f} Stunden")
print(f"Gesamtkosten: {cost:.2f} yuan")
# Ausgabe: Gesamtstunden: 5000 Stunden
# Ausgabe: Gesamtkosten: 100000.00 yuan
2. Rechenkosten: Die Energierechnung für Training und Inferenz
Die Rechenkosten werden in einmalige Trainingskosten und laufende Inferenzkosten unterteilt.
Trainingskosten:
- Verwenden Sie stündlich abgerechnete GPU-Instanzen von Cloud-Diensten (wie AWS SageMaker, Google Cloud AI Platform).
- Der Prozess der Modellabstimmung (Hyperparameter-Optimierung) kann das Training von Dutzenden bis Hunderten von Modellreplikaten erfordern, was die Kosten vervielfacht.
Inferenzkosten:
- Nach der Bereitstellung des Modells entstehen jedes Mal Rechenkosten, wenn es eine Benutzeranfrage verarbeitet (d. h. eine Vorhersage trifft).
- Bei Diensten mit hoher Parallelität (wie personalisierten Empfehlungssystemen) können die kumulierten Kosten selbst dann enorm sein, wenn die Kosten pro Inferenz sehr niedrig sind.
Beispiel
def estimate_training_cost(training_hours, instance_hourly_rate, num_trials=1):
"""
Schätzen Sie die Kosten für das Training eines Modells auf einer Cloud-Plattform
Parameter:
training_hours (float): Anzahl der Stunden, die für einen einzelnen Trainingslauf erforderlich sind
instance_hourly_rate (float): Stundensatz der GPU-Instanz (USD)
num_trials (int): Anzahl der Hyperparameter-Suchen oder Experimente
Rückgabe:
total_cost: Geschätzte Gesamtkosten
"""
total_cost = training_hours * instance_hourly_rate * num_trials
return total_cost
# Angenommen, das Training eines Modells dauert 10 Stunden, wobei eine P3-Instanz zu 4 $ pro Stunde verwendet wird und 20 Sätze von Hyperparameter-Experimenten durchgeführt werden
cost = estimate_training_cost(10, 4, 20)
print(f"Geschätzte Gesamtkosten für das Training: {cost} USD")
# Ausgabe: Geschätzte Gesamtkosten für das Training: 800 USD
3. Bereitstellungs- und Wartungskosten: Das Modell in Betrieb halten
Ein Modell in einer Produktionsumgebung bereitzustellen und es stabil in Betrieb zu halten, ist eine langfristige Investition.
Infrastrukturkosten:
- Kosten für Server, Container-Management (wie Kubernetes), Lastverteilung und Netzwerkverkehr.
- Tool- und Personalkosten für die Entwicklung von Deployment-Pipelines (CI/CD für ML).
Monitoring- und Wartungskosten:
- Es ist notwendig, die Vorhersageleistung, Latenz und Ressourcennutzung des Modells kontinuierlich zu überwachen.
- Die Datenverteilung kann sich im Laufe der Zeit ändern (Konzeptdrift), was ein regelmäßiges Neutraining oder Fine-Tuning des Modells mit neuen Daten erfordert, wodurch laufende Kosten für das Neutraining entstehen.
4. Opportunitätskosten und Risikokosten: Der unsichtbare Preis
Dies ist der am leichtesten zu unterschätzende Teil.
Opportunitätskosten:
- Wenn ein Team 3 Monate für die Entwicklung einer Machine-Learning-Lösung aufwendet, kann dies bedeuten, dass die Gelegenheit verpasst wird, das Problem in 1 Monat mit einem einfacheren regelbasierten System zu lösen.
Risikokosten:
- Modell-Bias: Wenn die Trainingsdaten nicht repräsentativ für alle Nutzer sind, kann das Modell gegenüber bestimmten Gruppen unfair sein, was ethische Probleme und PR-Krisen auslösen kann.
- Vorhersagefehler: In Bereichen wie dem Gesundheitswesen, der Finanzwelt und dem autonomen Fahren kann eine einzige falsche Vorhersage zu Personenschäden oder erheblichen Sachschäden führen und rechtliche Risiken mit sich bringen.
Die Obergrenze der Technologie - Inhärente Grenzen des maschinellen Lernens
Selbst ohne Berücksichtigung der Kosten hat die Technologie des maschinellen Lernens selbst inhärente Grenzen.
1. Datenabhängigkeit und "Garbage In, Garbage Out"
Modelle des maschinellen Lernens sind vollständig von ihren Trainingsdaten abhängig. Wenn die Daten schlechte Qualität, einen geringen Umfang oder eine Verzerrung aufweisen, ist die Leistung des Modells begrenzt.
- Problem kleiner Datenmengen: Für bestimmte Nischenbereiche (wie die Diagnose seltener Krankheiten) kann es unmöglich sein, genügend hochwertige Daten zu erhalten, um ein zuverlässiges Modell zu trainieren.
- Datenverzerrung: Wenn historische Daten soziale Verzerrungen enthalten (wie Geschlechterdiskriminierung bei der Einstellung), lernt das Modell diese Verzerrungen und verstärkt sie.
2. Das Interpretierbarkeitsdilemma: Der Preis der Blackbox
Viele Hochleistungsmodelle (wie tiefe neuronale Netze) sind komplexe "Blackboxen", was es uns erschwert, ihre interne Entscheidungslogik zu verstehen.
- In Bereichen, die hohe Zuverlässigkeit und Prüfbarkeit erfordern (wie Kreditgenehmigung und Justizhilfe), ist die Verwendung von Blackbox-Modellen möglicherweise nicht erlaubt.
- Wenn das Modell Fehler macht, ist es schwierig, die Grundursache zu diagnostizieren, was die Fehlersuche und -behebung erschwert.
3. Die Grenzen der Generalisierungsfähigkeit
Ein Modell, das bei Trainings- und Testsets gut abschneidet, bedeutet nicht, dass es alle Situationen in der realen Welt bewältigen kann.
- Out-of-Distribution-Daten: Das Modell kann möglicherweise keine Eingaben verarbeiten, die sich zu stark von der Verteilung der Trainingsdaten unterscheiden. Zum Beispiel kann ein autonomes Fahrsystem, das nur mit sonnigen Bildern trainiert wurde, bei nebligem Wetter vollständig versagen.
- Adversariale Beispiele: Winzige, für Menschen nicht wahrnehmbare Störungen der Eingabe können dazu führen, dass das Modell völlig falsche Vorhersagen trifft, was eine große Bedrohung für Systeme mit hohen Sicherheitsanforderungen darstellt.
Beispiel
import numpy as np
# Angenommen, ein einfacher "Katze-vs-Hund-Klassifikator" hat während des Trainings nur klare Bilder gesehen
def trained_classifier_confidence(image):
"""Simuliere ein Modell, das auf klaren Bildern trainiert wurde"""
# Hier vereinfacht: Wenn die Varianz der Bildpixelwerte groß ist (was auf mehr Detail und höhere Klarheit hindeutet), ist die Konfidenz hoch
clarity = np.var(image)
if clarity > 1000: # Angenommener Schwellenwert für klare Bilder
return 0.95 # Hohe Konfidenz
else:
return 0.55 # Geringe Konfidenz, was darauf hindeutet, dass das Modell unsicher ist
# Simuliere ein klares Bild (hohe Varianz) und ein unscharfes Bild (niedrige Varianz)
clear_image = np.random.randn(100, 100) * 255 # Hohe Varianz, simuliert ein klares Bild
blurry_image = np.random.randn(100, 100) * 50 + 128 # Niedrige Varianz, simuliert ein unscharfes Bild
print(f"Vorhersagekonfidenz für klares Bild: {trained_classifier_confidence(clear_image):.2f}")
print(f"Vorhersagekonfidenz für unscharfes Bild: {trained_classifier_confidence(blurry_image):.2f}")
# Mögliche Ausgabe: Vorhersagekonfidenz für klares Bild: 0.95
# Mögliche Ausgabe: Vorhersagekonfidenz für unscharfes Bild: 0.55
# Zeigt, dass dem Modell bei ungesehenen unscharfen Bildern die Zuversicht fehlt
Kosten-Nutzen-Analyse – Wann sollte man maschinelles Lernen einsetzen?
Angesichts dieser Kosten und Einschränkungen sollten wir maschinelles Lernen nicht blind anwenden. Bevor Sie ein Projekt starten, führen Sie unbedingt eine Kosten-Nutzen-Analyse durch und berücksichtigen Sie die folgenden Alternativen:
Entscheidungs-Flussdiagramm: Sollten wir maschinelles Lernen verwenden?
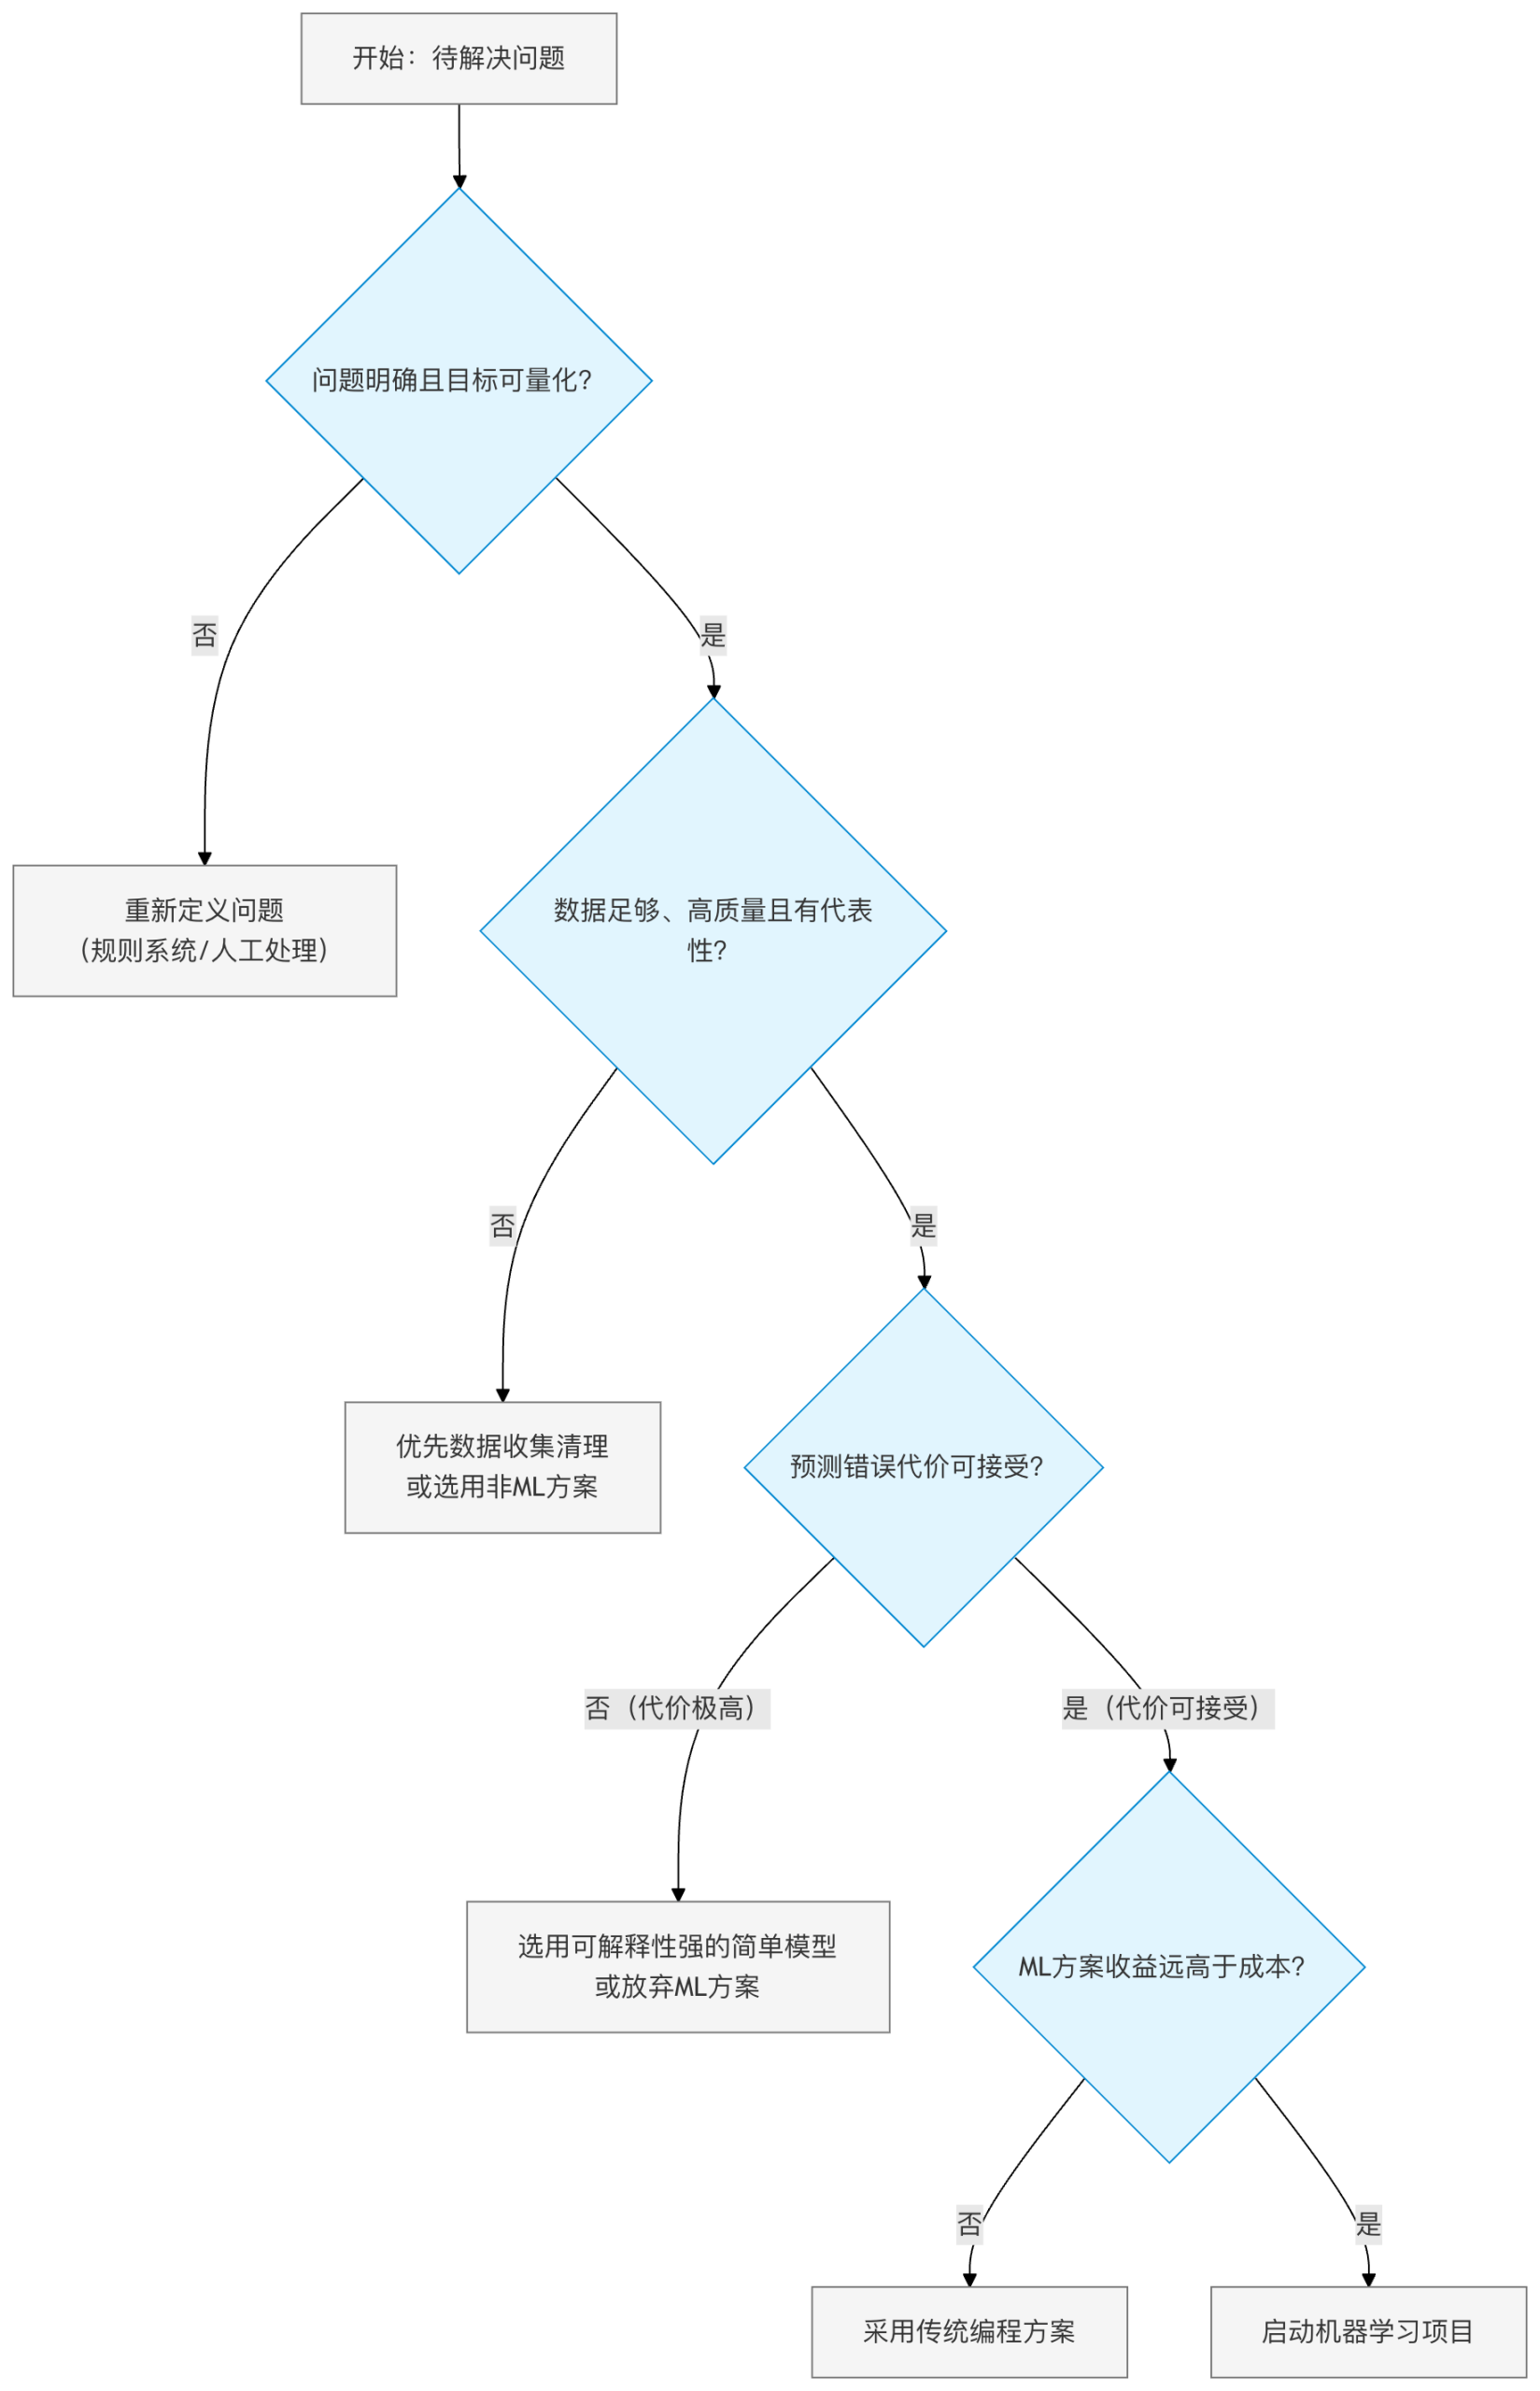
Pragmatische Alternativen
- Regelbasierte Systeme: Wenn die Geschäftslogik klar, stabil und mit wenigen Ausnahmen ist, ist das Schreiben von if-else-Regeln schneller, kostengünstiger und zuverlässiger.
- Statistische Methoden: Für viele analytische Aufgaben können klassische statistische Methoden wie lineare Regression und Hypothesentests bereits ausreichend sein und sind leichter zu interpretieren.
- Mensch-Maschine-Zusammenarbeit: In diesem Kontext ist die Verwendung von maschinellem Lernen als Hilfsmittel (z. B. das Herausfiltern von Fällen mit hoher Wahrscheinlichkeit zur manuellen Überprüfung) kosteneffizienter und sicherer als die vollständige Automatisierung.
Zusammenfassung und Handlungsleitfaden
Maschinelles Lernen ist eine leistungsstarke Technologie, aber es ist kein "Allheilmittel" für alle Probleme. Seine erfolgreiche Anwendung basiert aufeinem klaren Verständnis der Kosten in der realen Weltundvollem Respekt vor technischen Grenzen.
Handlungsempfehlungen für Einsteiger
- Klein anfangen: Wählen Sie für Ihr erstes Projekt ein Szenario mit geringem Umfang, leicht zugänglichen Daten und niedrigen Fehlerkosten (z. B. Sentimentanalyse von Filmkritiken unter Verwendung eines öffentlichen Datensatzes).
- Kosten umfassend schätzen: Führen Sie in der Projektplanungsphase bewusst eine grobe Kostenschätzung aus vier Dimensionen durch: Daten, Rechenleistung, Bereitstellung und Risiko.
- Einfache Lösungen priorisieren: Bevor Sie komplexe Deep-Learning-Modelle ausprobieren, versuchen Sie zunächst einfache Modelle wie logistische Regression und Entscheidungsbäume. Sie sind kostengünstiger, schneller und leichter zu interpretieren.
- Kontinuierliche Überwachung und Bewertung: Die Modellbereitstellung ist nicht das Ende. Legen Sie Überwachungsmetriken fest und bewerten Sie regelmäßig die Leistung und den Geschäftswert des Modells in realen Umgebungen.
Denken Sie daran: Ein exzellenter Machine-Learning-Praktiker ist nicht nur ein Modellarchitekt, sondern auch einIngenieur, der Kosten, Nutzen und Risiken abwägt.。
Andere Erweiterungen