Unüberwachtes Lernen - Dimensionsreduktion
Stellen Sie sich vor, Sie sind ein Fotograf, der eine Bibliothek mit Millionen hochauflösender Fotos organisiert. Jedes Foto besteht aus Millionen von Pixeln (Features). Wenn Sie schnell alle Fotos von Sonnenuntergängen am Meer finden möchten, ist der direkte Vergleich jedes Pixels jedes Fotos nahezu unmöglich, weil die Daten zu groß und zu „fett“ sind.
Im maschinellen Lernen stehen wir oft vor einem ähnlichen Dilemma: Datensätze haben Hunderte oder Tausende von Features (Dimensionen). Dies führt nicht nur zu extrem langsamer Berechnung (der Fluch der Dimensionalität), sondern kann auch, weil viele Features redundant oder irrelevant sind, unsere Fähigkeit beeinträchtigen, die wahren Muster in den Daten zu finden.
Dimensionsreduktion ist eine Kerntechnik des unüberwachten Lernens. Sie wirkt wie ein Fitnesstrainer für Daten und hilft uns, hochdimensionale Daten in einen niedrigdimensionalen Raum zu verschlanken, während die wichtigsten Informationen so weit wie möglich erhalten bleiben. Lernen wir heute die Dimensionsreduktion auf einfache und gründliche Weise.Grundlegende Konzepte der Dimensionsreduktion
Grundlegende Konzepte der Dimensionsreduktion
Was ist Dimensionsreduktion?
Dimensionsreduktion ist der Prozess, die Anzahl der Merkmale in einem Datensatz zu reduzieren.Sie verwendet eine mathematische Transformation, um Datenpunkte aus dem ursprünglichen hochdimensionalen Raum in einen neuen Raum mit niedrigerer Dimensionalität abzubilden.Warum Dimensionsreduktion durchführen?
Warum Dimensionsreduktion?
Visualisierung
- : Menschen können höchstens dreidimensionalen Raum intuitiv verstehen. Indem wir Dimensionen auf 2D oder 3D reduzieren, können wir hochdimensionale Daten darstellen und ihre Struktur, Gruppierungen und Ausreißer intuitiv beobachten.Verbesserte Effizienz
- : Weniger Datendimensionen bedeuten weniger Speicherplatz, schnellere Trainingsgeschwindigkeit und geringere Rechenkosten.Entfernen von Rauschen und Redundanz
- : Viele Algorithmen (insbesondere Algorithmen zur Distanzberechnung wie KNN) leiden in hochdimensionalen Räumen aufgrund irrelevanter oder doppelter Merkmale unter Leistungseinbußen. Dimensionsreduktion kann die Essenz der Daten herausarbeiten.Abschwächung des Fluchs der Dimensionalität
- : In hochdimensionalen Räumen werden Daten extrem dünn besetzt, wodurch es für viele maschinelle Lernmodelle schwierig wird, effektive Muster zu finden.Kernidee: Informationserhaltung
Kernidee: Informationserhaltung
Wie kann man Dimensionen reduzieren und gleichzeitig den Erhalt wertvoller Informationen in den Originaldaten (wie Varianz und Datenstruktur) maximieren?Verschiedene Dimensionsreduktionsalgorithmen haben unterschiedliche Antworten darauf.Detaillierte Erklärung gängiger Dimensionsreduktionsalgorithmen
Detaillierte Erklärung gängiger Dimensionsreduktionsalgorithmen
Lineare DimensionsreduktionNichtlineare DimensionsreduktionundLineare Dimensionsreduktion: Hauptkomponentenanalyse。
Lineare Dimensionsreduktion: Hauptkomponentenanalyse
Wie PCA funktioniert (vier Schritte):Zentrierung
: Subtrahiere den Mittelwert jedes Merkmals, sodass sich das Zentrum der Datenverteilung zum Ursprung des Koordinatensystems verschiebt.
- Berechne die Kovarianzmatrix: Diese Matrix beschreibt die Korrelationen zwischen den verschiedenen Merkmalen der Daten.
- Eigenwertzerlegung: Berechne die Eigenwerte und Eigenvektoren der Kovarianzmatrix.
- Die Eigenvektorengeben die Richtungen der neuen Koordinatenachsen (Hauptkomponenten) an,während die Eigenwertedie Varianz der Daten entlang dieser Richtung darstellen. Je größer der Eigenwert, desto mehr Informationen enthält diese Richtung.Auswahl der Hauptkomponenten: Sortiere die Eigenwerte vom größten zum kleinsten und wähle die obersten
- Eigenvektoren, die den größten Eigenwerten entsprechen, um eine Projektionsmatrix zu bilden.Datentransformation
k: Multipliziere die Originaldaten mit dieser Projektionsmatrix, um Daten zu erhalten, die reduziert sind auf - Dimensionen.Beispiel
k# Notwendige Bibliotheken importieren
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
# macOS zuerst
plt.rcParams['font.sans-serif'] = [
# Linux zuerst
'SimHei', 'Microsoft YaHei',
# Behebe das Problem, dass negative Vorzeichen als Quadrate angezeigt werden
'PingFang SC', 'Heiti TC',
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# 1. Lade den klassischen Iris-Datensatz (4 Merkmale)
plt.rcParams['axes.unicode_minus'] = False
# Originaldaten: 150 Stichproben, 4 Merkmale
# Labels, die zur Einfärbung in der Visualisierung verwendet werden
iris = load_iris()
X = iris.data "Ursprüngliche Datenform: {X.shape}"
y = iris.target # Ausgabe: (150, 4)
print(f# 2. Ein PCA-Modell erstellen, Reduzierung auf 2 Dimensionen angeben) # 3. Das Modell anpassen (Hauptkomponenten berechnen) und die Daten transformieren
"Datenform nach Dimensionsreduktion: {X_pca.shape}"
pca = PCA(n_components=2)
# Ausgabe: (150, 2)
X_pca = pca.fit_transform(X)
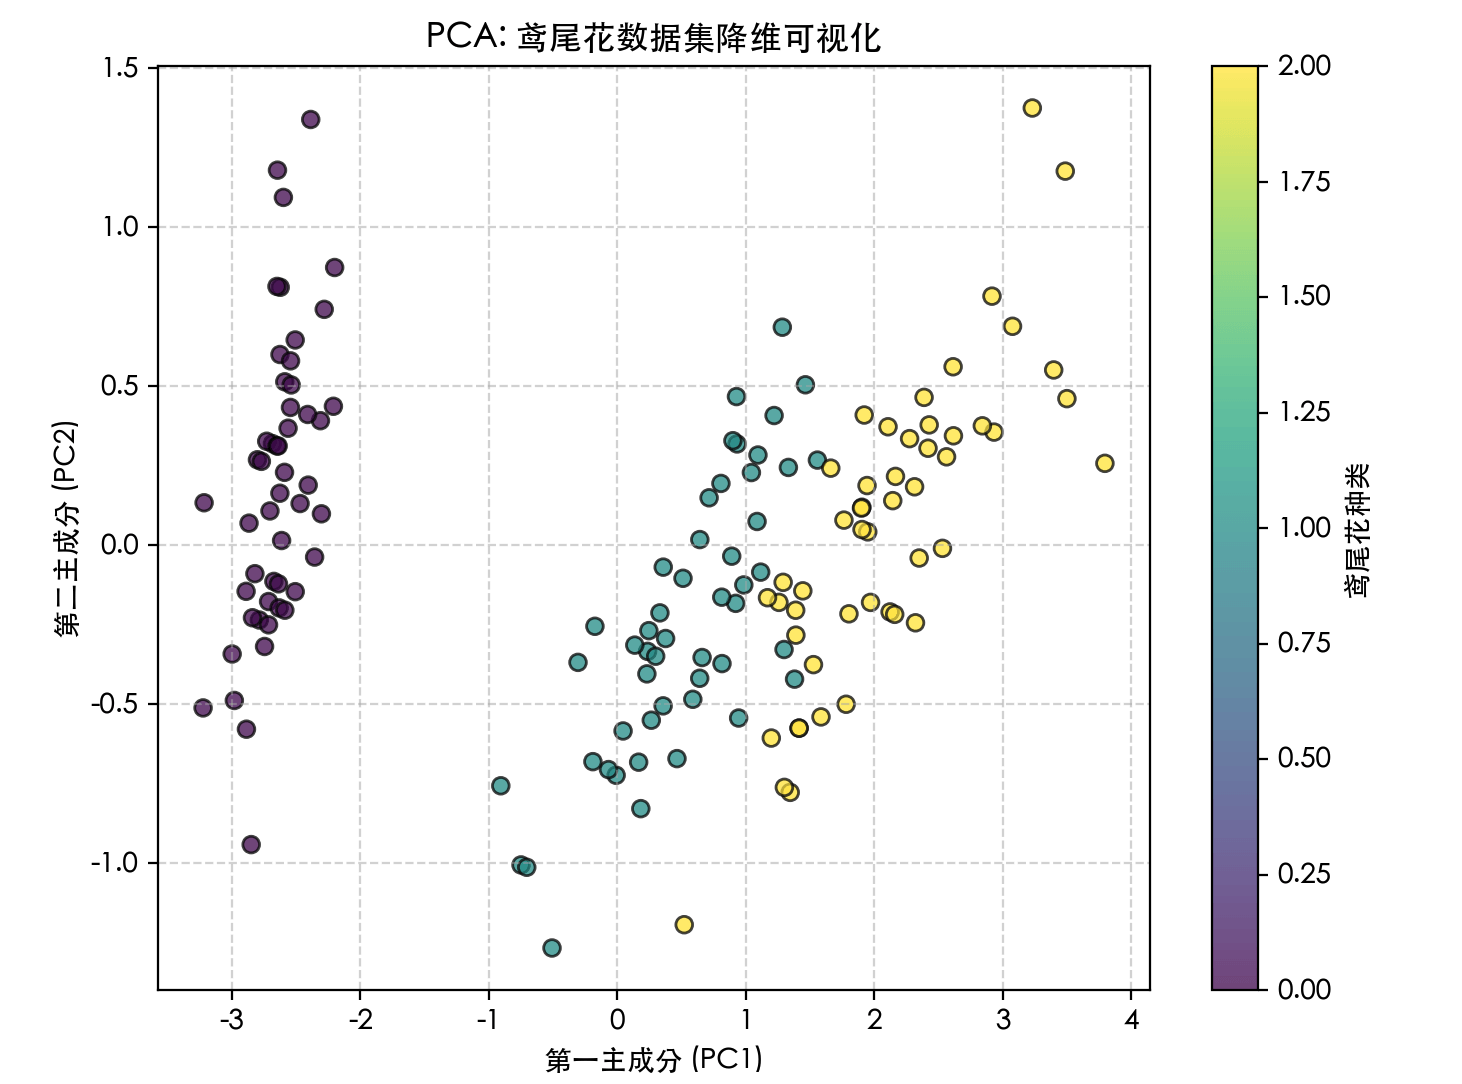
print(f"Erklärter Varianzanteil jeder Hauptkomponente: {pca.explained_variance_ratio_}") # Die Ausgabe könnte ähnlich sein wie: [0.9246, 0.0530], was anzeigt, dass die erste Hauptkomponente 92.5% der Informationen behält und die zweite 5.3%
print(f# 4. Visualisiere das Ergebnis der Dimensionsreduktion)
'Erste Hauptkomponente (PC1)'
'Zweite Hauptkomponente (PC2)'
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, edgecolor='k', alpha=0.7)
plt.xlabel('PCA: Visualisierung der Dimensionsreduktion des Iris-Datensatzes')
plt.ylabel('Iris-Arten')
plt.title(Code-Erklärung)
plt.colorbar(scatter, label=: Initialisiere das Modell,)
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
der Parameter gibt die Anzahl der beizubehaltenden Hauptkomponenten an (d. h. die Dimensionalität nach der Reduktion).:
PCA(n_components=2): Dies ist eine Kombinationsmethode; zuerst berechnet sie den Mittelwert und die Hauptkomponentenrichtungen der Daten (n_components), dann transformiert sie sofort die Daten in den neuen Raum (fit_transform(X): Dies ist ein sehr wichtiges Attribut von PCA; es sagt uns, wie viel Varianz (Information) der ursprünglichen Daten jedes neue Merkmal (Hauptkomponente) beibehält. Das hilft uns zu entscheiden, wie viele Hauptkomponenten sinnvollerweise zu wählen sind.fitVor- und Nachteile von PCAtransform)。explained_variance_ratio_Vorteile
: Recheneffizient, klare Prinzipien und kann lineare Korrelationen effektiv entfernen.
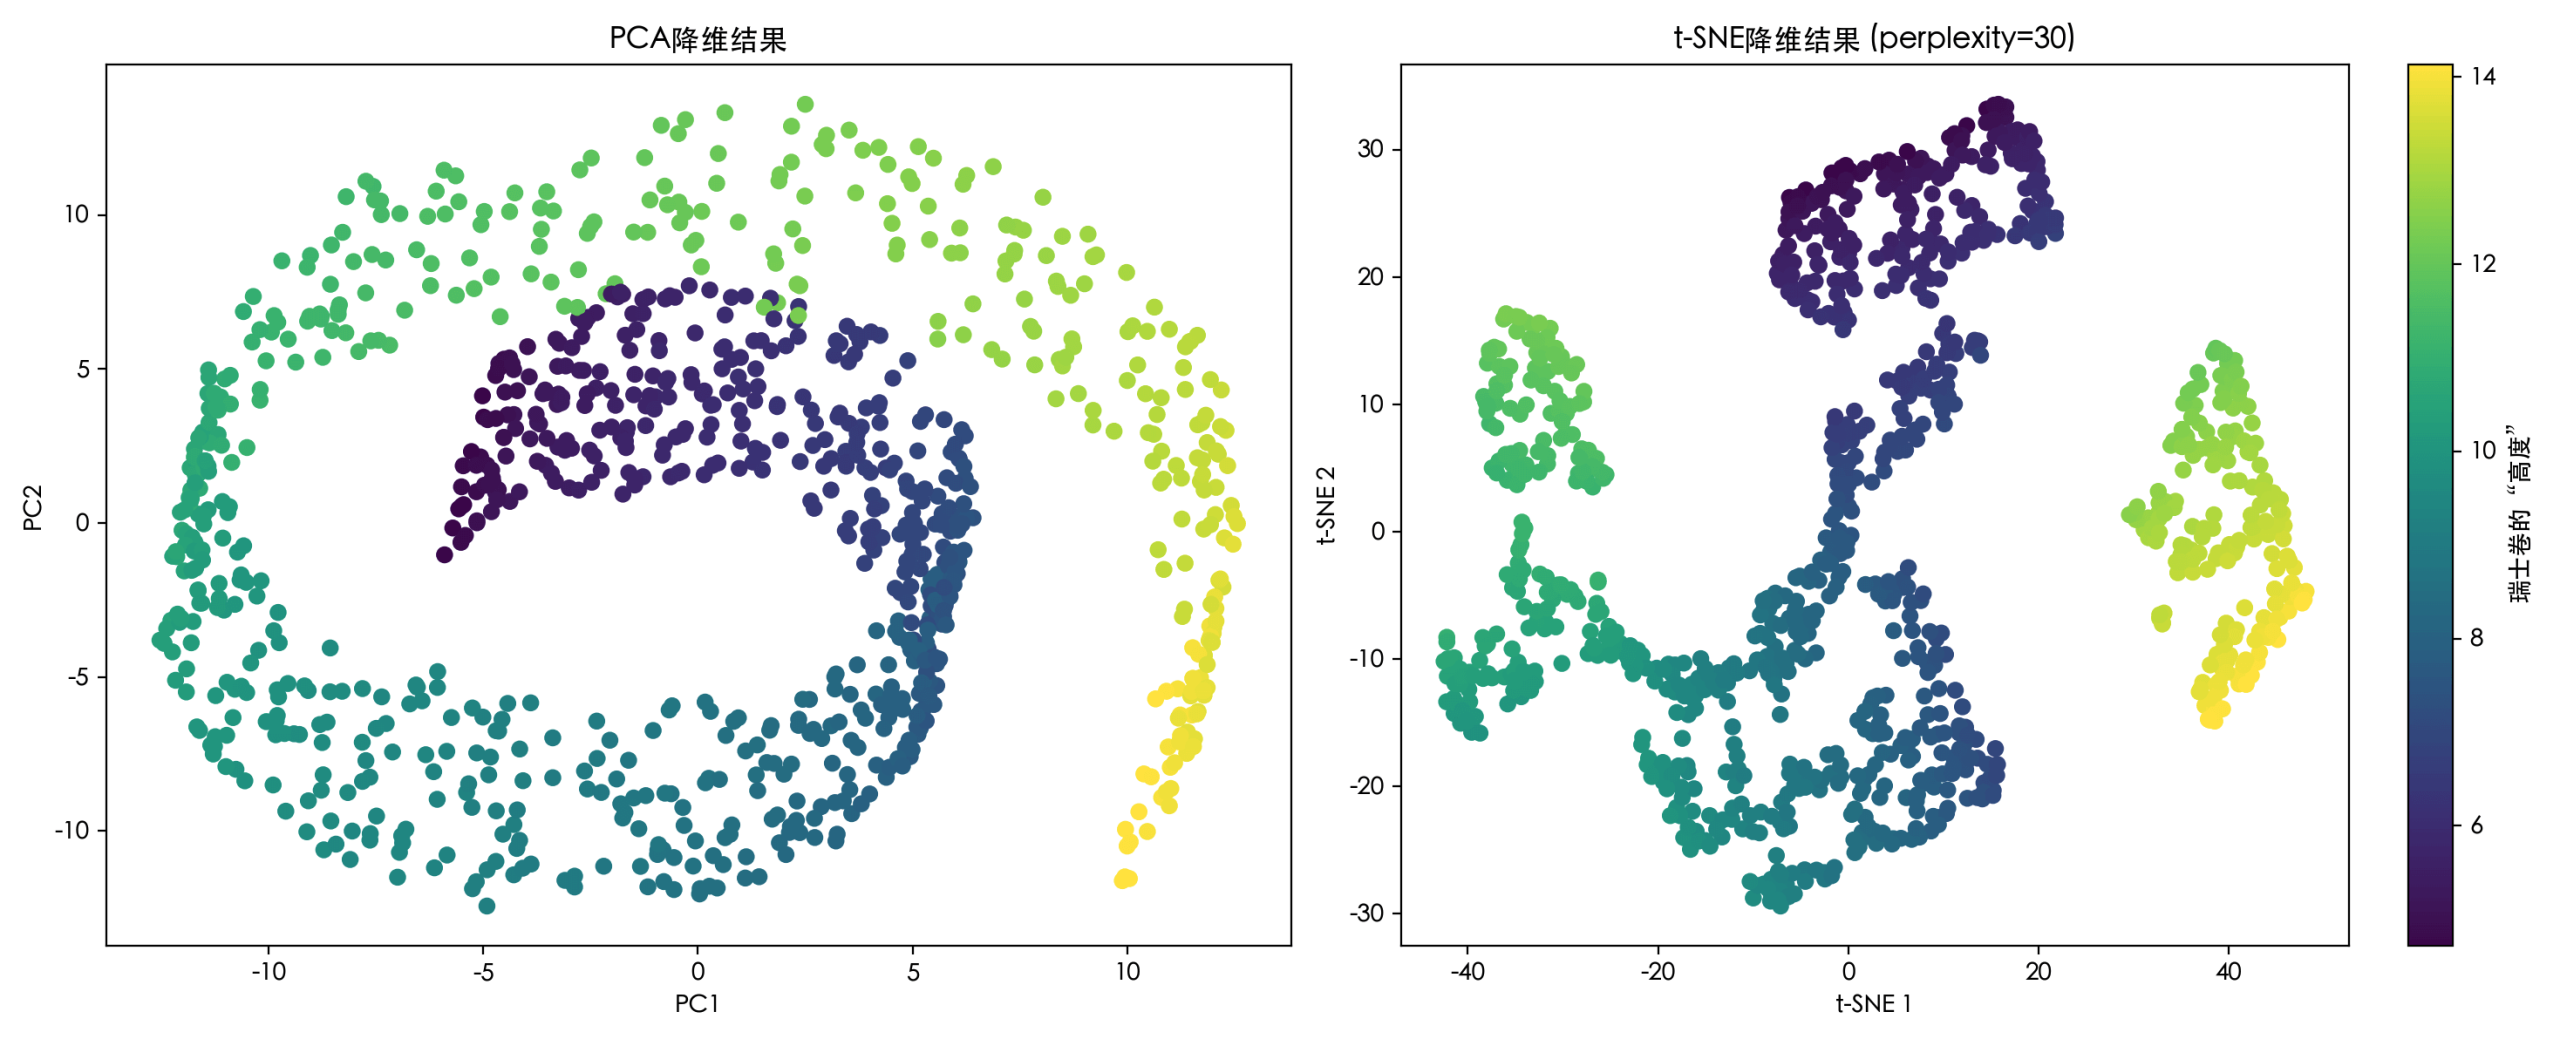
- Nachteile: Es ist eine lineare Methode und geht davon aus, dass die Hauptkomponenten der Daten linear sind. Bei nichtlinearen Mannigfaltigkeitsdaten wie beim "Swiss Roll" funktioniert PCA nicht gut.
- Nichtlineare Dimensionsreduktion: t-SNEWenn Daten komplexe nichtlineare Strukturen aufweisen, benötigen wir nichtlineare Methoden zur Dimensionsreduktion.
Nichtlineare Dimensionsreduktion: t-SNE
Kernidee von t-SNEt-SNE konzentriert sich aufdie Bewahrung der lokalen Struktur der Daten.
Es versucht, Punkte, die im hochdimensionalen Raum "ähnlich" sind (d. h. nahe beieinanderliegen), auch in der niedrigdimensionalen Abbildung "ähnlich" zu machen; während Punkte, die im hochdimensionalen Raum "nicht ähnlich" sind, im niedrigdimensionalen Raum weit auseinanderliegen.
Beispiel# Notwendige Bibliotheken importieren# Swiss-Roll-Daten generieren
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE
from sklearn.datasets import make_swiss_roll # macOS zuerst
# Linux zuerst
plt.rcParams['font.sans-serif'] = [
# Behebe das Problem, dass negative Vorzeichen als Quadrate angezeigt werden
'SimHei', 'Microsoft YaHei',
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
'PingFang SC', 'Heiti TC',
# 1. Einen nichtlinearen Datensatz generieren: Swiss Roll
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
"Form der Swiss-Roll-Daten: {X_swiss.shape}"
plt.rcParams['axes.unicode_minus'] = False
# 2. PCA (lineare Methode) verwenden, um eine Dimensionsreduktion zu versuchen
# 3. t-SNE (nichtlineare Methode) zur Dimensionsreduktion verwenden
X_swiss, color = make_swiss_roll(n_samples=1000, noise=0.1)
print(f# Perplexity ist ein Schlüsselparameter von t-SNE, normalerweise zwischen 5 und 50, was einen ausgewogenen Fokus auf lokale/globale Struktur darstellt) # (1000, 3)
# 4. Visualisierungen vergleichen
pca = PCA(n_components=2)
X_swiss_pca = pca.fit_transform(X_swiss)
# PCA-Ergebnis
'PCA-Ergebnis der Dimensionsreduktion'
tsne = TSNE(n_components=2, perplexity=30, random_state=42)
X_swiss_tsne = tsne.fit_transform(X_swiss)
# t-SNE-Ergebnis
fig, axes = plt.subplots(1, 2, figsize=(15, 6))
't-SNE-Ergebnis der Dimensionsreduktion (perplexity=30)'
axes[0].scatter(X_swiss_pca[:, 0], X_swiss_pca[:, 1], c=color, cmap='viridis')
axes[0].set_title('Swiss roll "Höhe"')
axes[0].set_xlabel('PC1')
axes[0].set_ylabel('PC2')
Wie man Methoden zur Dimensionsreduktion und Schlüsselparameter auswählt
sc = axes[1].scatter(X_swiss_tsne[:, 0], X_swiss_tsne[:, 1], c=color, cmap='viridis')
axes[1].set_title(Flussdiagramm zur Algorithmusauswahl)
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
plt.colorbar(sc, ax=axes[1], label=Leitfaden für Schlüsselparameter)
plt.tight_layout()
plt.show()
Code-Erklärung:
perplexityParameter: Kann als die Anzahl der Nachbarn verstanden werden, die für jeden Punkt berücksichtigt werden. Kleinere Werte konzentrieren sich stärker auf die lokale Struktur, größere Werte stärker auf die globale Struktur. Er ist der wichtigste Parameter, der bei t-SNE abgestimmt werden muss.random_state: Stellt sicher, dass die Ergebnisse reproduzierbar sind, da der t-SNE-Optimierungsprozess stochastisch ist.- Aus den Visualisierungsergebnissen wird deutlich, dass PCA die Swiss Roll "abflacht" und ihre nichtlineare gewundene Struktur verliert; während t-SNE diese Rolle besser auf einer 2D-Ebene entfaltet und die lokalen Nachbarschaftsbeziehungen der Daten bewahrt.
Vor- und Nachteile von t-SNE
Vorteile: Hervorragende Visualisierungswirkung bei komplexen nichtlinearen Daten, Clusterstrukturen werden deutlich sichtbar.
Nachteile:
- Langsame Berechnungsgeschwindigkeit, nicht geeignet für große Datensätze.
- Ergebnisse weisenZufälligkeitauf, jeder Lauf kann leicht unterschiedlich sein.
- Empfindlich gegenüber Hyperparametern,
perplexityErfordert Tuning. - Hauptsächlichfür die Visualisierung verwendet(2D/3D); die Merkmale reduzierter Dimension werden normalerweise nicht für nachfolgende Machine-Learning-Aufgaben verwendet, weil sich die Bedeutung der Abstände im niedrigdimensionalen Raum geändert hat.
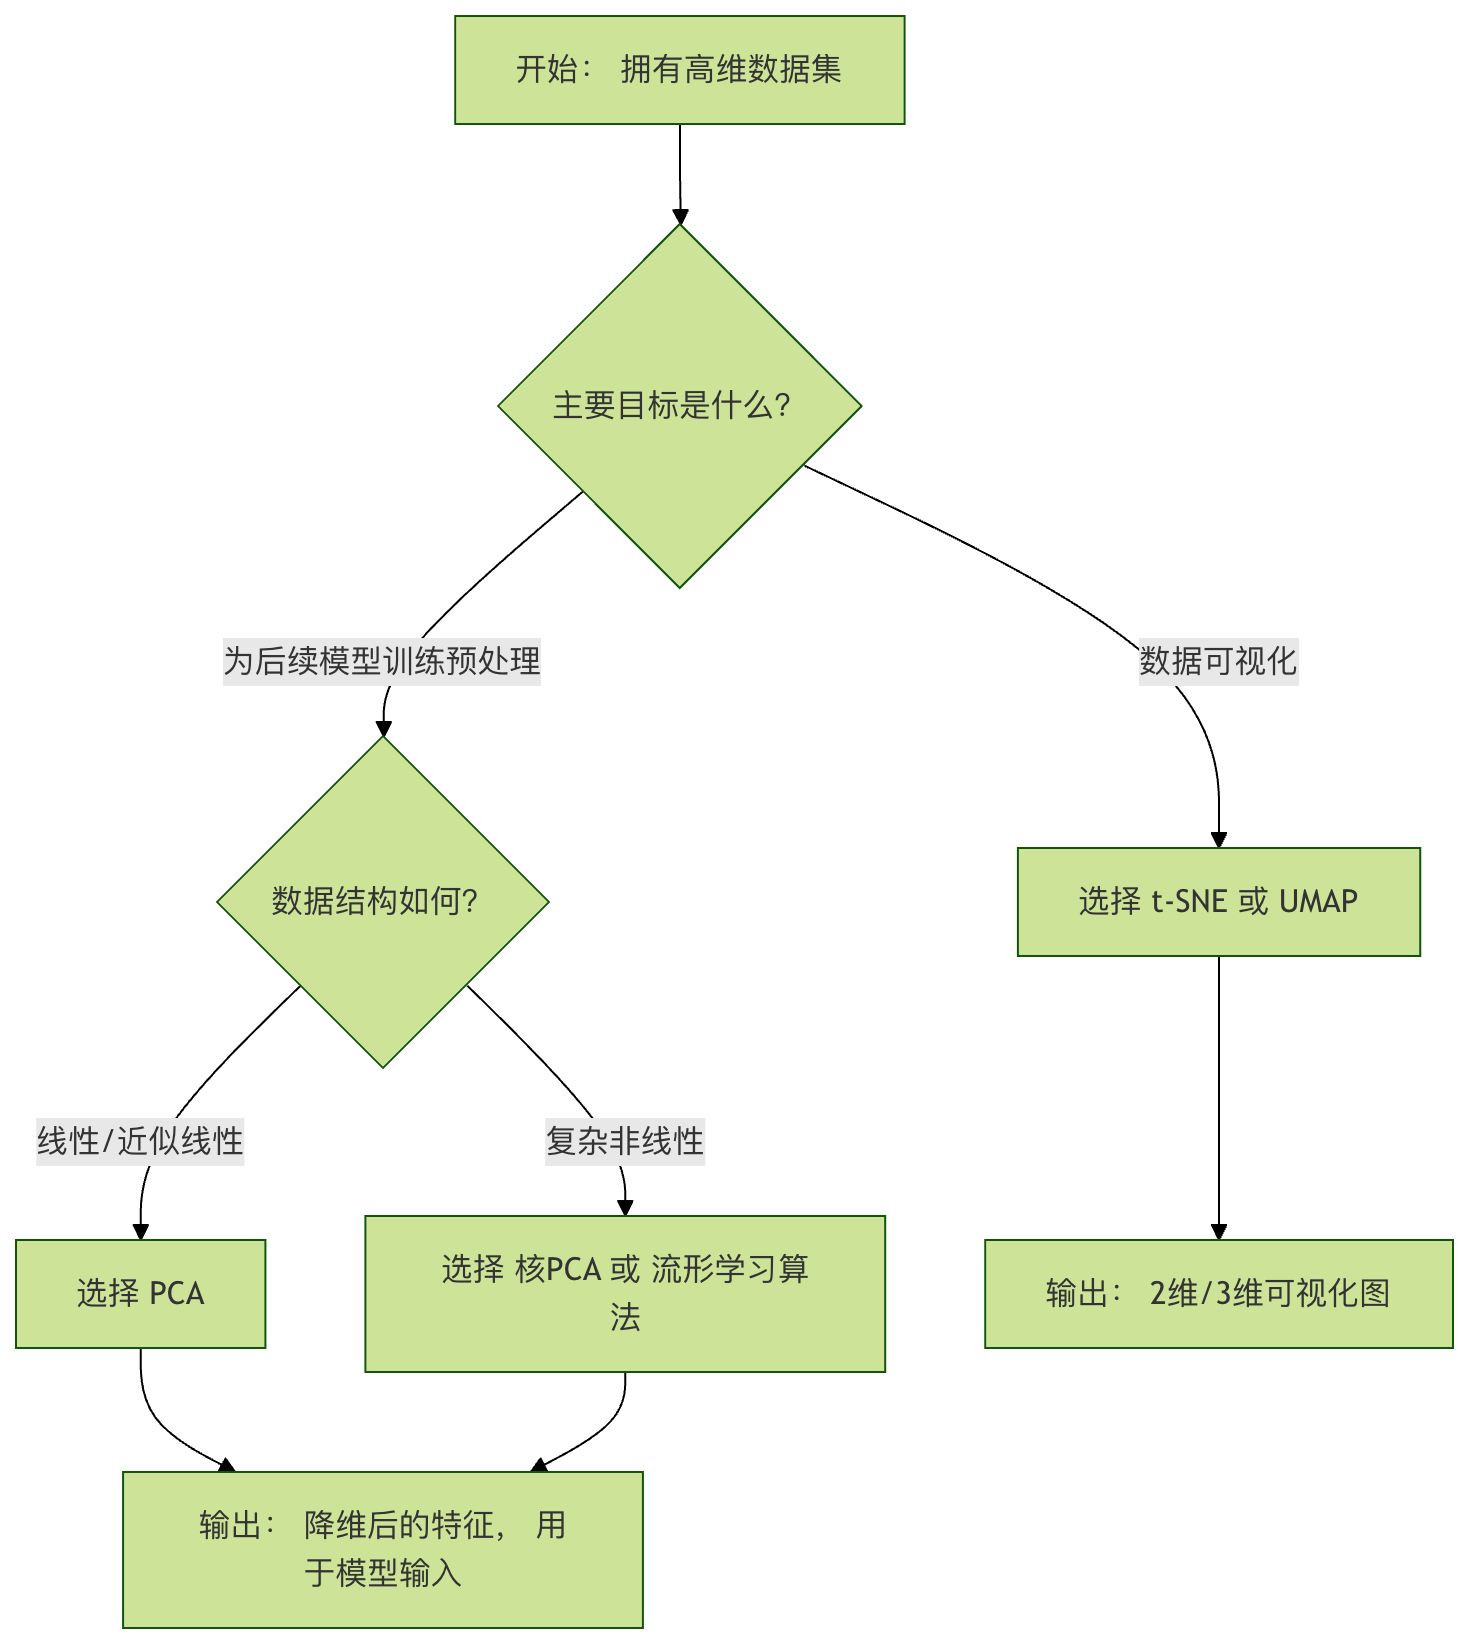
Wie man Methoden zur Dimensionsreduktion und Schlüsselparameter auswählt
Flussdiagramm zur Algorithmusauswahl
Leitfaden für Schlüsselparameter
PCA: n_components
- Kann auf eine ganze Zahl (z. B. 2) gesetzt werden, um eine bestimmte Dimension anzugeben.
- Kann festgelegt werden auf
0 < n < 1eine Dezimalzahl (z. B. 0.95), was bedeutet, dass derkumulative erklärte Varianzanteilder den Schwellenwert mit der minimalen Anzahl von Hauptkomponenten erreicht, beibehalten wird.
Beispiel
pca = PCA(n_components=0.95)
pca.fit(X)
print(f"Um 95% Varianz beizubehalten, werden {pca.n_components_} Hauptkomponenten benötigt")
t-SNE: perplexity
- Typische Werte liegen zwischen 5 und 50.
- Für kleine Datensätze (<100 Stichproben) werden kleinere Werte empfohlen.
- Der optimale Wert liegt normalerweise nahe bei der Anzahl der "Nachbarn" für jeden Punkt in den Daten. Er muss durch Experimentieren und Beobachten der Visualisierungsergebnisse gewählt werden.
Praktische Übungen und Zusammenfassung
Praktische Übung: Anwendung der Dimensionsreduktion auf den MNIST-Datensatz handgeschriebener Ziffern
Beispiel
from sklearn.preprocessing import StandardScaler
# 1. MNIST-Datensatz laden (nur eine Teilmenge der Stichproben nehmen, um es zu beschleunigen)
mnist = fetch_openml('mnist_784', version=1, as_frame=False)
X_mnist, y_mnist = mnist.data[:3000] / 255.0, mnist.target[:3000] # Normalisieren, die ersten 3000 Stichproben nehmen
print(f"Form der MNIST-Daten: {X_mnist.shape}") # (3000, 784) -> 784 Dimensionen!
# 2. Zuerst PCA verwenden, um schnell auf 50 Dimensionen zu reduzieren und dabei viel Rauschen zu entfernen
pca = PCA(n_components=50)
X_mnist_pca = pca.fit_transform(X_mnist)
print(f"Form nach PCA: {X_mnist_pca.shape}")
# 3. Dann t-SNE verwenden, um die 50-dimensionalen Daten zur Visualisierung auf 2 Dimensionen zu reduzieren
tsne = TSNE(n_components=2, perplexity=40, n_iter=300, random_state=42)
X_mnist_tsne = tsne.fit_transform(X_mnist_pca)
# 4. Visualisierung
plt.figure(figsize=(10, 8))
scatter = plt.scatter(X_mnist_tsne[:, 0], X_mnist_tsne[:, 1],
c=y_mnist.astype(int), cmap='tab10', Alpha=0.6, s=5)
plt.colorbar(scatter, ticks=range(10), label='Handgeschriebene Ziffern')
plt.title('t-SNE-Visualisierung des MNIST-Datensatzes handschriftlicher Ziffern nach PCA-Vorverarbeitung')
plt.xlabel('t-SNE 1')
plt.ylabel('t-SNE 2')
plt.grid(True, linestyle='--', alpha=0.3)
plt.show()
Übungsziel: Beobachten Sie, ob verschiedene Ziffern (0-9) klare Cluster auf der 2D-Ebene bilden. Versuchen Sie,perplexityParameter zu ändern (z. B. auf 10 oder 50) und zu sehen, wie sich die Visualisierung verändert.
Zusammenfassung und Kernpunkte
Das Wesen der Dimensionsreduktion: Es ist Informationskompression und -extraktion, nicht einfach das Verwerfen von Daten. Das Ziel ist, mit weniger Dimensionen so viele ursprüngliche Informationen wie möglich auszudrücken.。
PCA (der König der linearen Methoden): Findet die wichtigsten linearen Richtungen der Daten durch Maximierung der Varianz. Effizient und stabil, geeignet für die Vorverarbeitung und zum Entfernen linearer Korrelationen.
t-SNE (ein leistungsstarkes Werkzeug zur Visualisierung): Enthüllt nichtlineare Strukturen, indem es lokale Ähnlichkeiten zwischen Datenpunkten beibehält. Der Effekt ist verblüffend, aber es ist langsam und die Ergebnisse sind zufällig, hauptsächlich für explorative Datenanalyse verwendet.
Workflow:
- Das Ziel klären: Ist es für die Visualisierung oder um verfeinerte Merkmale für nachgelagerte Modelle bereitzustellen?
- Datenexploration: Visualisieren Sie zunächst einen Teil der Daten, um ein vorläufiges Gefühl für deren Linearität/Nichtlinearität zu bekommen.
- Methodenexperimente: Wählen Sie Algorithmen basierend auf dem Ziel und der Datenstruktur und passen Sie die wichtigsten Parameter an.
- Ergebnisse bewerten: Bewerten Sie den Effekt der Dimensionsreduktion durch Visualisierung, Informationserhaltungsrate oder Leistung nachgelagerter Aufgaben.
Dimensionsreduktion ist ein Schlüssel zur Entschlüsselung der Black Box hochdimensionaler Daten.
Wenn Sie PCA und t-SNE beherrschen, können Sie nicht nur einen Überblick über die globale Struktur bei komplexen Daten erhalten, sondern auch optimierte Merkmale für nachfolgende Machine-Learning-Modelle vorbereiten, was die Effizienz und Tiefe der Datenanalyse erheblich verbessert.
Andere Erweiterungen