Hyperparametersuche
In der Praxis des maschinellen Lernens stoßen wir oft auf diese Verwirrung: Warum können die Modelle anderer mit demselben Algorithmus eine Genauigkeit von 95% erreichen, während mein Modell nur 85% erreicht? Neben Unterschieden in Datenqualität und Feature Engineering liegt ein entscheidender Faktor oft inHyperparameter-Einstellungen.
Wenn der Modellalgorithmus der Motor eines Autos ist, dann sind Hyperparameter die Feinabstimmungsregler wie Zündzeitpunkt und Kraftstoffeinspritzmenge. Gut abgestimmt liefert der Motor eine brachiale Leistung; schlecht abgestimmt kann ihm die Leistung fehlen oder er kann starkem Verschleiß unterliegen.
Dieser Artikel führt Sie systematisch in die Hyperparametersuche ein, einen entscheidenden Teil der Modelloptimierung und des Engineerings.
Was sind Hyperparameter?
Bevor wir in die Suchmethoden eintauchen, müssen wir zunächst ein Kernkonzept klären:HyperparameterundModellparameter– den Unterschied zwischen ihnen.
Modellparameter vs. Hyperparameter
| Eigenschaft | Modellparameter | Hyperparameter |
|---|---|---|
| Definition | Die internen Variablen, die das Modelllerntaus den Trainingsdaten. | Bevor das Modelltrainingbeginnt,Konfigurationsvariablen, die manuell vom Entwickler festgelegt oder durch Algorithmen ausgewählt werden. |
| Lernmethode | Automatisch angepasst durch Optimierungsalgorithmen (z. B. Gradientenabstieg). | Nicht aus Trainingsdaten gelernt; erfordert eine externe Einstellung. |
| Beispiel | Gewichte in der linearen Regressionwund Bias-Werteb; Gewichte und Bias-Werte in neuronalen Netzen. |
Lernrate, maximale Tiefe von Entscheidungsbäumen, Anzahl der Bäume in einem Random Forest und K-Wert in KNN. |
| Auswirkung | Bestimmt die Fähigkeit des Modells, spezifische Daten anzupassen. | Bestimmt denLernprozess, die Kapazität und die Struktur des Modells,wodurch die endgültige Leistung beeinflusst wird. |
Eine anschauliche Analogie: Stellen Sie sich vor, Sie lernen, ein neues Gericht zu kochen (Trainieren eines Modells).
- Modellparametersind wie die genauen Mengen von „einer Prise Salz, einem halben Löffel Zucker“, die Sie während des Kochprozesses basierend auf den Zutaten und der Hitze herausfinden. Diese Menge ergibt sich durch Übung (Training).
- Hyperparameterwerden festgelegt, bevor Sie mit dem Kochen beginnen: ob Siescharfes Anbraten bei hoher Hitzeoderlangsames Köcheln bei niedriger Hitze(Lernrate) verwenden? Wie oft insgesamt sollten Sieanbraten(Anzahl der Trainingsepochen)? Diese Entscheidungen beeinflussen Ihren Kochprozess und den endgültigen Geschmack grundlegend.
Beispiele für gängige Hyperparameter
Verschiedene Machine-Learning-Algorithmen haben ihre eigenen Hyperparameter:
Allgemeine Hyperparameter:
learning_rate: Lernrate, steuert die Schrittweite der Aktualisierungen der Modellparameter. Ist sie zu groß, kann sie den optimalen Punkt "überspringen"; ist sie zu klein, ist das Lernen zu langsam.n_estimators: Anzahl der schwachen Lernenden (z. B. Bäume) in Ensemble-Modellen.max_iter/epochs: Maximale Anzahl an Iterationen oder Trainings-Epochen.
Lineare Modelle / neuronale Netze:
alpha/lambda: Stärke des Regularisierungsterms, wird verwendet, um Overfitting zu verhindern.batch_size: Anzahl der Stichproben, die pro Parameteraktualisierung verwendet werden.hidden_layer_sizes: Größe der verborgenen Schicht von neuronalen Netzen.
Baummodelle:
max_depth: Maximale Tiefe des Baums, steuert die Modellkomplexität.min_samples_split: Mindestanzahl an Stichproben, die zum Aufteilen eines internen Knotens erforderlich ist.min_samples_leaf: Mindestanzahl an Stichproben, die an einem Blattknoten erforderlich ist.
Warum wird Hyperparametersuche benötigt?
Da Hyperparameter so wichtig sind, können wir sie dann einfach willkürlich nach Erfahrung oder Intuition festlegen? Die Antwort ist nein. Die Gründe sind wie folgt:
- Große Auswirkung auf die Leistung: Beim selben Modell können unterschiedliche Hyperparameterkombinationen zu stark unterschiedlicher Leistung führen (z. B. Genauigkeit, F1-Score).
- Keine universellen optimalen Werte: Optimale Hyperparameter hängen stark vom jeweiligen Datensatz, der Aufgabe und dem Modell ab; es gibt keinen für alle passenden "magischen Standardparameter".
- Riesiger Kombinationsraum: Mehrere Hyperparameter interagieren miteinander und bilden einen hochdimensionalen Suchraum. Manuelles Ausprobieren ist extrem ineffizient und kann leicht in lokalen Denkmustern stecken bleiben.
Daher benötigen wir systematische, automatisierte Methoden, um diesen riesigen Parameterraum zu erkunden und Konfigurationen mit besserer Leistung zu finden. Dieser Prozess istHyperparametersucheoderHyperparameteroptimierung.。
Ihr Kernziel ist es, innerhalb akzeptabler Rechenkosten eine Menge von Hyperparametern zu finden, die das Modell hinsichtlich der Leistungsmetriken aufungesehenen Daten(Validierungsset) optimal abschneiden lässt.
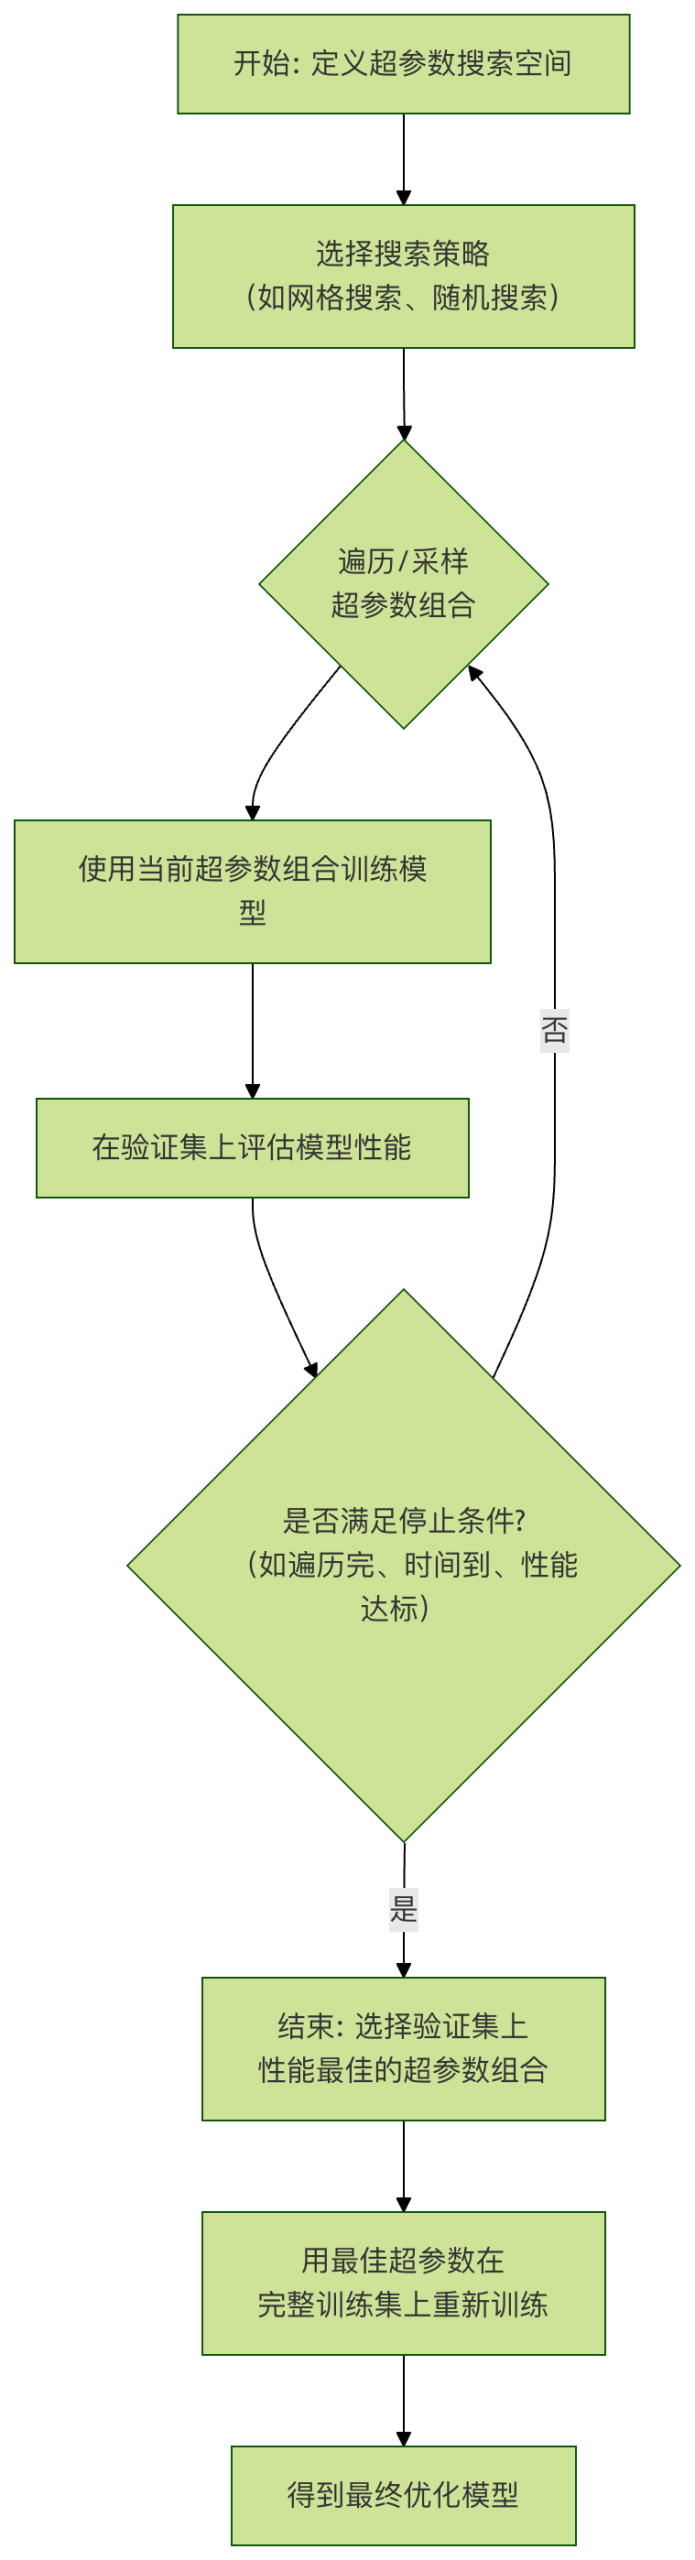
Gängige Strategien zur Hyperparametersuche
1. Gittersuche
Die Gittersuche ist die grundlegendste und intuitivste Suchmethode.
Funktionsweise:
- Definieren Sie eine Liste von Kandidatenwerten für jeden zu suchenden Hyperparameter.
- Der Suchalgorithmus erzeugt daskartesische Produktdieser Listen, d. h. alle möglichen Kombinationen.
- Durchlaufe jede Kombination, trainiere das Modell und evaluiere es.
- Wähle die Kombination mit der besten Leistung auf dem Validierungssatz aus.
Beispiel: Suche zwei Hyperparameter einer Support Vector Machine (SVM).
Beispiel
param_grid = {
'C': [0.1, 1, 10, 100], # Regularisierungsstärke, 4 Kandidatenwerte
'gamma': [0.001, 0.01, 0.1, 1] # Kernel-Koeffizient, 4 Kandidatenwerte
}
# Die Gittersuche wird 4 * 4 = 16 verschiedene Kombinationen ausprobieren
Vorteile:
- Einfach und zuverlässig: Solange das Gitter fein genug ist, ist garantiert, dass die optimale Lösung innerhalb des gegebenen Bereichs gefunden wird.
- Leicht zu parallelisieren: Das Training und die Evaluierung jeder Parameterkombination sind voneinander unabhängig, was es sehr gut für paralleles Rechnen geeignet macht.
Nachteile:
- Fluch der Dimensionalität: Wenn die Anzahl der Hyperparameter leicht zunimmt oder die Kandidatenwerte dichter werden, wächst die Anzahl der Kombinationen exponentiell, wodurch der Rechenaufwand unerträglich wird. Zum Beispiel müsste man bei 5 Parametern mit jeweils 10 Werten 10^5 = 100,000 Modelle trainieren und evaluieren!
- Geringe Effizienz: Es kann viele Rechenressourcen für "unwichtige" Parameter verschwenden.
2. Zufallssuche
Die Zufallssuche ist eine effektive Verbesserung gegenüber den Schwächen der Gittersuche.
Funktionsweise:
- Definieren Sie eineWahrscheinlichkeitsverteilung(z. B. Gleichverteilung, log-uniforme Verteilung) für jeden Hyperparameter.
- Innerhalb der angegebenen Gesamtzahl von Versuchen (
n_iter),Wählen Sie zufälligeine Menge von Hyperparameter-Werten aus. - Trainieren und bewerten Sie jeden abgetasteten Parametersatz.
- Wählen Sie die Kombination mit der besten Leistung aus.
Beispiel: Verwenden Sie die Zufallssuche, um einen Random Forest zu optimieren.
Beispiel
from scipy.stats import randint, uniform
param_dist = {
'n_estimators': randint(100, 500), # Ganzzahlige Gleichverteilung, 100 bis 500
'max_depth': randint(5, 30), # Ganzzahlige Gleichverteilung, 5 bis 30
'min_samples_split': uniform(0.01, 0.2) # Kontinuierliche Gleichverteilung, 0.01 bis 0.21
}
# Führe 50 Versuche zufällig durch
random_search = RandomizedSearchCV(estimator=rf_model,
param_distributions=param_dist,
n_iter=50,
cv=5,
verbose=2)
random_search.fit(X_train, y_train)
Warum ist die Zufallssuche effizienter?Forschung (Bergstra & Bengio, 2012) zeigt, dass die Modellleistung bei den meisten Problemen normalerweise nur auf wenige Hyperparameter empfindlich reagiert. Die Zufallssuche ermöglicht es uns,jede Dimensionöfter zu erkunden, wodurch eine höhere Wahrscheinlichkeit besteht, die beste Region für wichtige Parameter zu finden, statt durch das feste Raster unwichtiger Parameter wie bei der Gittersuche eingeschränkt zu sein.
Vorteile:
- Hohe Recheneffizienz: Bei gleichem Rechenbudget hat sie eine höhere Wahrscheinlichkeit, eine bessere Lösung als die Gittersuche zu finden.
- Flexibel: Sie können für Parameter einfach Wahrscheinlichkeitsverteilungen angeben (z. B. die Suche nach der Lernrate auf einer logarithmischen Skala).
Nachteile:
- Zufälligkeit: Ergebnisse können je nach Zufallsstartwert variieren und bestimmte Regionen verfehlen.
- Kein Gedächtnis: Jeder Versuch ist unabhängig und verwendet keine Informationen aus vorherigen Versuchen, um nachfolgende Suchen zu steuern.
3. Bayes'sche Optimierung
Die Bayes'sche Optimierung ist eine intelligentere Suchmethode, geeignet zur Optimierung von Funktionen mit sehr hohen Auswertungskosten (z. B. kann das Trainieren eines großen Deep-Learning-Modells Tage dauern).
Kernidee:
- Ersatzmodell: Verwenden Sie ein rechengünstiges probabilistisches Modell (z. B. einen Gauß-Prozess), um die reale, rechenintensive Zielfunktion zu "simulieren" (d. h. die Beziehung zwischen Modellleistung und Hyperparametern).
- Akquisitionsfunktion: Wählen Sie basierend auf der Unsicherheit des Ersatzmodells die "vielversprechendste" Hyperparameter-Kombination für die nächste Auswertung aus. Sie balanciertExploration(Stichproben in Regionen mit hoher Unsicherheit) undExploitation(Stichproben in der Nähe von Regionen, die bekanntermaßen gut abschneiden).
Workflow:

Vorteile:
- Äußerst effizient: Kann mit den wenigsten Versuchen eine nahezu optimale Lösung finden, besonders geeignet für teure Modelle.
- Adaptivität: Nutzt historische Informationen, um die Suchrichtung intelligent zu lenken.
Nachteile:
- Komplexe Implementierung: Komplexer als die vorherigen beiden.
- Schwierig zu parallelisieren: Die Standard-Bayes'sche Optimierung ist sequenziell und lässt sich nur schwer direkt parallelisieren (obwohl es verbesserte Methoden gibt).
- Hochdimensionale Räume: Mit steigender Dimensionalität der Hyperparameter wird das Anpassen und Optimieren des Ersatzmodells schwieriger.
Gängige Tools: scikit-optimize, BayesianOptimization, Optuna, Hyperopt。
Engineering-Praktiken und Überlegungen
1. Validierungsstrategie: Verunreinigen Sie Ihren Testsatz nicht!
Bei der Suche nach Hyperparametern,niemalsdas Testset verwenden, um den Suchprozess zu steuern; andernfalls führt dies zu Informationslecks und übermäßig optimistischen Schätzungen der Generalisierungsleistung.
Korrekte Vorgehensweise:
- Teilen Sie die Daten auf in:Trainingsset、Validierungsset、Testset。
- Die Hyperparametersuche wird auf dem "Trainingsset + Validierungsset" durchgeführt (z. B. mittels Kreuzvalidierung).
- Nach Auswahl der besten Hyperparameter verwenden Sie diesen Parametersatz, umdas finale Modell auf dem vollständigen Trainingsset neu zu trainieren(oder dem kombinierten Trainings- + Validierungsset).
- Verwenden Sie schließlich dasTestset, das an keinem Trainings- oder Tuningprozess teilgenommen hat, um die Generalisierungsfähigkeit des finalen Modells fair zu bewerten.
2. Kreuzvalidierung verwenden
Um die Hyperparameterleistung robuster zu bewerten und Zufälligkeiten aufgrund einer einzelnen Datenaufteilung zu vermeiden, sollte eine Kreuzvalidierung verwendet werden.
Beispiel
# 5-fache Kreuzvalidierung für die Grid-Suche verwenden
grid_search = GridSearchCV(estimator=model,
param_grid=param_grid,
cv=5, # 5-fache Kreuzvalidierung
scoring='accuracy',
return_train_score=True)
grid_search.fit(X_train_val, y_train_val) # Hier Trainings- + Validierungsdaten verwenden
print(f"Beste Parameter: {grid_search.best_params_}")
print(f"Bester Kreuzvalidierungs-Score: {grid_search.best_score_:.4f}")
# Bestes Modell abrufen (bereits mit besten Parametern auf allen Daten neu angepasst)
best_model = grid_search.best_estimator_
3. Design-Tipps für den Hyperparameterraum
- Skalenempfindliche Parameter: Bei Parametern wie Lernrate und Regularisierungsstärke erstreckt sich ihreffektiver Bereich oft über mehrere Größenordnungen. Sie sollten auf einer logarithmischen Skala durchsucht werden (z. B.,
[0.001, 0.01, 0.1, 1]), nicht auf einer linearen Skala (z. B.,[0.1, 0.2, ..., 1.0])。 - Grob-zu-fein: Sie können zunächst eine groß angelegte Zufallssuche oder eine dünn besetzte Gittersuche durchführen, um Regionen mit besserer Leistung zu lokalisieren, und dann in diesen Regionen eine feinere Suche durchführen.
- Vorwissen nutzen: Legen Sie sinnvolle anfängliche Bereiche und Verteilungen basierend auf Algorithmusprinzipien und empirischer Literatur fest.
4. Automatisierung und Toolchains
In der realen Praxis wird die Hyperparametersuche oft in die MLOps-Pipeline integriert.
- Frameworks:
Scikit-learnbietenGridSearchCVundRandomizedSearchCV。 - fortgeschrittene Bibliotheken:
Optuna,Ray Tune,Keras Tunerusw. bieten leistungsfähigere, verteilungsfreundliche Suchfunktionen und unterstützen erweiterte Funktionen wie Early Stopping und Pruning. - Cloud-Dienste: Plattformen wie AWS SageMaker und Google Vertex AI bieten verwaltete Dienste zur Hyperparameter-Optimierung.
Praktische Übung
Jetzt verwenden wirScikit-learnundRandom Forestden Datensatz, um eine vollständige Übung zur Hyperparametersuche durchzuführen.
Aufgabe: Verwenden Sie den Wine-Datensatz, um einen Random-Forest-Klassifikator mittels Zufallssuche zu optimieren.
Beispiel
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, RandomizedSearchCV
from sklearn.metrics import classification_report
from scipy.stats import randint
# 2. Daten laden und aufteilen
data = load_wine()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train_val, X_val, y_train_val, y_val = train_test_split(X_train, y_train, test_size=0.25, random_state=42) # 0.25 * 0.8 = 0.2
# 3. Modell und Parameterverteilungen definieren
rf = RandomForestClassifier(random_state=42)
param_dist = {
'n_estimators': randint(50, 300), # Anzahl der Bäume
'max_depth': randint(3, 20), # Maximale Tiefe der Bäume
'min_samples_split': randint(2, 10), # Mindestanzahl an Samples, die zum Aufteilen eines internen Knotens erforderlich ist
'min_samples_leaf': randint(1, 5), # Mindestanzahl an Samples in einem Blattknoten
'max_features': ['sqrt', 'log2'] # Anzahl der Merkmale, die bei der Suche nach dem besten Split berücksichtigt werden
}
# 4. Zufallssuche durchführen (mit 3-facher Kreuzvalidierung)
random_search = RandomizedSearchCV(estimator=rf,
param_distributions=param_dist,
n_iter=30, # Zufällig 30 Parameterkombinationen ausprobieren
cv=3, # 3-fache Kreuzvalidierung
scoring='accuracy',
random_state=42,
verbose=1,
n_jobs=-1) # Alle CPU-Kerne für Parallelisierung verwenden
random_search.fit(X_train_val, y_train_val)
# 5. Suchergebnisse ausgeben
print("="*50)
print("Beste Parameter aus der Zufallssuche:")
print(random_search.best_params_)
print(f"\n"Beste Kreuzvalidierungsgenauigkeit: {random_search.best_score_:.4f}")
# 6. Das beste Modell auf dem unabhängigen Validierungssatz bewerten
best_model = random_search.best_estimator_
y_val_pred = best_model.predict(X_val)
print("\nLeistungsbericht für das Validierungsset:)
print(classification_report(y_val, y_val_pred, target_names=data.target_names))
# 7. (Letzter Schritt) Mit den besten Parametern auf dem gesamten Trainingsset erneut trainieren und auf dem Testset evaluieren
final_model = RandomForestClassifier(**random_search.best_params_, random_state=42)
final_model.fit(X_train, y_train) # Alle Trainingsdaten verwenden
y_test_pred = final_model.predict(X_test)
print("="*50)
print("Leistungsbericht des finalen Modells auf dem Testset (vollständig neue Daten):")
print(classification_report(y_test, y_test_pred, target_names=data.target_names))
Ausgabe:
Fitting 3 folds for each of 30 candidates, totalling 90 fits
==================================================
随机搜索最佳参数:
{'max_depth': 9, 'max_features': 'log2', 'min_samples_leaf': 1, 'min_samples_split': 8, 'n_estimators': 156}

最佳交叉验证准确率:0.9812

在验证集上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        11
     class_1       1.00      0.94      0.97        16
     class_2       0.90      1.00      0.95         9

    accuracy                           0.97        36
   macro avg       0.97      0.98      0.97        36
weighted avg       0.98      0.97      0.97        36

==================================================
最终模型在测试集(全新数据)上的性能报告:
              precision    recall  f1-score   support

     class_0       1.00      1.00      1.00        14
     class_1       1.00      1.00      1.00        14
     class_2       1.00      1.00      1.00         8

    accuracy                           1.00        36
   macro avg       1.00      1.00      1.00        36
weighted avg       1.00      1.00      1.00        36
Weitere Erweiterungen