Grundlegende Terminologie des maschinellen Lernens
Das Erlernen des maschinellen Lernens ist wie das Erlernen einer neuen Sprache; man muss zuerst den grundlegenden Wortschatz beherrschen. Diese Begriffe bilden das "Sprachsystem" des maschinellen Lernens, und sie zu verstehen ist der erste Schritt zu tieferem Lernen.
Stellen Sie sich vor, Sie bringen einem Roboter bei, Früchte zu erkennen:
- Daten: Bilder und Informationen verschiedener Früchte
- Merkmal: Die Farbe, Form, Größe und der Geschmack der Frucht
- Label: Der Name dieser Frucht (Apfel, Banane, Orange)
- Modell: Die vom Roboter gelernte "Methode zum Erkennen von Früchten"
- Training: Der Prozess, dem Roboter beizubringen, Früchte zu erkennen
- Inferenz: Die Fähigkeit des Roboters, neue Früchte zu erkennen
Daten
Was sind Daten?
Datensind der "Rohstoff" des maschinellen Lernens, so wie Zutaten, die ein Koch zum Kochen braucht. Ohne Daten kann maschinelles Lernen nicht stattfinden.
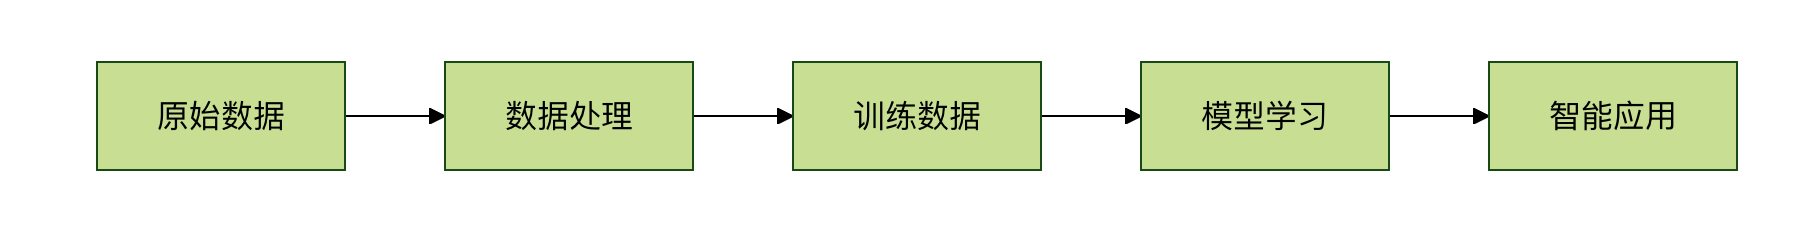
Arten von Daten
1. Strukturierte Daten
Merkmale: Hat ein klares Format und eine klare Organisation, ordentlich wie eine Tabelle
# Beispiel für strukturierte Daten: StudenteninformationstabelleBeispiel
students_data = {
'Name': ['Zhang San', 'Li Si', 'Wang Wu'],
'Age': [18, 19, 20],
'Score': [85, 92, 78],
'Class': ['Class 1', 'Class 2', 'Class 1']
}
df = pd.DataFrame(students_data)
print(df)
Ausgabe:
   姓名  年龄  成绩  班级
0  张三  18  85  一班
1  李四  19  92  二班
2  王五  20  78  一班
2. Unstrukturierte Daten
Merkmale: Hat kein festes Format und erfordert eine spezielle Verarbeitung
Beispiele:
- Text: Kommentare, Artikel, E-Mails
- Bilder: Fotos, medizinische Bilder
- Audio: Sprache, Musik
- Video: Überwachungsaufnahmen, Filme
# 非结构化数据示例:文本和图像
text_data = "这个产品质量很好,我很满意!"
# image_data = 一张产品的照片
# audio_data = 顾客的语音评价
Bedeutung der Datenqualität
Garbage in, garbage outGarbage In, Garbage Out) ist ein wichtiges Prinzip des maschinellen Lernens. Datenqualität bestimmt direkt die Modellleistung.
Beispiel
import numpy as np
import pandas as pd
# Daten mit verschiedenen Problemen erstellen
problematic_data = {
'Price': [100, 200, None, 300, -50], # Fehlende Werte und Ausreißer
'Rating': [4.5, 'Good', 3.8, 4.2, 5.0], # Inkonsistente Datentypen
'Sales'⟦⟧'Many': [1000, 1200, 800, 1500, 'Many'] # Mischung aus Text und Zahlen
}
df = pd.DataFrame(problematic_data)
print("Problematische Daten:")
print(df)
print("\nAnalyse der Datenprobleme: ")
print(f"Anzahl fehlender Werte: {df.isnull().sum().sum()}")
print(f"Datentypen:\n{df.dtypes}")
Merkmal
Was ist ein Merkmal?
Ein Merkmalist ein "beobachtbares Attribut" von Daten, ähnlich wie die Beschreibung der Eigenschaften einer Person: Größe, Gewicht, Haarfarbe, Persönlichkeit usw. Beim maschinellen Lernen sind Merkmale die Grundlage für Vorhersagen.
Bedeutung der Merkmalsauswahl:
- Gute Merkmale können das Modell mit halbem Aufwand doppelt so effektiv machen
- Schlechte Merkmale können das Modell mit doppeltem Aufwand halb so effektiv machen
- Feature-Engineering ist oft der Schlüssel zur Bestimmung der Modellleistung
Arten von Merkmalen
1. Numerische Merkmale
Eigenschaften: Können durch Zahlen dargestellt werden und mathematische Operationen durchlaufen
# 数值特征示例
numerical_features = {
    '年龄': [25, 30, 35, 40],
    '收入': [5000, 8000, 12000, 15000],
    '身高': [165, 170, 175, 180]
}
2. Kategorische Merkmale
Eigenschaften: Repräsentieren verschiedene Kategorien und können keine mathematischen Operationen durchlaufen
# 类别特征示例
categorical_features = {
    '性别': ['男', '女', '男', '女'],
    '学历': ['本科', '硕士', '博士', '本科'],
    '城市': ['北京', '上海', '广州', '深圳']
}
3. Textmerkmale
Eigenschaften: Erfordert eine spezielle Verarbeitung, bevor es vom Modell verwendet werden kann
# 文本特征示例
text_features = {
    '评论': [
        '这个产品很好用,推荐购买!',
        '质量一般,不太满意。',
        '性价比高,值得入手。'
    ]
}
Beispiel für Feature Engineering
Beispiel
import pandas as pd
import numpy as np
# Rohdaten: Hausinformationen
house_data = {
'Area': [80, 120, 60, 150, 90],
'Number of Bedrooms': [2, 3, 1, 4, 2],
'Year Built': [2000, 2010, 1995, 2015, 2005],
'Price': [200, 350, 150, 500, 280]
}
df = pd.DataFrame(house_data)
# Neue Merkmale erstellen
df['House Age'] = 2023 - df['Year Built'] # Hausalter
df['Price per Square Meter'] = df['Price'] / df['Area'] # Preis pro Einheit
df['Bedroom Area Ratio'] = df['Number of Bedrooms'] / df['Area'] * 100 # Schlafzimmer-Verhältnis
print("Rohdaten + neue Merkmale:")
print(df)
# Analyse der Merkmalswichtigkeit
correlation = df.corr()['Price'].sort_values(ascending=False)
print("\nKorrelation zwischen Merkmalen und Preis: ")
print(correlation)
Label
Was ist ein Label?
Labelist die "Antwort", die wir vorhersagen wollen, genau wie die richtige Antwort auf eine Prüfungsfrage. Beim überwachten Lernen hat jede Datenprobe ein entsprechendes Label.
Rolle der Labels:
- Die Lernrichtung des Modells vorgeben
- Die Lerneffektivität des Modells bewerten
- Den Problemtyp definieren
Arten von Labels
1. Klassifikations-Labels
Merkmale: Diskrete kategorische Werte
# 分类标签示例
classification_labels = {
    '邮件类型': ['垃圾邮件', '正常邮件', '垃圾邮件', '正常邮件'],
    '情感倾向': ['正面', '负面', '中性', '正面'],
    '疾病诊断': ['患病', '健康', '健康', '患病']
}
2. Regressions-Labels
Merkmale: Kontinuierliche numerische Werte
# 回归标签示例
regression_labels = {
    '房价': [250000, 320000, 180000, 450000],
    '温度': [25.5, 28.3, 22.1, 30.0],
    '股票价格': [100.5, 105.2, 98.7, 110.3]
}
Bedeutung der Label-Qualität
# 标签质量问题示例
import numpy as np
# 模拟图像分类任务中的标签问题
image_data = ['cat1.jpg', 'dog1.jpg', 'cat2.jpg', 'dog2.jpg']
problematic_labels = ['猫', '犬', '猫咪', '狗']  # 标签不一致
# 标签标准化
label_mapping = {
    '猫': 'cat', '猫咪': 'cat',
    '犬': 'dog', '狗': 'dog'
}
standardized_labels = [label_mapping[label] for label in problematic_labels]
print("原始标签:", problematic_labels)
print("标准化标签:", standardized_labels)
Modell
Was ist ein Modell?
Modellist das "Muster" oder die "Regel", die ein Algorithmus für maschinelles Lernen aus Daten lernt, genau wie das Wissen, das Schüler aus Lehrbüchern lernen.
Wesen eines Modells:
- Mathematische Funktion: Eingabemerkmale, Ausgabevorhersagen
- Menge von Parametern: konkrete Darstellung der erlernten Regeln
- Entscheidungsregeln: wie man aus Eingaben Ausgaben erhält
Darstellung eines Modells
Beispiel
import numpy as np
import matplotlib.pyplot as plt
# Simulierte Daten
X = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 6, 8, 10])
# Lineares Modell: y = w * x + b
# Gelernte Parameter: w = 2, b = 0
w, b = 2, 0
def linear_model(x):
"""Lineare Modellfunktion"""
return w * x + b
# Vorhersage
predictions = linear_model(X)
# Visualisierung
plt.scatter(X, y, color='blue', label='Wahre Daten')
plt.plot(X, predictions, color='red', label='Modellvorhersagen')
plt.xlabel('Eingabe X')
plt.ylabel('Ausgabe y')
plt.title('Beispiel für ein lineares Modell')
plt.legend()
plt.grid(True)
plt.show()
print(f"Modellparameter: w = {w}, b = {b}")
print(f"Vorhersageergebnisse: {predictions}")
Modellkomplexität
Beispiel
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
import numpy as np
# Nichtlineare Daten generieren
np.random.seed(42)
X = np.random.rand(20, 1) * 10
y = np.sin(X) + np.random.randn(20, 1) * 0.1
# Einfaches Modell (linear)
simple_model = LinearRegression()
simple_model.fit(X, y)
# Komplexes Modell (Polynom hohen Grades)
poly_features = PolynomialFeatures(degree=10)
X_poly = poly_features.fit_transform(X)
complex_model = LinearRegression()
complex_model.fit(X_poly, y)
# Visualisierung
X_test = np.linspace(0, 10, 100).reshape(-1, 1)
X_test_poly = poly_features.transform(X_test)
plt.scatter(X, y, color='blue', label='Trainingsdaten')
plt.plot(X_test, simple_model.predict(X_test), color='green', label='Einfaches Modell')
plt.plot(X_test, complex_model.predict(X_test_poly), color='red', label='Komplexes Modell')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Vergleich der Modellkomplexität')
plt.legend()
plt.grid(True)
plt.show()
Training
Was ist Training?
Trainingist der Prozess, durch den ein Modell lernt, ähnlich wie Schüler in der Schule Wissen lernen. Während des Trainings passt das Modell kontinuierlich seine Parameter an, sodass Vorhersagen den wahren Labels immer näher kommen.
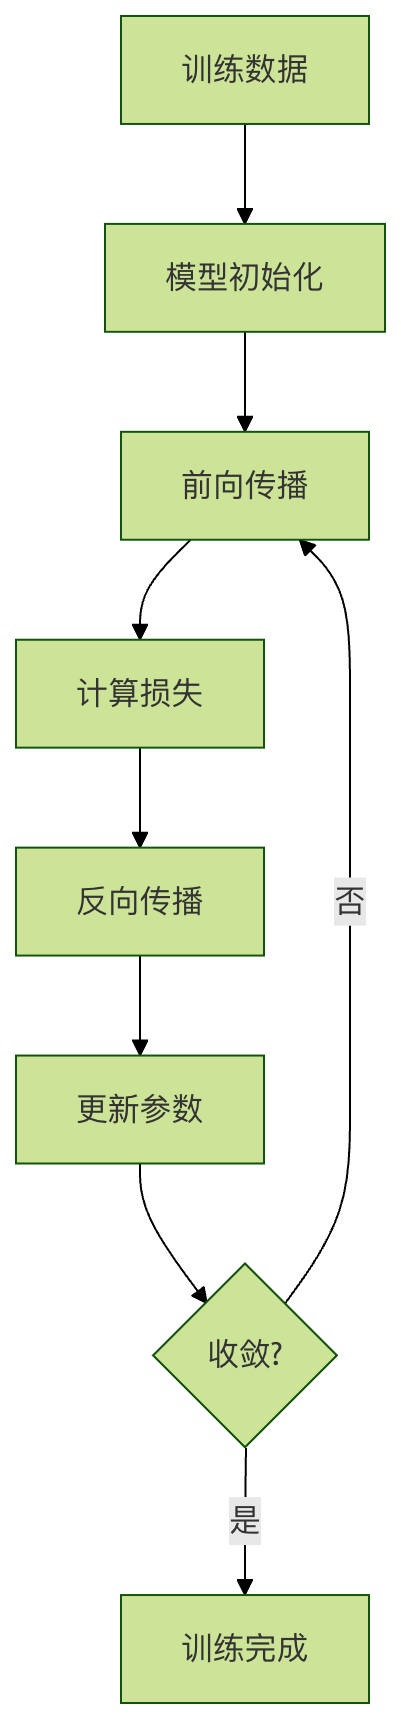
Beispiel für einen Trainingsprozess
Beispiel
import numpy as np
import matplotlib.pyplot as plt
# Trainingsdaten generieren
np.random.seed(42)
X = np.random.rand(50, 1) * 10
y = 3 * X + 2 + np.random.randn(50, 1) * 2
# Modellparameter initialisieren
w, b = 0.0, 0.0
learning_rate = 0.01
epochs = 100
# Trainingsprozess aufzeichnen
loss_history = []
# Trainingsschleife
for epoch in range(epochs):
# Vorwärtspropagierung
y_pred = w * X + b
# Verlust berechnen (mittlerer quadratischer Fehler)
loss = np.mean((y_pred - y) ** 2)
loss_history.append(loss)
# Gradienten berechnen
dw = np.mean(2 * X * (y_pred - y))
db = np.mean(2 * (y_pred - y))
# Parameter aktualisieren
w -= learning_rate * dw
b -= learning_rate * db
if epoch % 10 == 0:
print(f"Epoche {epoch}: Verlust = {loss:.4f}, w = {w:.4f}, b = {b:.4f}")
# Trainingsprozess visualisieren
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(loss_history)
plt.xlabel('Epoche')
plt.ylabel('Verlust')
plt.title('Änderung des Trainingsverlusts')
plt.grid(True)
plt.subplot(1, 2, 2)
plt.scatter(X, y, color='blue', label='Trainingsdaten')
plt.plot(X, w * X + b, color='red', label='Trainiertes Modell')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Trainingsergebnisse')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
print(f"Finale Modellparameter: w = {w:.4f}, b = {b:.4f}")
Inferenz
Was ist Inferenz?
InferenzInferenz ist der Prozess, mithilfe eines trainierten Modells Vorhersagen zu treffen, so wie Studierende erlerntes Wissen nutzen, um Prüfungsfragen zu beantworten.
Beispiel für den Inferenzprozess
Beispiel
import numpy as np
# Angenommen, wir haben bereits ein Hauspreisvorhersagemodell trainiert
class HousePriceModel:
def __init__(self):
# Simuliere trainierte Parameter
self.feature_weights = {
'Area': 2.5,
'Bedrooms': 10.0,
'House age': -1.0,
'Location score': 50.0
}
self.bias = 50.0
def predict(self, features):
"""
Verwende das trainierte Modell zur Vorhersage von Hauspreisen
"""
price = self.bias
for feature_name, feature_value in features.items():
if feature_name in self.feature_weights:
price += self.feature_weights[feature_name] * feature_value
return price
# Das trainierte Modell erstellen
model = HousePriceModel()
# Inferenz: Neuen Hauspreis vorhersagen
new_houses = [
{'Area': 80, 'Bedrooms': 2, 'House age': 5, 'Location score': 8},
{'Area': 120, 'Bedrooms': 3, 'House age': 2, 'Location score': 9},
{'Area': 60, 'Bedrooms': 1, 'House age': 10, 'Location score': 6}
]
print(Hauspreis-Vorhersageergebnisse:)
for i, house in enumerate(new_houses, 1):
predicted_price = model.predict(house)
print(f"Haus {i}: vorhergesagter Preis {predicted_price:.2f} zehntausend Yuan")
# Batch-Inferenz
def batch_predict(model, house_list):
"""Batch-Vorhersage"""
return [model.predict(house) for house in house_list]
batch_prices = batch_predict(model, new_houses)
print(f"\nBatch-Vorhersage-Ergebnisse: {batch_prices}")
Vollständiges Beispiel: Von Daten zur Inferenz
Beispiel
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# 1. Datenvorbereitung
np.random.seed(42)
n_samples = 200
# Feature-Daten generieren
area = np.random.normal(100, 30, n_samples) # Fläche
bedrooms = np.random.randint(1, 5, n_samples) # Schlafzimmer
age = np.random.randint(0, 20, n_samples) # Hausalter
location_score = np.random.randint(1, 10, n_samples) # Lagebewertung
# Labels (Hauspreise) generieren - Linearkombination von Features plus Rauschen
price = (area * 2.5 + bedrooms * 20 + age * -2 + location_score * 15 +
np.random.normal(0, 50, n_samples))
# DataFrame erstellen
data = pd.DataFrame({
'Area': area,
'Bedrooms': bedrooms,
'House age': age,
'Location score': location_score,
'Price': price
})
print(Datenbeispiel:)
print(data.head())
# 2. In Trainingsset und Testset aufteilen
features = ['Area', 'Bedrooms', 'House age', 'Location score']
X = data[features]
y = data['Price']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print(f"\nGröße des Trainingssets: {X_train.shape)
print(f"Größe des Testsets: {X_test.shape)
# 3. Das Modell trainieren
model = LinearRegression()
model.fit(X_train, y_train)
print(f"\nModellparameter:")
for feature, coef in zip(features, model.coef_):
print(f"{feature}: {coef:.2f}")
print(f"Achsenabschnitt: {model.intercept_:.2f}")
# 4. Modell bewerten
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_mse = mean_squared_error(y_train, y_train_pred)
test_mse = mean_squared_error(y_test, y_test_pred)
train_r2 = r2_score(y_train, y_train_pred)
test_r2 = r2_score(y_test, y_test_pred)
print(f"\nModellbewertung:")
print(f"Trainingsset-MSE: {train_mse:.2f}, R²: {train_r2:.2f}")
print(f"Testset-MSE: {test_mse:.2f}, R²: {test_r2:.2f}")
# 5. Inferenz (neue Daten vorhersagen)
new_houses = pd.DataFrame({
'Area': [85, 120, 65],
'Bedrooms': [2, 3, 1],
'House age': [3, 1, 8],
'Location score': [7, 9, 5]
})
predictions = model.predict(new_houses)
print(f"\nPreisvorhersage für neues Haus:")
for i, price in enumerate(predictions, 1):
print(f"Haus {i}: {price:.2f} zehntausend Yuan")
Häufige Typen von Machine-Learning-Netzen
| Modelltyp | Vollständiger chinesischer Name | Englische Abkürzung | Kernanwendungsszenarien | Vorteile | Nachteile |
|---|---|---|---|---|---|
| Traditionelles maschinelles Lernen | Entscheidungsbaum | DT | Klassifikation, Regression, Analyse der Feature-Wichtigkeit | Hohe Interpretierbarkeit, keine Normalisierung der Daten erforderlich | Anfällig für Overfitting, empfindlich gegenüber Rauschen |
| Random Forest | RF | Klassifikation, Regression, Anomalieerkennung | Widerstandsfähig gegen Overfitting, hohe Stabilität | Hoher Rechenaufwand bei hochdimensionalen Daten | |
| Logistische Regression | LR | Binäre Klassifikation, Wahrscheinlichkeitsvorhersage | Schnelles Training, hohe Interpretierbarkeit | Schwierig, nichtlineare Beziehungen anzupassen | |
| Support-Vektor-Maschine | SVM | Klassifikation, hochdimensionale Daten mit kleinen Stichproben | Starke Generalisierungsfähigkeit, geeignet für Szenarien mit hohen Merkmalsdimensionen | Langsames Training bei großen Datenmengen, komplexe Parameterabstimmung | |
| Naive Bayes | NB | Textklassifikation, Spam-Erkennung | Extrem schnelles Training, unempfindlich gegenüber fehlenden Daten | Nimmt Unabhängigkeit der Merkmale an, was in realen Szenarien möglicherweise nicht zutrifft | |
| XGBoost | XGBoost | Klassifikation, Regression, Aufgaben auf Wettbewerbsniveau | Hohe Genauigkeit, unterstützt parallele Berechnung, integrierte Regularisierung | Anfällig für Overfitting, empfindlich gegenüber Hyperparametern | |
| LightGBM | LightGBM | Klassifikation und Regression bei großen Datenmengen | Schnelle Trainingsgeschwindigkeit, geringer Speicherverbrauch | Kann bei kleinen Datensätzen weniger stabil als XGBoost sein | |
| Deep Learning | Künstliches Neuronales Netz | ANN | Einfache Klassifikations- und Regressionsaufgaben | Einfache Struktur, leicht zu verstehen | Schwierig, hochdimensionale, komplexe Daten zu verarbeiten |
| Faltungsneuronales Netz | CNN | Bilderkennung, Objekterkennung, Videoanalyse | Extrahiert automatisch räumliche Merkmale, Parameter-Sharing | Das Training erfordert große Datenmengen und Rechenressourcen | |
| Rekurrentes Neuronales Netz | RNN | Verarbeitung von Sequenzdaten, Textgenerierung | Verarbeitet Sequenzen variabler Länge | Hat Probleme mit verschwindenden/explodierenden Gradienten, langfristige Abhängigkeiten sind schwer zu erfassen | |
| Long Short-Term Memory | LSTM | Übersetzung langer Textsequenzen, Spracherkennung | Löst das Langzeitabhängigkeitsproblem von RNNs | Komplexe Struktur, relativ langsame Trainingsgeschwindigkeit | |
| Gated Recurrent Unit | GRU | Verarbeitung von Sequenzdaten, Sentimentanalyse | Einfachere Struktur als LSTM, schnelleres Training | Bei langen Sequenzen etwas schlechter als LSTM | |
| Generatives adversarisches Netzwerk | GAN | Bildgenerierung, Stilübertragung, Daten-Augmentierung | Generierte Daten von hoher Qualität, starke Diversität | Instabiles Training, anfällig für Mode Collapse | |
| Transformer | Transformer | Verarbeitung natürlicher Sprache, multimodale Aufgaben | Hohe Effizienz bei paralleler Berechnung, starke Fähigkeit, lange Abhängigkeiten zu erfassen | Hohe Rechenkosten, anfällig für Overfitting bei kleinen Datensätzen | |
| Autoencoder | AE | Datenkompression, Anomalieerkennung, Merkmalsextraktion | Unüberwachtes Lernen, einfache Struktur | Qualität der generierten Daten ist normalerweise geringer als bei GAN | |
| Graph-Neuronales Netz | GNN | Analyse sozialer Netzwerke, Vorhersage molekularer Strukturen | Verarbeitet graphstrukturierte Daten, ermittelt Knotenbeziehungen | Schwierig zu trainieren, hohe Anforderungen an die Vorverarbeitung der Graphstruktur |