Q-Learning und SARSA beim bestärkenden Lernen
Im Bereich der künstlichen Intelligenz ist das bestärkende Lernen eine Methode, die es einem Agenten ermöglicht zu lernen, wie er Ziele durch Interaktion mit der Umgebung erreicht.
Stellen Sie sich vor, Sie bringen einem Welpen ein neues Kommando bei: Wenn er eine Aktion ausführt (z. B. sich setzen), geben Sie ihm eine Belohnung (ein Leckerli), und er lernt allmählich, richtig zu reagieren, wenn er das Kommando hört. Q-learning und SARSA sind zwei klassische und entscheidende Algorithmen im bestärkenden Lernen; sie sind die Kernwerkzeuge, mit denen der Agent lernen kannwelche Aktion in welchem Zustand am besten istKernwerkzeuge.
Grundlagen des bestärkenden Lernens und des Markov-Entscheidungsprozesses
Bevor wir in Q-learning und SARSA eintauchen, müssen wir das gemeinsame theoretische Rahmenwerk verstehen, das sie teilen.
Kernkonzepte
Probleme des bestärkenden Lernens werden üblicherweise modelliert alsein Markov-Entscheidungsprozess. Er enthält die folgenden Schlüsselelemente:
- Agent: Die Entität, die Entscheidungen trifft und lernt.
- Umgebung: Die externe Welt, mit der der Agent interagiert.
- Zustand: Eine Beschreibung der Umgebung zu einem bestimmten Zeitpunkt.
- Aktion: Eine Operation, die der Agent in einem gegebenen Zustand ausführen kann.
- Belohnung: Das unmittelbare Auszahlungssignal, das die Umgebung nach Ausführung einer Aktion durch den Agenten zurückmeldet.
- Policy: Die Regel, nach der der Agent in einem gegebenen Zustand Aktionen auswählt; sie ist das Lernziel.
Ziele und Wertfunktionen
Das ultimative Ziel des Agenten ist es, die langfristige kumulative Belohnung zu maximieren, nicht nur die unmittelbare Belohnung. Zu diesem Zweck führen wirWertfunktionen ein.。
- Zustandswertfunktion V(s): Stellt, ausgehend vom Zustand
s, die erwartete kumulative Belohnung dar, die durch Befolgen einer bestimmten Policy erzielt werden kann. - Aktionswertfunktion Q(s, a): Stellt im Zustand
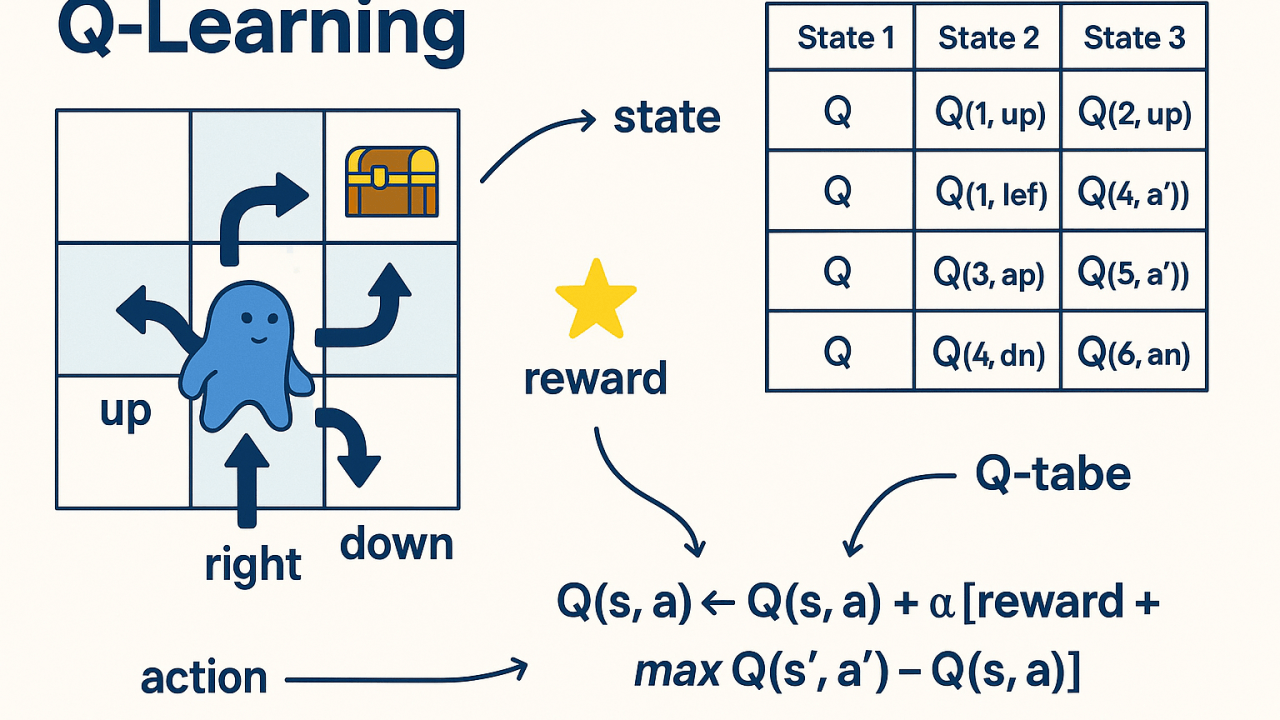
sbei Ausführung der Aktionaund anschließendem Befolgen einer bestimmten Policy die erwartete kumulative Belohnung dar, die erzielt werden kann.Der Kern von Q-learning und SARSA besteht darin, diese Q-Funktion zu lernen.
Um unmittelbare und zukünftige Belohnungen auszugleichen, verwenden wirDiskontfaktor γ(normalerweise im Bereich [0, 1]). Die Belohnung beim zukünftigen Schritt k wird mit γ^k multipliziert, was bedeutet, dass der Agent kurzfristigen Belohnungen mehr Bedeutung beimisst.
Q-Learning: Off-Policy-Temporal-Difference-Lernen
Q-Learning ist einOff-Policy-Algorithmus, der 1989 von Watkins vorgeschlagen wurde. Seine Kernidee ist, dass der Agent indirekt die optimale Policy findet, indem er eine optimale Q-Wert-Tabelle lernt.
Algorithmuskern: Formel zur Aktualisierung des Q-Werts
Der Lernprozess von Q-learning wird durch die folgende Formel gesteuert:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]
Zerlegen wir diese Formel:
Q(s_t, a_t)Q(s, a): zum Zeitpunkt tt, im Zustand ss_tAusführen von Aktion aa_t, die aktuelle Schätzung.α: Lernrate α, steuert den Grad, in dem neue Informationen alte Informationen überschreiben (0 < α ≤ 1).r_{t+1}r: nach Ausführung einer Aktiona_t, die unmittelbar erhaltene Belohnung.γ: Diskontfaktor γ, misst die Wichtigkeit zukünftiger Belohnungen.max_{a} Q(s_{t+1}, a)max Q(s', a'): imnächsten Zustands_{t+1}, der größte Q-Wert unter allen möglichen Aktionen. Dies stellt die bestmögliche zukünftige Rückgabe dar, die basierend auf der aktuellen Q-Tabelle geschätzt wird.[ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]TD-Fehler: genanntTemporal-Difference-Fehler. Er ist die Differenz zwischen dem "Zielwert" (sofortige Belohnung plus die beste Zukunftsschätzung) und der "aktuellen Schätzung". Der Algorithmus aktualisiert Q, indem er diesen Fehler reduziert.
Die Bedeutung von Off-Policy
Q-Learning wirdOff-Policygenannt, weil es beim Aktualisieren von Q-Werten die Aktion, die zur Bewertung des zukünftigen Werts verwendet wird (max_{a} Q(s_{t+1}, a)) und die Aktion, die der Agent tatsächlich zur Exploration ausführt,sind getrennt.。
- Verhaltensrichtlinie: Die Richtlinie, die verwendet wird, um tatsächlich ausgeführte Aktionen auszuwählen (z. B. ε-greedy, das mit einer bestimmten Wahrscheinlichkeit zufällig erkundet).
- Zielrichtlinie: Die Richtlinie, die zum Aktualisieren der Q-Werte verwendet wird; sie ist eine vollständig gierige Richtlinie (wählt immer die Aktion mit dem größten aktuellen Q-Wert).
Diese Trennung ermöglicht es Q-Learning, kühn zu lernen, indem es seine Schätzung des optimalen Pfads verwendet, selbst während es gerade zufällige Exploration durchführt.
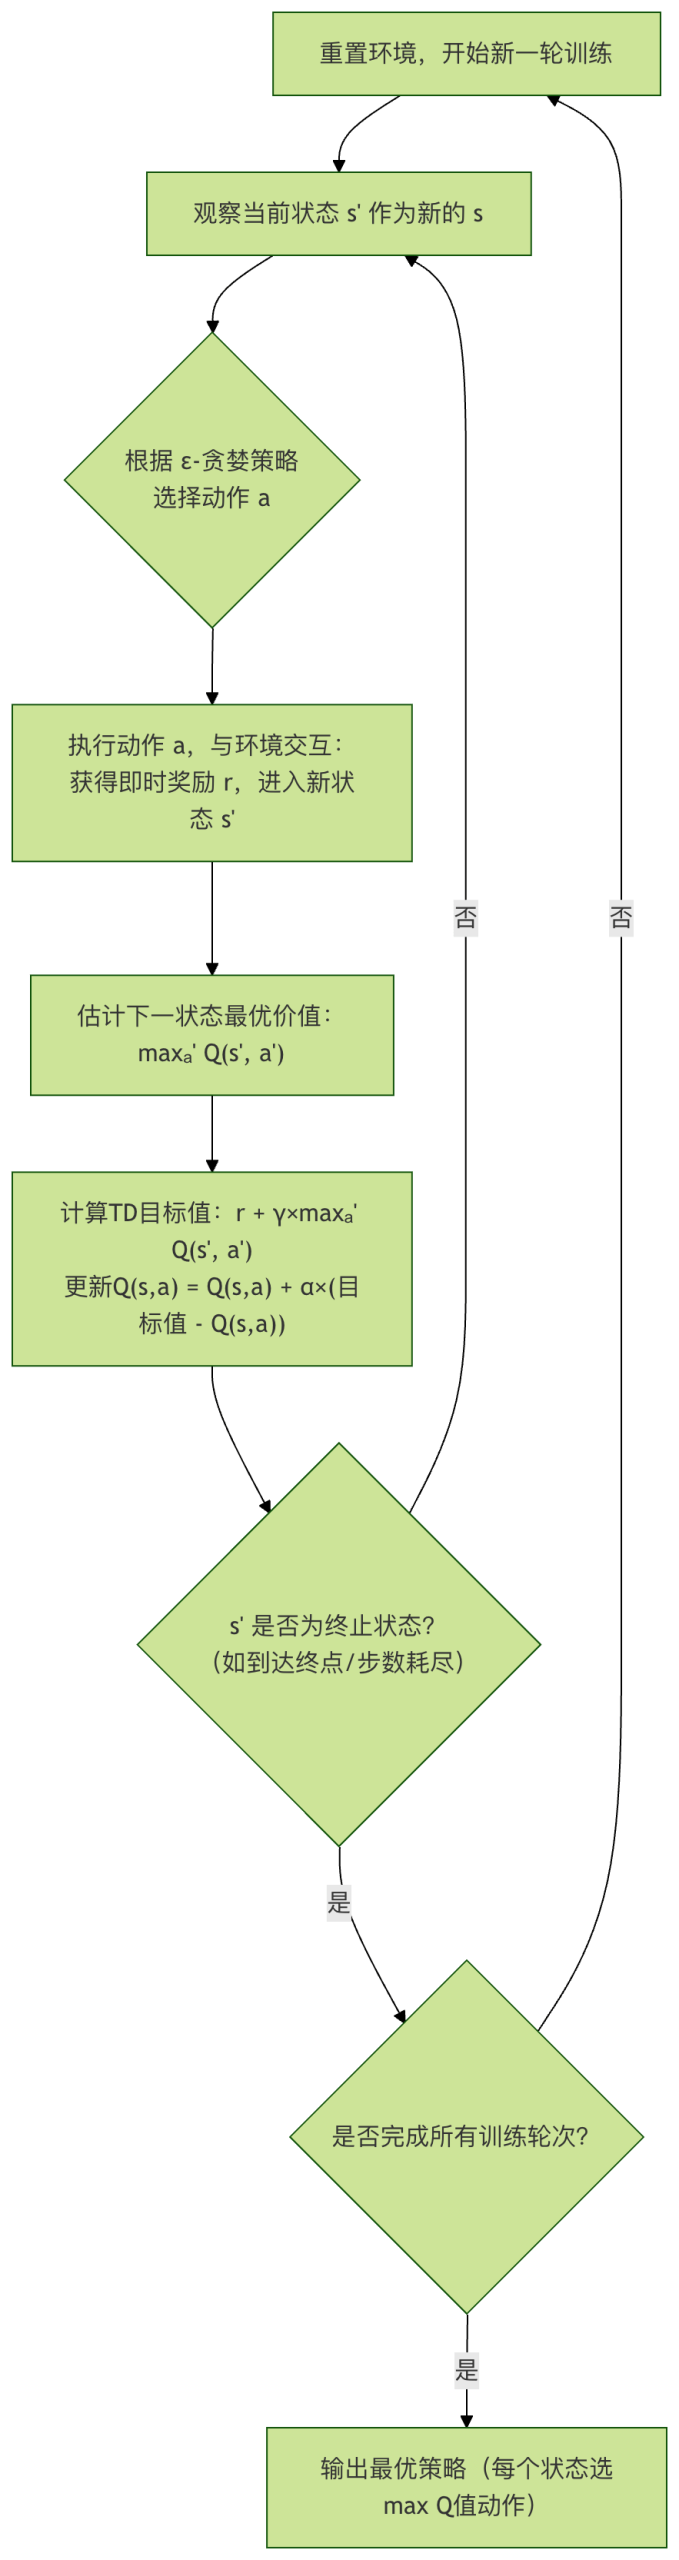
Algorithmusablauf
SARSA: On-Policy Temporal-Difference-Lernen
Der Name SARSA stammt aus der Zustands-Aktions-Sequenz, die an seinem Aktualisierungsprozess beteiligt ist:(S_t, A_t, R_{t+1}, S_{t+1}, A_{t+1}). Es ist einOn-PolicyAlgorithmus.
Algorithmuskern: Formel zur Aktualisierung des Q-Werts
Die Aktualisierungsformel von SARSA ist der von Q-Learning sehr ähnlich, aber es gibt einen entscheidenden Unterschied:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) ]
Beachte den zweiten Teil:
- Q-Learning verwendet max_{a'} Q(s', a'):
γ * max_{a} Q(s_{t+1}, a) - SARSA verwendet Q(s', a'):
γ * Q(s_{t+1}, a_{t+1})
In SARSA wird der Agent imnächsten Zustands_{t+1}tatsächlich eine Aktion ausführen,a_{t+1}deren Q-Wert zur Schätzung des zukünftigen Werts verwendet wird.
Die Bedeutung von On-Policy
SARSA wirdOn-Policygenannt, weil die Policy, die zum Aktualisieren der Q-Werte verwendet wird (Ziel-Policy), und die Policy, die zur Auswahl von Aktionen verwendet wird (Verhaltens-Policy),dieselben sind, wobei beide normalerweise die ε-greedy-Policy sind.
- Es bewertet und optimiert die Policy, die esgerade ausführt.
- Was es lernt, ist eine Policy, die das Risiko zukünftiger Exploration berücksichtigt, daher ist sie normalerweise "konservativer".
Vergleich von Q-Learning und SARSA
Das Verständnis des Unterschieds zwischen beiden ist der Schlüssel, um sie zu meistern. Die folgende Tabelle fasst die Kernunterschiede übersichtlich zusammen:
| Merkmal | Q-learning | SARSA |
|---|---|---|
| Policy-Typ | Off-policy | On-policy |
| Aktualisierungsziel | Basierend auf der optimalen Aktion:r + γ * max Q(s', a') |
Basierend auf der tatsächlichen Aktion:r + γ * Q(s', a_{t+1}) |
| Lernziel | Lerne die Q-Funktionder optimalen Policy. | Lerne die Q-Funktionder Verhaltens-Policy (z. B. ε-greedy). |
| Risikoneigung | Eher "kühn", geht davon aus, dass in der Zukunft optimale Aktionen gewählt werden | Eher "konservativ", berücksichtigt das Risiko, das zukünftige Exploration mit sich bringen kann |
| Aktualisierungszeitpunkt | In(s, a, r, s')kann sofort nach (S, A, R, S') aktualisiert werden |
erfordert(s, a, r, s', a')das Fünf-Tupel (S, A, R, S', A') zum Aktualisieren. |
| Typische Anwendungen | Diskrete Umgebungen, Suche nach der global optimalen Lösung | Umgebungen mit hohen Sicherheitsanforderungen, in denen gefährliche Zustände vermieden werden müssen |
Klassisches Cliff-Walking-Beispiel
Dieses Beispiel veranschaulicht den Unterschied zwischen beiden anschaulich. Angenommen, eine Gitterwelt, in der der Agent vom Start S zum Ziel G läuft; darunter befindet sich eine Klippe. Ein Absturz gibt eine große negative Belohnung und führt zurück zum Start.

- Q-learningQ-learning: Da es annimmt, dass in der Zukunft immer der optimale (sicherste) Weg gewählt wird, lernt es schnell den kürzesten Weg entlang der Klippenkante (Pfad 1), weil es "glaubt", dass es nicht abstürzen wird.
- SARSASARSA: Da es berücksichtigt, dass in der Zukunft noch eine Wahrscheinlichkeit ε für zufällige Exploration besteht, könnte es von der Klippe fallen. Daher lernt es einen sichereren Weg weiter oben (Pfad 2). Obwohl er länger ist, ist seine langfristig erwartete Rendite höher.
Fazit: In Umgebungen, in denen Exploration und Exploitation ausbalanciert werden müssen und Fehler kostspielig sind, lernt SARSA normalerweise eine sicherere und robustere Policy.
Code-Praxis: Q-Learning und SARSA in Python implementieren
Wir verwenden eine einfache4x4Gitterwelt, um beide Algorithmen zu demonstrieren. Das Ziel ist, dass sich der Agent von der oberen linken Ecke(0,0)zur unteren rechten Ecke bewegt.(3,3)。
Umgebungs-Setup
Beispiel
import random
class GridWorld:
def __init__(self, size=4):
self.size = size
self.state = (0, 0) # Startpunkt
self.goal = (size-1, size-1) # Endpunkt
self.actions = ['up', 'down', 'left', 'right']
self.action_map = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
def reset(self):
"""Umgebung auf Startpunkt zurücksetzen"""
self.state = (0, 0)
return self.state
def step(self, action):
"""Aktion ausführen, (nächster Zustand, Belohnung, beendet) zurückgeben"""
move = self.action_map[action]
next_state = (self.state[0] + move[0], self.state[1] + move[1])
# Grenzprüfung: Wenn außerhalb der Grenzen, an Ort und Stelle bleiben
if not (0 <= next_state[0] < self.size and 0 <= next_state[1] < self.size):
next_state = self.state
self.state = next_state
# Belohnungs-Setup: Belohnung 10 für das Erreichen des Ziels, -1 für andere Züge (schnelles Erreichen fördern)
if next_state == self.goal:
Belohnung = 10
done = True
else:
Belohnung = -1
done = False
return next_state, reward, done
def get_actions(self):
return self.actions
Implementierung des Q-learning-Algorithmus
Beispiel
"""
Q-learning-Algorithmus implementieren
env: Umgebungsobjekt
episodes: Anzahl der Trainingsepisoden
alpha: Lernrate
gamma: Diskontfaktor
epsilon: Explorationswahrscheinlichkeit in der ε-greedy-Strategie
"""
# Q-Tabelle mit Form [Gitterzeilen, Gitterspalten, Anzahl der Aktionen] initialisieren
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
while not done:
# 1. Aktion mithilfe der ε-greedy-Policy auswählen
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1) # Exploration: zufällig auswählen
else:
action_idx = np.argmax(q_table[state[0], state[1], :]) # Ausnutzung: die Aktion mit dem maximalen Q-Wert wählen
action = env.actions[action_idx]
# 2. Aktion ausführen, Feedback erhalten
next_state, reward, done = env.step(action)
# 3. Kern-Update von Q-learning
# Q-Wert des aktuellen Zustands-Aktions-Paares
current_q = q_table[state[0], state[1], action_idx]
# Maximaler Q-Wert des nächsten Zustands (Schlüssel für Off-Policy)
next_max_q = np.max(q_table[next_state[0], next_state[1], :])
# Ziel-Q-Wert berechnen
target_q = reward + gamma * next_max_q
# Q-Tabelle aktualisieren
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# Übergang zum nächsten Zustand
state = next_state
return q_table
Implementierung des SARSA-Algorithmus
Beispiel
"""
SARSA-Algorithmus implementieren
Parameterbedeutungen wie bei Q-Learning
"""
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
# SARSA muss zuerst eine Aktion für den Anfangszustand wählen
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1)
else:
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
while not done:
# 1. Führe die im vorherigen Schritt gewählte Aktion aus
next_state, reward, done = env.step(action)
# 2. Wähle eine Aktion für den nächsten Zustand (on-policy, weiterhin ε-greedy)
if random.uniform(0, 1) < epsilon:
next_action_idx = random.randint(0, len(env.actions)-1)
else:
next_action_idx = np.argmax(q_table[next_state[0], next_state[1], :])
next_action = env.actions[next_action_idx]
# 3. SARSA-Kern-Update
current_q = q_table[state[0], state[1], action_idx]
# Hauptunterschied: Verwende den Q-Wert der **tatsächlich auszuführenden Aktion** im nächsten Zustand
next_q = q_table[next_state[0], next_state[1], next_action_idx]
target_q = reward + gamma * next_q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# 4. Aktualisiere Zustand und Aktion für die nächste Iteration
state = next_state
action_idx = next_action_idx
action = next_action
return q_table
Testen und Policy-Visualisierung
Beispiel
"""Teste die gelernte Policy"""
total_rewards = []
for _ in range(episodes):
state = env.reset()
done = False
total_reward = 0
steps = []
while not done:
# Verwende während des Testens eine greedy Policy (keine Exploration)
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
next_state, reward, done = env.step(action)
steps.append(action[0].upper()) # Ersten Buchstaben jeder Aktion aufzeichnen
total_reward += reward
state = next_state
total_rewards.append(total_reward)
print(f"Episodenschritte: {steps}, Gesamtbelohnung: {total_reward}")
print(f"Durchschnittliche Belohnung: {np.mean(total_rewards):.2f}")
# Umgebung erstellen
env = GridWorld(size=4)
print("=== Training und Testen von Q-Learning ===")
q_table_ql = q_learning(env, episodes=1000)
test_policy(env, q_table_ql)
print("\n"=== Training und Testen von SARSA ===")
env.reset() # Umgebungszustand zurücksetzen
q_table_sarsa = sarsa(env, episodes=1000)
test_policy(env, q_table_sarsa)
# Vergleiche einfach die finalen Policies
print("\n=== Policy-Vergleich (Aktionen vom Startpunkt (0,0)) ===)
start_q_values = q_table_ql[0, 0, :]
start_sarsa_values = q_table_sarsa[0, 0, :]
print(f"Q-learning Q-Werte: {dict(zip(env.actions, start_q_values))}")
print(f"Empfohlene Aktion: {env.actions[np.argmax(start_q_values)]}")
print(f"SARSA Q-Werte: {dict(zip(env.actions, start_sarsa_values))}")
print(f"Empfohlene Aktion: {env.actions[np.argmax(start_sarsa_values)]}")