Unüberwachtes Lernen - Clustering
Stellen Sie sich vor, Sie betreten eine riesige Bibliothek, in der alle Bücher unordentlich auf dem Boden verstreut sind. Ihre Aufgabe ist es nicht, jedes Buch zu lesen (das wäre zu zeitaufwändig), sondern sie nach Themen wie Science-Fiction, historischen Biografien und Kochrezepten in Stapeln zu gruppieren. In diesem Prozess haben Sie keine fertige Klassifikationsliste, die Ihnen sagt, welches Buch zu welcher Kategorie gehört; Sie verlassen sich ausschließlich auf Merkmale wie den Inhalt des Buches, den Einband, die Dicke usw.,spontandiese Gruppen entdecken.
Im maschinellen Lernen geht es beimClusteringgenau darum. Es ist eine Art vonunüberwachtem Lernen, einer Methode, deren Ziel es ist, die interne Struktur und Gruppierung in Daten zu entdecken, die keine vorab gekennzeichneten Antworten haben (d. h. keine "Labels").
Was ist unüberwachtes Lernen und Clustering?
Bevor wir beginnen, wollen wir kurz zwischen den beiden Hauptparadigmen des maschinellen Lernens unterscheiden:
- Überwachtes Lernen: Es ist wie Lernen mit einem Lehrer. Wir geben dem Algorithmus eine große Anzahl von Fragen (Merkmalsdaten) und die entsprechenden richtigen Antworten (Labels), damit er die Zuordnung von Fragen zu Antworten lernt. Zum Beispiel zeigen wir dem Algorithmus viele Bilder von Katzen und Hunden (Merkmale) und sagen ihm, ob jedes Bild eine Katze oder ein Hund ist (Labels). Nach dem Training kann er neue Bilder erkennen.
- Unüberwachtes Lernen: Es ist, als würde man die Maschine selbst erkunden und entdecken lassen. Wir stellen nur Fragen (Merkmalsdaten),ohne Antworten (Labels) bereitzustellen. Die Aufgabe des Algorithmus besteht darin, selbst Muster, Strukturen oder Beziehungen aus den Daten zu finden. Clustering ist eine seiner Kerntechniken.
Die Kernidee des Clusterings: Unterteile die Stichproben im Datensatz in mehreredisjunkteTeilmengen (Cluster oder Klassen genannt), sodass Stichproben innerhalb desselben Clusters einanderähnlichsind, während Stichproben in verschiedenen Clustern einanderunähnlich。
Die Ähnlichkeit wird hier üblicherweise durch mathematischeDistanz(z. B. euklidische Distanz) gemessen.
Je geringer die Distanz, desto höher die Ähnlichkeit.
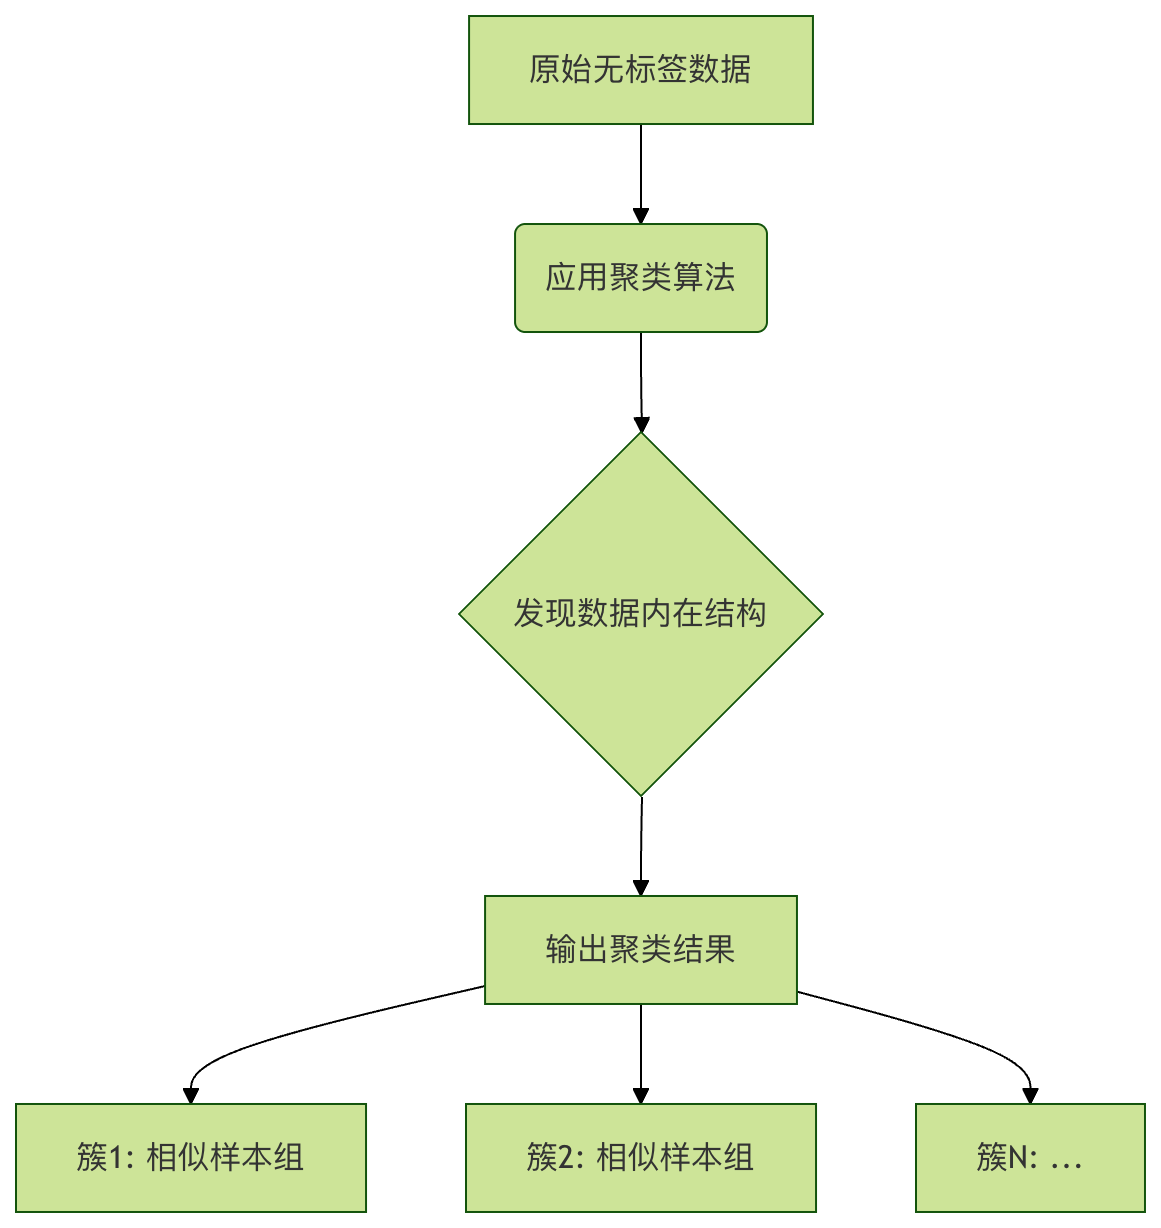
Klassischer Clustering-Algorithmus: K-Means
K-MeansEr ist einer der bekanntesten und am häufigsten verwendeten Clustering-Algorithmen, mit einer intuitiven Idee und einer relativ einfachen Implementierung.
Funktionsweise und Schritte des Algorithmus
Wir können uns den K-Means-Prozess als Wahl von Repräsentanten und Neuaufteilung von Bezirken vorstellen:
- Bestimmen Sie die Anzahl der Cluster K: Zuerst müssen Sie entscheiden, in wie viele Klassen Sie die Daten aufteilen möchten. Dieser K-Wert muss im Voraus festgelegt werden; er ist ein Schlüsselparameter von K-Means.
- Repräsentanten initialisieren (Zentroide): Wählen Sie zufällig K Punkte im Datenraum als anfängliche "Mittelpunkte" jedes Clusters aus, die wirZentroide nennen。
- Bewohner (Stichproben) zuweisen: Berechnen Sie die Distanz von jedem Stichprobenpunkt im Datensatz zu den K Zentroiden. Nach dem Prinzip "Was nahe beieinander liegt, gehört zur selben Klasse", weisen Sie jede Stichprobe dem Cluster des Zentroids zu, deram nächstendaran liegt. Auf diese Weise werden alle Stichproben in K Cluster aufgeteilt.
- Neue Repräsentanten wählen (Zentroide aktualisieren): Nun hat jeder Cluster eine Menge von Stichproben. Berechnen Sie den Zentroid jedes Clusters neu; der neue Zentroid ist derDurchschnitt(Mittelpunkt) aller Stichprobenpunkte in diesem Cluster.
- Wiederholen und konvergieren: Wiederholen Sie Schritt 3 (Zuordnung) und Schritt 4 (Aktualisierung), bis sich die Positionen der Zentroide nicht mehr wesentlich ändern (d. h. der Algorithmus konvergiert). Zu diesem Zeitpunkt ändert sich auch der Cluster, zu dem jede Stichprobe gehört, nicht mehr.
Codebeispiel und Übung
Verwenden wir Pythonsscikit-learnBibliothek und einen einfachen Datensatz, um K-Means zu demonstrieren.
Beispiel
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows bevorzugt
'SimHei', 'Microsoft YaHei',
# macOS bevorzugt
'PingFang SC', 'Heiti TC',
# Linux bevorzugt
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Das Problem beheben, bei dem negative Vorzeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
# 1. Einen künstlichen Datensatz erstellen
# Wir erzeugen 300 Beispielpunkte, die sich auf natürliche Weise um 4 Zentren gruppieren (um die Beobachtung zu erleichtern)
X, y_true = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# X sind die Merkmalsdaten, y_true sind die echten Klassenlabels (werden nur für den abschließenden Vergleich verwendet; der Clustering-Algorithmus verwendet sie nicht)
# 2. Die Originaldaten visualisieren
plt.scatter(X[:, 0], X[:, 1], s=50) # s ist die Größe der Punkte
plt.title("Ursprüngliche unbeschriftete Daten")
plt.show()
# 3. K-Means-Clustering anwenden
# Angeben, in 4 Klassen zu clustern
kmeans = KMeans(n_clusters=4, random_state=0, n_init='auto')
# Modell anpassen und das Cluster-Label jeder Stichprobe vorhersagen
y_kmeans = kmeans.fit_predict(X)
# 4. Die Zentroid-Koordinaten ermitteln
centroids = kmeans.cluster_centers_
# 5. Die Clustering-Ergebnisse visualisieren
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
# Datenpunkte verschiedener Cluster mit unterschiedlichen Farben markieren
plt.scatter(centroids[:, 0], centroids[:, 1], c='red', s=200, alpha=0.8, marker='X')
# Zentroidpositionen mit roten Kreuzen markieren, alpha ist die Transparenz
plt.title("K-Means-Clustering-Ergebnis (K=4)")
plt.show()
# Die vorhergesagten Cluster-Labels der ersten 10 Stichproben ausgeben
print("Cluster-Labels der ersten 10 Stichproben:", y_kmeans[:10])
# Zentroidkoordinaten ausgeben
print("Zentroidkoordinaten der vier Cluster:"\n", centroids)
Code-Erklärung:
make_blobs: Erzeugt einen simulierten Datensatz für das Clustering,centers=4gibt an, dass die Daten um 4 Zentren herum erzeugt werden.KMeans(n_clusters=4): Erstellt eine K-Means-Modellinstanz und gibt die Anzahl der Cluster K als 4 an.n_init='auto'ist die Anzahl der Ausführungen des Algorithmus, wobei das beste Ergebnis verwendet wird.fit_predict(X): Die Kernmethode, angewendet auf die DatenXpasst das Modell an und gibt den Clusterindex (0, 1, 2, 3) für jede Stichprobe zurück.cluster_centers_: Ein Attribut, das die Koordinaten der nach dem Training erhaltenen K-Zentroide speichert.
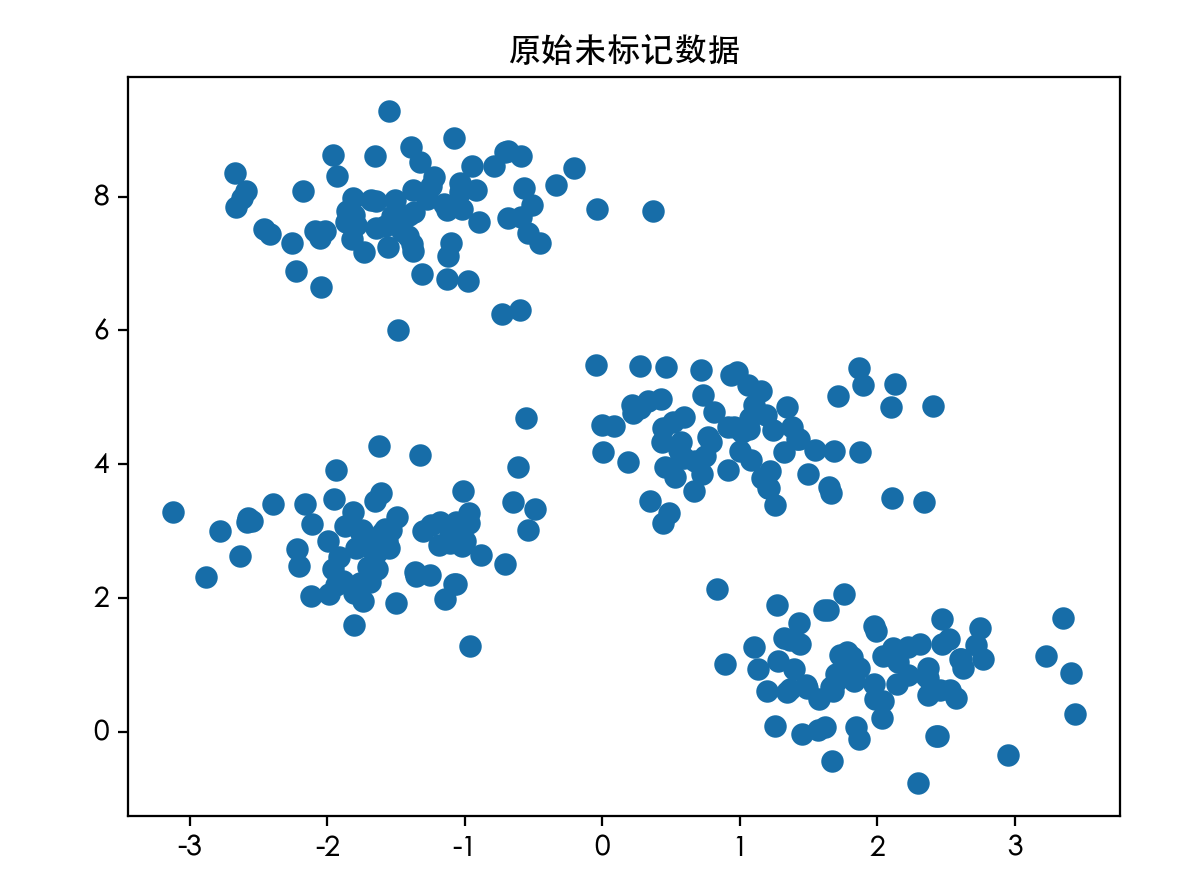
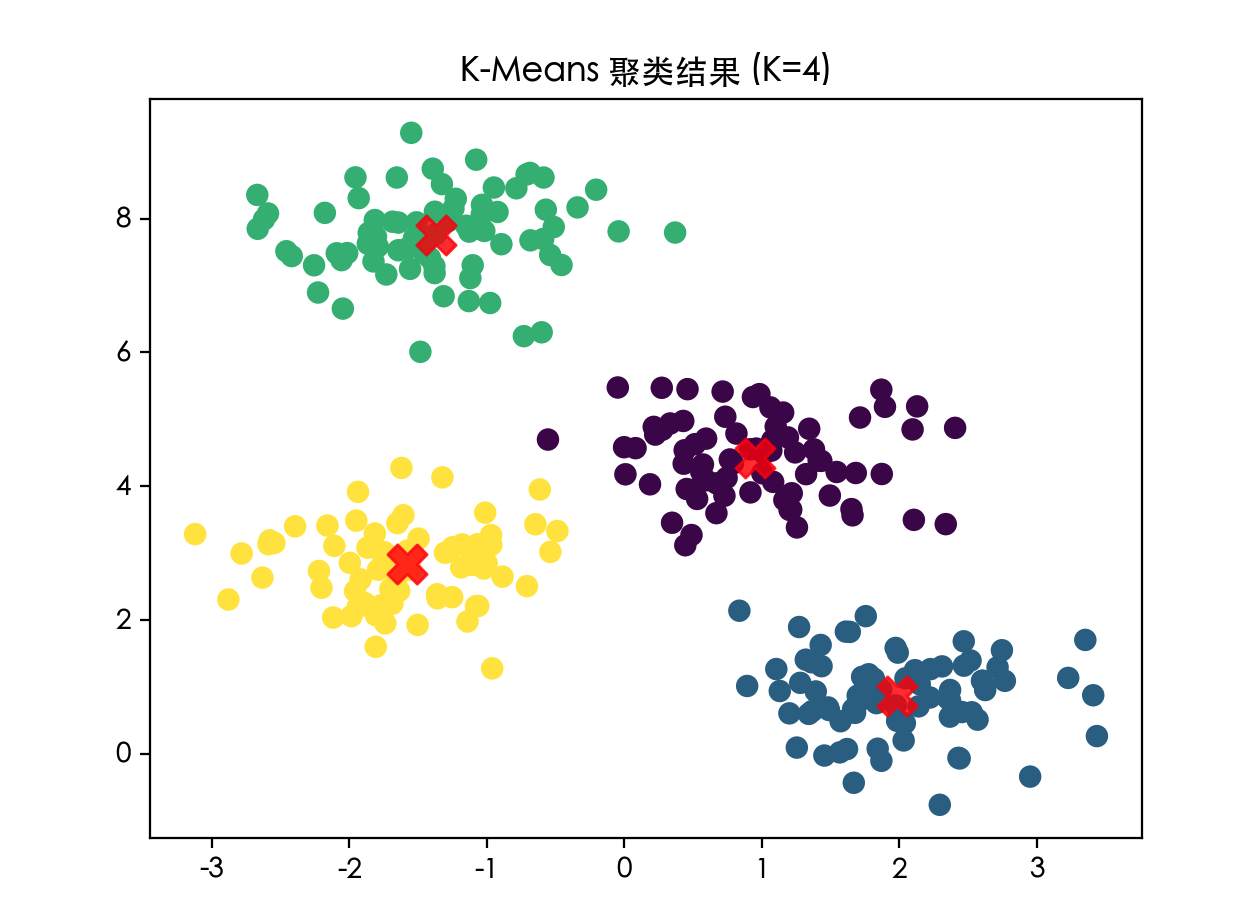
Wenn Sie diesen Code ausführen, sehen Sie zwei Diagramme. Das erste ist eine Menge unordentlicher Punkte, während das zweite klar in vier farbige Gruppen unterteilt ist, mit rotenXMarkierungen in den Zentren. Das ist die Magie von K-Means!
前10个样本的簇标签: [1 2 0 2 1 1 3 0 2 2]
四个簇的质心坐标:
 [[ 0.94973532  4.41906906]
 [ 1.98258281  0.86771314]
 [-1.37324398  7.75368871]
 [-1.58438467  2.83081263]]
Ursprüngliche unbeschriftete Daten:
K-Means-Clustering-Ergebnis:
Wie wählt man den besten K-Wert?
Da wir wissen, dass die Daten um 4 Zentren herum erzeugt werden, setzen wir im obigen Beispiel einfachK=4. Aber in der realen Welt wissen wir oft nicht, in wie viele Klassen die Daten aufgeteilt werden sollten. Wie wählt man K?
Eine häufig verwendete Methode ist die"Ellbogenmethode". Die Idee ist: Wenn die Anzahl der Cluster K zunimmt, nimmt der durchschnittliche Abstand der Beispielpunkte zum Zentroid ihres Clusters (genanntVerzerrungoderinertia) ab. Wenn K kleiner als die wahre Anzahl der Cluster ist, verringert eine Erhöhung von K diesen Abstand stark; wenn K die wahre Anzahl der Cluster erreicht, führt eine weitere Erhöhung von K dazu, dass die Verringerung des Abstands stark zurückgeht. Dieser Knickpunkt ist wie das Ellbogengelenk, und der entsprechende K-Wert ist eine bessere Wahl.
Beispiel
inertias = []
K_range = range(1, 11) # K von 1 bis 10 testen
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=0, n_init='auto')
kmeans.fit(X)
inertias.append(kmeans.inertia_) # Das Attribut inertia_ ist die SSE
# Die Ellbogenkurve zeichnen
plt.plot(K_range, inertias, 'bo-')
plt.xlabel('Anzahl der Cluster K')
plt.ylabel('Trägheit (SSE)')
plt.title('Ellbogenmethode zum Finden des besten K-Werts')
plt.axvline(x=4, color='r', linestyle='--', alpha=0.5) # Markiere das bekannte K=4
plt.show()
Wenn du die erzeugte Kurve betrachtest, wirst du feststellen, dass sich die Geschwindigkeit, mit der die Kurve abfällt, um K=4 herum deutlich verlangsamt und einen "Ellbogen" bildet, was darauf hindeutet, dass K=4 eine vernünftige Wahl ist.
Anwendungsszenarien des Clusterings
Clustering ist ein leistungsstarkes Werkzeug zur explorativen Datenanalyse mit extrem breiten Anwendungen:
- Kundensegmentierung: Im E-Commerce oder Marketing wird auf der Grundlage des Kaufverhaltens und der Demografie (demografische Merkmale) von Kunden geclustert, um sie in Gruppen wie "High-Value-Kunden" und "preisempfindliche Kunden" für gezieltes Marketing einzuteilen.
- Bildsegmentierung: Clustern Sie Pixel in einem Bild basierend auf Farbe und Textur, was verwendet werden kann, um Bilder zu vereinfachen und Vordergrund und Hintergrund zu identifizieren.
- Anomalieerkennung: Normale Datenpunkte bilden normalerweise dichte Cluster, während Ausreißer weit vom Zentrum eines jeden Clusters entfernt sind. Clustering kann verwendet werden, um diese Ausreißerpunkte zu entdecken.
- Dokumentenklassifikation: Clustern Sie Nachrichtenartikel oder Forschungsarbeiten, um automatisch heiße Themen oder Forschungsfelder zu entdecken.
- Analyse sozialer Netzwerke: In sozialen Netzwerken können durch das Clustern der Beziehungen und Interaktionen von Benutzern Gemeinschaften oder Kreise entdeckt werden.
Praktische Übungen und Zusammenfassung
Übung 1: Probieren Sie verschiedene K-Werte ausÄndern Sie Folgendes im obigen K-Means-Beispielcode:n_clustersParameter: setzen Sie sie jeweils auf 2, 3, 5, 8. Beobachten Sie die Diagramme der Clustering-Ergebnisse und spüren Sie den Einfluss der Wahl des K-Werts auf die Ergebnisse.
Übung 2: Verwenden Sie einen echten DatensatzVersuchen Sie,scikit-learnintegriertirisden (Iris)-Datensatz zum Clustering. Obwohl dieser Datensatz normalerweise für die Klassifikation verwendet wird, können Sie seine Labels ignorieren und nur die Merkmalsdaten (Kelch- und Blütenblattlänge und -breite) für das K-Means-Clustering verwenden und dann die Clustering-Ergebnisse mit den wahren Labels vergleichen, um zu sehen, wie gut es funktioniert.
Beispiel
iris = datasets.load_iris()
X_iris = iris.data # Nur die Merkmalsdaten verwenden