Maschinelles Lernen - Kundensegmentierung
In der heutigen datengetriebenen Geschäftswelt ist das Verständnis der Kunden der Schlüssel zum Erfolg.
Wenn Ihre Kundenbasis jedoch Zehntausende oder sogar Millionen erreicht, wird die manuelle Analyse der Merkmale und Verhaltensmuster jedes einzelnen Kunden unpraktikabel.
An diesem Punkt werden Techniken des maschinellen Lernens, insbesondereunüberwachtes Lernen mit seinenClustering-Algorithmen, zu einem leistungsstarken Werkzeug.
Kundensegmentierung, auch Kunden-Segmentierung genannt, hat das Kernziel, die große Kundschaft in mehrere Untergruppen mit ähnlichen Merkmalen aufzuteilen. Das ist wie ein erfahrener Ladenbesitzer, der Kunden nicht mehr als vages Ganzes behandelt, sondern klar verschiedene Gruppen erkennen kann, etwa preisbewusste Haushaltsführende, Technikbegeisterte, die neue Produkte lieben, und High-End-Kunden, denen Serviceerlebnis wichtig ist. Durch gezielte Marketing-, Service- und Produktstrategien für verschiedene Gruppen können Unternehmen ihre operative Effizienz und Kundenzufriedenheit deutlich verbessern.
Dieser Artikel führt Sie Schritt für Schritt durch ein vollständiges Praxisprojekt zur Kundensegmentierung. Wir verwenden den klassischen K-Means-Clustering-Algorithmus, um einen simulierten Einzelhandels-Kundendatensatz zu analysieren – vom Datenverständnis bis zur Modellbewertung – und erhalten schließlich Segmentierungsergebnisse mit Business-Insights.
Clusteranalyse und K-Means-Algorithmus verstehen
Bevor wir mit der praktischen Übung beginnen, müssen wir die Kernwerkzeuge verstehen, die wir gleich verwenden werden.
Was ist Clusteranalyse?
Clusteranalyse ist eine Methode des unüberwachten Lernens. Anders als beim überwachten Lernen (etwa Vorhersage von Hauspreisen oder Erkennung von Katzen- und Hundebildern) haben Clustering-Algorithmen keine vorab gekennzeichneten „richtigen Antworten“ (d. h. Labels). Ihre Aufgabe ist es, die inhärente Struktur der Daten zu erkunden, ähnliche Datenpunkte automatisch derselben Gruppe (einem sogenannten „Cluster“) zuzuordnen und gleichzeitig Datenpunkte in verschiedenen Gruppen so unähnlich wie möglich zu halten.
Eine einfache Analogie: Stellen Sie sich einen Korb mit gemischten Früchten vor, der Äpfel, Orangen und Bananen enthält. Die Aufgabe des Clustering-Algorithmus besteht darin, Früchte, die sich in Form, Farbe und Größe ähneln, automatisch zusammenzuhäufen, ohne dass Ihnen jemand die Kategorienamen nennt.
Wie der K-Means-Algorithmus funktioniert
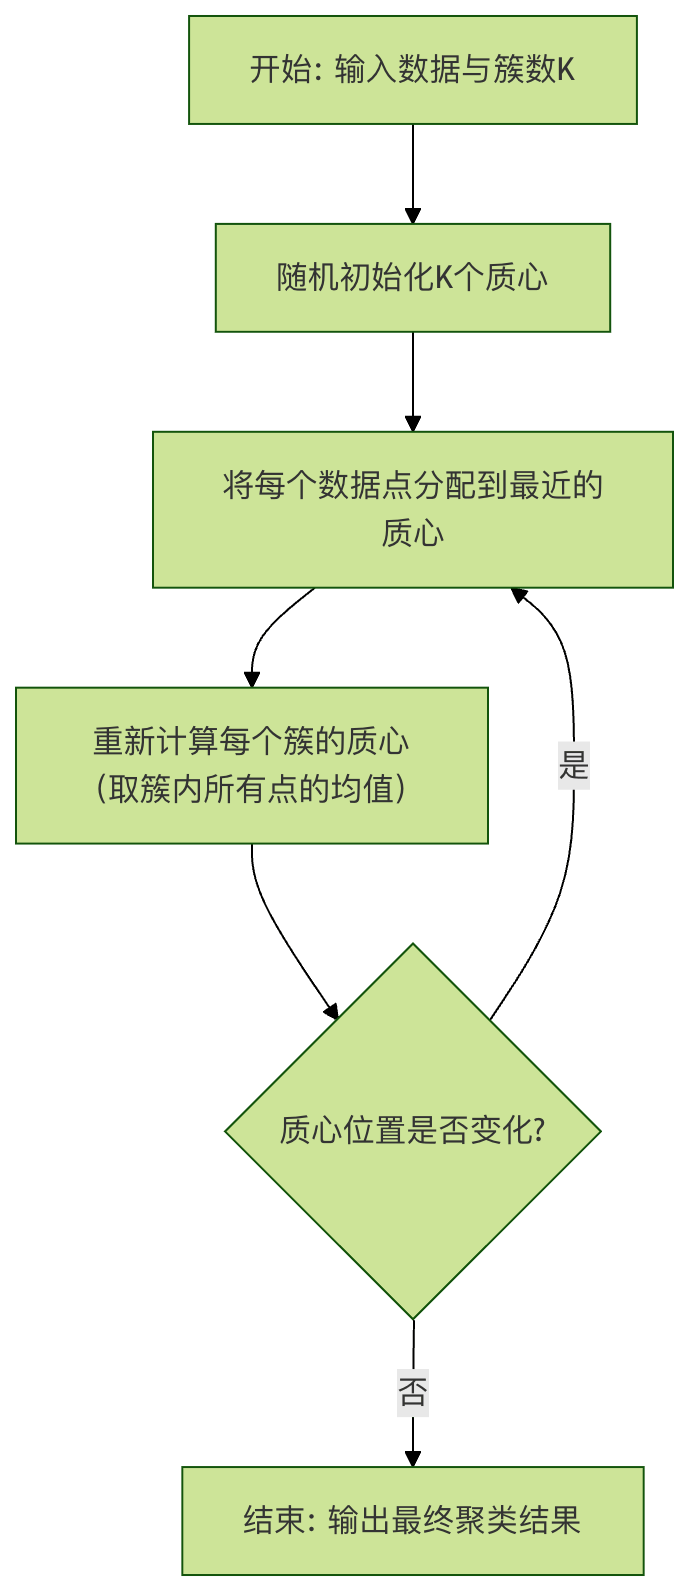
K-Means ist einer der am häufigsten verwendeten und intuitivsten Clustering-Algorithmen. "K" steht für die Anzahl der Cluster, in die wir die Daten aufteilen möchten. Seine Funktionsweise lässt sich in vier Schritten zusammenfassen:
- Initialisierung: Wählen Sie zufällig K Datenpunkte als anfängliche "Cluster" (Zentroide) aus.
- Zuordnung: Berechnen Sie den Abstand von jedem Datenpunkt zu jedem Zentroid (normalerweise unter Verwendung der euklidischen Distanz) und weisen Sie dann jeden Punkt dem Cluster des nächstgelegenen Zentroids zu.
- Aktualisierung: Berechnen Sie den Zentroid jedes Clusters neu (d. h. den Mittelwert aller Punkte in diesem Cluster).
- Iteration: Wiederholen Sie die Schritte 2 und 3, bis sich die Positionen der Zentroide nicht mehr wesentlich ändern oder die vorgegebene Anzahl von Iterationen erreicht ist.
Das folgende Flussdiagramm veranschaulicht diesen Prozess:
Kernpunkte des Algorithmus:
- Distanzmetrik: Normalerweise wird die euklidische Distanz verwendet, um die Ähnlichkeit zwischen Datenpunkten zu messen; je kleiner die Distanz, desto höher die Ähnlichkeit.
- Zentroid: Stellt den "Durchschnittspunkt" oder das Zentrum eines Clusters dar.
- Ziel: Minimieren Sie die Summe der quadrierten Abstände der Datenpunkte zu ihrem Zentroid innerhalb jedes Clusters ("Within-Cluster-Sum of Squares" oder Inertia).
Praxisübung: Einzelhandelskundensegmentierung
Nun werden wir die Theorie in die Praxis umsetzen. Wir werden Python und seine leistungsstarken Bibliotheken aus dem Data-Science-Ökosystem verwenden, um dieses Projekt abzuschließen.
Schritt 1: Einrichtung der Umgebung und Laden der Daten
Stellen Sie zunächst sicher, dass die erforderlichen Bibliotheken in Ihrer Python-Umgebung installiert sind:pandaszur Datenverarbeitung,numpyfür numerische Berechnungen,matplotlibundseabornzur Visualisierung,scikit-learnist die zentrale Bibliothek für maschinelles Lernen.
Beispiel
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import silhouette_score
import warnings
warnings.filterwarnings('ignore') # Nicht kritische Warnungen ignorieren
# Visualisierungsstil festlegen
sns.set_style("whitegrid")
# -------------------------- Chinesische Schriftart festlegen Start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows zuerst
'SimHei', 'Microsoft YaHei',
# macOS zuerst
'PingFang SC', 'Heiti TC',
# Linux zuerst
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Problem beheben, dass Minuszeichen als Quadrate angezeigt werden
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Chinesische Schriftart festlegen Ende --------------------------
Wir werden einen simulierten Kundendatensatz verwendencustomer_data.csv, der typischerweise die folgenden Merkmale enthält:
CustomerID: Eindeutige KundenkennungAnnual_Income_(k$): Jährliches Kundeneinkommen (in Tausend Dollar)Spending_Score: Ausgaben-Score (0-100, umfassend abgeleitet aus Kaufhäufigkeit, Betrag usw.)Age: Alter
Der Inhalt ist wie folgt:
CustomerID,Age,Annual_Income_(k$),Spending_Score
1,19,15,39
2,21,15,81
3,20,16,6
4,23,16,77
5,31,17,40
6,22,17,76
7,35,18,6
8,23,18,94
9,64,19,3
10,30,19,72
11,67,20,14
12,35,20,99
13,58,21,15
14,24,21,77
15,37,22,13
16,22,22,79
17,35,23,35
18,20,23,66
19,52,24,29
20,35,24,98
21,46,25,35
22,25,25,73
23,54,26,5
24,28,26,73
25,45,27,28
26,23,28,82
27,40,28,36
28,35,28,61
29,60,29,4
30,21,30,87
31,62,30,17
32,23,30,73
33,18,31,92
34,49,33,14
35,21,33,81
36,42,34,17
37,30,34,73
38,36,37,26
39,20,37,75
40,65,38,35
41,24,38,92
42,48,39,36
43,31,39,61
44,49,40,29
45,24,40,98
46,50,41,15
47,27,42,65
48,29,43,88
49,31,43,19
50,49,44,75
Beispiel
df = pd.read_csv('customer_data.csv')
print("Datenform (Zeilen, Spalten):", df.shape)
print("\n"Erste 5 Datenzeilen:")
print(df.head())
print("\n"Grundlegende Dateninformationen:")
print(df.info())
print("\n"Deskriptive Statistik:")
print(df.describe())
Ausgabe:
数据形状(行数,列数): (50, 4)

数据前5行:
   CustomerID  Age  Annual_Income_(k$)  Spending_Score
0           1   19                  15              39
1           2   21                  15              81
2           3   20                  16               6
3           4   23                  16              77
4           5   31                  17              40

数据基本信息:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 50 entries, 0 to 49
Data columns (total 4 columns):
 #   Column              Non-Null Count  Dtype
---  ------              --------------  -----
 0   CustomerID          50 non-null     int64
 1   Age                 50 non-null     int64
 2   Annual_Income_(k$)  50 non-null     int64
 3   Spending_Score      50 non-null     int64
dtypes: int64(4)
memory usage: 1.7 KB
None

描述性统计:
       CustomerID        Age  Annual_Income_(k$)  Spending_Score
count    50.00000  50.000000           50.000000       50.000000
mean     25.50000  35.560000           28.160000       51.680000
std      14.57738  14.283085            8.739682       31.506682
min       1.00000  18.000000           15.000000        3.000000
25%      13.25000  23.000000           21.000000       20.750000
50%      25.50000  31.000000           27.500000       61.000000
75%      37.75000  47.500000           36.250000       77.000000
max      50.00000  67.000000           44.000000       99.000000
Schritt 2: Datenexploration und Vorverarbeitung
Bevor wir den Algorithmus anwenden, müssen wir zunächst die Daten verstehen und die "Bereinigungsarbeit" ordnungsgemäß durchführen.
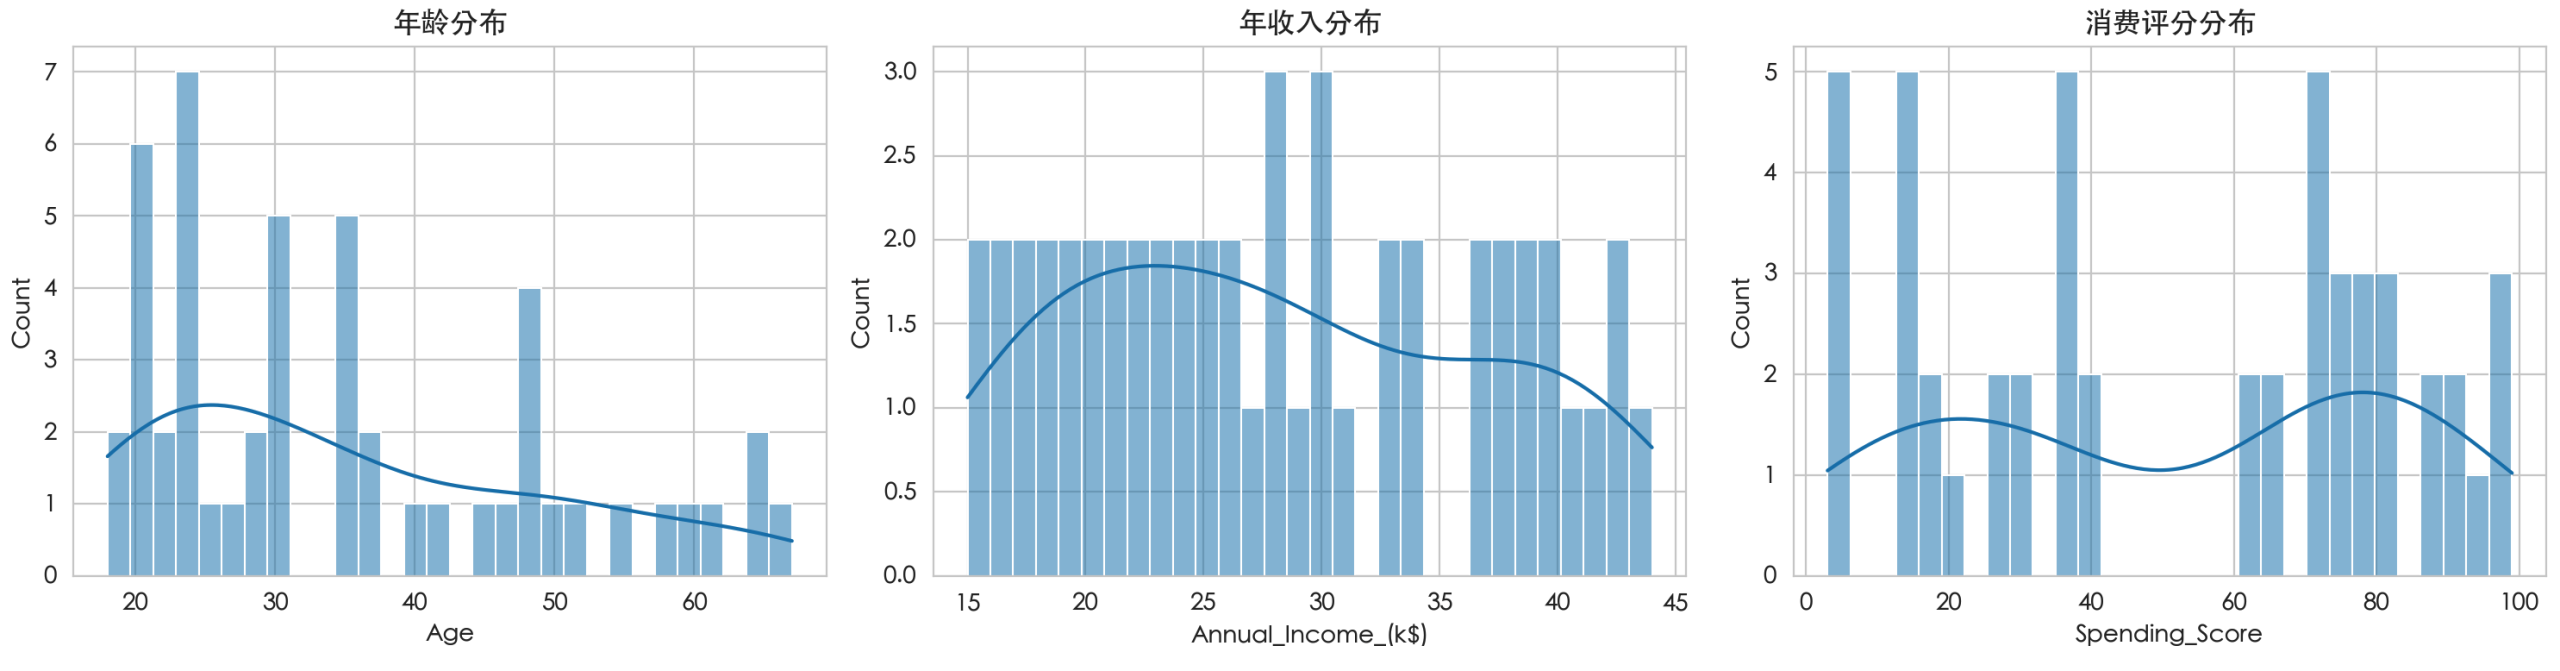
1. Explorative DatenanalyseEntdecken Sie Muster zunächst durch Visualisierung und Statistik.
Beispiel
fig, axes = plt.subplots(1, 3, figsize=(15, 4))
sns.histplot(df['Age'], bins=30, kde=True, ax=axes[0])
axes[0].set_title('Altersverteilung')
sns.histplot(df['Annual_Income_(k$)'], bins=30, kde=True, ax=axes[1])
axes[1].set_title('Verteilung des Jahreseinkommens')
sns.histplot(df['Spending_Score'], bins=30, kde=True, ax=axes[2])
axes[2].set_title('Verteilung des Spending Score')
plt.tight_layout()
plt.show()
# Beziehungen zwischen Merkmalen anzeigen
sns.pairplot(df[['Age', 'Annual_Income_(k$)', 'Spending_Score']])
plt.suptitle('Streudiagramm-Matrix der Merkmalsbeziehungen', y=1.02)
plt.show()
2. DatenvorverarbeitungClustering-Algorithmen sind sehr empfindlich gegenüber der Dimension (Einheiten) von Merkmalen. Die numerischen Wertebereiche von Jahreseinkommen (Zehntausende) und Alter (Zehner) unterscheiden sich stark, was die Distanzberechnung ernsthaft beeinflusst und dazu führt, dass das Einkommensmerkmal die Clustering-Ergebnisse dominiert. Daher müssen wir eineMerkmalsstandardisierung durchführen, die jedes Merkmal auf eine Standardnormalverteilung mit Mittelwert 0 und Varianz 1 skaliert.
Beispiel
features = ['Age', 'Annual_Income_(k$)', 'Spending_Score']
X = df[features].copy()
# Feature-Standardisierung
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # fit berechnet Mittelwert und Varianz, transform wendet die Transformation an
X_scaled_df = pd.DataFrame(X_scaled, columns=features)
print("Erste 5 Zeilen der standardisierten Daten:")
print(X_scaled_df.head())
Schritt 3: Bestimmung der optimalen Anzahl von Clustern (K-Wert)
K-Means erfordert, dass wir den K-Wert im Voraus angeben. Wie wählt man ein sinnvolles K? Wir verwenden zwei klassische Methoden:
1. Ellbogen-MethodeZeichnen Sie die Quadratsumme innerhalb der Cluster (Inertia) für verschiedene K-Werte auf. Inertia nimmt mit steigendem K ab; wir suchen den Wendepunkt der Kurve (wie einen Ellbogen), nach dem der Nutzen (Abnahme der Inertia) durch weiteres Erhöhen von K kleiner wird.
Beispiel
K_range = range(1, 11) # K von 1 bis 10 testen
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto') # n_init='auto' ist eine Verwendung in neueren Versionen
kmeans.fit(X_scaled)
inertia.append(kmeans.inertia_) # Inertia für diesen K-Wert abrufen
# Diagramm der Ellbogenmethode zeichnen
plt.figure(figsize=(8,5))
plt.plot(K_range, inertia, 'bo-')
plt.xlabel('Anzahl der Cluster (K)')
plt.ylabel('Summe der Quadrate innerhalb der Cluster (Inertia)')
plt.title('Ellbogenmethode: Auswahl des besten K-Werts')
plt.xticks(K_range)
plt.show()
2. Silhouette-KoeffizientenmethodeDer Silhouette-Koeffizient misst die Ähnlichkeit eines Datenpunkts zu seinem eigenen Cluster (Kohäsion) und seine Trennung von anderen Clustern. Sein Wert reicht von -1 bis 1,je höher, desto besser, was auf eine bessere Clustering-Leistung hinweist.
Beispiel
K_range = range(2, 11) # Der Silhouette-Koeffizient erfordert mindestens 2 Cluster
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto')
cluster_labels = kmeans.fit_predict(X_scaled)
score = silhouette_score(X_scaled, cluster_labels)
silhouette_scores.append(score)
# Diagramm des Silhouettenkoeffizienten zeichnen
plt.figure(figsize=(8,5))
plt.plot(K_range, silhouette_scores, 'go-')
plt.xlabel('Anzahl der Cluster (K)')
plt.ylabel('Silhouettenkoeffizient')
plt.title('Methode des Silhouettenkoeffizienten: Den besten K-Wert wählen')
plt.xticks(K_range)
plt.show()
Durch Kombination des Diagramms der Ellbogenmethode (Wendepunkt) und des Diagramms des Silhouettenkoeffizienten (Spitze) nehmen wir an und bestimmen, dassK=5eine gute Wahl ist.
Schritt 4: K-Means zum Clustering anwenden
Trainiere das Modell mit dem ausgewählten K-Wert und weise jedem Kunden Cluster-Labels zu.
Beispiel
final_k = 5
kmeans_final = KMeans(n_clusters=final_k, random_state=42, n_init='auto')
df['Cluster'] = kmeans_final.fit_predict(X_scaled) # Cluster-Labels zum ursprünglichen DataFrame hinzufügen
# Anzahl der Kunden in jedem Cluster anzeigen
cluster_counts = df['Cluster'].value_counts().sort_index()
print("Verteilung der Kundenanzahl pro Cluster:")
print(cluster_counts)
# Merkmalsmittelwerte pro Cluster anzeigen (ursprüngliche Skala)
cluster_profile = df.groupby('Cluster')[features].mean().round(2)
print("\nDurchschnittliche Merkmalswerte pro Cluster:)
print(cluster_profile)
Schritt 5: Ergebnisanalyse und Visualisierung
Abstrakte Cluster-Labels in intuitive Erkenntnisse umwandeln.
1. Visualisierung der Clustering-ErgebnisseDa wir drei Merkmale haben, können wir die zwei wichtigsten Merkmale (z. B. Einkommen und Ausgabenbewertung) zur Visualisierung in einer zweidimensionalen Ebene auswählen.
Beispiel
plt.figure(figsize=(10, 6))
scatter = plt.scatter(df['Annual_Income_(k$)'], df['Spending_Score'],
c=df['Cluster'], cmap='viridis', s=50, alpha=0.7)
plt.colorbar(scatter, label='Cluster-Bezeichnung')
plt.xlabel('Jährliches Einkommen (k$)')
plt.ylabel('Ausgabenbewertung')
plt.title('Ergebnisse der Kundensegmentierung (basierend auf jährlichem Einkommen und Ausgabenbewertung)')
plt.show()
2. Kundensegmente profilierenGemäßcluster_profileder Tabelle können wir jedem Cluster eine geschäftliche Bedeutung zuweisen:
| Cluster-Bezeichnung | Alter | Jährliches Einkommen | Ausgaben-Score | Mögliches Kundenprofil |
|---|---|---|---|---|
| 0 | Mittel | Hoch | Niedrig | Vorsichtiger Typ mit hohem Einkommen: Hohes Einkommen, aber konservative Ausgaben; kann Sparer oder vermögende Personen umfassen, die preisempfindlich sind. |
| 1 | Mittel | Niedrig | Niedrig | Typ mit niedrigem Einkommen und geringen Ausgaben: Sowohl Einkommen als auch Kaufkraft sind begrenzt; sie benötigen kosteneffektive Produkte. |
| 2 | Mittel | Niedrig | Hoch | Preis-Leistungs-orientierter Typ: Das Einkommen ist nicht hoch, aber sie geben gern Geld aus; sie schätzen Trends und Erlebnisse und sind Zielgruppe für Werbeaktionen. |
| 3 | Mittel | Hoch | Hoch | Idealer VIP-Typ: Hohes Einkommen und hohe Ausgaben; sie sind die zentrale Profitquelle des Unternehmens und sollten erstklassige Services und exklusive Vorteile erhalten. |
| 4 | Jung | Mittel | Mittel | Junger Potenzialtyp: Junge Kunden, deren Einkommen und Ausgaben im Wachstum begriffen sind; sie sind entscheidend für den Aufbau von Markentreue. |
Schritt 6: Modellbewertung und Anwendungsempfehlungen
Bewertung: Zusätzlich zum Silhouette-Score können Sie prüfen, ob die Stichprobenverteilung innerhalb der Cluster ausgewogen ist, und Geschäftslogik heranziehen, um zu beurteilen, ob die Segmentierung sinnvoll ist.
Anwendungsempfehlungen:
- Präzisionsmarketing: Bewerben Sie hochwertige neue Produkte und exklusive Events für den "Idealen VIP-Typ" (Cluster 3); senden Sie Rabattgutscheine und Informationen zu Gruppenkäufen an den "Preis-Leistungs-orientierten Typ" (Cluster 2).
- Produktentwicklung: Gestalten Sie modische Produkte mit starken sozialen Attributen für den „jungen Potenzialtyp“ (Cluster 4).
- Kundenservice: Stellen Sie dem „einkommensstarken, vorsichtigen Typ“ (Cluster 0) detaillierte Produktdaten und Sicherheitsgarantien bereit, um ihre Bedenken zu zerstreuen.
- Ressourcenzuweisung: Weisen Sie hochwertigen Kundensegmenten mehr Kundenservice- und Marketingressourcen zu.
Zusammenfassung und weiterführende Erkundung
In diesem praktischen Fall haben Sie den Prozess der Kundensegmentierung mit dem K-Means-Algorithmus vollständig erlebt:Datenvorbereitung -> Explorative Analyse -> Vorverarbeitung -> K-Wert bestimmen -> Modell trainieren -> Ergebnisse analysieren。
Zusammenfassung der Kernpunkte:
- Clustering ist eine unüberwachte Lernmethode, die verwendet wird, um inhärente Gruppierungen in Daten zu entdecken.
- Feature-Standardisierungist ein entscheidender Schritt vor der Verwendung distanzbasierter Clustering-Algorithmen.
- EllbogenmethodeundSilhouettenkoeffizientsind praktische Werkzeuge zur Bestimmung der optimalen Anzahl von Clustern.
- Die Interpretation von Clustering-Ergebnissen mussmit Geschäftswissen kombiniert werden, um echten Mehrwert zu schaffen.