Утечка данных
В практике машинного обучения мы часто сталкиваемся с озадачивающим явлением: модель показывает отличные результаты на обучающем и валидационном наборах, все метрики близки к идеальным, но как только она развёртывается в реальной производственной среде, её производительность резко падает и становится почти непригодной для использования. За этим огромным разрывом скрывается один из самых распространённых и опасных невидимых убийц —Утечка данных。
Утечка данных — основная причина провалов проектов машинного обучения. Она подрывает справедливость оценки модели, заставляя нас делать слепо оптимистичные ошибочные суждения о производительности модели. Понимание, выявление и предотвращение утечки данных — это ключевой инженерный навык, которым должен овладеть каждый инженер машинного обучения и специалист по данным.
Эта статья поможет вам системно разобраться в утечке данных, понять её механизмы, изучить методы диагностики и освоить набор эффективных стратегий предотвращения.
Что такое утечка данных?
Основное определение
Утечка данных— это когда в процессе обучения моделинеправомерно используется информация, недоступная в реальных сценариях прогнозирования, из-за чего модель усваивает «будущую информацию» или «глобальную информацию», которую не должна знать, и тем самым демонстрирует чрезмерно оптимистичную, но на самом деле недействительную производительность при оценке.
Проще говоря, это как если бы модель тайком подглядела «ответы» перед «экзаменом». Это позволяет ей получить высокий балл на пробных экзаменах (валидационной выборке), но с треском провалиться на настоящем экзамене, где ответов нет (в производственной среде).
Яркая метафора
Представьте, что вы учите студента распознавать изображения животных.
- Правильный подход: вы показываете ему несколько изображений кошек и собак (обучающая выборка), говорите, где кошки, а где собаки. Затем вы достаёте несколько новых изображений, которых он никогда не видел (тестовая выборка), и просите его определить их.
- Подход с утечкой данных: показывая ему обучающие изображения, вы случайно подмешиваете несколько изображений из тестовой выборки и сообщаете ему ответы. В результате, когда студент сталкивается с действительно «новыми» изображениями, он на самом деле уже давно видел и запомнил ответы. Кажется, что он хорошо выучил материал, но в действительности он не овладел общей способностью «определять животных по признакам»; он лишь запомнил ответы для конкретных изображений.
Распространённые типы и сценарии утечки данных
Утечка данных не всегда очевидна; она часто скрывается в деталях конвейера обработки данных. В основном её можно разделить на следующие две категории:
1. Утечка данных в признаках
Это самый распространённый тип, при котором признаки, используемые для обучения, содержат прямую или косвенную информацию о целевой переменной.
Сценарий 1: использование будущей информации
Это типичная ловушка при прогнозировании временных рядов.
- Неверный пример: Прогнозирование цены акции на завтра, но с использованием индекса тональности новостей за завтра или объёма торгов за завтра в качестве признаков. В реальном прогнозировании вы абсолютно не можете знать эту информацию о завтра заранее.
- Правильный подход: Любой признак должен бытьисторической информацией, известной на момент прогнозирования. Например, для прогноза на завтра можно использовать только исторические цены, новости и т. д. вплоть до сегодняшнего закрытия.
Сценарий 2: Тень целевой переменной
Признаки имеют обратную причинно-следственную связь или высокую корреляцию с целевой переменной.
- Неверный пример: В модели медицинской диагностики использовать признак «принимал ли пациент специальный препарат A», чтобы предсказать, есть ли у пациента заболевание X. Но в реальности только пациентам с диагностированным заболеванием X назначают специальный препарат A. Этот признак почти напрямую раскрывает ответ.
- Неверный пример: В модели прогнозирования оттока пользователя количество недавних обращений клиента в службу поддержки добавляется как признак. Если обращение в службу поддержки является мерой исправления ситуации перед оттоком пользователя, то этот признак содержит информацию о скором оттоке.
Сценарий 3: Неправильная предобработка данных
Вперед разделением обучающей и тестовой выборокбыли выполнены глобальные операции предобработки данных.
- Неверная операция: Сначала нормализовать весь набор данных (вычесть глобальное среднее, разделить на глобальное стандартное отклонение), а затем разделить его на обучающую и тестовую выборки.
- Проблема: Данные тестовой выборки участвуют в вычислении глобального среднего и стандартного отклонения, а это значит, что при обучении модели вы уже «подсмотрели» информацию о распределении тестовой выборки.
- Правильный подход:Сначала разделить, затем предобработать. Вычислите параметры нормализации (среднее, стандартное отклонение) с использованием данных обучающей выборки, затем используйте эти параметры для преобразования обучающей и тестовой выборок.
Пример
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
# Ошибка: обучение на всех данных перед разделением
X_scaled = scaler.fit_transform(X_all)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all, test_size=0.2)
# ----------------------------------------------------------------------
# Правильный подход: сначала разделить, затем обрабатывать отдельно
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# 1. Сначала разделите данные
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 2. Обучите препроцессор только на обучающей выборке
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train) # Вычислите среднее и стандартное отклонение, используя только обучающие данные
# 3. Используйте параметры, полученные на обучающей выборке, для преобразования тестовой выборки
X_test_scaled = scaler.transform(X_test) # Примечание: здесь используется transform, а не fit_transform!
2. Утечка данных в процессе оценки
Этот вид утечки возникает при проектировании процесса обучения и оценки модели, приводя к тому, что модель косвенно контактирует с тестовыми данными во время оценки.
Сценарий 1: Неправильная кросс-валидация
Использование стандартной случайной K-блочной кросс-валидации на данных временных рядов.
Проблема: Случайное перемешивание данных может привести к «использованию будущих данных для обучения модели предсказывать прошлое», что серьёзно нарушает принцип хронологического порядка.
Правильный подход: Используйтекросс-валидацию временных рядов, гарантируя, что обучающий набор всегда предшествует валидационному набору во времени.
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # ... 训练和评估
Сценарий 2: Отбор признаков или настройка гиперпараметров на основе всех данных
Это чрезвычайно распространённая и скрытая ловушка.
Неправильный процесс:
- Используйте все данные для отбора признаков и выберите лучшее подмножество признаков.
- Используйте все данные для поиска по сетке гиперпараметров и найдите оптимальные параметры.
- Примените вышеуказанные «оптимальные» признаки и параметры к модели, а затем снова используйте train_test_split для оценки производительности.
Проблема: В процессе отбора признаков и настройки уже были просмотрены все данные (включая будущий тестовый набор), а выбранные «оптимальные» признаки и параметры являются результатом переобучения на всём наборе данных, что не может отражать его способность к обобщению на новых данных.
Правильный подход: Включите такие шаги, как отбор признаков и настройка гиперпараметров,в качестве части обучения модели, и инкапсулируйте их внутри цикла кросс-валидации. ИспользуйтеPipelineиGridSearchCVчтобы хорошо автоматизировать этот процесс.
Пример
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import SelectKBest
from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestClassifier
# Создайте конвейер: сначала отбор признаков, затем моделирование
pipe = Pipeline([
('selector', SelectKBest()), # Селектор признаков
('classifier', RandomForestClassifier()) # Классификатор
])
# Определите сетку параметров
param_grid = {
'selector__k': [5, 10, 20], # Выберите несколько признаков
'classifier__n_estimators': [50, 100]
}
# Используйте GridSearchCV для настройки с помощью кросс-валидации
# Параметр cv гарантирует, что на каждом фолде кросс-валидации отбор признаков и настройка выполняются только на обучающем фолде
grid_search = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train) # Только на обучающем наборе!
print("Лучшие параметры:", grid_search.best_params_)
print("Лучшая оценка кросс-валидации:", grid_search.best_score_)
# Наконец, оцените на независимом тестовом наборе
final_score = grid_search.score(X_test, y_test)
print("Оценка на независимом тестовом наборе:", final_score)
Как диагностировать утечку данных?
- Предупреждение о разрыве в производительности: Производительность модели на обучающем/валидационном наборе (например, accuracy, AUC) намного выше, чем в реальных бизнес-сценариях или на строго изолированном тестовом наборе; это самый очевидный тревожный сигнал.
- Анализ важности признаков: Изучите признаки, которые модель считает наиболее важными. Если вы обнаружите признак с аномально высокой важностью, и с точки зрения бизнес-логики он не должен обладать такой сильной предсказательной способностью (например, поле ID или поле, содержащее информацию о целевой переменной), утечка весьма вероятна.
- Проверьте корреляцию между признаками и целевой переменной: Вычислите корреляцию между всеми признаками и целевой переменной. Если признак имеет чрезвычайно высокую корреляцию с целевой переменной в обучающем наборе, но это не имеет смысла с точки зрения бизнес-логики, будьте крайне бдительны.
- Проведите "тест на доступность": Перед развёртыванием смоделируйте полностью закрытый тест: обучите на данных из исторического момента времени, предскажите данные за последующий период и сравните с реальными результатами. Это самый эффективный способ обнаружить утечку временных рядов.
- Проверка кода и ретроспектива процесса: Тщательно проверьте весь поток кода предварительной обработки данных, конструирования признаков, обучения и оценки модели, чтобы убедиться в отсутствии операции "сначала загрязнить, потом разделить".
Лучшие практики предотвращения утечки данных
Следуя следующим принципам и процессам, вы сможете в максимальной степени избежать утечки данных:
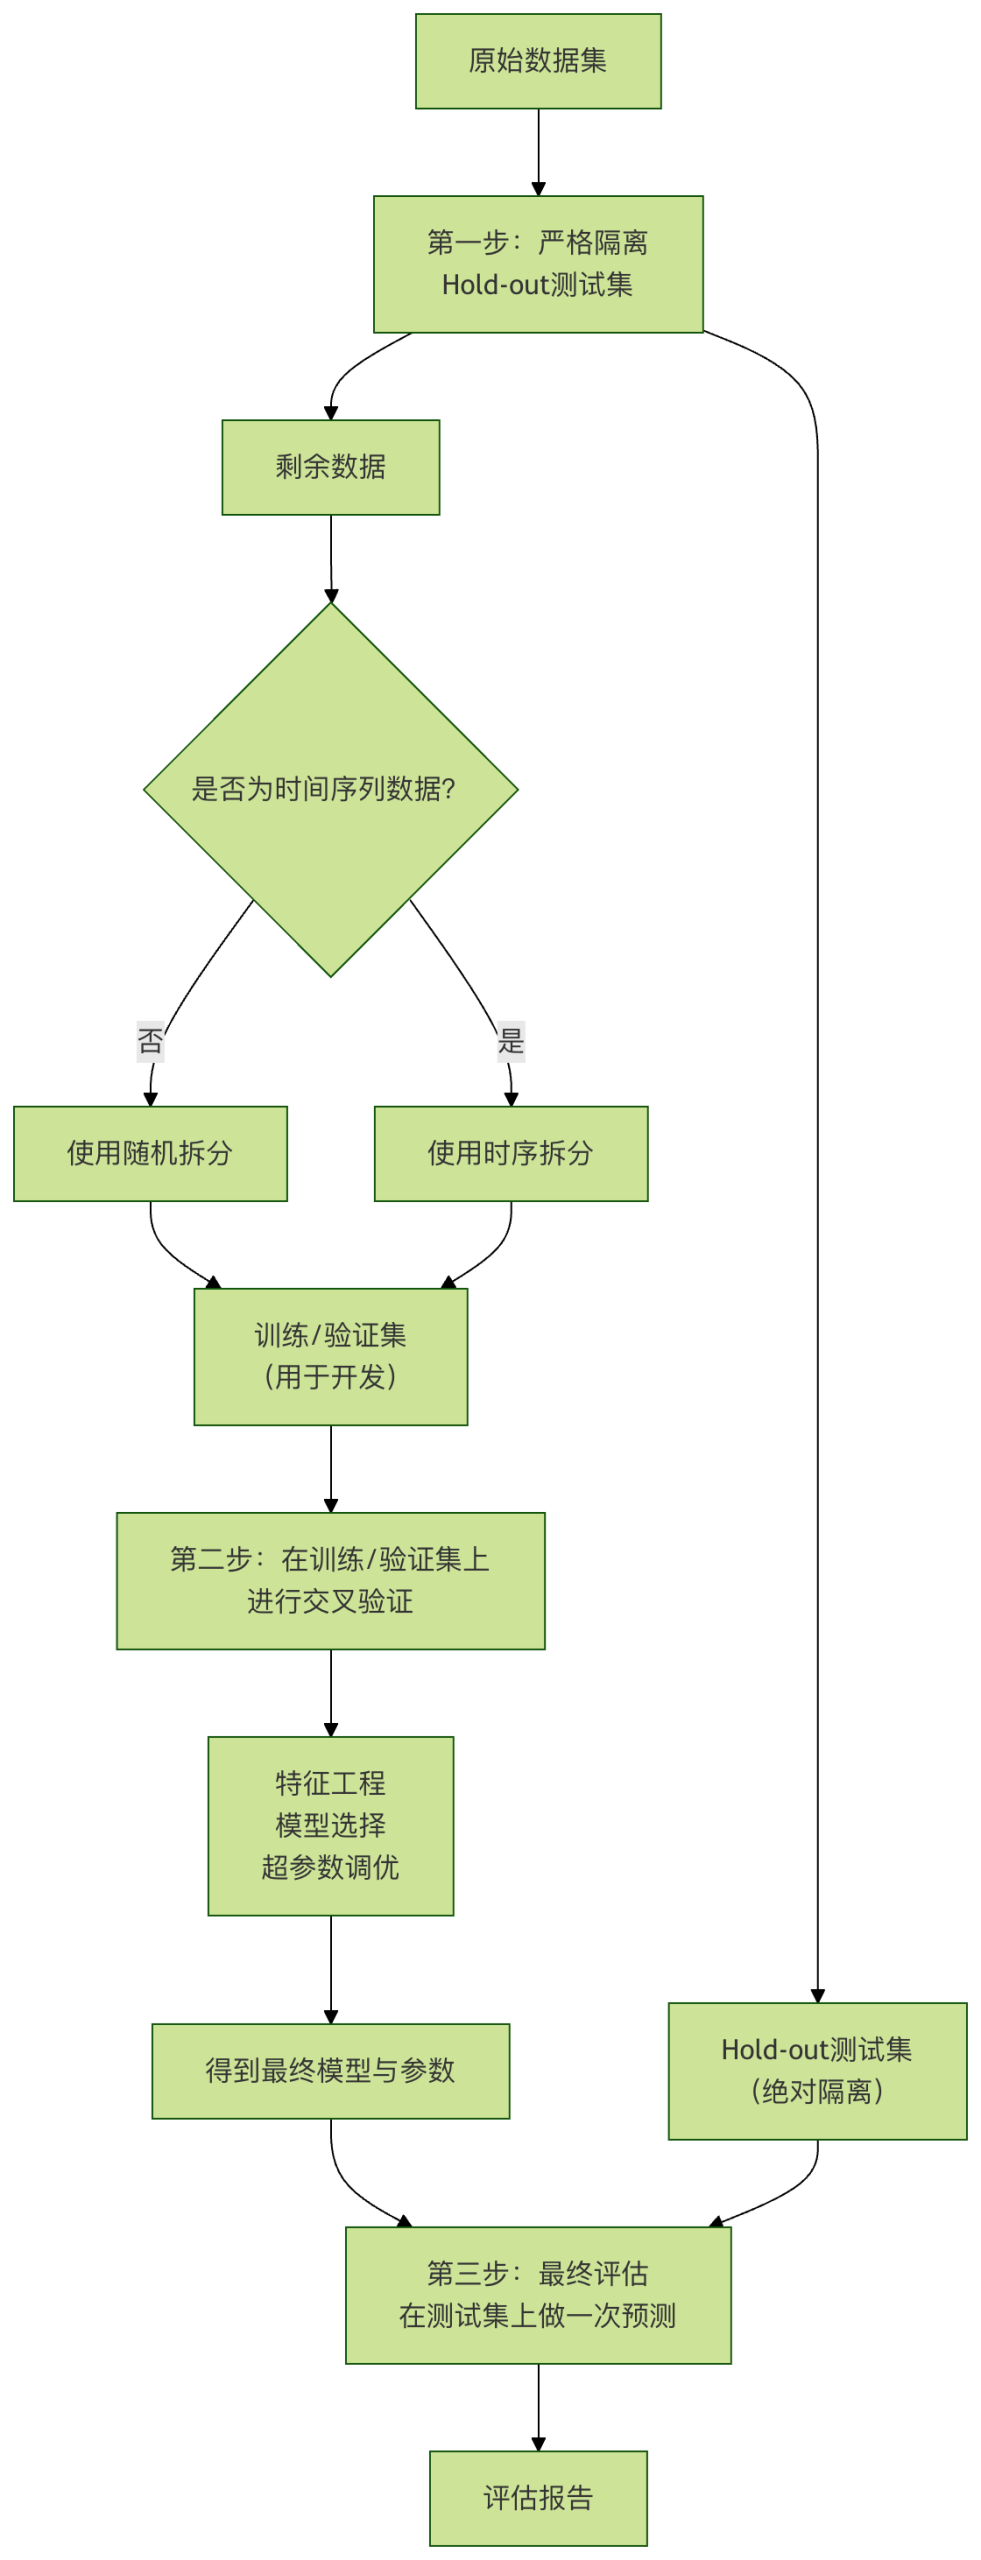
- Сформируйте строгий подход к изоляции данных: В начале проекта сразу, случайным образом (или по времени) отложите часть данных какокончательный тестовый набори заблокируйте его, никогда не используя на протяжении всего цикла разработки модели. Он используется только на финальном этапе оценки модели.
- Следуйте железному правилу "сначала разделить, потом обрабатывать": Любая операция, которая извлекает параметры из данных (нормализация, заполнение пропущенных значений, кодирование и т. д.), должна выполняться только на обучающем наборе, а затем полученные параметры применяются к валидационному и тестовому наборам.
- Используйте Pipeline: Scikit-learn
Pipelineинструменты могут принудительно объединять этапы предварительной обработки и этапы обучения модели вместе, обеспечивая корректное повторное выполнение этапов предварительной обработки во время кросс-валидации. Это мощное оружие против утечки на этапе предварительной обработки. - Сохраняйте благоговейное отношение к временным рядам: При работе с временными данными всегда исходите из того, что "будущее непознаваемо". Используйте кросс-валидацию временных рядов и убедитесь, что все признаки являются лаговыми признаками.
- Глубоко понимайте бизнес-логику: Общайтесь с экспертами в предметной области, чтобы понять истинный смысл и время создания каждого признака. Остерегайтесь признаков, которые имеют обратную причинно-следственную связь с результатом или содержат информацию, полученную после факта.
- Сохраняйте скептический настрой: Если модель показывает нереалистично хорошие результаты (например, точность 99.9%), вашей первой реакцией должно быть "Это утечка данных?", а не празднование успеха.
Итог
Утечка данных — ключевая проблема на пути к инженерии машинного обучения. Это не просто техническая ошибка, а проявление системного изъяна мышления. Чтобы противостоять утечке данных, нам нужно:
- На когнитивном уровне: постоянно сохраняйте бдительность, понимая, что её суть — неправильное использование информации.
- В процессе: установите и соблюдайте строгие стандарты обработки данных и оценки моделей.
- В инструментах: грамотно используйте
Pipeline, правильные методы кросс-валидации и другие инструменты, чтобы построить защитный барьер.