Fuite de données
Dans la pratique de l'apprentissage automatique, nous rencontrons souvent un phénomène déroutant : le modèle a d'excellentes performances sur l'ensemble d'entraînement et l'ensemble de validation, avec toutes les métriques proches de la perfection, mais une fois déployé dans un véritable environnement de production, ses performances chutent brutalement et deviennent presque inutilisables. Derrière cet écart énorme, l'un des tueurs invisibles les plus courants et les plus dangereux estFuite de données。
La fuite de données est une cause majeure d'échecs de projets d'apprentissage automatique. Elle compromet l'équité de l'évaluation des modèles, ce qui nous conduit à porter des jugements erronés aveuglément optimistes sur les performances des modèles. Comprendre, identifier et prévenir la fuite de données est une compétence d'ingénierie essentielle que chaque ingénieur en apprentissage automatique et chaque data scientist doit maîtriser.
Cet article vous guidera pour comprendre systématiquement la fuite de données, appréhender ses mécanismes, apprendre des méthodes de diagnostic et maîtriser un ensemble de stratégies de prévention efficaces.
Qu'est-ce que la fuite de données ?
Définition principale
La fuite de donnéesdésigne, pendant le processus d'entraînement du modèle,l'utilisation inappropriée d'informations indisponibles dans des scénarios de prédiction réels, ce qui amène le modèle à apprendre des « informations futures » ou des « informations globales » qu'il ne devrait pas connaître, produisant ainsi des performances trop optimistes mais en réalité invalides lors de la validation.
En termes simples, c'est comme si le modèle avait secrètement jeté un coup d'œil aux « réponses » avant l'« examen ». Cela lui permet d'obtenir de bons résultats aux examens blancs (ensemble de validation), mais d'échouer lamentablement au véritable examen où il n'y a pas de réponses (environnement de production).
Une métaphore imagée
Imaginez que vous appreniez à un élève à reconnaître des images d'animaux.
- L'approche correcte: Vous lui montrez quelques images de chats et de chiens (ensemble d'entraînement), vous lui dites lesquelles sont des chats et lesquelles sont des chiens. Ensuite, vous sortez de nouvelles images qu'il n'a jamais vues (ensemble de test) et vous lui demandez de les identifier.
- L'approche avec fuite de données: Pendant que vous lui montrez des images d'entraînement, vous mélangez accidentellement certaines images de l'ensemble de test et vous lui donnez les réponses. Par conséquent, lorsque l'élève est confronté à des images véritablement « nouvelles », il a en fait déjà vu et mémorisé les réponses depuis longtemps. Il semble avoir bien appris, mais en réalité il n'a pas acquis la capacité générale d'« identifier des animaux à partir de leurs caractéristiques » ; il a seulement mémorisé les réponses pour des images spécifiques.
Types et scénarios courants de fuite de données
La fuite de données n'est pas toujours évidente ; elle se cache souvent dans les détails du pipeline de traitement des données. On peut principalement la diviser en deux catégories :
1. Fuite de données dans les caractéristiques
C'est le type le plus courant, où les caractéristiques utilisées pour l'entraînement contiennent des informations directes ou indirectes sur la variable cible.
Scénario 1 : Utilisation d'informations futures
C'est un piège typique dans la prévision de séries temporelles.
- Exemple incorrect: Prédire le prix d'une action demain, mais utiliser l'indice de sentiment des actualités de demain ou le volume d'échanges de demain comme caractéristiques. Dans une prédiction réelle, vous ne pouvez absolument pas connaître ces informations sur demain à l'avance.
- Approche correcte: Toute caractéristique doit êtreune information historique connue au moment de la prédiction. Par exemple, vous ne pouvez utiliser que les prix historiques, les actualités, etc. jusqu'à la clôture d'aujourd'hui pour prédire demain.
Scénario 2 : Ombre de la variable cible
Les caractéristiques ont une causalité inversée ou une forte corrélation avec la variable cible.
- Exemple incorrect: Dans un modèle de diagnostic médical, utiliser une caractéristique « le patient a-t-il pris le médicament spécial A » pour prédire si le patient a la maladie X. Mais en réalité, seuls les patients diagnostiqués avec la maladie X se voient prescrire le médicament spécial A. Cette caractéristique révèle presque directement la réponse.
- Exemple incorrect: Dans un modèle prédisant si un utilisateur va résilier, le nombre de fois que le client a récemment contacté le support est ajouté comme caractéristique. Si le fait de contacter le support est une mesure corrective avant le départ de l'utilisateur, alors cette caractéristique contient des informations sur un départ imminent.
Scénario 3 : Prétraitement des données inadéquat
DansAvant de diviser l'ensemble d'entraînement et l'ensemble de test, des opérations globales de prétraitement des données ont été effectuées.
- Opération incorrecte: D'abord normaliser l'ensemble du jeu de données (soustraire la moyenne globale, diviser par l'écart-type global), puis le diviser en ensemble d'entraînement et ensemble de test.
- Le problème: Les données de l'ensemble de test participent au calcul de la moyenne globale et de l'écart-type global, ce qui signifie que lors de l'entraînement du modèle, vous avez déjà « jeté un coup d'œil » aux informations de distribution de l'ensemble de test.
- Approche correcte:: Diviser d'abord, puis prétraiter. Calculer les paramètres de normalisation (moyenne, écart-type) à l'aide des données de l'ensemble d'entraînement, puis utiliser ces paramètres pour transformer l'ensemble d'entraînement et l'ensemble de test.
Exemple
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
# Erreur : Ajustement sur l'ensemble des données avant la séparation
X_scaled = scaler.fit_transform(X_all)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all, test_size=0.2)
# ----------------------------------------------------------------------
# Approche correcte : diviser d'abord, puis traiter séparément
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# 1. Diviser d'abord les données
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 2. Ajuster le préprocesseur uniquement sur l'ensemble d'entraînement
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train) # Calculer la moyenne et l'écart-type uniquement à partir des données d'entraînement
# 3. Utiliser les paramètres obtenus à partir de l'ensemble d'entraînement pour transformer l'ensemble de test
X_test_scaled = scaler.transform(X_test) # Remarque : ici, c'est transform, pas fit_transform !
2. Fuite de données dans le processus d'évaluation
Ce type de fuite se produit dans la conception du processus d'entraînement et d'évaluation du modèle, ce qui amène le modèle à entrer indirectement en contact avec les données de test lors de l'évaluation.
Scénario 1 : Validation croisée incorrecte
Utilisation d'une validation croisée K-fold aléatoire standard sur des données de séries temporelles.
Problème: le mélange aléatoire des données peut entraîner « l'utilisation de données futures pour entraîner un modèle à prédire le passé », ce qui viole gravement le principe d'ordre chronologique.
Approche correcte: utilisezla validation croisée de séries temporelles, en garantissant que l'ensemble d'entraînement précède toujours l'ensemble de validation dans le temps.
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # ... 训练和评估
Scénario 2 : sélection de caractéristiques ou réglage des hyperparamètres basé sur toutes les données
Il s'agit d'un piège extrêmement courant et caché.
Processus incorrect:
- Utiliser toutes les données pour effectuer une sélection de caractéristiques et choisir le meilleur sous-ensemble de caractéristiques.
- Utiliser toutes les données pour effectuer une recherche par grille des hyperparamètres et trouver les paramètres optimaux.
- Appliquer les caractéristiques et paramètres « optimaux » ci-dessus au modèle, puis utiliser à nouveau train_test_split pour évaluer les performances.
Le problème: le processus de sélection de caractéristiques et de réglage a déjà vu toutes les données (y compris l'ensemble de test futur), et les caractéristiques et paramètres « optimaux » sélectionnés sont le résultat d'un surapprentissage sur l'ensemble du jeu de données, ce qui ne peut pas représenter sa capacité de généralisation sur de nouvelles données.
Approche correcte: intégrez des étapes telles que la sélection de caractéristiques et le réglage des hyperparamètresdans le cadre de l'entraînement du modèle, et encapsulez-les à l'intérieur de la boucle de validation croisée. UtilisezPipelineetGridSearchCVpour automatiser efficacement ce processus.
Exemple
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import SelectKBest
from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestClassifier
# Créer un pipeline : d'abord la sélection de caractéristiques, puis la modélisation
pipe = Pipeline([
('selector', SelectKBest()), # Sélecteur de caractéristiques
('classifier', RandomForestClassifier()) # Classifieur
])
# Définir la grille de paramètres
param_grid = {
'selector__k': [5, 10, 20], # Sélectionner quelques caractéristiques
'classifier__n_estimators': [50, 100]
}
# Utiliser GridSearchCV pour le réglage par validation croisée
# Le paramètre cv garantit que dans chaque pli de validation croisée, la sélection de caractéristiques et le réglage ne sont effectués que sur le pli d'entraînement
grid_search = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train) # Uniquement effectué sur l'ensemble d'entraînement !
print("Meilleurs paramètres :", grid_search.best_params_)
print("Meilleur score de validation croisée :", grid_search.best_score_)
# Enfin, évaluer sur l'ensemble de test indépendant
final_score = grid_search.score(X_test, y_test)
print("Score sur l'ensemble de test indépendant :", final_score)
Comment diagnostiquer une fuite de données ?
- Avertissement sur l'écart de performance: La performance du modèle sur l'ensemble d'entraînement/validation (par ex., exactitude, AUC) est bien supérieure à sa performance dans des scénarios métier réels ou sur un ensemble de test strictement isolé ; c'est le signal d'alarme le plus évident.
- Analyse de l'importance des caractéristiques: Examinez les caractéristiques que le modèle considère comme les plus importantes. Si vous trouvez une caractéristique avec une importance anormalement élevée et que, d'un point de vue logique métier, elle ne devrait pas avoir un tel pouvoir prédictif (par ex., un champ ID, ou un champ contenant des informations sur la cible), une fuite est très probable.
- Vérifiez la corrélation entre les caractéristiques et la cible: Calculez la corrélation entre toutes les caractéristiques et la variable cible. Si une caractéristique présente une corrélation extrêmement élevée avec la cible dans l'ensemble d'entraînement, mais que cela n'a pas de sens d'un point de vue logique métier, soyez très vigilant.
- Effectuez un « test de disponibilité »: Avant le déploiement, simulez un test complètement hermétique : entraînez le modèle avec des données d'un point historique dans le temps, prédisez les données d'une période ultérieure et comparez avec les résultats réels. C'est le moyen le plus efficace de détecter une fuite de séries temporelles.
- Revue de code et rétrospective de processus: Examinez attentivement l'ensemble du flux de code de prétraitement des données, d'ingénierie des caractéristiques, d'entraînement du modèle et d'évaluation afin de garantir qu'il n'y ait aucune opération « contaminer d'abord, diviser ensuite ».
Bonnes pratiques pour prévenir la fuite de données
En suivant les principes et processus suivants, vous pouvez éviter dans la plus large mesure possible la fuite de données :
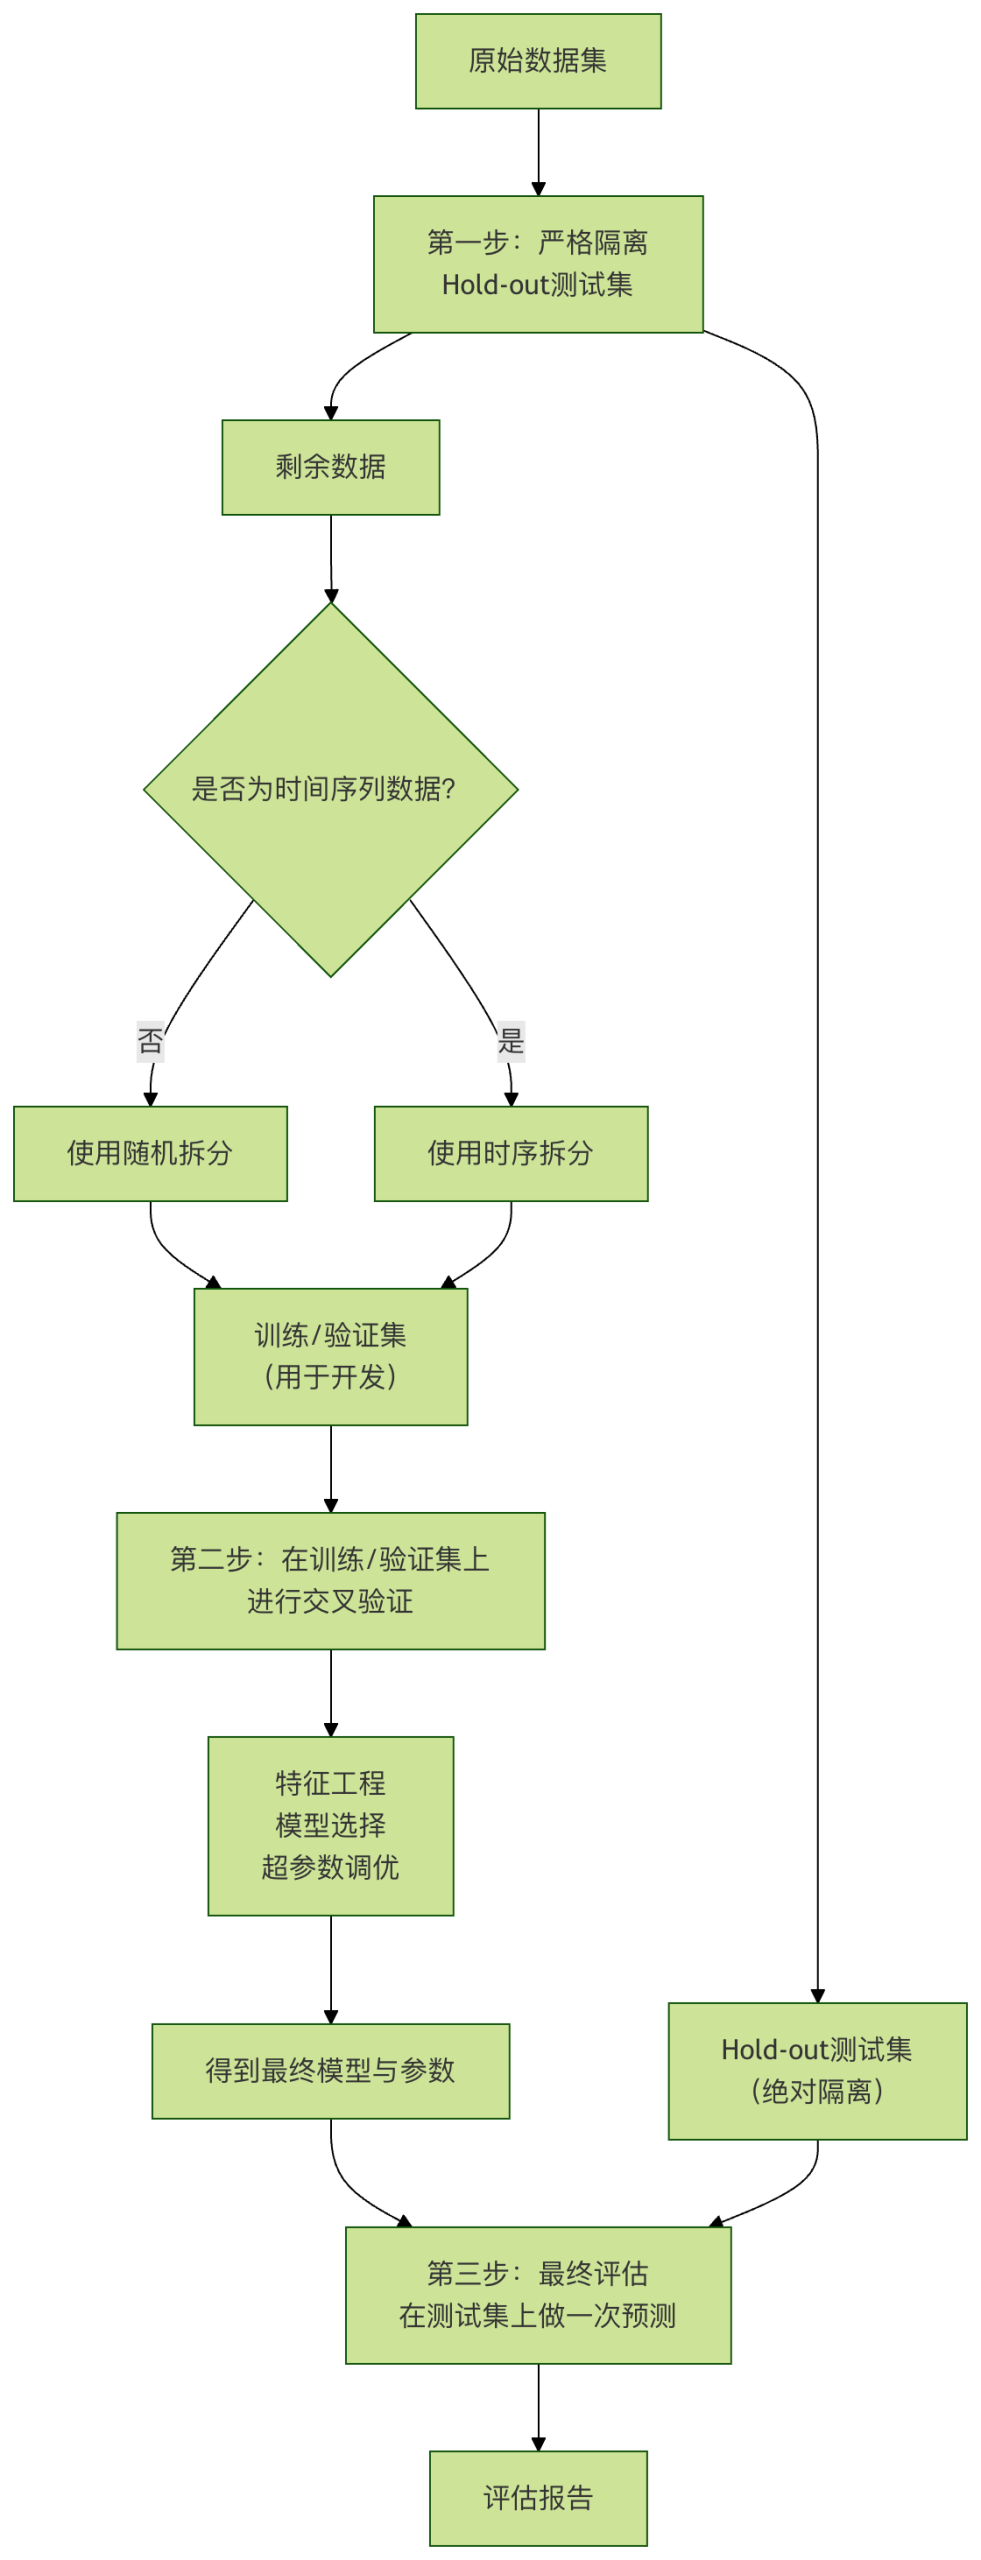
- Adoptez un état d'esprit strict d'isolation des données: Au début du projet, mettez immédiatement de côté, de manière aléatoire (ou selon le temps), une partie des données commeensemble de test final, et verrouillez-la, sans jamais l'utiliser tout au long du cycle de développement du modèle. Elle n'est utilisée que pour l'étape finale de l'évaluation du modèle.
- Respectez la règle d'airain « diviser d'abord, puis traiter »: Toute opération qui apprend des paramètres à partir des données (normalisation, remplissage des valeurs manquantes, encodage, etc.) ne doit être effectuée que sur l'ensemble d'entraînement, puis les paramètres appris sont appliqués aux ensembles de validation et de test.
- Utilisez Pipeline: les
Pipelineoutils de Scikit-learn peuvent regrouper de force les étapes de prétraitement et les étapes d'entraînement du modèle, garantissant que les étapes de prétraitement sont correctement réexécutées lors de la validation croisée. Ils constituent une arme puissante contre la fuite de prétraitement. - Gardez une certaine révérence pour les séries temporelles: Lorsque vous traitez des données temporelles, supposez toujours que « l'avenir est inconnaissable ». Utilisez la validation croisée pour séries temporelles et assurez-vous que toutes les caractéristiques sont des caractéristiques retardées.
- Comprenez profondément la logique métier: Communiquez avec des experts du domaine pour comprendre la signification réelle et le moment de génération de chaque caractéristique. Méfiez-vous des caractéristiques qui ont une relation causale inversée avec le résultat ou qui contiennent des informations a posteriori.
- Adoptez une attitude sceptique: Si un modèle obtient des performances irréalistes (par exemple, une précision de 99.9%), votre première réaction devrait être « s'agit-il d'une fuite de données ? » plutôt que de célébrer un succès.
Résumé
La fuite de données est un défi majeur sur le chemin de l'ingénierie de l'apprentissage automatique. Ce n'est pas seulement un bug technique, mais la manifestation d'un défaut de réflexion systémique. Pour lutter contre la fuite de données, nous devons :
- Sur le plan cognitif: rester vigilant à tout moment, en comprenant que son essence est l'utilisation inappropriée de l'information.
- Dans le processus: établir et respecter des normes strictes de traitement des données et d'évaluation des modèles.
- Dans les outils: bien utiliser
Pipeline, des méthodes de validation croisée correctes et d'autres outils pour construire un pare-feu.