データリーク
機械学習の実践では、しばしば困惑させる現象に遭遇します。モデルがトレーニングセットと検証セットでは優れた性能を示し、各指標がほぼ完璧に近いのに、実際の本番環境にデプロイすると、性能が急激に低下し、ほぼ使えなくなります。この大きなギャップの背後に潜む、最も一般的で危険な目に見えない原因こそ、データリーク。
データリークは機械学習プロジェクトが失敗する主な原因の一つであり、モデル評価の公平性を損ない、モデルの性能に対して盲目的に楽観的な誤判断を引き起こします。データリークを理解し、特定し、防ぐことは、すべての機械学習エンジニアとデータサイエンティストが習得すべき中核的なエンジニアリングスキルです。
本記事では、データリークを体系的に理解し、その発生メカニズムを理解し、診断方法を学び、効果的な予防戦略を習得します。
データリークとは?
中核定義
データリークとは、モデル学習プロセスにおいて、実際の予測シナリオでは入手できない情報を不適切に使用することですその結果、モデルが本来知るべきではない「未来情報」や「全体情報」を学習してしまい、評価時には過度に楽観的でありながら実際には無効な性能を示すことになります。
簡単に言えば、モデルが「試験」の前にこっそり「解答」を見てしまうようなものです。これにより、模擬試験(検証セット)では高得点を取れますが、答えのない実際の試験(本番環境)では大失敗します。
わかりやすい比喩
あなたが学生に動物の画像を識別させることを教えていると想像してください。
- 正しい方法: 猫と犬の画像(トレーニングセット)を見せて、どれが猫でどれが犬かを教えます。その後、彼が見たことのない新しい画像(テストセット)を出して、識別させます。
- データリークのやり方トレーニング画像を見せるときに、誤ってテストセットの画像も混ぜてしまい、しかも答えを教えてしまったとします。その結果、その学生は本当の「新しい」画像に直面したとき、実はすでに見たことがあり答えを覚えていました。彼はうまく学んでいるように見えても、実際には「特徴から動物を識別する」という汎用のな能力を習得しておらず、特定の画像の答えを覚えただけなのです。
データリークの一般的な種類とシナリオ
データリークは常に一目でわかるわけではなく、データ処理プロセスの細部に隠れていることがよくあります。主に以下の2つのカテゴリに分類できます。
1. 特徴量におけるデータリーク
これは最も一般的なタイプで、学習に使用される特徴量に目的変数に関する直接的または間接的な情報が含まれているものです。
シナリオ1: 未来情報の使用
これは時系列予測における典型的な罠です。
- 誤った例: 明日の株価を予測するのに、特徴量として明日のニュース感情指数や明日の取引量を使用します。実際の予測時には、明日のこれらの情報を事前に知ることは絶対にできません。
- 正しい方法: あらゆる特徴量は予測時点で既知の履歴情報である必要があります。例えば、今日の終値までの過去の価格やニュースなどだけを使って明日を予測します。
シナリオ2: 目的変数の影
特徴量と目的変数の間に因果の逆転や高い関連性が存在します。
- 誤った例医療診断モデルで、「特効薬Aを服用したかどうか」という特徴量を使って病気Xに罹患しているかどうかを予測します。しかし実際には、病気Xと診断された患者にのみ特効薬Aは処方されます。この特徴量はほぼ直接のに答えを明かしています。
- 誤った例: ユーザーが離脱するかどうかを予測するモデルに、顧客が最近カスタマーサポートに連絡した回数を追加します。カスタマーサポートへの連絡がユーザー離脱前の挽回措置であるなら、この特徴量には離脱間近の情報が含まれています。
シナリオ3: データ前処理の不適切さ
にトレーニングセットとテストセットを分割する前にグローバルなデータ前処理操作を行った。
- 誤った操作: 最初にデータセット全体に対して正規化(全体平均を引き、全体標準偏差で割る)を行い、その後でトレーニングセットとテストセットに分割します。
- 問題点: テストセットのデータが全体平均と標準偏差の計算に加わっており、モデルを学習する時点でテストセットの分布情報を「覗き見て」しまったことになります。
- 正しい方法:先に分割し、それから前処理を行う。トレーニングセットのデータを使って正規化パラメータ(平均、標準偏差)を計算し、そのパラメータでトレーニングセットとテストセットを変換します。
実例
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
2. 評価プロセスにおけるデータリーク
X_scaled = scaler.fit_transform(X_all)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all, test_size=0.2)
# ----------------------------------------------------------------------
この種のリークはモデルの学習と評価のフロー設計で発生し、モデルが評価プロセス中に間接的にテストデータに触れることになります。
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
シナリオ1: 誤った交差検証
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
時系列データに対して標準的なランダムK分割交差検証を使用します。
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train) 問題
: データをランダムにシャッフルすると、「未来のデータでモデルを学習して過去を予測する」という状況を引き起こし、時間の順序の原則に深刻に違反します。
X_test_scaled = scaler.transform(X_test) 正しい方法
2. 評価プロセスにおけるデータリーク
時系列交差検証
であり、トレーニングセットの時間が常に検証セットより前にあることを保証します。
シナリオ2: 全データに基づいて特徴量選択やハイパーパラメータ調整を行う
これは極めて一般的で見えにくい罠です。誤ったフロー
全データを使って特徴量選択を行い、最良の特徴量サブセットを選び出します。全データを使ってハイパーパラメータのグリッドサーチを行い、最適なパラメータを見つけます。上記の「最適な」特徴量とパラメータをモデルに使用し、もう一度 train_test_split を使って性能を評価します。問題点
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # ... 训练和评估
: 特徴量選択とチューニングのプロセスがすでに全データ(将来のテストセットを含む)を見ており、選ばれた「最適な」特徴量とパラメータはデータセット全体に対して過学習した結果であり、新しいデータへの汎化能力を表すものではありません。
正しい方法
: 特徴量選択やハイパーパラメータ調整などのステップを:
- モデル学習の一部として
- 、交差検証ループの内部に組み込んで実行します。使用することで
- このプロセスをうまく自動化できます。
実例# 正しい方法:PipelineとGridSearchCVを使用してリークを防ぐ # パイプラインを作成:最初に特徴量選択、次にモデル構築 # 特徴量セレクタ # 分類器 # パラメータグリッドを定義 # いくつかの特徴量を選択 # GridSearchCVを使用して交差検証でチューニング # cvパラメータにより、各交差検証フォールドで、特徴量選択とチューニングがトレーニングフォールドでのみ行われることを保証 # トレーニングセットでのみ実行! "最適なパラメータ:" "交差検証の最良スコア:" # 最後に独立したテストセットで評価 "独立テストセットのスコア:"
データリークを診断するには?性能ギャップの警告: モデルのトレーニング/検証セットでの性能(精度、AUCなど)が、実際のビジネスシナリオや厳密に隔離されたテストセットでの性能よりもはるかに高い場合、これが最も明らかな危険信号です。特徴量重要性の分析PipelineとGridSearchCV: モデルが最も重要だと判断した特徴量を確認します。ある特徴量の重要度が異常に高く、ビジネスロジック上それほど強い予測力を持つべきではない場合(例えばIDフィールドや目的変数の情報を含むフィールド)、リークが存在する可能性が高いです。
実例
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import SelectKBest
from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestClassifier
「可用性テスト」を実施する
pipe = Pipeline([
('selector', SelectKBest()), デプロイ前に、完全に閉じたテストをシミュレーションします。過去のある時点のデータで学習し、その後の一定期間のデータを予測して、実際の結果と比較します。これは時系列リークを検証する最も効果のな方法です。
('classifier', RandomForestClassifier()) コードレビューとフローの振り返り
])
: データ前処理、特徴量エンジニアリング、モデル学習と評価のコードフロー全体を注意深く確認し、「先に汚染、後に分割」という操作がないことを保証します。
param_grid = {
'selector__k': [5, 10, 20], データリークを防ぐためのベストプラクティス
'classifier__n_estimators': [50, 100]
}
以下の原則とフローに従うことで、データリークを最大限に防ぐことができます:
厳格なデータ分離の考え方を確立する
grid_search = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train) : プロジェクト開始時に、すぐに、ランダムに(または時間順に)一部のデータを
print(最終テストセット, grid_search.best_params_)
print("交叉验证最佳分数:", grid_search.best_score_)
# 最終のに独立したテストセット上で評価する
final_score = grid_search.score(X_test, y_test)
print("独立测试集分数:", final_score)
データリークを診断する方法は?
- 性能落差の警告:モデルがトレーニング/検証セット上での性能(正確率、AUCなど)が、実際のビジネスシーンや厳格に隔離されたテストセット上での性能よりもはるかに高い場合、これは最も明確なレッドフラッグである。
- 特徴量重要度分析:モデルが最も重要だと考える特徴を確認する。ある特徴の重要度が異常に高く、かつビジネスロジック上それほど強い予測力を持つべきではない場合(例えばIDフィールドや、ターゲット情報を含むフィールド)、リークが存在する可能性が高い。
- 特徴とターゲットの相関を確認する:すべての特徴量と目的変数の相関を計算する。ある特徴量がトレーニングセット上で目的変数との相関が異常に高いが、ビジネスロジック上説明がつかない場合、十分に警戒する必要がある。
- 「ユーザビリティテスト」を実施する:デプロイ前に、完全に閉じたテストをシミュレーションする。過去のある時点のデータでトレーニングし、その後の期間のデータを予測し、実際の結果と比較する。これは時系列リークを検証する最も効果的な方法である。
- コードレビューとプロセスの振り返り:データ前処理、特徴エンジニアリング、モデルトレーニング、評価のコードフロー全体を注意深く確認し、「先に汚染し、後に分割する」操作がないことを確実にする。
データリークを防ぐためのベストプラクティス
以下の原則とプロセスに従うことで、データリークを最大限に回避できる:
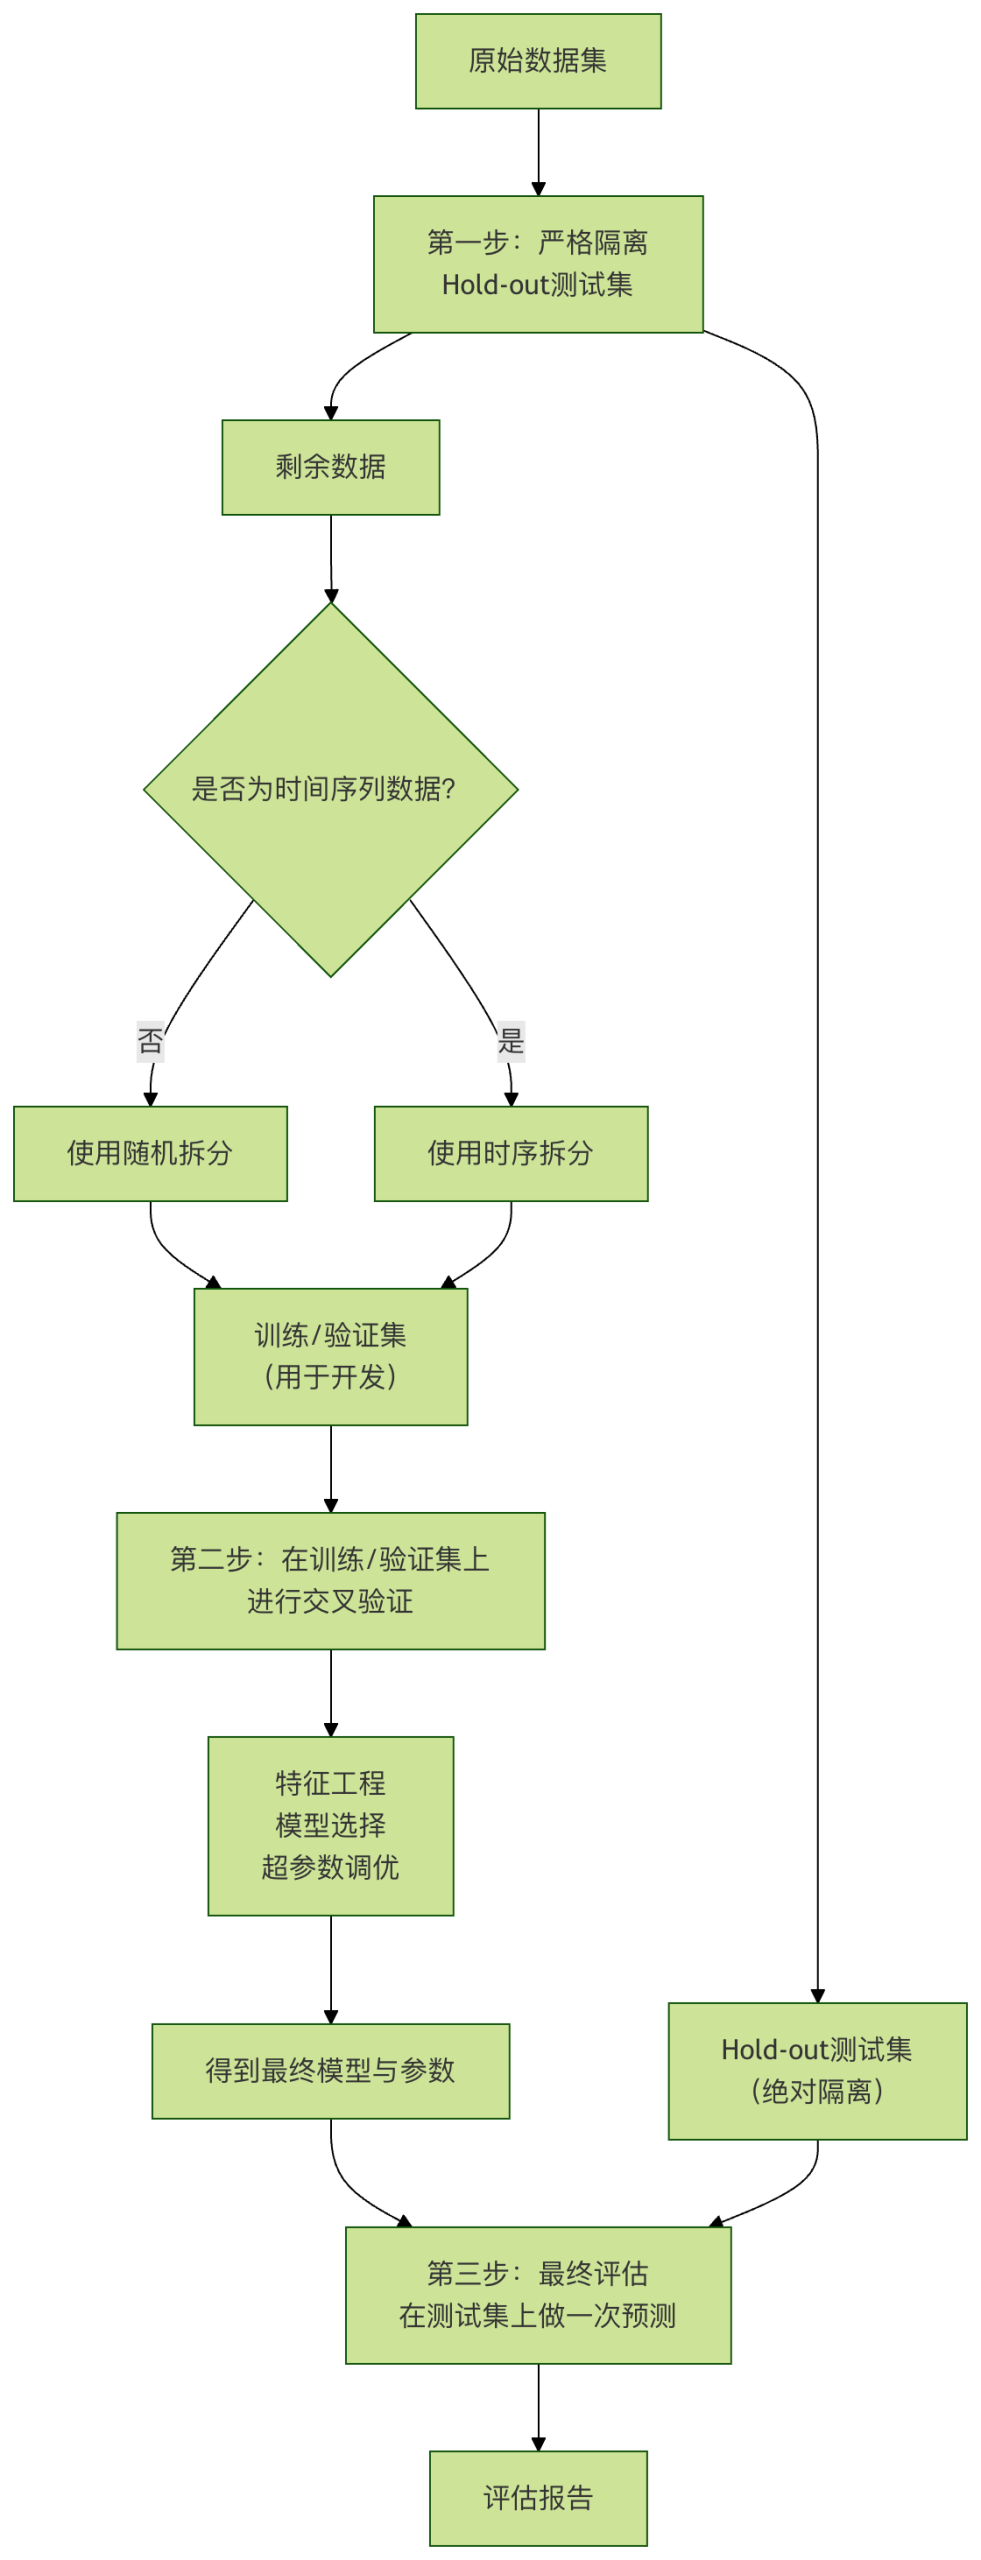
- 厳格なデータ分離の考え方を確立する。:プロジェクト開始時に、直ちにランダムに(または時間順に)一部のデータを分割して、最终测试集、それをロックし、モデル開発サイクル全体で決して使用しない。それは最後のステップのモデル評価にのみ使用する。
- 「先に分割し、後で処理する」という鉄則を守る:データからパラメータを学習する操作(正規化、欠損値の補完、エンコーディングなど)は、すべてトレーニングセットに対してのみ行い、学習したパラメータを検証セットとテストセットに適用しなければならない。
- Pipeline を使用する:Scikit-learn の
Pipelineツールは前処理ステップとモデルトレーニングステップを強制的にバンドルし、交差検証時に前処理ステップが正しく繰り返し実行されることを保証する、前処理リークを防ぐための強力なツールである。 - 時系列データに対して畏敬の念を抱く:時間データを扱うときは、常に「未来は未知である」と仮定する。時系列交差検証を使用し、すべての特徴量がラグ特徴量であることを確認する。
- ビジネスロジックを深く理解する:ドメイン専門家とコミュニケーションを取り、各特徴量の本当の意味と生成時間を理解する。結果と因果関係が逆転している特徴量や、事後情報を含む特徴量に注意する。
- 懐疑的な態度を保つ:モデルの性能が現実離れしている場合(例えば精度99.9%)、最初の反応は「データリークしていないか?」であるべきで、成功を祝うことではない。
まとめ
データリークは機械学習の実用化への道における重要な課題である。それは単なる技術的なバグではなく、システム思考の欠陥の現れでもある。データリークに対抗するには、以下が必要である:
- 認知面では:常に警戒心を保ち、その本質が情報の不適切な使用であることを理解する。
- プロセス面では:厳格なデータ処理とモデル評価の規範を確立し、遵守する。
- ツール面では:うまく活用する
Pipeline、適切な交差検証方法などのツールを活用してファイアウォールを構築する。