Fuga de datos
En la práctica del aprendizaje automático, a menudo nos encontramos con un fenómeno desconcertante: el modelo se desempeña de manera excelente en el conjunto de entrenamiento y en el de validación, con todos los indicadores casi perfectos, pero una vez desplegado en un entorno de producción real, su rendimiento cae en picado y se vuelve casi inutilizable. Detrás de esta enorme brecha, el asesino invisible más común y peligroso esla fuga de datos。
La fuga de datos es una de las principales causas de fracaso en los proyectos de aprendizaje automático. Destruye la imparcialidad de la evaluación del modelo y nos lleva a un juicio erróneo de optimismo ciego sobre el rendimiento del modelo. Comprender, identificar y prevenir la fuga de datos es una habilidad de ingeniería esencial que todo ingeniero de aprendizaje automático y científico de datos debe dominar.
Este artículo te llevará a comprender sistemáticamente la fuga de datos, entender su mecanismo de ocurrencia, aprender métodos de diagnóstico y dominar un conjunto de estrategias de prevención eficaces.
¿Qué es la fuga de datos?
Definición principal
La fuga de datos, se refiere a que durante el entrenamiento del modelo,se utiliza de manera inapropiada información que no estaría disponible en el escenario de predicción real,, lo que hace que el modelo aprenda "información futura" o "información global" que no debería conocer, lo que a su vez genera un rendimiento demasiado optimista pero realmente ineficaz durante la evaluación.
En términos simples, el modelo ha visto a escondidas las "respuestas" antes del "examen". Esto le permite obtener puntuaciones altas en el examen de práctica (conjunto de validación), pero fracasar estrepitosamente en el examen real, sin respuestas (entorno de producción).
Una metáfora ilustrativa
Imagina que estás enseñando a un estudiante a reconocer imágenes de animales.
- El método correcto: le muestras algunas imágenes de gatos y perros (conjunto de entrenamiento), le dices cuáles son gatos y cuáles son perros. Luego, sacas algunas imágenes nuevas que nunca ha visto (conjunto de prueba) y le pides que las identifique.
- La práctica con fuga de datos: mientras le muestras las imágenes de entrenamiento, sin querer mezclas algunas imágenes del conjunto de prueba y le das las respuestas. Como resultado, cuando el estudiante se enfrenta a imágenes realmente "nuevas", en realidad ya las ha visto y recuerda las respuestas. Parece que ha aprendido bien, pero en realidad no ha adquirido la capacidad general de "identificar animales según sus características"; solo ha memorizado las respuestas de imágenes específicas.
Tipos y escenarios comunes de fuga de datos
La fuga de datos no siempre es obvia; a menudo se esconde en los detalles del flujo de procesamiento de datos. Principalmente se puede dividir en las siguientes dos categorías:
1. Fuga de datos en las características
Este es el tipo más común: las características utilizadas para el entrenamiento contienen información directa o indirecta sobre la variable objetivo.
Escenario 1: Uso de información futura
Esta es una trampa típica en la predicción de series temporales.
- Ejemplo incorrecto: predecir el precio de una acción para mañana, pero se utilizan como características el índice de sentimiento de las noticias de mañana o el volumen de operaciones de mañana. En una predicción real, de ninguna manera puedes conocer esa información de mañana por adelantado.
- El método correcto: cualquier característica debe serinformación histórica conocida en el momento de la predicción. Por ejemplo, solo se pueden usar los precios históricos de cierre hasta hoy, noticias, etc., para predecir mañana.
Escenario 2: La sombra de la variable objetivo
Las características tienen una relación causal invertida o una alta correlación con la variable objetivo.
- Ejemplo incorrecto: en un modelo de diagnóstico médico, se usa una característica llamada 'si ya se ha tomado el medicamento específico A' para predecir si se padece la enfermedad X. Pero en realidad, solo a los pacientes diagnosticados con la enfermedad X se les prescribe el medicamento específico A. Esta característica casi revela directamente la respuesta.
- Ejemplo incorrecto: en un modelo para predecir si un usuario abandonará el servicio, se incluye el número de veces que el cliente contactó al servicio de atención al cliente más recientemente. Si contactar al servicio es una medida de retención antes del abandono, esta característica contiene información sobre el abandono inminente.
Escenario 3: Preprocesamiento de datos inadecuado
EnAntes de dividir el conjunto de entrenamiento y el de pruebase realizaron operaciones de preprocesamiento de datos globales.
- Operación incorrecta: primero se normaliza todo el conjunto de datos (restando la media global y dividiendo por la desviación estándar global), y luego se dividen el conjunto de entrenamiento y el de prueba.
- El problema: los datos del conjunto de prueba participan en el cálculo de la media y la desviación estándar globales, lo que significa que, al entrenar el modelo, ya se ha "espiado" la información de distribución del conjunto de prueba.
- El método correcto:Dividir primero y preprocesar después. Calcular los parámetros de normalización (media, desviación estándar) con los datos del conjunto de entrenamiento, y luego usar estos parámetros para transformar el conjunto de entrenamiento y el de prueba.
Ejemplo
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
# Error: ajustar a todos los datos antes de dividir
X_scaled = scaler.fit_transform(X_all)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_all, test_size=0.2)
# ----------------------------------------------------------------------
# Método correcto: dividir primero y luego procesar por separado
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# 1. Primero dividir los datos
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 2. Ajustar el preprocesador solo en el conjunto de entrenamiento
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train) # Calcular la media y la desviación estándar solo con los datos de entrenamiento
# 3. Transformar el conjunto de prueba usando los parámetros obtenidos del conjunto de entrenamiento
X_test_scaled = scaler.transform(X_test) # Nota: aquí se usa transform, ¡no fit_transform!
2. Fuga de datos durante la evaluación
Este tipo de fuga ocurre en el diseño del flujo de entrenamiento y evaluación del modelo, lo que hace que el modelo entre en contacto indirecto con los datos de prueba durante la evaluación.
Escenario 1: Validación cruzada incorrecta
Usar la validación cruzada estándar de K pliegues aleatorios en datos de series temporales.
Problema: barajar los datos aleatoriamente provoca la situación de "entrenar el modelo con datos futuros para predecir el pasado", lo que viola gravemente el principio de orden temporal.
El método correcto: usarvalidación cruzada temporal, asegurando que el tiempo del conjunto de entrenamiento siempre sea anterior al del conjunto de validación.
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
    X_train, X_test = X[train_index], X[test_index]
    y_train, y_test = y[train_index], y[test_index]
    # ... 训练和评估
Escenario 2: Realizar selección de características o ajuste de hiperparámetros con todos los datos
Esta es una trampa extremadamente común y oculta.
Flujo incorrecto:
- Usar todos los datos para la selección de características y elegir el mejor subconjunto de características.
- Usar todos los datos para la búsqueda en cuadrícula de hiperparámetros y encontrar los parámetros óptimos.
- Aplicar las características y parámetros "óptimos" anteriores al modelo, y luego usar train_test_split una vez más para evaluar el rendimiento.
El problema: el proceso de selección de características y ajuste ya ha visto todos los datos (incluido el conjunto de prueba futuro), y las características y parámetros "óptimos" seleccionados son el resultado de un sobreajuste a todo el conjunto de datos, por lo que no pueden representar su capacidad de generalización en datos nuevos.
El método correcto: incluir pasos como la selección de características y el ajuste de hiperparámetroscomo parte del entrenamiento del modeloy realizarlos dentro del bucle de validación cruzada. El uso dePipelineyGridSearchCVun pipeline puede automatizar muy bien este proceso.
Ejemplo
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import SelectKBest
from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestClassifier
# Crear el pipeline: primero selección de características, luego modelado
pipe = Pipeline([
('selector', SelectKBest()), # Selector de características
('classifier', RandomForestClassifier()) # Clasificador
])
# Definir la cuadrícula de parámetros
param_grid = {
'selector__k': [5, 10, 20], # Seleccionar varias características
'classifier__n_estimators': [50, 100]
}
# Usar GridSearchCV para el ajuste mediante validación cruzada
# El parámetro cv garantiza que en cada pliegue de la validación cruzada, la selección de características y el ajuste se realicen solo en el fold de entrenamiento
grid_search = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy')
grid_search.fit(X_train, y_train) # ¡Solo hacerlo en el conjunto de entrenamiento!
print("Mejores parámetros:", grid_search.best_params_)
print("Mejor puntuación de validación cruzada:", grid_search.best_score_)
# Evaluar finalmente en el conjunto de prueba independiente
final_score = grid_search.score(X_test, y_test)
print("Puntuación en el conjunto de prueba independiente:", final_score)
¿Cómo diagnosticar la fuga de datos?
- Advertencia de brecha de rendimiento: el rendimiento del modelo en el conjunto de entrenamiento/validación (como exactitud, AUC) es mucho mayor que en el escenario comercial real o en el conjunto de prueba estrictamente aislado. Esta es la señal de alerta más evidente.
- Análisis de importancia de las características: revisa las características que el modelo considera más importantes. Si se descubre que alguna característica tiene una importancia anormalmente alta y, desde la lógica del negocio, no debería tener tanto poder predictivo (por ejemplo, un campo de ID o un campo que contenga información del objetivo), es muy probable que exista una fuga.
- Comprobar la correlación entre características y objetivo: calcular la correlación entre todas las características y la variable objetivo. Si una característica tiene una correlación extremadamente alta con el objetivo en el conjunto de entrenamiento, pero no tiene sentido desde la lógica del negocio, se debe estar muy alerta.
- Realizar una "prueba de usabilidad": antes del despliegue, simula una prueba completamente cerrada: entrena con datos de un punto histórico en el tiempo, predice los datos de un período posterior y compara con los resultados reales. Este es el método más eficaz para detectar fugas en series temporales.
- Revisión de código y revisión del flujo de trabajo: revisa cuidadosamente todo el flujo de código de preprocesamiento de datos, ingeniería de características, entrenamiento y evaluación del modelo, para asegurarse de que no haya operaciones de "contaminar primero, dividir después".
Mejores prácticas para prevenir la fuga de datos
Siguiendo los siguientes principios y flujos, se puede evitar al máximo la fuga de datos:
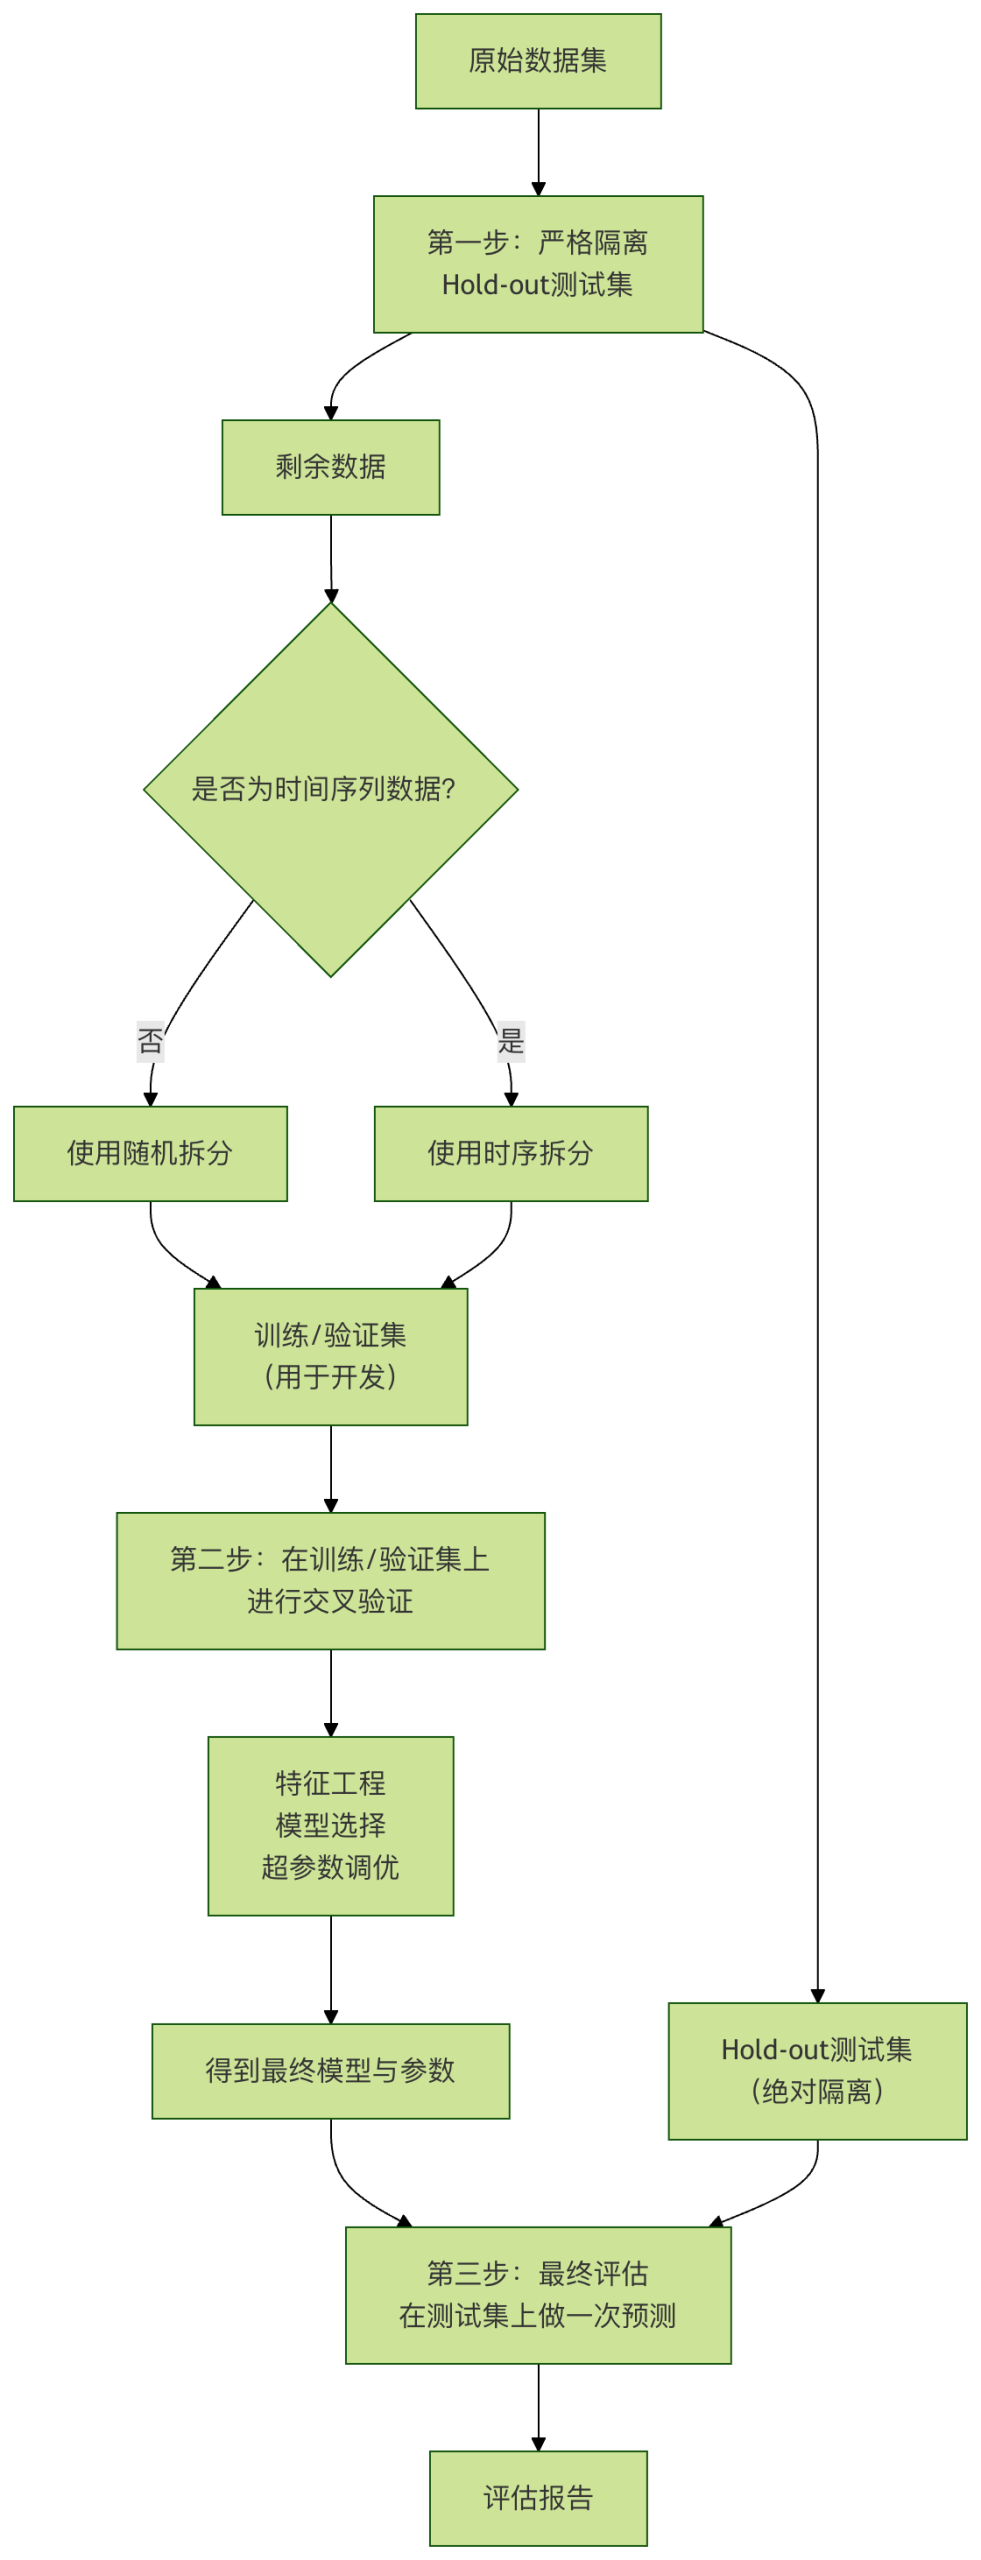
- Establecer una estricta mentalidad de aislamiento de datos: al inicio del proyecto, separa de inmediato, de manera aleatoria (o según el tiempo), una parte de los datos comoconjunto de prueba final, y bloquearlo, sin usarlo jamás durante todo el ciclo de desarrollo del modelo. Solo se utiliza para la evaluación final del modelo.
- Sigue la regla de hierro de "primero dividir, luego procesar": Cualquier operación que aprenda parámetros de los datos (normalización, imputación de valores faltantes, codificación, etc.) debe realizarse únicamente sobre el conjunto de entrenamiento, y luego aplicar los parámetros aprendidos al conjunto de validación y al conjunto de prueba.
- Usar Pipeline: de Scikit-learn
PipelineLas herramientas que integran forzosamente los pasos de preprocesamiento con el entrenamiento del modelo, garantizando que el preprocesamiento se repita correctamente durante la validación cruzada, son un arma eficaz para prevenir la fuga de preprocesamiento. - Mantén reverencia por las series temporales: Al procesar datos temporales, asume siempre que «el futuro es impredecible». Utiliza validación cruzada temporal y asegúrate de que todas las características sean características rezagadas.
- Comprende profundamente la lógica del negocio: comunícate con expertos del dominio, comprende el significado real y el momento de generación de cada característica. Desconfía de aquellas características que tengan una relación de causalidad invertida con el resultado o que contengan información posterior a los hechos.
- Mantén una actitud escéptica: Si el rendimiento de un modelo es irrealmente bueno (por ejemplo, una precisión del 99,9 %), tu primera reacción debería ser «¿hay una fuga de datos?», en lugar de celebrar el éxito.
Resumen
La fuga de datos es un desafío clave en el camino hacia la ingeniería del aprendizaje automático. No es solo un bug técnico, sino la manifestación de una laguna en el pensamiento sistémico. Para combatir la fuga de datos, necesitamos:
- A nivel cognitivo: Mantener siempre la vigilancia y comprender que su esencia es el uso indebido de la información.
- En el proceso: Establecer y cumplir normas estrictas de procesamiento de datos y evaluación de modelos.
- En las herramientas: aprovechar
Pipeliney usar métodos correctos de validación cruzada y otras herramientas para construir un cortafuegos.