Algorithme des k plus proches voisins
L'algorithme des K plus proches voisins (KNN) est un algorithme simple et couramment utilisé de classification et de régression.
L'algorithme des K plus proches voisins est un type d'apprentissage supervisé. Son idée centrale est de calculer la distance entre l'échantillon à classer et chaque échantillon de l'ensemble d'entraînement, de trouver les K échantillons ayant la plus petite distance, puis de prédire la classe ou la valeur de l'échantillon cible en fonction des classes ou des valeurs de ces K échantillons.
Principes de base de KNN
Les principes de base de l'algorithme KNN peuvent être résumés par les étapes suivantes :
- Calculer la distance: Calculer la distance entre l'échantillon à classer et chaque échantillon de l'ensemble d'entraînement. Les métriques de distance courantes incluent la distance euclidienne, la distance de Manhattan, etc.
- Sélectionner les K plus proches voisins: En fonction des distances calculées, sélectionner les K échantillons ayant la plus petite distance.
- Vote ou moyenne: Pour les problèmes de classification, la classe qui apparaît le plus fréquemment parmi les K plus proches voisins est la classe de l'échantillon cible ; pour les problèmes de régression, la valeur moyenne des K plus proches voisins est la valeur de l'échantillon cible.
Caractéristiques de KNN
- Simple et facile à comprendre: Le principe de l'algorithme KNN est très simple, facile à comprendre et à implémenter.
- Aucun entraînement requis: KNN est un algorithme d'« apprentissage paresseux » qui ne nécessite pas de processus d'entraînement explicite ; tous les calculs sont effectués au moment de la prédiction.
- Aucune hypothèse sur la distribution des données: KNN ne fait aucune hypothèse sur la distribution des données, ce qui le rend adapté à divers types de données.
- Complexité calculatoire élevée: Comme KNN doit calculer les distances à tous les échantillons au moment de la prédiction, la complexité calculatoire devient élevée lorsque l'ensemble de données est grand.
Avantages et inconvénients de l'algorithme KNN
Avantages
- Simple et facile à utiliser: L'algorithme KNN est simple dans son principe et facile à comprendre et à implémenter.
- Aucun entraînement requis: KNN ne nécessite pas de processus d'entraînement explicite ; tous les calculs sont effectués au moment de la prédiction.
- Adapté à la classification multiclasse: KNN peut facilement gérer les problèmes de classification multiclasse.
Inconvénients
- Complexité calculatoire élevée: KNN doit calculer les distances à tous les échantillons au moment de la prédiction, et la complexité calculatoire est élevée lorsque l'ensemble de données est grand.
- Sensible au bruit: KNN est relativement sensible aux données bruitées, ce qui peut affecter les résultats de prédiction.
- Nécessité de choisir une valeur K appropriée: Le choix de la valeur K affecte grandement les performances du modèle, et sélectionner une valeur K appropriée est un défi.
Étapes d'implémentation de l'algorithme KNN
1. Importer les bibliothèques nécessaires
Tout d'abord, nous devons importer quelques bibliothèques Python courantes, telles quenumpypour le calcul numérique,matplotlibpour le traçage,sklearnpour charger des jeux de données et évaluer des modèles.
Exemple
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2. Charger le jeu de données
Nous utilisonssklearnfromload_irisfonction pour charger le jeu de données Iris classique. Ce jeu de données contient 150 échantillons, chacun avec 4 caractéristiques, et l'objectif est de classer les échantillons en 3 classes.
Exemple
iris = datasets.load_iris()
X = iris.data[:, :2] # Prendre uniquement les deux premières caractéristiques pour la visualisation
y = iris.target
3. Prétraitement des données
Avant d’appliquer l’algorithme KNN, il est généralement nécessaire de standardiser les données pour garantir que chaque caractéristique contribue de manière égale au calcul de la distance.
Exemple
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Entraîner le modèle KNN
Ensuite, nous utilisonssklearnfromKNeighborsClassifierpour entraîner le modèle KNN. Ici, nous choisissons K=3, c’est-à-dire que nous sélectionnons les 3 voisins les plus proches.
Exemple
knn = KNeighborsClassifier(n_neighbors=3)
# Entraîner le modèle
knn.fit(X_train, y_train)
5. Prédiction et évaluation
Utilisez le modèle entraîné pour effectuer des prédictions sur l’ensemble de test et calculer la précision du modèle.
Exemple
y_pred = knn.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision du modèle KNN : {accuracy:.4f}")
La sortie est la suivante :
KNN模型的准确率: 0.7556
6. Visualiser les résultats de classification KNN
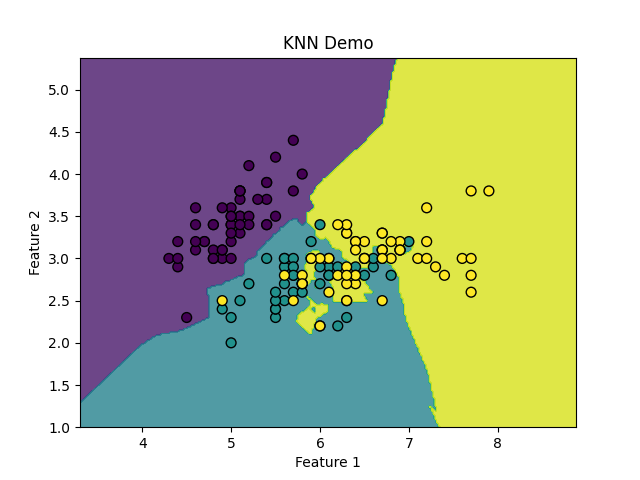
Pour comprendre plus intuitivement l’effet de classification de KNN, nous pouvons tracer les points de données et les frontières de décision.
Ici, nous utilisons les deux premières caractéristiques de l’ensemble de données comme caractéristiques d’entrée.
Exemple
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
# Charger le jeu de données Iris
iris = datasets.load_iris()
X = iris.data[:, :2] # Prendre uniquement les deux premières caractéristiques pour la visualisation
y = iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer le modèle KNN, définir la valeur de K à 3
knn = KNeighborsClassifier(n_neighbors=3)
# Entraîner le modèle
knn.fit(X_train, y_train)
# Prédire sur l'ensemble de test
y_pred = knn.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision du modèle KNN : {accuracy:.4f}")
# Tracer la frontière de décision et les points de données
h = .02 # Taille du pas du maillage
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
# Créer une grille maillée 2D représentant différents espaces d’échantillons
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
# Utiliser le modèle KNN pour prédire la classe de chaque point de la grille
Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Tracer la frontière de décision
plt.contourf(xx, yy, Z, alpha=0.8)
# Tracer les points de données d’entraînement
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o', s=50)
plt.title("KNN Demo")
plt.xlabel("Caractéristique 1")
plt.ylabel("Caractéristique 2")
plt.show()
L'affichage est le suivant :
7. Ajuster la valeur de K
Le choix de la valeur de K a un impact important sur les performances du modèle.
Nous choisissons généralement la meilleure valeur de K via des méthodes de validation croisée ou de visualisation.
Exemple
k_range = range(1, 21)
accuracies = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
accuracies.append(accuracy)
# Tracer la relation entre la valeur de K et la précision
plt.plot(k_range, accuracies, marker='o')
plt.title("Relation entre la valeur de K et la précision")
plt.xlabel("Valeur de K")
plt.ylabel("Précision")
plt.show()
8. Utilisation de KNN pour les tâches de régression
KNN peut également être utilisé pour les tâches de régression (régression KNN).
Dans les tâches de régression, KNN prédit la sortie en faisant la moyenne des valeurs cibles des K plus proches voisins.
Exemple
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
# Générer des données d'exemple
X = np.random.rand(100, 1) * 10
y = np.sin(X).ravel() + 0.1 * np.random.randn(100)
# Diviser en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer un modèle de régression KNN
knn_reg = KNeighborsRegressor(n_neighbors=5)
# Entraîner le modèle
knn_reg.fit(X_train, y_train)
# Prédire sur l'ensemble de test
y_pred = knn_reg.predict(X_test)
# Visualiser les résultats de régression
plt.scatter(X_test, y_test, color='red', label='Valeurs réelles')
plt.scatter(X_test, y_pred, color='blue', label='Valeurs prédites')
plt.title("Régression KNN")
plt.xlabel("Caractéristique")
plt.ylabel("Cible")
plt.legend()
plt.show()
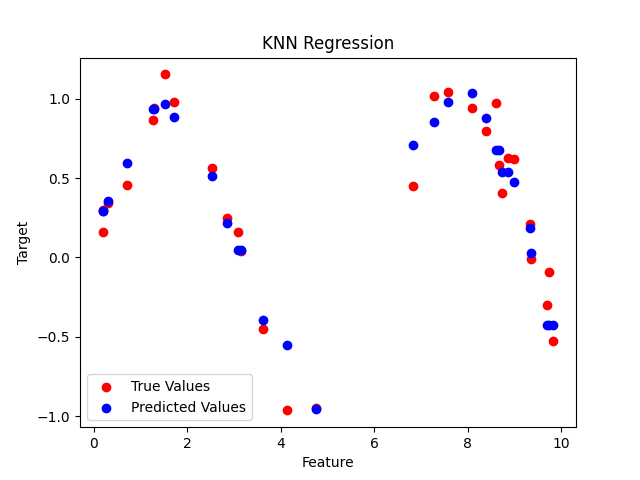
Le rouge indique les valeurs réelles, le bleu indique les valeurs prédites :