Algoritmo de K vecinos más cercanos
El algoritmo de K vecinos más cercanos (K-Nearest Neighbors, abreviado KNN) es un algoritmo de clasificación y regresión simple y de uso común.
El algoritmo de K vecinos más cercanos es un tipo de aprendizaje supervisado. Su idea central es calcular la distancia entre la muestra a clasificar y cada muestra del conjunto de entrenamiento, encontrar las K muestras más cercanas y, luego, predecir la categoría o el valor de la muestra a clasificar según las categorías o valores de estas K muestras.
Fundamentos del algoritmo KNN
El principio básico del algoritmo KNN se puede resumir en los siguientes pasos:
- Calcular la distanciaCalcular la distancia entre la muestra a clasificar y cada muestra del conjunto de entrenamiento. Los métodos de medición de distancia más comunes incluyen la distancia euclidiana, la distancia de Manhattan, etc.
- Seleccionar los K vecinos más cercanosSegún las distancias calculadas, seleccionar las K muestras más cercanas.
- Votación o promedioPara problemas de clasificación, la categoría que aparece con más frecuencia entre los K vecinos más cercanos es la categoría de la muestra a clasificar; para problemas de regresión, el promedio de los valores de los K vecinos más cercanos es el valor de la muestra a clasificar.
Características de KNN
- Simple y fácil de entenderEl principio del algoritmo KNN es muy simple, fácil de entender e implementar.
- No requiere entrenamientoKNN es un algoritmo de "aprendizaje perezoso" (lazy learning), no necesita un proceso de entrenamiento explícito; todos los cálculos se realizan en el momento de la predicción.
- Sin suposiciones sobre la distribución de los datosKNN no hace ninguna suposición sobre la distribución de los datos, por lo que es adecuado para varios tipos de datos.
- Alta complejidad computacionalDebido a que KNN necesita calcular la distancia de todas las muestras al predecir, cuando el conjunto de datos es grande, la complejidad computacional es alta.
Ventajas y desventajas del algoritmo KNN
Ventajas
- Simple y fácil de usarEl principio del algoritmo KNN es simple, fácil de entender e implementar.
- No requiere entrenamientoKNN no requiere un proceso de entrenamiento explícito; todos los cálculos se realizan en el momento de la predicción.
- Adecuado para problemas de clasificación múltipleKNN puede manejar fácilmente problemas de clasificación múltiple.
Desventajas
- Alta complejidad computacionalKNN necesita calcular la distancia de todas las muestras al predecir; cuando el conjunto de datos es grande, la complejidad computacional es alta.
- Sensible al ruidoKNN es bastante sensible a los datos ruidosos; los datos ruidosos pueden afectar los resultados de la predicción.
- Necesidad de elegir un valor K apropiadoLa elección del valor K tiene una gran influencia en el rendimiento del modelo; elegir un valor K adecuado es un desafío.
Pasos para implementar el algoritmo KNN
1. Importar las bibliotecas necesarias
Primero, necesitamos importar algunas bibliotecas comunes de Python, comonumpypara el cálculo numérico,matplotlibpara la generación de gráficos,sklearnpara cargar conjuntos de datos y evaluar modelos.
Ejemplo
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2. Cargar el conjunto de datos
Usamossklearndeload_irisLa función carga el clásico conjunto de datos de iris. Este conjunto de datos contiene 150 muestras, cada muestra tiene 4 características, y el objetivo es clasificar las muestras en 3 categorías.
Ejemplo
iris = datasets.load_iris()
X = iris.data[:, :2] # Tomar solo las dos primeras características para facilitar la visualización
y = iris.target
3. Preprocesamiento de datos
Antes de aplicar el algoritmo KNN, generalmente es necesario estandarizar los datos para garantizar que cada característica contribuya de manera equitativa al cálculo de la distancia.
Ejemplo
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Entrenar el modelo KNN
A continuación, usamossklearndeKNeighborsClassifierpara entrenar el modelo KNN. Aquí elegimos K=3, es decir, seleccionamos los 3 vecinos más cercanos.
Ejemplo
knn = KNeighborsClassifier(n_neighbors=3)
# Entrenar el modelo
knn.fit(X_train, y_train)
5. Predicción y evaluación
Usar el modelo entrenado para predecir el conjunto de prueba y calcular la precisión (accuracy) del modelo.
Ejemplo
y_pred = knn.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo KNN: {accuracy:.4f}")
La salida es la siguiente:
KNN模型的准确率: 0.7556
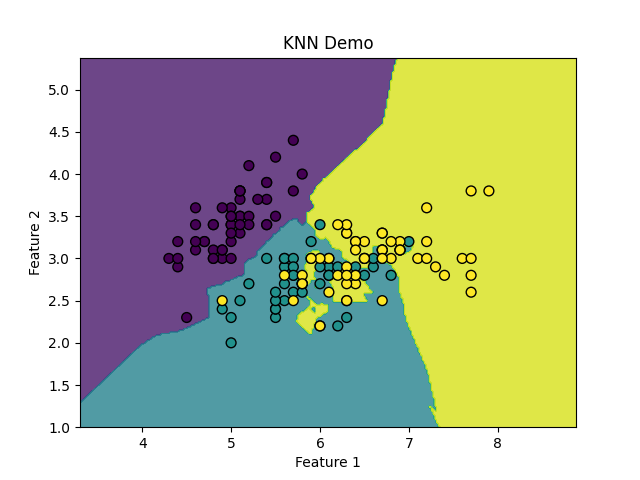
6. Visualización de los resultados de clasificación de KNN
Para comprender de manera más intuitiva el efecto de clasificación de KNN, podemos dibujar los puntos de datos y el límite de decisión.
Aquí utilizaremos las dos primeras características del conjunto de datos como características de entrada.
Ejemplo
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
# Cargar el conjunto de datos Iris
iris = datasets.load_iris()
X = iris.data[:, :2] # Tomar solo las dos primeras características para facilitar la visualización
y = iris.target
# Dividir el conjunto de datos en conjunto de entrenamiento y conjunto de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el modelo KNN, establecer el valor de K en 3
knn = KNeighborsClassifier(n_neighbors=3)
# Entrenar el modelo
knn.fit(X_train, y_train)
# Realizar predicciones sobre el conjunto de prueba
y_pred = knn.predict(X_test)
# Calcular la precisión
accuracy = accuracy_score(y_test, y_pred)
print(f"Precisión del modelo KNN: {accuracy:.4f}")
# Dibujar el límite de decisión y los puntos de datos
h = .02 # Tamaño del paso de la cuadrícula
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
# Crear una cuadrícula bidimensional que representa diferentes espacios de muestra
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
# Usar el modelo KNN para predecir la categoría de cada punto en la cuadrícula
Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Dibujar el límite de decisión
plt.contourf(xx, yy, Z, alpha=0.8)
# Dibujar los puntos de datos de entrenamiento
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o', s=50)
plt.title("KNN Demo")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
Se muestra de la siguiente manera:
7. Ajustar el valor de K
La elección del valor de K tiene una influencia importante en el rendimiento del modelo.
Generalmente elegimos el mejor valor de K mediante validación cruzada o métodos de visualización.
Ejemplo
k_range = range(1, 21)
accuracies = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
accuracies.append(accuracy)
# Graficar la relación entre el valor de K y la precisión
plt.plot(k_range, accuracies, marker='o')
plt.title("Relación entre el valor de K y la precisión")
plt.xlabel("Valor de K")
plt.ylabel("Precisión")
plt.show()
8. Usar KNN para tareas de regresión
KNN también se puede utilizar para tareas de regresión (KNN Regression).
En tareas de regresión, KNN predice la salida promediando los valores objetivo de los K vecinos más cercanos.
Ejemplo
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
# Generar datos de ejemplo
X = np.random.rand(100, 1) * 10
y = np.sin(X).ravel() + 0.1 * np.random.randn(100)
# Dividir en conjunto de entrenamiento y conjunto de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Crear el modelo de regresión KNN
knn_reg = KNeighborsRegressor(n_neighbors=5)
# Entrenar el modelo
knn_reg.fit(X_train, y_train)
# Realizar predicciones sobre el conjunto de prueba
y_pred = knn_reg.predict(X_test)
# Visualizar los resultados de la regresión
plt.scatter(X_test, y_test, color='red', label='True Values')
plt.scatter(X_test, y_pred, color='blue', label='Predicted Values')
plt.title("KNN Regression")
plt.xlabel("Feature")
plt.ylabel("Target")
plt.legend()
plt.show()
El rojo representa los valores reales, el azul representa los valores predichos:
