K近傍法
K近傍法(K-Nearest Neighbors、略称KNN)は、シンプルで広く使われている分類および回帰アルゴリズムです。
K近傍法は教師あり学習の一種であり、核となる考え方は、分類対象のサンプルとトレーニングセット内の各サンプルとの距離を計算し、最も近いK個のサンプルを見つけ、そのK個のサンプルのクラスまたは値に基づいて、分類対象のサンプルのクラスまたは値を予測することです。
KNNの基本原理
KNNアルゴリズムの基本原理は、以下の手順にまとめられます:
- 距離の計算:分類対象のサンプルとトレーニングセット内の各サンプルとの距離を計算します。一般的な距離の計算方法には、ユークリッド距離やマンハッタン距離などがあります。
- K個の最近傍を選択:計算された距離に基づいて、距離が最も近いK個のサンプルを選択します。
- 投票または平均:分類問題の場合、K個の最近傍の中で最も多く出現するクラスが分類対象のサンプルのクラスとなります。回帰問題の場合、K個の最近傍の値の平均が分類対象のサンプルの値となります。
KNNの特徴
- シンプルで理解しやすい:KNNアルゴリズムの原理は非常にシンプルで、理解と実装が容易です。
- トレーニング不要:KNNは一種の「怠惰学習」アルゴリズムであり、明示的なトレーニングプロセスを必要とせず、すべての計算は予測時に行われます。
- データ分布に対する仮定なし:KNNはデータの分布について一切の仮定を行わないため、さまざまな種類のデータに適用できます。
- 計算複雑度が高い:KNNは予測時にすべてのサンプルとの距離を計算する必要があるため、データセットが大きい場合、計算複雑度が非常に高くなります。
KNNアルゴリズムの長所と短所
長所
- シンプルで使いやすい:KNNアルゴリズムの原理はシンプルで、理解と実装が容易です。
- トレーニング不要:KNNは明示的なトレーニングプロセスを必要とせず、すべての計算は予測時に行われます。
- 多クラス分類問題に適用可能:KNNは多クラス分類問題を簡単に処理できます。
短所
- 計算複雑度が高い:KNNは予測時にすべてのサンプルとの距離を計算する必要があるため、データセットが大きい場合、計算複雑度が非常に高くなります。
- ノイズに敏感:KNNはノイズデータに対して比較的敏感であり、ノイズデータが予測結果に影響を与える可能性があります。
- 適切なK値の選択が必要:K値の選択はモデルのパフォーマンスに大きな影響を与えるため、適切なK値を選択することは課題です。
KNNアルゴリズムの実装手順
1. 必要なライブラリのインポート
まず、いくつかの一般的なPythonライブラリをインポートする必要があります。例えば、numpyは数値計算に使用し、matplotlibは作図に使用し、sklearnはデータセットの読み込みとモデルの評価に使用します。
例
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2. データセットの読み込み
私たちはsklearnのload_iris関数を使用して、定番のアイリスデータセットを読み込みます。このデータセットには150個のサンプルが含まれ、各サンプルには4つの特徴があり、サンプルを3つのクラスに分類することを目的としています。
例
iris = datasets.load_iris()
X = iris.data[:, :2] # 可視化しやすいように最初の2つの特徴のみを使用
y = iris.target
3. データの前処理
KNNアルゴリズムを適用する前に、各特徴の距離計算への寄与が同じになるよう、データを標準化する必要があります。
例
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. KNNモデルのトレーニング
次に、私たちはsklearnのKNeighborsClassifierを使用して、KNNモデルをトレーニングします。ここではK=3を選択します。つまり、3つの最近傍を選択します。
例
knn = KNeighborsClassifier(n_neighbors=3)
# モデルをトレーニング
knn.fit(X_train, y_train)
5. 予測と評価
トレーニング済みモデルを使用してテストセットの予測を行い、モデルの正解率を計算します。
例
y_pred = knn.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"KNNモデルの正解率: {accuracy:.4f}")
出力は以下の通りです:
KNN模型的准确率: 0.7556
6. KNN分類結果の可視化
KNNの分類効果をより直感的に理解するために、データポイントと決定境界を描画できます。
ここでは、データセットの最初の2つの特徴を入力特徴として使用します。
例
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
# Irisデータセットを読み込む
iris = datasets.load_iris()
X = iris.data[:, :2] # 可視化しやすいように最初の2つの特徴のみを使用
y = iris.target
# データセットをトレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# KNNモデルを作成し、K値を3に設定
knn = KNeighborsClassifier(n_neighbors=3)
# モデルをトレーニング
knn.fit(X_train, y_train)
# テストセットで予測を実行
y_pred = knn.predict(X_test)
# 正解率を計算
accuracy = accuracy_score(y_test, y_pred)
print(f"KNNモデルの正解率: {accuracy:.4f}")
# 決定境界とデータポイントを描画
h = .02 # グリッドのステップ幅
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
# 2次元グリッドを作成し、異なるサンプル空間を表す
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
# KNNモデルを使用して、グリッド内の各ポイントのクラスを予測
Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# 決定境界を描画
plt.contourf(xx, yy, Z, alpha=0.8)
# トレーニングデータポイントを描画
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o', s=50)
plt.title("KNN Demo")
plt.xlabel("Feature 1")
plt.ylabel("Feature 2")
plt.show()
表示は以下の通りです:
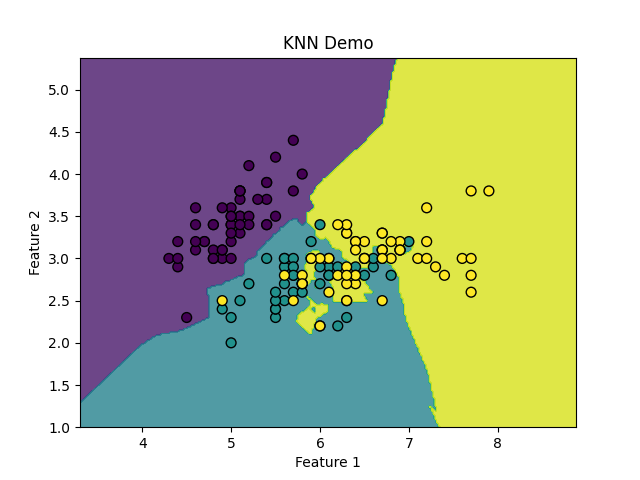
7. K値の調整
K値の選択はモデルのパフォーマンスに重要な影響を与えます。
通常、交差検証または可視化手法を使用して最適なK値を選択します。
例
k_range = range(1, 21)
accuracies = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
accuracies.append(accuracy)
# K値と正解率の関係をプロット
plt.plot(k_range, accuracies, marker='o')
plt.title("K値と正解率の関係")
plt.xlabel("K値")
plt.ylabel("正解率")
plt.show()
8. KNNを使用した回帰タスク
KNNは回帰タスク(KNN回帰)にも使用できます。
回帰タスクでは、KNNはK個の最近傍の目的値の平均を計算して出力を予測します。
例
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
# サンプルデータを生成
X = np.random.rand(100, 1) * 10
y = np.sin(X).ravel() + 0.1 * np.random.randn(100)
# トレーニングセットとテストセットに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# KNN回帰モデルを作成
knn_reg = KNeighborsRegressor(n_neighbors=5)
# モデルをトレーニング
knn_reg.fit(X_train, y_train)
# テストセットで予測を実行
y_pred = knn_reg.predict(X_test)
# 回帰結果を可視化
plt.scatter(X_test, y_test, color='red', label='True Values')
plt.scatter(X_test, y_pred, color='blue', label='Predicted Values')
plt.title("KNN Regression")
plt.xlabel("Feature")
plt.ylabel("Target")
plt.legend()
plt.show()
赤色が実測値、青色が予測値です:
