Алгоритм K-ближайших соседей
K-ближайшие соседи (KNN) — это простой и часто используемый алгоритм классификации и регрессии.
K-ближайшие соседи — это разновидность обучения с учителем. Основная идея метода заключается в вычислении расстояния между классифицируемым образцом и каждым образцом в обучающей выборке, поиске K образцов с наименьшим расстоянием и последующем предсказании класса или значения целевого образца на основе классов или значений этих K образцов.
Основные принципы KNN
Основные принципы алгоритма KNN можно сформулировать в виде следующих шагов:
- Вычисление расстояния: Вычислите расстояние между классифицируемым образцом и каждым образцом в обучающей выборке. Распространённые метрики расстояния включают евклидово расстояние, манхэттенское расстояние и т. д.
- Выбор K ближайших соседей: На основе вычисленных расстояний выберите K образцов с наименьшим расстоянием.
- Голосование или усреднение: Для задач классификации класс, который чаще всего встречается среди K ближайших соседей, является классом целевого образца; для задач регрессии среднее значение K ближайших соседей является значением целевого образца.
Особенности KNN
- Простота и лёгкость понимания: Принцип алгоритма KNN очень прост, его легко понять и реализовать.
- Не требуется обучение: KNN — это алгоритм «ленивого обучения», который не требует явного процесса обучения; все вычисления выполняются во время прогнозирования.
- Отсутствие предположений о распределении данных: KNN не делает никаких предположений о распределении данных, что делает его подходящим для различных типов данных.
- Высокая вычислительная сложность: Поскольку KNN должен вычислять расстояния до всех образцов во время прогнозирования, вычислительная сложность становится высокой, когда набор данных большой.
Преимущества и недостатки алгоритма KNN
Преимущества
- Простота и удобство использования: Алгоритм KNN прост по принципу, его легко понять и реализовать.
- Не требуется обучение: KNN не требует явного процесса обучения; все вычисления выполняются во время прогнозирования.
- Подходит для многоклассовой классификации: KNN может легко обрабатывать задачи многоклассовой классификации.
Недостатки
- Высокая вычислительная сложность: KNN должен вычислять расстояния до всех образцов во время прогнозирования, и вычислительная сложность высока, когда набор данных большой.
- Чувствительность к шуму: KNN относительно чувствителен к зашумлённым данным, что может повлиять на результаты прогнозирования.
- Необходимо выбрать подходящее значение K: Выбор значения K сильно влияет на производительность модели, а выбор подходящего значения K является сложной задачей.
Шаги реализации алгоритма KNN
1. Импорт необходимых библиотек
Сначала нам нужно импортировать некоторые распространённые библиотеки Python, такие какnumpyдля численных вычислений,matplotlibдля построения графиков,sklearnдля загрузки наборов данных и оценки моделей.
Пример
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
2. Загрузка набора данных
Мы используемsklearnfromload_irisфункция для загрузки классического набора данных Iris. Этот набор данных содержит 150 образцов, каждый с 4 признаками, и цель — классифицировать образцы на 3 класса.
Пример
iris = datasets.load_iris()
X = iris.data[:, :2] # Взять только первые два признака для визуализации
y = iris.target
3. Предобработка данных
Перед применением алгоритма KNN обычно необходимо стандартизировать данные, чтобы каждый признак вносил одинаковый вклад в вычисление расстояния.
Пример
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Обучение модели KNN
Далее мы используемsklearnfromKNeighborsClassifierдля обучения модели KNN. Здесь мы выбираем K=3, то есть выбираем 3 ближайших соседа.
Пример
knn = KNeighborsClassifier(n_neighbors=3)
# Обучаем модель
knn.fit(X_train, y_train)
5. Прогнозирование и оценка
Используйте обученную модель для прогнозирования на тестовом наборе и вычислите точность модели.
Пример
y_pred = knn.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"KNN model accuracy: {accuracy:.4f}")
Вывод следующий:
KNN模型的准确率: 0.7556
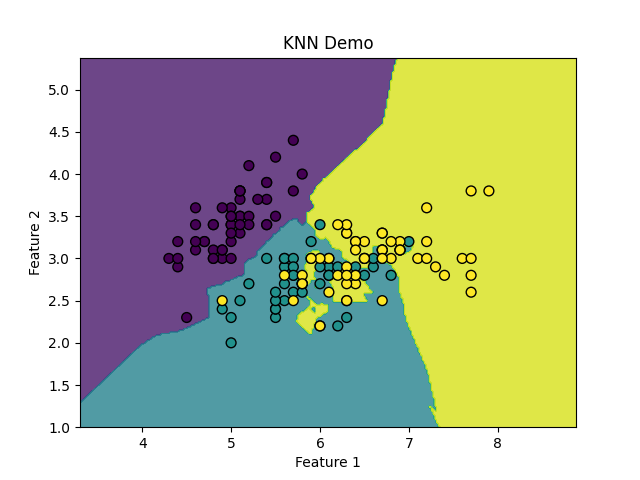
6. Визуализация результатов классификации KNN
Чтобы более интуитивно понять эффект классификации KNN, мы можем построить точки данных и границы решения.
Здесь мы используем первые два признака набора данных в качестве входных признаков.
Пример
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score
# Загрузить набор данных Iris
iris = datasets.load_iris()
X = iris.data[:, :2] # Взять только первые два признака для визуализации
y = iris.target
# Разделите набор данных на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создать модель KNN, установить значение K равным 3
knn = KNeighborsClassifier(n_neighbors=3)
# Обучаем модель
knn.fit(X_train, y_train)
# Выполните прогноз на тестовом наборе
y_pred = knn.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"KNN model accuracy: {accuracy:.4f}")
# Построить границу решения и точки данных
h = .02 # Размер шага сетки
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
# Создать двумерную сетку, представляющую различные пространства выборок
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
# Использовать модель KNN для предсказания класса каждой точки на сетке
Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
# Построить границу решения
plt.contourf(xx, yy, Z, alpha=0.8)
# Построить точки обучающих данных
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o', s=50)
plt.title("Демо KNN")
plt.xlabel("Признак 1")
plt.ylabel("Признак 2")
plt.show()
Отображение выглядит следующим образом:
7. Настройка значения K
Выбор значения K оказывает важное влияние на производительность модели.
Обычно мы выбираем наилучшее значение K с помощью кросс-валидации или методов визуализации.
Пример
k_range = range(1, 21)
accuracies = []
for k in k_range:
knn = KNeighborsClassifier(n_neighbors=k)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
accuracies.append(accuracy)
# Постройте график зависимости между значением K и точностью
plt.plot(k_range, accuracies, marker='o')
plt.title("Связь между значением K и точностью")
plt.xlabel("Значение K")
plt.ylabel("Точность")
plt.show()
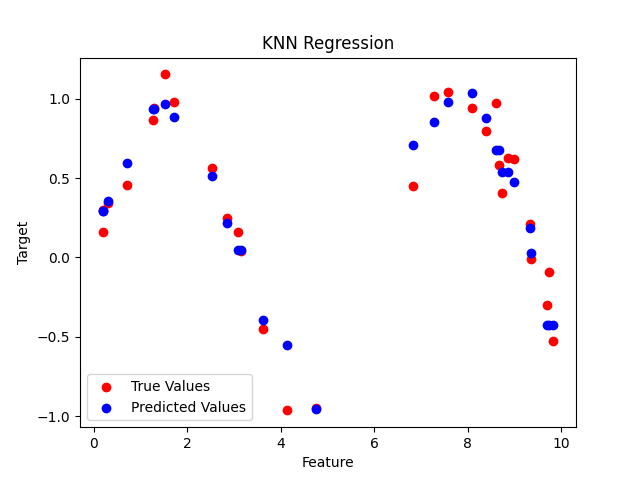
8. Использование KNN для задач регрессии
KNN также можно использовать для задач регрессии (KNN-регрессия).
В задачах регрессии KNN предсказывает выход, усредняя целевые значения K ближайших соседей.
Пример
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsRegressor
# Сгенерировать пример данных
X = np.random.rand(100, 1) * 10
y = np.sin(X).ravel() + 0.1 * np.random.randn(100)
# Разделить на обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создать модель KNN-регрессии
knn_reg = KNeighborsRegressor(n_neighbors=5)
# Обучаем модель
knn_reg.fit(X_train, y_train)
# Выполните прогноз на тестовом наборе
y_pred = knn_reg.predict(X_test)
# Визуализация результатов регрессии
plt.scatter(X_test, y_test, color='red', label='Истинные значения')
plt.scatter(X_test, y_pred, color='blue', label='Предсказанные значения')
plt.title("KNN-регрессия")
plt.xlabel("Признак")
plt.ylabel("Целевая переменная")
plt.legend()
plt.show()
Красный обозначает истинные значения, синий — предсказанные значения: