Обучение с подкреплением: исследование против использования
В мире обучения с подкреплением агент подобен исследователю, который постоянно учится и растёт в неизвестной среде. Он сталкивается с основным противоречием, проходящим через всё: должен ли онисследовать (исследование)неизвестную территорию и искать новые пути, которые могут принести более высокие награды, или должениспользовать (использование)известную лучшую стратегию, чтобы стабильно получать текущую известную максимальную награду? Этот "компромисс между исследованием и использованием" — один из самых фундаментальных и критических вызовов в проектировании алгоритмов обучения с подкреплением. Хорошее понимание и разрешение этого противоречия — необходимый путь для агента, чтобы вырасти из новичка в мастера.
Что такое исследование и использование?
Давайте сначала разберём эти два ключевых понятия через аналогию из повседневной жизни.
Представьте, что каждый день в полдень вам нужно выбрать ресторан для обеда.
- Эксплуатация: вы выбираете пойти визвестный ресторан, который вам нравится больше всего. Вы знаете, что еда там соответствует вашему вкусу, цены разумны, а качество обслуживания стабильно. Выбор эксплуатации означает, что вы принимаете решения на основенаилучшей известной на данный момент информации, с цельюмаксимизации определённых немедленных выигрышей. В обучении с подкреплением это соответствует выбору агентом действия с наибольшей текущей оценкой (например, Q-значения).
- Исследование: вы решаетепопробовать новый ресторан, в котором никогда не бывали. Этот новый ресторан может оказаться ужасным и заставить вас глубоко пожалеть, но он также может быть неожиданно вкусным и стать вашим новым любимым. Выбор исследования означает, что выдействуете, чтобы получить больше информации об окружающей среде, с цельюоптимизации долгосрочных будущих вознаграждений. В обучении с подкреплением это соответствует случайному выбору агентом действий или выбору действий, не являющихся текущими оптимальными, чтобы обновить своё понимание модели окружающей среды.
Цель агента обучения с подкреплением — не выиграть один обед, аполучить наибольшее долгосрочное удовлетворение (совокупное вознаграждение) за бесчисленное множество выборов обеда.Если вы только эксплуатируете и никогда не исследуете, вы можете так и не обнаружить тот лучший новый ресторан, и долгосрочные вознаграждения не смогут достичь оптимума. Если вы только исследуете и никогда не эксплуатируете, вы можете потратить много времени и денег на плохие рестораны и не насладиться лучшим известным выбором.
Почему необходим компромисс?
Причина, по которой исследованию и эксплуатации необходим компромисс, коренится внеопределённостиокружающей среды инеполноте знаний агента.。
- Ограниченность информации: Агент изначально ничего не знает об окружающей среде. Он должен собирать данные посредством исследования, чтобы построить когнитивную модель мира (состояния, действия, награды, вероятности переходов).
- Альтернативные издержки: Исследование неизвестных действий может давать более низкие немедленные награды (или даже наказание), что эквивалентно уплате стоимости за информацию. Чрезмерное исследование пожертвует большим количеством краткосрочной награды, которую в противном случае можно было бы получить.
- Динамическая природа оптимального решения: В нестационарных средах оптимальная политика может меняться со временем. Даже если агент нашёл текущую оптимальную политику, ему всё ещё нужно продолжать исследовать в определённой степени, чтобы адаптироваться к изменениям среды и предотвратить устаревание политики.
Следовательно, превосходный алгоритм обучения с подкреплением должен находить динамический баланс между «использованием существующих знаний для получения наград» и «исследованием неизвестного для улучшения знаний».
Распространённые стратегии исследования
Как можно интегрировать механизмы исследования в алгоритм? Вот несколько классических методов:
ε-жадная стратегия (ε-Greedy)
Это самая простая и наиболее часто используемая стратегия исследования. Агент большую часть времени (с вероятностью1-ε) выбирает действие, которое в текущий момент считает оптимальным (эксплуатация), но с небольшой вероятностьюε(например, 5%) выбирает действие полностью случайным образом (исследование).
Пример
def epsilon_greedy(q_values, epsilon=0.1):
"""
Реализация ε-жадной стратегии
Аргументы:
q_values: массив, представляющий оценку Q-значения каждого действия в текущем состоянии.
epsilon: вероятность исследования, между 0 и 1.
Возвращает:
selected_action: индекс действия, выбранного в соответствии со стратегией.
"""
n_actions = len(q_values)
# Исследование с вероятностью epsilon (случайный выбор)
if np.random.random() < epsilon:
selected_action = np.random.randint(n_actions)
# Эксплуатация с вероятностью 1-epsilon (выбрать действие с наибольшим Q-значением)
else:
# Если несколько действий имеют одинаковое Q-значение, выберите одно случайным образом
selected_action = np.random.choice(np.where(q_values == np.max(q_values))[0])
return selected_action
# Пример: предположим, что в некотором состоянии оценки Q-значений трёх действий равны [1.5, 2.8, 2.3]
state_q_values = [1.5, 2.8, 2.3]
for i in range(10):
action = epsilon_greedy(state_q_values, epsilon=0.2)
print(f"Выбор {i+1}: Действие {action} (Q-значение: {state_q_values[action]:.1f})")
Преимущества: Простота и понятность, лёгкость реализации.Недостатки: Исследование полностью случайно и не использует никакую имеющуюся информацию (например, хотя действие не оптимально, его Q-значение близко к оптимальному; вероятность его исследования такая же, как у плохого действия с очень низким Q-значением).
Алгоритм верхней доверительной границы (Upper Confidence Bound, UCB)
UCB — это «более умная» стратегия исследования. Его основная идея — добавить «бонус за неопределённость» к оценке каждого действия. Чем меньше раз действие было опробовано, тем больше его неопределённость, и тем выше этот бонусный член, тем самым побуждая агента попробовать его.
Формула выбора действия обычно такова: \[ a_t = \arg\max_a \left[ Q(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right] \]
где:
Q(a)являетсяaтекущей средней оценкой награды действия (член эксплуатации).N_t(a)— это, к моменту времениt, число раз, которое действиеaбыло выбрано.c— это параметр баланса, который управляет силой исследования.ln t— это логарифм общего временного шага.- Член с квадратным корнем — это «бонус неопределённости» или «бонус исследования». Чем меньше раз выбирается действие (
N_t(a)мало), тем больше становится этот член.
Пример
import math
class UCB:
def __init__(self, n_actions, c=2):
self.n_actions = n_actions
self.c = c # Параметр исследования
self.Q = np.zeros(n_actions) # Оценки ценности действий
self.N = np.zeros(n_actions) # Счётчики выбора действий
self.total_steps = 0
def select_action(self):
self.total_steps += 1
# Убедиться, что каждое действие выбрано хотя бы один раз
if np.any(self.N == 0):
action = np.random.choice(np.where(self.N == 0)[0])
else:
# Вычислить значение UCB для каждого действия: Q(a) + c * sqrt(ln(t) / N(a))
ucb_values = self.Q + self.c * np.sqrt(np.log(self.total_steps) / self.N)
action = np.argmax(ucb_values)
return action
def update(self, action, reward):
"""Обновить оценку значения действия"""
self.N[action] += 1
# Инкрементально обновить Q-значение: NewEstimate = OldEstimate + (1/N) * (Target - OldEstimate)
self.Q[action] += (reward - self.Q[action]) / self.N[action]
# Симуляция задачи о многоруком бандите, где каждая рука имеет свою истинную вероятность награды
true_means = [0.1, 0.5, 0.9] # Истинные средние награды трёх рук
n_actions = len(true_means)
bandit = UCB(n_actions, c=2)
total_reward = 0
for step in range(1000):
action = bandit.select_action()
# Симуляция вытягивания руки бандита: награда 1 с определённой вероятностью, иначе 0
reward = 1 if np.random.random() < true_means[action] else 0
bandit.update(action, reward)
total_reward += reward
print(f"Суммарная награда, полученная стратегией UCB за 1000 шагов: {total_reward}")
print(f"Количество раз, когда каждое действие было выбрано: {bandit.N}")
print(f"Оценки Q-значений каждого действия: {bandit.Q}")
Преимущества: Исследование более целенаправленно; оно предпочтительно исследует действия с высокой неопределённостью (мало попыток) и может быстрее сходиться к оптимальному действию.Недостатки: Требуется отслеживать количество выборов каждого действия, и он может быть неприменим, когда пространство действий непрерывное или очень большое.
Сэмплирование Томпсона
Это вероятностный метод, основанный на байесовских идеях. Для распределения вознаграждения каждого действия (например, параметра распределения Бернуллиθ_a), агент поддерживает априорное распределение (например, бета-распределение). На каждом шаге из апостериорного распределения каждого действия онсэмплируетвозможный параметр вознагражденияθ_a, а затем выполняет действие с наибольшим сэмплированным значением. После получения фактического вознаграждения он обновляет апостериорное распределение этого действия в соответствии с результатом.
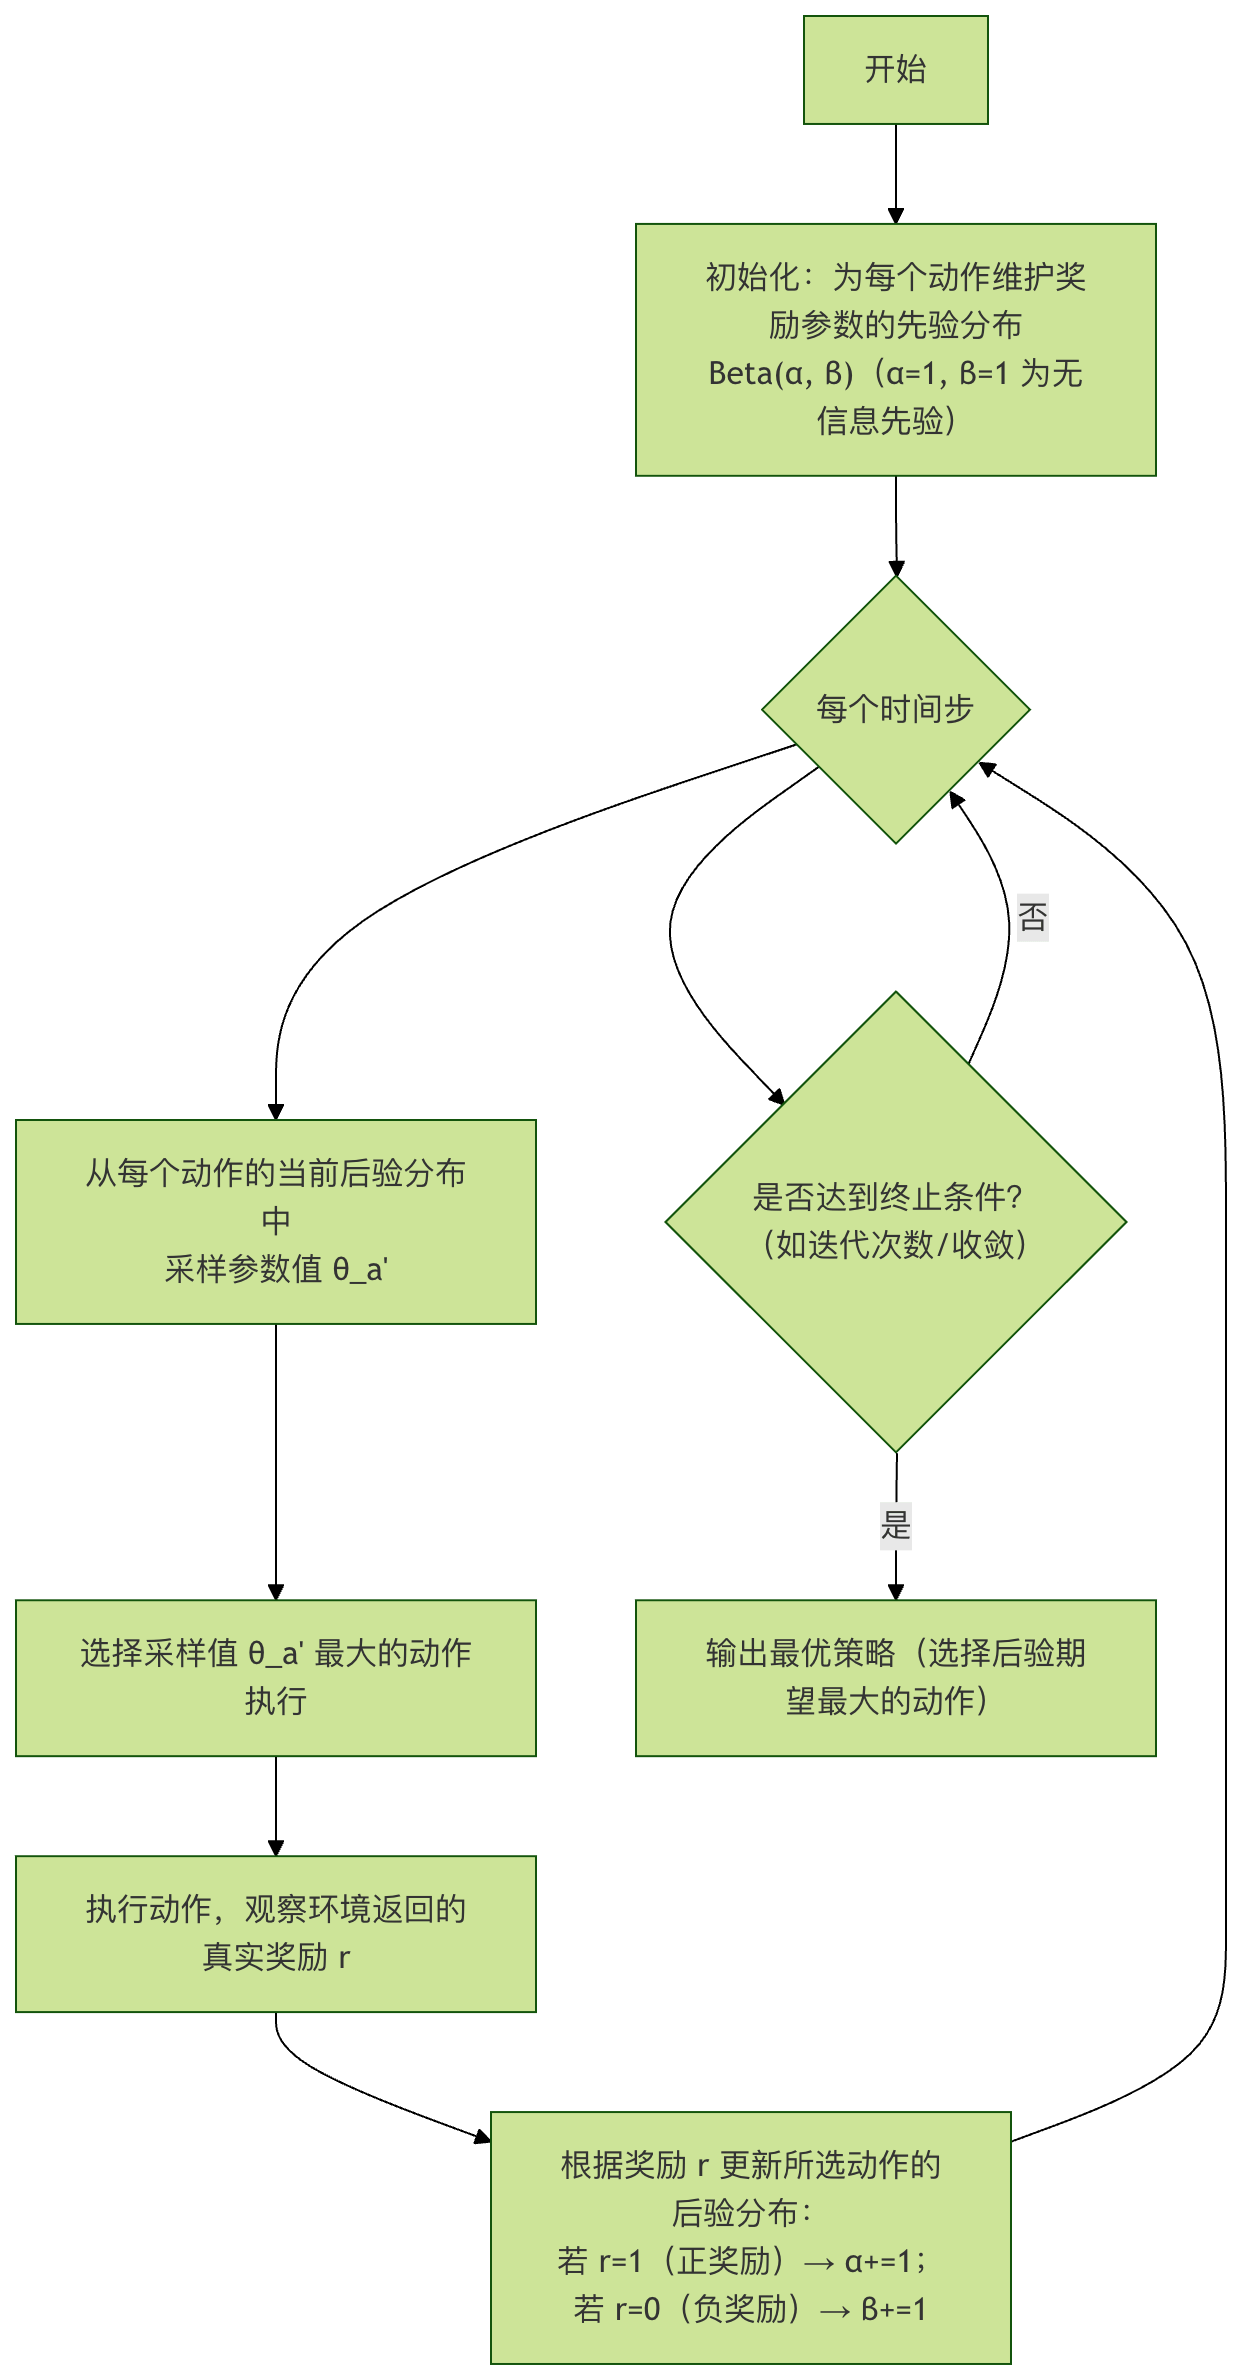
Объяснение процедуры:
- Инициализация: для каждого действия
aпредполагаем, что вероятность получения вознагражденияθ_aподчиняется распределению Beta(α=1, β=1), которое является равномерным априорным распределением. - Сэмплирование: На каждом шаге из каждого действия
aтекущее распределение Beta(α_a, β_a), независимо выбираем значениеθ_a'。 - Выбор: Выполните действие с выбранным значением
θ_a'которое является наибольшим. - Обновление: Если получена награда
r=1, то у действияαувеличивается на 1; еслиr=0, тоβувеличивается на 1. Это эквивалентно обновлению байесовского апостериорного распределения с использованием наблюдаемых данных.
Преимущества: Естественно балансирует исследование и использование, обладает хорошими теоретическими свойствами и часто очень хорошо показывает себя на практике.Недостатки: Требуется предположить вид распределения награды, а вычисления могут быть сложнее, чем в ε-greedy.
Динамический баланс между исследованием и использованием
В практических приложениях стратегии исследования часто не статичны, а динамически корректируются по мере прогресса обучения агента.
- Интенсивное исследование на ранней стадии: В начале обучения агент ничего не знает об окружающей среде, поэтому следует установить более высокий коэффициент исследования (например, большее
εилиc), чтобы масштабно собирать данные. - Интенсивная эксплуатация на более позднем этапе: По мере обучения понимание агентом среды становится более точным, и темп исследования следует постепенно снижать (например, пусть
εсо временем уменьшается), смещая фокус на эксплуатацию уже изученных превосходных стратегий, чтобы стабильно получать высокие награды.
Этот процесс динамической настройки имитирует человеческий процесс обучения — «от масштабных проб к постоянному совершенствованию».
Практическое упражнение: сравнение разных стратегий
Давайте разработаем простой эксперимент, чтобы сравнить эффективность стратегий ε-жадной и UCB на классической задаче «многорукий бандит».
Задача:
- Создайте бандита с 5 руками, где истинные вероятности награды каждой руки соответственно равны
[0.1, 0.2, 0.8, 0.5, 0.3]。 - Реализуйте стратегии ε-жадную (ε=0.1) и UCB (c=2) соответственно.
- Запустите каждую стратегию на 2000 шагов, записывая немедленную награду и кумулятивную награду на каждом шаге.
- Постройте кривую кумулятивной награды по временным шагам и посмотрите, какая стратегия может быстрее и стабильнее получать более высокую суммарную награду.
Подумайте:
- Попробуйте изменить параметры ε и c и посмотрите, какое влияние они оказывают на результаты?
- Если разрыв между оптимальным рычагом (вероятность 0.8) и неоптимальным рычагом (вероятность 0.5) уменьшится, как изменится эффективность стратегий?
- В более сложных средах обучения с подкреплением (таких как
Gym), как эти стратегии исследования можно объединить с Q-Learning, DQN и другими алгоритмами?